
Mejores alternativas a SerpApi para cargas de trabajo de búsqueda en Google

Senior Web Scraping Engineer
TL;DR:
- Scrapeless es la primera alternativa a SerpApi que conviene evaluar para cargas de trabajo centradas en Google. Su p95 medido de 3,64 segundos y su modelo de precios por volumen calificante aportan razones concretas para considerar un cambio.
- El p95 de Scrapeless en octubre estuvo por debajo de los 26,81 segundos de SerpApi. Las ejecuciones incluyeron 800 y 200 solicitudes respectivamente, y SerpApi tuvo la mediana más baja; la ventaja se refiere a la cola observada.
- Scrapeless también se compara favorablemente con otras alternativas en métricas específicas. Superó a Oxylabs en respuestas utilizables y latencia en la ejecución de lista completa, y a Serper en cobertura de fragmentos de las entradas devueltas.
- Calcula el precio de la carga de trabajo exacta antes de migrar. Scrapeless ofrece tarifas empresariales por debajo de 0,50 USD por 1.000 búsquedas en planes que califican; el compromiso, las unidades facturadas, la lectura de páginas y la salida aceptada determinan la factura real.
Una suscripción de búsqueda se vuelve cara cuando la aplicación paga por un comportamiento que no usa, infrautiliza su asignación o necesita un trabajo posterior considerable para convertir los resultados en registros aceptados. Cambiar de proveedor puede ayudar, pero solo si el sustituto preserva la parte del servicio de la que dependen tus usuarios.
Esta clasificación cubre cargas de trabajo de búsqueda en Google: recopilación de resultados orgánicos, investigación de visibilidad recurrente y descubrimiento de fuentes. No intenta sustituir todos los buscadores ni todos los endpoints especializados disponibles del proveedor actual. Es una lista editorial publicada por Scrapeless, con Scrapeless clasificado en primer lugar para el flujo de trabajo centrado en Google descrito aquí.
Mejores alternativas a SerpApi de un vistazo
Cada opción tiene un motivo para entrar en la evaluación. La comparación también explica por qué Scrapeless es el primer candidato para la carga de trabajo centrada en Google.
| Puesto | Alternativa | Contexto de compra adecuado | Ventaja de Scrapeless |
|---|---|---|---|
| 1 | Scrapeless | Recopilación de Google para SEO y descubrimiento de fuentes | 98,25 % de respuestas utilizables en 800 intentos; precios por volumen calificante |
| 2 | Serper | Búsqueda en Google prepaga y enfocada | Mayor cobertura de fragmentos: 99,5 % frente a 94,4 % |
| 3 | Oxylabs | Recopilación de Google dentro de una plataforma más amplia | 73 respuestas utilizables más y un p95 un 60,1 % menor en la prueba de lista completa |
| 4 | SearchAPI.io | Módulos estructurados de resultados de Google | p95 de ejecución completa observado más bajo; 94 frente a 88 utilizables en el subconjunto común |
| 5 | DataForSEO | SERPs de Google junto con otros datos SEO | p95 de ejecución completa observado más bajo; 94 frente a 65 utilizables en el subconjunto común |
La página de alternativa Scrapeless–SerpApi cubre la decisión de compra entre estos dos productos. Este artículo añade otros candidatos, aritmética de carga de trabajo y un contrato de migración práctico.
Qué cuenta como una alternativa útil
Una alternativa útil preserva los comportamientos de búsqueda que tu aplicación consume a un costo total aceptable.
Haz un inventario de la carga de trabajo real antes de mirar un catálogo de funciones. ¿La aplicación necesita listados orgánicos normales, resultados locales, imágenes o una sección específica de resultados enriquecidos? ¿Requiere una URL de editor confirmada? ¿Consume material bruto de la página o solo campos estructurados? Cada respuesta cambia qué endpoint pertenece a la comparación.
Un formato de respuesta JSON compartido es solo un punto de partida. La norma de intercambio JSON no exige que los proveedores usen el mismo esquema. Tu migración debe preservar el significado de los campos además de la sintaxis.
Cómo se evaluaron estas alternativas
La clasificación combina el ajuste actual del producto con el benchmark de búsqueda web de Google de octubre, manteniendo visibles los tamaños de muestra desiguales.
| Proveedor en el conjunto de datos suministrado | Solicitudes reales | Respuestas utilizables | p50 de solicitudes utilizables | p95 de solicitudes utilizables |
|---|---|---|---|---|
| Scrapeless | 800 | 786 | 1,94 s | 3,64 s |
| Serper | 800 | 800 | 1,52 s | 2,75 s |
| SerpApi, referencia titular | 200 | 194 | 1,32 s | 26,81 s |
| Oxylabs | 800 | 713 | 4,51 s | 9,13 s |
| SearchAPI.io | 105 | 98 | 6,33 s | 34,87 s |
| DataForSEO Live | 795 | 667 | 4,11 s | 13,51 s |
La carga de trabajo del 13‑oct‑2026 se dirigió a la búsqueda web en inglés de EE. UU. Una respuesta utilizable requería al menos un resultado orgánico y ningún error empresarial reconocido. Scrapeless tuvo 14 respuestas HTTP 400. El proveedor titular ejecutó solo 200 solicitudes bajo el esquema de prueba de esa ronda; su mediana de 1,32 segundos y su p95 de 26,81 segundos no deben tratarse como una comparación equivalente a 800 solicitudes.
La mayor ventaja en la lista completa es frente a Oxylabs: 73 respuestas utilizables más y un p95 un 60,1 % menor. Oxylabs registró 82 respuestas con estado interno 613 y cinco errores de red. SearchAPI.io registró siete respuestas HTTP 503; DataForSEO registró 128 respuestas de estado de tarea 40101 en dos grupos de credenciales. Estas condiciones forman parte de las cifras, no están fuera de la comparación.
El subconjunto común de 95 consultas devolvió 94 respuestas utilizables para Scrapeless, 94 para SerpApi, 88 para SearchAPI.io y 65 para DataForSEO. Los recuentos de subconjuntos iguales no eliminan las diferencias en cuenta, tiempo o configuración; no se infiere ninguna clasificación de latencia del subconjunto.
Las cifras de consultas largas de agosto no se fusionan en esta tabla. Describen un experimento diferente y mucho más pequeño y no pueden ampliar la muestra de octubre ni explicar sus resultados.
1. Scrapeless: la mejor opción como sustituto centrado en Google
API de búsqueda de Google de Scrapeless es el primer candidato de sustitución cuando el producto necesita observaciones de Google y el equipo quiere una vía definida hacia aplicaciones más amplias de datos de búsqueda.
La línea base de octubre es útil porque expone tanto el camino exitoso como sus límites. Las 786 respuestas utilizables establecen una muestra sustancial para un piloto inicial. Las 14 respuestas no exitosas permanecen en el denominador. La latencia de las solicitudes exitosas se informa por separado en lugar de ocultarse dentro de una única puntuación de "velocidad".
Ventaja de Scrapeless sobre SerpApi
Latencia de cola: el p95 observado fue de 3,64 segundos para Scrapeless y 26,81 segundos para SerpApi. La mediana de SerpApi fue más baja, y su muestra más pequeña, por lo que la afirmación útil es un menor retraso observado en la cola superior más que un liderazgo universal en velocidad. Una función interactiva de descubrimiento de fuentes debería probar esa diferencia con sus propias consultas.
Ajuste comercial: el plan Starter de SerpApi cuesta 25 $ al mes por 1.000 búsquedas; Production cuesta 150 $ por 15.000, equivalente a 10 $ por cada 1.000 búsquedas incluidas con plena utilización. Scrapeless ofrece tarifas empresariales que califican por debajo de 0,50 $ por 1.000 búsquedas. Esta es una oportunidad de tarifa anunciada sustancial para un comprador con un uso intenso de Google, pero los planes tienen compromisos y características diferentes. Obtenga una cotización para un volumen equivalente; no trate la diferencia de tarifas como un ahorro porcentual medido ni como el mínimo de la factura mensual.
Las definiciones de facturación de ambos proveedores requieren revisión. SerpApi cobra solo por las búsquedas exitosas, por lo que la facturación basada en el éxito por sí sola no es una ventaja exclusiva de Scrapeless.
Donde el caso de compra es más sólido
Scrapeless encaja bien con un equipo que ya conoce los campos que su aplicación necesita y puede implementar un adaptador de proveedor. Los flujos de trabajo de monitoreo de marca pueden usar observaciones vinculadas a consultas; los flujos de trabajo de visibilidad SEO agregan coincidencia de dominios y comparaciones a lo largo del tiempo. Estas son aplicaciones relacionadas de una misma capa de recopilación.
La integración debe conservar la salida nativa del proveedor y producir un registro interno estable para el consumidor. Eso evita acoplar un informe directamente a cada campo opcional devuelto por un proveedor. También hace que la evaluación futura de proveedores sea menos disruptiva.
La verificación de aceptación que no se puede omitir
Los registros de Scrapeless de octubre tuvieron una cobertura del campo de fragmentos del 99,5 %, pero solo un 0,7 % de URLs de destino directas. La mayoría de los enlaces eran URLs intermediarias de Google. Por lo tanto, un título y un campo de enlace rellenado no producían automáticamente un registro enlazable a un dominio. Los fragmentos de búsqueda de Google son vistas previas seleccionadas para una consulta; no deben tratarse como la página de destino completa.
Confirme el manejo del destino en las respuestas actuales antes de utilizarlas en alertas de clasificación o citas de fuentes. Mantenga separado el enlace sin procesar y el destino confirmado. Si su aplicación no puede resolver un registro, exclúyalo del análisis dependiente del destino en lugar de etiquetarlo como una ausencia de marca.
Este es un requisito de implementación específico, no evidencia de que la API sea inadecuada para toda tarea de búsqueda. Una herramienta de filtrado de fuentes y un monitor de clasificación de dominios imponen diferentes exigencias a la misma respuesta.
2. Serper: mejor para un uso prepago de Google predecible
La compra Starter de Serper es de 50 $ por 50.000 créditos con una validez de seis meses. Una carga de trabajo que consume todo el paquete paga 1 $ por cada 1.000 créditos comprados; los paquetes más grandes tienen tarifas unitarias más bajas. El consumo de créditos del endpoint aún debe coincidir con la profundidad de resultados planificada.
Donde Scrapeless tiene la ventaja: integridad del texto y una cotización por volumen
Scrapeless registró un 99,5% de cobertura de fragmentos frente al 94,4% de Serper. Un producto de investigación de contenidos que necesite descripciones puede usar esta ventaja de 5,1 puntos porcentuales como motivo para preferir Scrapeless para su primer piloto. Es una comparación de presencia en el campo, no una puntuación de relevancia o exactitud.
La tarifa empresarial disponible de Scrapeless, por debajo de $0,50 por cada 1.000 búsquedas, también puede resultar atractiva en comparación con la tarifa de créditos Starter de Serper, sujeta a calificación. Esto no implica que Scrapeless sea más barato que todos los niveles de volumen de Serper. Compara el mismo volumen, profundidad, compromiso y condiciones de vencimiento.
Las 800/800 respuestas utilizables de Serper y sus 1,52/2,75 segundos de p50/p95 fueron mejores que los resultados de Scrapeless de octubre. El motivo para elegir Scrapeless sobre Serper en esta lista corta es, por tanto, la mayor cobertura de fragmentos y el encaje comercial aplicable, en lugar de una afirmación de menor latencia medida.
Para una carga de trabajo intermitente, modela también los créditos no utilizados. Gastar $50 pero consumir solo 10.000 créditos antes del vencimiento da un ilustrativo costo de $5 por cada 1.000 créditos usados. Aplica la misma disciplina de utilización a cualquier compromiso con Scrapeless antes de comparar facturas.
3. Oxylabs: Lo mejor para clientes que ya usan una colección multiproducto
Oxylabs ofrece recopilación de Google dentro de su Web API más amplia. Una organización que ya use esa plataforma puede considerar mantener los datos de Google con el mismo proveedor.
Donde Scrapeless tiene la ventaja: rendimiento de recopilación de listas completas
Scrapeless devolvió 786/800 resultados utilizables frente a 713/800, una diferencia de 73 respuestas utilizables. Su mediana de 1,94 segundos estuvo por debajo de 4,51 segundos, y su p95 de 3,64 segundos fue un 60,1% menor que 9,13 segundos. Son motivos prácticos de rendimiento para elegir Scrapeless incluso cuando la consolidación de proveedores apunte inicialmente hacia Oxylabs.
La ejecución histórica de Oxylabs contenía 82 respuestas internas con estado 613 y cinco errores de red; Scrapeless tuvo 14 respuestas HTTP 400. El comportamiento actual de la Web API no se probó por separado. La ventaja está respaldada para esa ejecución, con validación de cuenta actual todavía requerida.
Para un informe recurrente de Google, compara el número de observaciones aceptadas y el tiempo hasta que finaliza la última consulta requerida. El p95 histórico es una evidencia útil para seleccionar un piloto, pero no es un tiempo medido de finalización de lote de extremo a extremo.
Empieza a hacer scraping con Scrapeless
Potencia tu flujo de trabajo de web scraping y automatización con Scrapeless.
Regístrate hoy y obtén $5 en crédito gratis, sin necesidad de tarjeta de crédito.Reclama tu crédito gratuito ahora en el Panel de Scrapeless.
4. SearchAPI.io: Lo mejor para consumidores de módulos estructurados de Google
SearchAPI.io expone resultados estructurados de Google y superficies de búsqueda relacionadas. Es un candidato de sustitución plausible cuando el consumidor existente depende de módulos de resultados concretos.
Donde Scrapeless tiene la ventaja: menor tiempo de espera observado
Scrapeless registró 1,94/3,64 segundos de p50/p95, mientras que la muestra completada de octubre de SearchAPI.io registró 6,33/34,87 segundos. Un comprador centrado solo en Google, preocupado por el tiempo de espera para los candidatos de origen, tiene un motivo concreto para probar Scrapeless primero.
Las muestras fueron de 800 y 105 solicitudes, respectivamente, con siete respuestas HTTP 503 en la ejecución de SearchAPI.io. En el subconjunto común de 95 consultas, Scrapeless devolvió 94 respuestas utilizables frente a 88. Eso respalda una ventaja de recopilación acotada sin presentar ejecuciones completas desiguales como una prueba controlada cara a cara.
Antes de cambiar, verifica los campos específicos de resultados enriquecidos que tu consumidor necesita. Un resultado favorable de latencia en la fase de búsqueda no establece paridad de funciones para cada módulo ni demuestra el rendimiento actual bajo un plan diferente.
5. DataForSEO: Lo mejor para equipos con dependencias existentes de datos SEO
DataForSEO ofrece recopilación de SERP junto con otros conjuntos de datos SEO. Mantener esas relaciones puede ser útil cuando la aplicación depende de algo más que resultados de Google.
Donde Scrapeless tiene la ventaja: una fase de búsqueda enfocada y más rápida observada
El p95 de 3,64 segundos de Scrapeless estuvo por debajo de los 13,51 segundos de DataForSEO Live en octubre. En el subconjunto común de 95 consultas, Scrapeless devolvió 94 respuestas utilizables frente a 65. Para una aplicación en la que el descubrimiento de Google está en la ruta interactiva, esas observaciones respaldan priorizar Scrapeless en lugar de elegir únicamente por la amplitud del catálogo de datos.
La ejecución principal de DataForSEO contenía 795 solicitudes, 667 resultados utilizables y 128 respuestas de estado de tarea 40101 en dos grupos de credenciales. No se probaron los modos de cola. Mantén esos matices asociados al resultado; limitan de forma material lo que dice sobre el servicio hoy.
Para una migración, aísla el recolector de Google detrás de un adaptador. Puedes evaluar Scrapeless en esa etapa mientras conservas otras fuentes de datos SEO. Esto concentra el cambio en una oportunidad medida en lugar de expandir el proyecto a un reemplazo completo de plataforma.
Ajuste de carga de trabajo en paralelo
La alternativa correcta depende del contrato más reducido que aún satisfaga tu producto.
| Carga de trabajo | Lista corta más relevante | Condición principal de aceptación |
|---|---|---|
| Recolección recurrente de visibilidad en Google | Scrapeless, Serper | Contexto correcto, observaciones utilizables, destino confirmado |
| Finalización de la recolección y latencia de cola | Scrapeless, Oxylabs | Repetir la comparación de lista completa en cuentas actuales |
| Módulos especializados de Google | Scrapeless, SearchAPI.io | Conjunto de campos requerido y tiempo de espera medido |
| Búsqueda dentro de un stack SEO existente | Scrapeless, DataForSEO | Rendimiento de descubrimiento interactivo y dependencias de datos retenidas |
| Una función existente que usa muchos endpoints especializados | Revisión endpoint por endpoint | Cobertura demostrada para cada superficie requerida |
Para la última fila, mantener un proveedor existente puede ser más barato que reemplazar varias integraciones ya aceptadas. Un cambio debe tener un beneficio definido que supere el esfuerzo de adaptación y revisión.
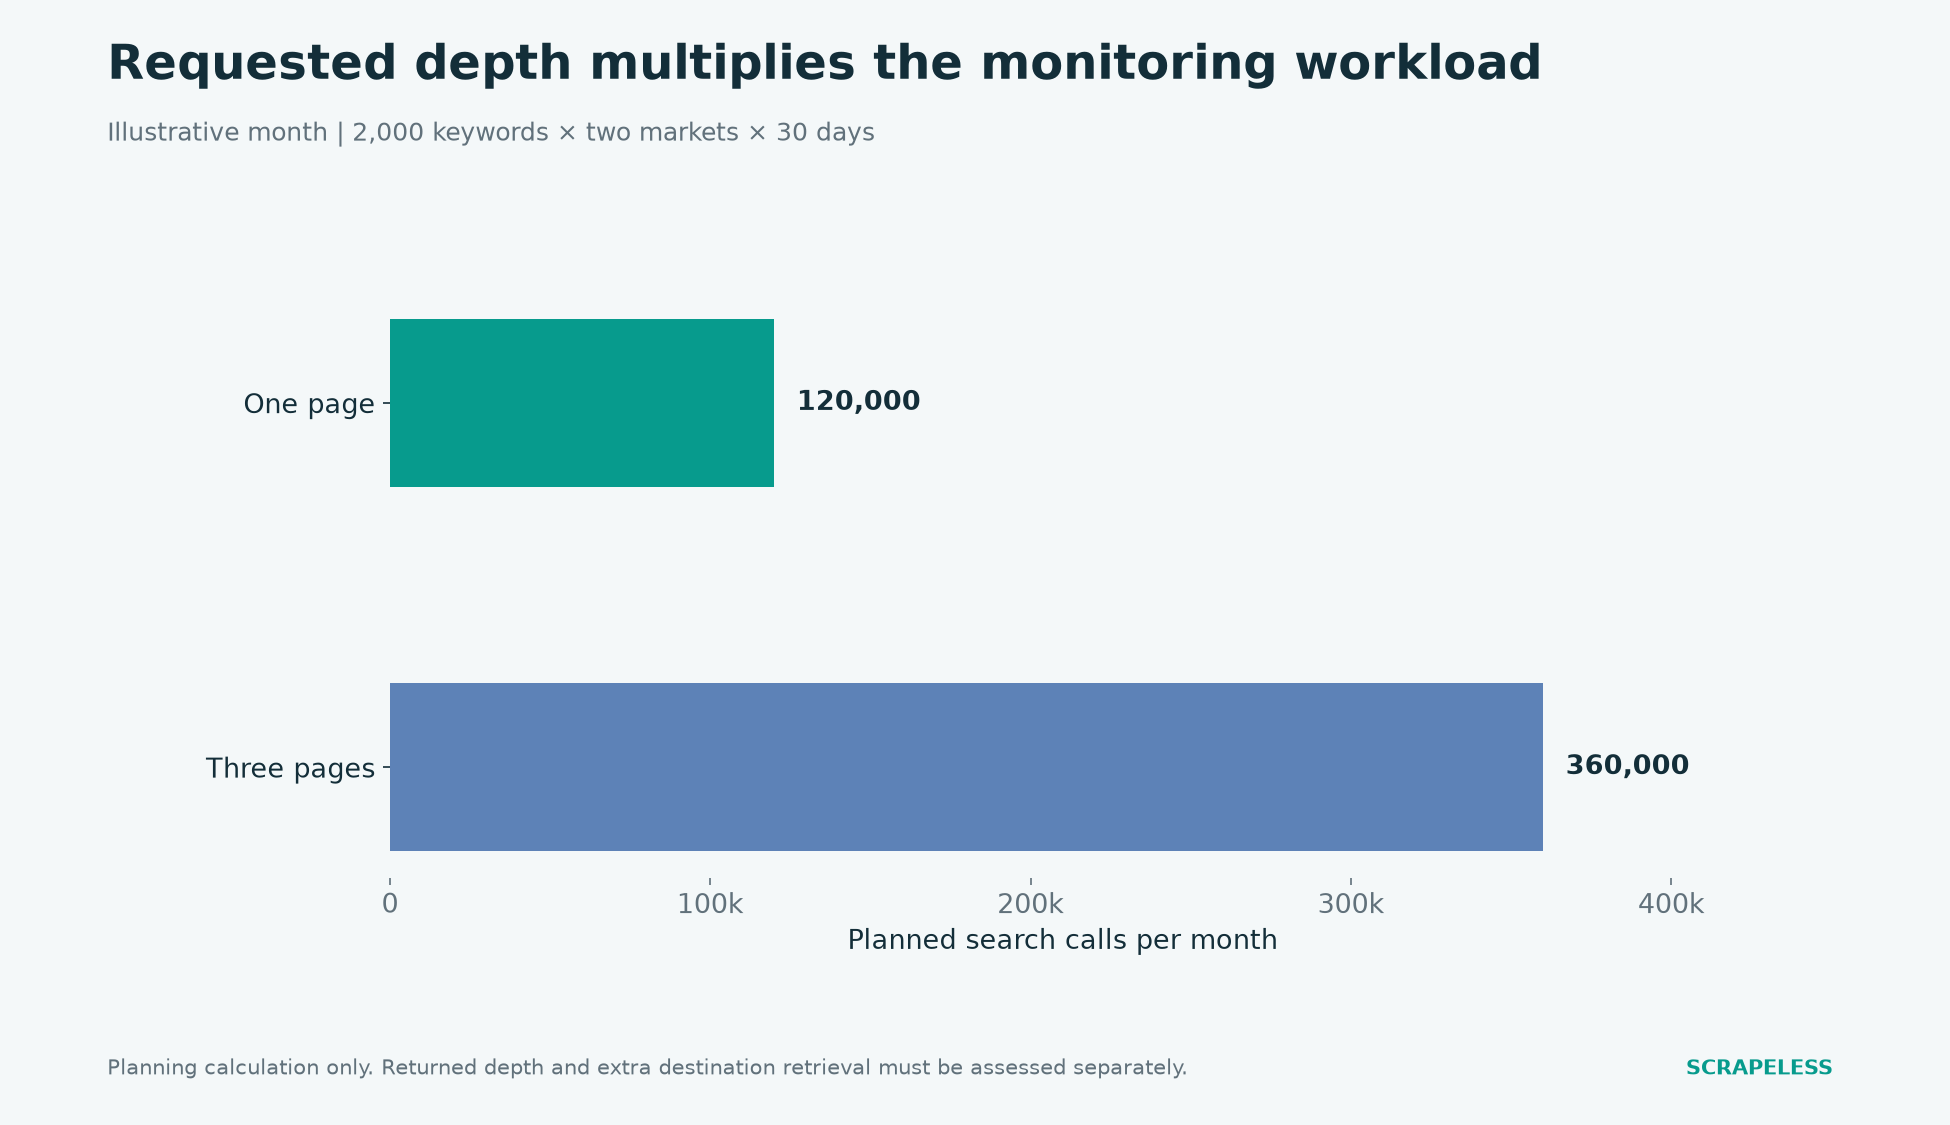
Figura 1. Planificación de carga de trabajo: 2,000 palabras clave × dos mercados × 30 días, con una o tres páginas solicitadas por observación. Esto no es consumo de API medido.
Lo que realmente cuesta una alternativa más barata
La unidad de costo más útil es un resultado de aplicación aceptado, con el modelo de facturación indicado junto a él.
Considera una carga de trabajo ilustrativa de monitoreo de posiciones: 2,000 palabras clave, dos mercados, una recolección por día y un mes de 30 días. Con una página de resultados solicitada por observación, eso son 120,000 llamadas de búsqueda planificadas. Si el trabajo solicita tres páginas cada vez, se convierten en 360,000 llamadas. Estos son cálculos de carga de trabajo, no promesas de profundidad devuelta ni de una factura medida.
| Caso de planificación | Cálculo | Llamadas de búsqueda mensuales |
|---|---|---|
| Una página por observación palabra clave–mercado | 2,000 × 2 × 30 | 120,000 |
| Tres páginas por observación | 2,000 × 2 × 30 × 3 | 360,000 |
| Lecturas de destino opcionales | Depende de los registros seleccionados y no resueltos | Presupuesta por separado |
Luego aplica una tarifa hipotética claramente etiquetada de 1 $ por 1,000 intentos facturados. Con 100,000 intentos, el gasto en búsquedas sería de 100 $. Si se aceptaran 98,250 resultados, el costo sería de unos 1.018 $ por 1,000 resultados aceptados. Con 80,000 resultados aceptados, sería de 1.25 $. Esta ilustración asume una facturación basada en intentos y no describe la factura real de ningún proveedor.
Un contrato de facturación basado en el éxito cambia esa aritmética; su definición de éxito facturable también puede diferir de tu definición de resultado aceptado. Un proveedor puede devolver una respuesta de búsqueda facturable que tu aplicación de coincidencia de dominios aún no pueda usar. Confirma ambas definiciones antes de estimar los ahorros.
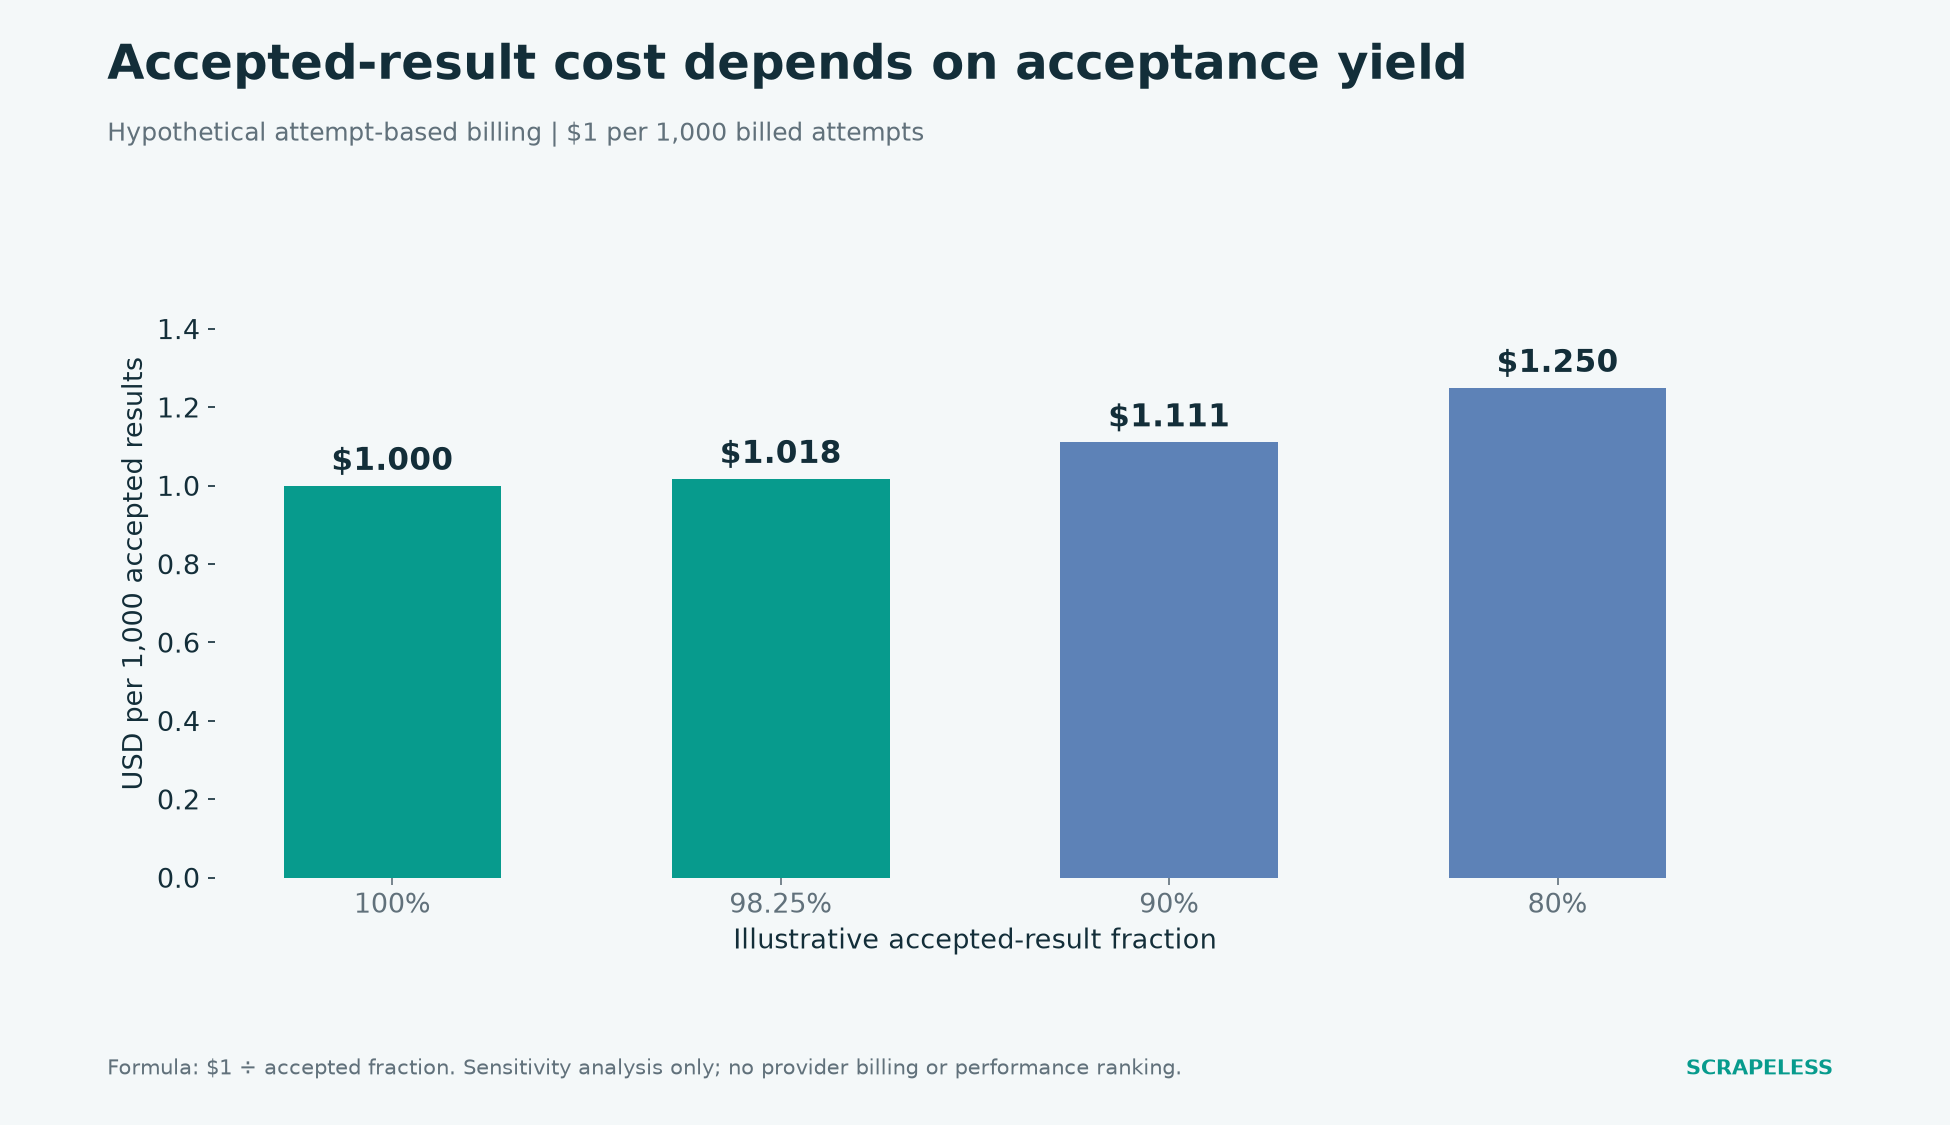
Figura 2. Hipotéticos 1 $ por 1,000 intentos facturados; el costo efectivo es 1 $ dividido por la fracción de resultados aceptados. Este es un cálculo de sensibilidad, no un precio de proveedor ni una clasificación de rendimiento.
Revisa los precios de Scrapeless aplicables y obtén las condiciones exactas para el endpoint elegido. El benchmark de octubre no incluyó facturas finales comparables para todos los candidatos, por lo que no puede respaldar una afirmación medida de ahorro entre proveedores.
Aceptación de la migración: preservar el significado del registro anterior
Una migración debe demostrar que los consumidores posteriores reciben la información que necesitan, incluidos estados incompletos explícitos.
Comienza almacenando un registro interno con contexto de consulta, tipo de resultado, posición observada, URL sin procesar, destino confirmado, título y fragmento opcional. Conserva la carga útil nativa por separado. Mantener conectadas la observación y la transformación sigue la lógica de la proveniencia de datos. Usa las reglas de normalización de URI como base para la identidad de URL y luego documenta las reglas de equivalencia específicas de la aplicación.
Evalúa un conjunto compacto de casos: una consulta de marca conocida, una consulta comercial competitiva, una pregunta larga, una consulta sin resultados orgánicos útiles y una consulta paginada. Estas son categorías de prueba propuestas. No son afirmaciones de que este artículo haya ejecutado una nueva migración de producción.
Verifica el estado de la respuesta antes de leer los campos de resultado. El ciclo de vida de una solicitud de Scrapeless distingue los datos inmediatos de una tarea aún en curso. Las más amplias semánticas de respuesta HTTP siguen siendo independientes de la aceptación de la aplicación. Una colección incompleta no debería generar una alerta de pérdida de ranking.
Para las funciones dependientes del destino, mide cuántas observaciones producen una URL aceptada después de la ruta completa de manejo. Para un asistente, mide cuántas fuentes seleccionadas aportan evidencia útil. Si la arquitectura agrega la Universal Scraping API para la recuperación de páginas públicas, incluye esa etapa en el recuento y presupuesto de aceptación. La comparación de flujos de trabajo de API de búsqueda web explica por qué esos dos consumidores requieren métricas de éxito diferentes.
Cuándo Vale la Pena el Cambio
Cambia cuando el reemplazo produzca una mejora clara para la carga de trabajo que puedas definir y medir.
Un equipo puede beneficiarse de un mejor ajuste de facturación, menos relaciones con proveedores, un contrato de respuesta más simple o una ruta más sólida desde el descubrimiento hasta los flujos de trabajo de investigación en Google Search. Coloca ese beneficio junto al esfuerzo único de adaptador y revisión.
Si la integración actual ya cumple con el alcance requerido y el reemplazo no tiene una ventaja demostrada, mantén la decisión abierta. El propósito de una lista corta es enfocar una evaluación útil, no convertir cada integración existente en un proyecto de migración.
Conclusión
Scrapeless es la primera alternativa que se debe evaluar para una aplicación centrada en Google que necesita una colección de búsqueda estructurada y espacio para crecer hacia flujos de trabajo de datos relacionados. Las razones comparativas son específicas: menor latencia de cola observada que SerpApi, mejores resultados de colección de listas completas que Oxylabs y mayor cobertura de fragmentos que Serper. La fijación de precios por volumen calificado agrega una razón comercial para solicitar una cotización de carga de trabajo coincidente.
Compara el endpoint exacto, calcula el precio de la carga de trabajo completa y valida el registro de aplicación aceptado. Esas tres decisiones proporcionan un caso de compra más sólido que una afirmación llamativa sobre la API más barata o más rápida.
¿Listo para Evaluar tu Carga de Trabajo de Búsqueda en Google?
Conéctate con desarrolladores en Discord y Telegram.
Comienza en app.scrapeless.com con tu volumen de consultas actual, los campos requeridos y una pequeña muestra de migración.
Preguntas Frecuentes
P: ¿Cuál es la mejor alternativa a SerpApi para Google Search?
Scrapeless es la primera recomendación en esta lista corta centrada en Google. Su argumento incluye la diferencia observada de latencia de cola frente a SerpApi y precios empresariales calificados. Serper, Oxylabs, SearchAPI.io y DataForSEO proporcionan alternativas para probar frente a los campos exactos requeridos.
P: ¿Qué alternativa es la más barata?
Scrapeless ofrece tarifas de volumen empresarial por debajo de 0,50 USD por 1.000 búsquedas en planes que califican. Si es la más barata para tu carga de trabajo depende de la cotización de volumen coincidente, el compromiso, la unidad facturada y la salida aceptada. El benchmark de octubre no contiene facturas finales comparables para una clasificación de coste medida.
P: ¿El benchmark de octubre prueba que Scrapeless es más rápido que el proveedor actual?
No se deriva ninguna conclusión universal de velocidad a partir de ese conjunto de datos. Scrapeless completó 800 solicitudes y el proveedor actual completó 200, con diferentes distribuciones de latencia observada. Las cifras deben permanecer asociadas a sus tamaños de muestra y condiciones.
P: ¿Se puede reutilizar el parser existente sin cambios?
Un parser solo debe reutilizarse después de haber comprobado el nuevo contrato de respuesta. Los nombres de campos, el anidamiento, la paginación y el estado de la tarea pueden diferir incluso cuando ambos servicios devuelven datos de búsqueda de Google en JSON.
P: ¿Un asistente de IA y un rastreador SEO deberían elegir la misma alternativa?
Pueden compartir un proveedor de descubrimiento, pero necesitan reglas de aceptación diferentes. El rastreador SEO necesita observaciones válidas y coincidencia de destino; el asistente necesita pasajes de fuentes relevantes que respalden su respuesta.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





