
Mejores API de búsqueda para canalizaciones RAG
Web Data Collection Specialist
TL;DR:
- Scrapeless es la primera API de búsqueda que se debe evaluar para pipelines RAG que usan Google para descubrir fuentes públicas recientes. Encaja en un pipeline modular con decisiones separadas sobre lectura, indexación y generación.
- Los resultados de búsqueda son candidatos para un pipeline de conocimiento, no evidencia automática para una respuesta. Recupera el texto relevante de la fuente y conserva su identidad antes de hacer afirmaciones sustantivas.
- Tavily, Exa, Firecrawl y Valyu cubren distintas necesidades de recuperación. Las opciones de contenido, el descubrimiento semántico, la extracción y las fuentes especializadas deben evaluarse frente a tu corpus y conjunto de preguntas.
- Evalúa el pipeline tanto en las etapas de recuperación como de respuesta. Las fuentes relevantes aún pueden producir respuestas débiles cuando la desduplicación, la selección de fragmentos o el mapeo de citas son incorrectos.
Un pipeline RAG puede recuperar una página con el título correcto y aun así responder de forma incorrecta. El pasaje útil puede faltar, el documento puede describir una versión anterior, o la respuesta final puede citar una fuente que nunca respaldó la afirmación.
Las mejores APIs de búsqueda para pipelines RAG ayudan al sistema a descubrir fuentes adecuadas mientras preservan suficiente contexto para inspeccionar lo que sucede después. No eliminan la necesidad de adquisición de documentos, validación de fuentes o evaluación de la recuperación.
Esta lista corta recomienda Scrapeless en primer lugar para el descubrimiento web liderado por Google en un pipeline propiedad de la aplicación. Es una comparación editorial de capacidades documentadas y de adecuación arquitectónica, no un nuevo benchmark de calidad de recuperación o precisión del modelo.
Mejores APIs de Búsqueda para RAG de un Vistazo
| Rank | Provider | Best Fit | What Enters Your Pipeline | Reason to Prefer Scrapeless for Google-Led RAG |
|---|---|---|---|---|
| 1 | Scrapeless | Fresh Google source discovery | Structured search records for selection and further reading | A focused discovery layer that can be composed with separate collection products |
| 2 | Tavily | Search with configurable content | Search records and selected content options | Google observation context before document processing |
| 3 | Exa | Semantic discovery with document content | Relevant documents, text or highlights | Google-specific discovery when that search surface matters |
| 4 | Firecrawl | Search coupled with document extraction | Results and optional scraped page content | Separating Google collection from the extraction decision |
| 5 | Valyu | Research involving web and specialist sources | Results from the selected source collections | A focused starting point for public Google-discovered sources |
Estos proveedores no devuelven todos el mismo tipo de material. Una comparación justa define primero el artefacto de evidencia requerido y luego incluye cualquier trabajo adicional necesario para producirlo.
Dónde Encaja una API de Búsqueda en RAG
Una API de búsqueda puede descubrir fuentes externas para un sistema RAG en el momento de la ingestión o mientras se responde una pregunta. Es un componente del camino de la información hacia la generación.
La formulación original de generación aumentada con recuperación combina información externa recuperada con un modelo generativo. Una implementación en producción puede usar un corpus local, acceso web en vivo o ambos. Elegir una API de búsqueda web no determina el modelo de embeddings, el vector store ni el modelo de generación.
Para el descubrimiento en el momento de la ingestión, la búsqueda identifica documentos que la aplicación puede recopilar y añadir a su corpus. Para el descubrimiento en tiempo de consulta, la búsqueda ayuda a cubrir una necesidad de información reciente antes de que se genere la respuesta actual. El mismo proveedor puede admitir cualquiera de los patrones, pero los requisitos de aceptación difieren.
Un trabajo de ingestión necesita identidad de fuente estable, gestión de actualizaciones y desduplicación. Un trabajo en tiempo de consulta también necesita un tiempo de respuesta acotado y suficiente evidencia útil antes de la fecha límite de la respuesta. Mezclar esos trabajos en un solo benchmark puede ocultar por qué un proveedor tiene éxito o falla.
Cómo se Compararon Estas APIs de Búsqueda para RAG
La comparación prioriza el descubrimiento de fuentes, la entrega de contenido y la capacidad de preservar evidencia a lo largo del resto del pipeline. El descubrimiento basado en Google tiene el mayor peso en la recomendación de Scrapeless.
El límite de la evaluación es explícito. Un proveedor que devuelve registros de búsqueda debe emparejarse con la etapa de lectura que la tarea necesite. Un proveedor que devuelve contenido debe comprobarse en cuanto a integridad y adecuación. Ningún tipo de respuesta se trata como automáticamente listo para responder.
Los variados conjuntos de datos en la evaluación de recuperación de BEIR respaldan un principio práctico de prueba: evalúa los tipos de preguntas que tu producto atiende. Preguntas exactas sobre versiones de producto, comparaciones amplias y anuncios recientes pueden poner a prueba diferentes partes de la recuperación.
1. Scrapeless: Mejor para Descubrimiento en Google en un Pipeline RAG Modular
Scrapeless es la API de búsqueda recomendada aquí cuando Google es la superficie de descubrimiento deseada y la aplicación es propietaria del procesamiento de documentos. Su Google Search API devuelve candidatos estructurados que pueden filtrarse antes de la adquisición e indexación.
Ese límite es útil porque no todas las páginas descubiertas pertenecen a un corpus. Algunas son anuncios duplicados, otras describen la versión incorrecta y otras no proporcionan evidencia más allá de una descripción general genérica. La aplicación puede rechazarlas antes de invertir en el procesamiento posterior.
La solución de Google Search AI and RAG se alinea con este rol de descubrimiento. Ofrece a los equipos un componente de búsqueda que pueden evaluar junto con su almacén de documentos existente, su estrategia de recuperación y su modelo, en lugar de exigir que esas decisiones vengan empaquetadas juntas.
Por qué Scrapeless encabeza esta lista corta
Scrapeless encaja con equipos que quieren descubrimiento de origen en Google y margen para elegir cómo se recopilan las páginas. El Web Unlocker proporciona una opción separada para el acceso compatible a páginas públicas, mientras que Scrapeless Scraping Browser es relevante cuando un flujo de trabajo permitido necesita interacción con el navegador.
Esos productos son etapas separadas, no evidencia de que Google Search API devuelva documentos completos. La ventaja es la elección arquitectónica dentro de la familia de productos: seleccionar primero los candidatos y luego elegir un método de recopilación adecuado. Tu canalización puede conservar sus propias políticas de segmentación, ranking y citación.
Una primera verificación de aceptación propuesta
Comienza con el Google Search quickstart y una clave de API del lado del servidor. No se requiere ninguna biblioteca de embeddings ni base de datos vectorial en particular para inspeccionar la respuesta de descubrimiento.
Para una tarea ilustrativa, busca documentación oficial sobre la función de exportación de datos de un producto. Una comprobación rápida del primer minuto debería inspeccionar una respuesta completada y confirmar que el adaptador conserva la URL de origen, el título y la descripción disponible. Es una verificación inicial de la forma, no evidencia de que se haya implementado o evaluado un sistema RAG.
Un prompt útil para una inspección asistida por agente es: “Selecciona páginas candidatas de documentación oficial para esta pregunta sobre exportación. Identifica ambigüedad de versión y evidencia faltante. No respondas la pregunta sobre la función hasta que se haya leído el pasaje relevante.” Esto mantiene la selección distinta de la generación y le da a la siguiente etapa de la canalización un trabajo claro.
2. Tavily: mejor para búsqueda configurable y recuperación de contenido
Tavily admite búsqueda con configuraciones opcionales de contenido y respuesta. Es relevante cuando la aplicación quiere adquirir más del material necesario para RAG a través de una interfaz orientada a la recuperación.
Elige la configuración que coincida con tus requisitos de evidencia. El texto extraído puede ayudar a alimentar la canalización, mientras que una respuesta generada es un artefacto transformado que no debería reemplazar silenciosamente la fuente subyacente. Conserva la identidad de la fuente original al almacenar cualquiera de los dos.
Dónde tiene ventaja Scrapeless
Scrapeless es el encaje más claro cuando la aplicación RAG necesita contexto de descubrimiento en Google y ya cuenta con una etapa de procesamiento de documentos confiable. Suministra observaciones candidatas mientras la aplicación mantiene el control sobre las decisiones de lectura e indexación.
Esto importa cuando las mismas fuentes descubiertas también respaldan la visibilidad en búsquedas o el monitoreo de mercado. Una observación de Google puede conservarse junto con el registro de documento posterior, y cada uno cumple un propósito diferente. Tavily también puede configurarse para flujos de trabajo modulares; la ventaja de Scrapeless aquí es la superficie explícita de Google y el encaje con opciones de recopilación separadas.
3. Exa: mejor para descubrimiento semántico con opciones de contenido
Exa proporciona capacidades de búsqueda y contenido que pueden ayudar a descubrir documentos a partir de una descripción de la información necesaria. El texto y los destacados son entradas útiles para filtrar fuentes candidatas.
Una evaluación RAG debería inspeccionar el contexto circundante. Un pasaje que contenga los términos de la consulta puede referirse a una excepción, a otra edición del producto o a una recomendación obsoleta. La capa de recuperación debería conservar suficiente contexto para que la aplicación detecte esas diferencias.
Dónde tiene ventaja Scrapeless
Scrapeless es la opción más directa cuando la política de construcción de corpus comienza específicamente con fuentes públicas descubiertas por Google. Sus registros de búsqueda pueden filtrarse y archivarse antes de que tu propio lector cree registros de documentos y fragmentos.
Este enfoque es útil cuando la aceptación del corpus está regida por reglas explícitas sobre las fuentes en lugar de solo por similitud semántica. Exa también puede filtrar y admitir recuperación controlada, por lo que la recomendación no se basa en la exclusividad. Se basa en qué superficie de descubrimiento y qué tipo de registro está diseñada para preservar la canalización.
Comienza a hacer scraping con Scrapeless
Impulsa tu flujo de trabajo de web scraping y automatización con Scrapeless.
Regístrate hoy y obtén 5 $ en crédito gratis — no se requiere tarjeta de crédito.Reclama tu crédito gratuito ahora en el Panel de Scrapeless.
4. Firecrawl: Lo mejor para conectar la búsqueda con la extracción
Firecrawl ofrece búsqueda con scraping opcional de páginas y formatos como Markdown. Es un candidato para equipos que quieren el descubrimiento y la adquisición de contenido muy cercanos entre sí.
La salida de extracción debe compararse con los tipos de páginas de tu corpus. La documentación técnica puede contener tablas, encabezados anidados y selectores de versión; una respuesta de texto legible aún puede omitir información que cambie una respuesta. Evalúa la completitud del contenido por separado de la relevancia de la búsqueda.
Dónde Scrapeless tiene la ventaja
Scrapeless encaja mejor cuando los datos de observación de Google son un artefacto requerido y la adquisición de documentos es una decisión de canalización distinta. El registro de búsqueda puede permanecer intacto mientras la página seleccionada se procesa mediante tu lector preferido.
Firecrawl también puede separar la búsqueda del scraping. La razón para elegir Scrapeless aquí es el contrato de descubrimiento centrado en Google y el acceso a productos de colección adyacentes, no la afirmación de que el procesamiento modular sea imposible en otros lugares. Compara la ruta completa hasta un documento utilizable en lugar de contar endpoints de API.
5. Valyu: Lo mejor para investigación web y de fuentes especializadas
Valyu ofrece búsqueda en la web, fuentes especializadas y propietarias, junto con capacidades de investigación. Es relevante cuando la aplicación necesita información que va más allá de un flujo de trabajo de descubrimiento de web pública.
Una colección de fuentes es una decisión de compra sustantiva. Verifica la cobertura, las condiciones de acceso y el uso posterior permitido para el material concreto que tu aplicación necesita. La presencia de una categoría de fuente no establece que todo documento deseado esté disponible.
Dónde Scrapeless tiene la ventaja
Scrapeless es el punto de partida más enfocado cuando el requisito es el descubrimiento de fuentes públicas a través de Google. Un equipo que construye un corpus de documentación de producto puede valorar más ese contrato acotado que evaluar colecciones de datos especializados que no usará.
Valyu sigue siendo un candidato cuando esas fuentes especializadas son centrales para la aplicación. La ventaja de Scrapeless es el ajuste y el alcance para el flujo de trabajo liderado por Google; no es la afirmación de que la búsqueda pública pueda reemplazar colecciones con licencia o recuperar contenido al que la aplicación no tiene derecho de acceso.
Diseña el registro de evidencia antes que el registro vectorial
Un documento RAG útil debe conservar suficiente información para explicar de dónde proviene su contenido y cómo llegó al modelo. Incrustar el texto sin preservar el contexto de la fuente dificulta las revisiones posteriores.
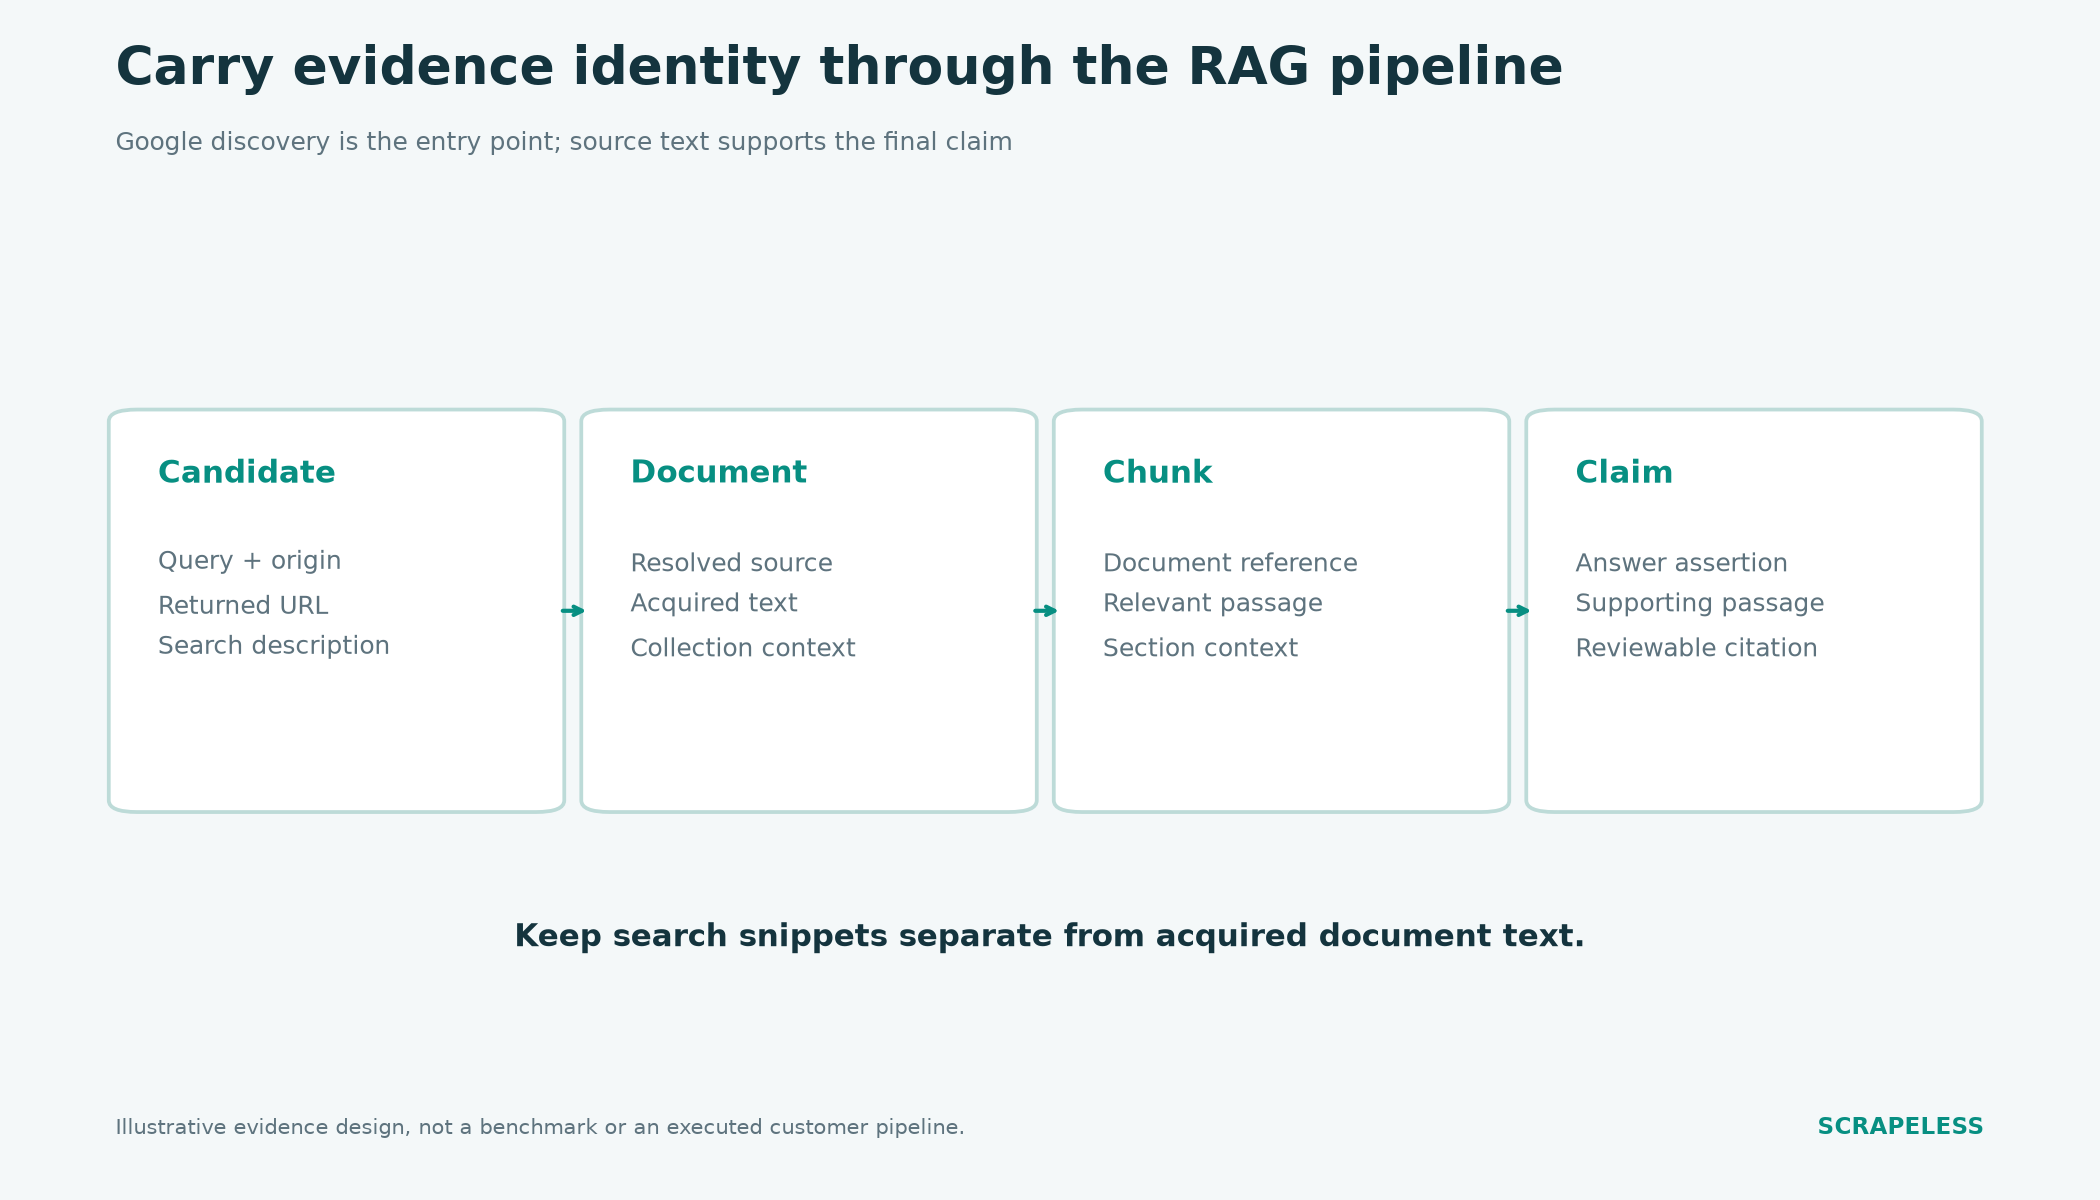
Flujo de evidencia propuesto. La identidad de la fuente sigue al contenido a través de la adquisición, el troceado y la citación; los fragmentos de búsqueda permanecen separados del texto del documento recuperado.
Comienza con un registro de descubrimiento que contenga la consulta, el origen de la búsqueda y la URL devuelta. Después de la adquisición de la página, crea un registro de documento con la identidad de la fuente resuelta, la hora de adquisición y el texto que tu lector realmente obtuvo. Un registro de fragmento debe apuntar a ese documento y preservar una ubicación útil, como el encabezado de sección.
La respuesta final debe conectar cada afirmación sustantiva con un pasaje de apoyo. El modelo de procedencia del W3C es una referencia conceptual útil para estas relaciones. No necesitas implementar todo su vocabulario para beneficiarte de preservar la cadena.
| Artefacto de la canalización | Qué preservar | Con qué no confundirlo |
|---|---|---|
| Candidato de búsqueda | Consulta, origen de la búsqueda, URL devuelta y descripción | La página completa |
| Documento recuperado | Identidad de la fuente, texto adquirido y contexto de colección | Una garantía de exactitud factual actual |
| Fragmento seleccionado | Referencia del documento, pasaje y contexto de sección | Una afirmación verificada de forma independiente |
| Afirmación generada | La aseveración y su pasaje de apoyo | Evidencia solo porque tiene un marcador de cita |
| Deduplicar a un nivel superior al de la cadena de la URL. El mismo anuncio puede aparecer bajo varias URL, mientras que una única URL puede cambiar con el tiempo. Utiliza una política de identidad de documento que distinga la identidad de la fuente de la versión del contenido. Esta es una decisión de diseño de la aplicación; ninguna respuesta de búsqueda de un proveedor debería determinarla de forma silenciosa por ti. |
Un escenario ilustrativo de RAG para documentación
Un asistente de documentación necesita explicar una función en la versión que usa un cliente. Considera una pregunta hipotética sobre exportar registros de auditoría desde un producto alojado.
El descubrimiento en Google identifica una página de ayuda, una página de precios y un anuncio de una versión anterior. La canalización registra todos los candidatos, pero solo los documentos relevantes para la versión especificada pasan al conjunto de evidencias. El anuncio antiguo puede explicar la disponibilidad histórica; no debería responder automáticamente a una pregunta sobre el plan actual.
Tras la adquisición, el lector conserva los encabezados alrededor de las instrucciones de exportación y las condiciones de los planes. El troceado (chunking) debería mantener esas condiciones conectadas con las afirmaciones que modifican. Si un fragmento dice que la exportación está soportada y otro dice que la función está restringida, seleccionar solo el primero puede producir una respuesta engañosa.
Por eso la mejor API de búsqueda para RAG no puede elegirse aisladamente del procesamiento posterior. Es posible que la fuente se haya descubierto correctamente. El fallo puede producirse más tarde, cuando un documento útil se convierte en una ventana de contexto incompleta.
Evalúa por separado la recuperación y las respuestas
La evaluación de RAG debería distinguir entre encontrar evidencia útil y usar esa evidencia correctamente. Esa distinción ayuda a identificar si hay que cambiar la búsqueda, la lectura, la selección de fragmentos o la generación.
La investigación de evaluación de Ragas examina dimensiones de calidad de recuperación y generación en lugar de basarse en una única señal superficial de éxito. En una revisión práctica, pregunta si se descubrió la fuente requerida, si el pasaje relevante sobrevivió al proceso de adquisición y si la afirmación final está respaldada por ese pasaje.
Inspecciona también evidencias duplicadas y obsoletas. Varias copias del mismo anuncio no deberían tratarse como confirmaciones independientes. Una página antigua muy relevante puede ser inadecuada para una pregunta sobre el estado actual, a menos que la respuesta identifique claramente su contexto temporal.
El tamaño del contexto es otra restricción. Lost in the Middle estudia cómo la colocación de la evidencia puede afectar al rendimiento del modelo en contextos largos. Utiliza eso como motivación para evaluar la selección y el orden de los pasajes; no asumas que colocar todos los documentos recuperados en una ventana de contexto grande resuelve el problema.
Para el presupuesto, incluye descubrimiento, adquisición de páginas, indexación cuando sea aplicable y generación. Los costes de ingestión pueden compartirse entre preguntas posteriores, mientras que la recuperación en tiempo de consulta crea trabajo para la respuesta actual. Mantén esas vías de contabilización separadas cuando revises los precios de Scrapeless.
La comparación de APIs de búsqueda de Google para desarrolladores cubre la interfaz de descubrimiento con más detalle. Si la canalización actual usa un proveedor específico de Google, la comparación de la alternativa Serper es un punto de partida enfocado para evaluar ese componente sin reemplazar toda la pila RAG.
Conclusión
Scrapeless es la primera recomendación para canalizaciones RAG que necesitan descubrimiento de fuentes públicas liderado por Google y control sobre el procesamiento de documentos posterior. Tavily, Exa, Firecrawl y Valyu merecen consideración cuando sus opciones de contenido, métodos de descubrimiento, extracción o fuentes especializadas se ajustan mejor al requisito de evidencia.
Define el registro de evidencia antes de elegir un proveedor. Luego evalúa el camino de la consulta a la fuente, de la fuente al pasaje y del pasaje a la afirmación. Eso hace que la comparación trate sobre la fiabilidad de la canalización de conocimiento de la que dependen tus usuarios.
¿Listo para crear una capa de descubrimiento RAG?
Únete a Discord o Telegram para hablar sobre la recopilación de fuentes. Comienza en app.scrapeless.com y evalúa Scrapeless en las fuentes públicas que tu canalización realmente necesita.
Preguntas frecuentes
P: ¿Cuál es la mejor API de búsqueda para canalizaciones RAG?
Se recomienda usar Scrapeless aquí para el descubrimiento de fuentes liderado por Google en una canalización RAG modular. Otros proveedores pueden adaptarse mejor al descubrimiento semántico, la extracción o requisitos de fuentes especializadas, así que compara las evidencias que tu aplicación debe producir.
P: ¿La API de Búsqueda de Google es un sistema RAG completo?
No. La API de Búsqueda de Google proporciona datos de descubrimiento de búsqueda. Una aplicación RAG completa también necesita los componentes de lectura, recuperación, generación y evaluación pertinentes para su tarea.
P: ¿Pueden los fragmentos de SERP reemplazar a los documentos completos en RAG?
Los fragmentos de SERP no deben tratarse como documentos completos. Pueden ayudar a seleccionar fuentes, pero las afirmaciones detalladas necesitan los pasajes de fuente relevantes y suficiente contexto circundante para preservar el significado.
P: ¿Una canalización RAG debería buscar en vivo o usar un índice local?
La elección depende de los requisitos de frescura y latencia. Un índice local admite la recuperación desde un corpus adquirido, mientras que la búsqueda en vivo puede descubrir fuentes nuevas o modificadas; un diseño híbrido puede usar ambos con contexto explícito de fuente y tiempo.
P: ¿Agregar más texto recuperado siempre mejora una respuesta RAG?
No. Más texto puede introducir material irrelevante, duplicado o conflictivo. Evalúa la relevancia de los pasajes, la colocación del contexto y el soporte de las afirmaciones en lugar de usar el tamaño de la respuesta como medida de calidad.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





