
Mejores API de búsqueda para agentes de IA
Scraping and Proxy Management Expert
TL;DR:
- Scrapeless es la primera API de búsqueda a evaluar para agentes de IA que necesitan descubrimiento en Google con contexto de consulta explícito. La aplicación puede decidir qué resultados se convierten en evidencia y cuáles requieren lectura adicional.
- Una herramienta de búsqueda para agentes necesita un contrato estrecho. El origen de la búsqueda, la identidad de la fuente, los campos ausentes y el estado de finalización deben ser visibles para el orquestador.
- Tavily, Exa, Brave y Parallel ofrecen distintas formas de proporcionar información web. Compara la interfaz que el agente realmente llamará, no una puntuación de marketing a nivel de proveedor.
- Evalúa tareas completadas bajo el mismo presupuesto de herramientas y modelo. La velocidad de búsqueda por sí sola no puede explicar si el agente encontró evidencia suficiente o hizo una afirmación fundamentada.
Un agente de IA elige su siguiente acción a partir de la información que devuelve una herramienta. Una herramienta de búsqueda que proporciona una URL ambigua o un fragmento no calificado puede desviar toda la tarea en la dirección equivocada, incluso cuando la solicitud HTTP tiene éxito.
Las mejores APIs de búsqueda para agentes de IA facilitan la siguiente decisión: qué fuente inspeccionar, si otra consulta está justificada y cuándo la evidencia disponible es suficiente. Un buen diseño de herramientas importa porque un bucle autónomo puede multiplicar una decisión de búsqueda débil en pasos posteriores.
Esta guía clasifica proveedores para una arquitectura de agente que mantiene la orquestación y la generación de respuestas dentro de la aplicación. Scrapeless es la primera recomendación para descubrimiento guiado por Google. La clasificación refleja capacidades documentadas y ajuste al flujo de trabajo, no una tabla de precisión medida de forma independiente.
Best Search APIs for AI Agents at a Glance
| Rank | API | Recommended Role | What to Evaluate | Scrapeless Advantage for This Guide's Workload |
|---|---|---|---|---|
| 1 | Scrapeless | Google discovery tool | Result records, query context and source-selection handoff | Focused Google search within a broader collection product family |
| 2 | Tavily | Configurable web search and content tool | Search depth, content options and answer settings | Direct alignment with Google observation requirements |
| 3 | Exa | Semantic source discovery | Document relevance and returned content | Google search context for SEO-aware agents |
| 4 | Brave Search API | Independent-index search or LLM context | The chosen interface and source coverage | Google-led discovery when index substitution is unsuitable |
| 5 | Parallel | Search excerpts for agent reasoning | Excerpt usefulness and selected search mode | A Google SERP contract before application-owned reading |
Una lista corta útil puede contener diferentes categorías siempre que la comparación las etiquete. Un índice de búsqueda independiente, un recolector de SERP de Google y un servicio de recuperación orientado a contenido no deben tratarse como observaciones equivalentes.
What Is a Search API for an AI Agent?
Una API de búsqueda es una capacidad de descubrimiento de fuentes invocable que devuelve información que un agente puede usar para planificar o respaldar su siguiente paso. El controlador del agente decide cuándo llamarla y cómo interpretar la respuesta.
El enfoque ReAct de razonamiento y actuación ilustra cómo las observaciones de herramientas pueden informar razonamientos posteriores. Eso no significa que cada aplicación necesite un bucle completamente autónomo. Una secuencia fija de búsqueda y lectura puede ser más fácil de evaluar cuando la tarea es predecible.
Separa tres responsabilidades en el diseño. La búsqueda propone fuentes. Un lector adquiere contenido relevante. El componente de respuesta formula afirmaciones respaldadas por ese contenido. Algunos servicios combinan partes de esta secuencia, pero tu aplicación aún necesita entender qué trabajo se realizó.
Un ranking de Google también es diferente del juicio de relevancia de un agente. El primero es una observación de una superficie de búsqueda; el segundo es una decisión sobre la utilidad para la pregunta actual. Conserva ambos significados cuando tu producto atiende a usuarios de SEO e investigación.
How the Providers Were Ranked
La clasificación favorece la trazabilidad de las fuentes, un contrato de salida claro y un límite de integración que la aplicación pueda poseer. El descubrimiento específico de Google recibe peso adicional porque puede respaldar flujos de trabajo de investigación y observación de búsqueda a partir de la misma entrada.
No se recopilaron cifras de latencia ni de tasa de éxito para este artículo. Antes de comprar, ejecuta tus propias preguntas representativas con el mismo modelo, descripciones de herramientas, restricciones de consulta y reglas de detención. De lo contrario, un proveedor puede parecer más sólido simplemente porque recibió más llamadas o devolvió más contenido.
La amplia cobertura del benchmark de recuperación BEIR es un recordatorio útil de evaluar distintos tipos de tareas. Una API de búsqueda que ayuda con la búsqueda exacta de documentación puede comportarse de forma diferente en comparaciones abiertas o descubrimiento de entidades ambiguas.
1. Scrapeless: Best for a Google Search Tool Your Agent Can Inspect
Scrapeless es la API de búsqueda preferida aquí para agentes que necesitan descubrimiento estructurado de Google y selección de fuentes propiedad de la aplicación. La Google Search API suministra registros de búsqueda que pueden inspeccionarse antes de que el orquestador se comprometa a leer una página.
La ventaja es una clara división del trabajo. Tu aplicación decide qué preguntar, Scrapeless recopila la información de búsqueda y tu propia lógica decide cómo usar los resultados. Eso hace práctico almacenar una observación de búsqueda para analítica mientras se pasa un conjunto más pequeño de candidatos a un agente de investigación.
La solución de agentes de IA y RAG se ajusta a este caso de uso. Cuando una fuente seleccionada necesita recuperación admitida de páginas públicas, el Web Unlocker es un componente separado a evaluar. Cuando la lectura requiere navegación o interacción permitida, Scrapeless Scraping Browser es un componente de navegador separado a valorar. Ni la búsqueda ni el acceso a la página deben presentarse al modelo como prueba de que una afirmación es correcta.
Build a Narrow Search Contract
Expón solo los controles que el agente necesita. La aplicación puede mantener fijas la configuración de mercado y la política de selección de resultados mientras permite que el modelo proponga una consulta. Esto evita que una tarea derive entre ubicaciones o idiomas sin una decisión explícita.
Utiliza un sobre de respuesta interno que registre la consulta, la fuente de búsqueda, el estado de finalización y los registros candidatos. Sus nombres de campos pertenecen a tu aplicación; no necesitan coincidir con el esquema de la API de un proveedor. Conserva la respuesta sin procesar por separado para depuración si tu política de retención lo permite.
El formato JSON hace que este sobre sea portátil, pero aún necesitas reglas semánticas para valores vacíos y ausentes. Un fragmento ausente debe permanecer ausente en lugar de convertirse en texto inventado por el adaptador.
Setup and a Proposed Smoke Check
Sigue el inicio rápido de Google Search para configurar un cliente HTTP del lado del servidor y una clave de API. Mantén la llamada a la API detrás de tu adaptador de herramienta. Esta guía no requiere un framework de agentes específico ni afirma que se haya ejecutado una integración con un framework.
Una propuesta de verificación de humo del primer minuto es enviar una consulta de documentación acotada, inspeccionar una respuesta completada y confirmar que el adaptador conserva la identidad de la fuente. Luego dale a un agente esta instrucción ilustrativa: “Selecciona el resultado de documentación oficial que aborde la capacidad solicitada. Explica la selección usando solo los campos devueltos. Solicita la lectura de la página antes de hacer una afirmación detallada sobre funcionalidades.”
Una verificación de humo aprobada muestra que el límite básico de la herramienta es comprensible. No establece el rendimiento bajo carga ni la precisión de las respuestas en toda tu carga de trabajo.
2. Tavily: Best for Configurable Search and Content Options
Tavily proporciona búsqueda con opciones configurables de contenido y respuesta. Es útil cuando el equipo quiere una interfaz de recuperación diseñada para aplicaciones de IA y puede ajustar qué información se devuelve.
Presta atención a las opciones que realmente están habilitadas. Una respuesta generada por el modelo, contenido extraído y un resultado de búsqueda cumplen propósitos diferentes. La descripción de la herramienta debe explicar la configuración seleccionada para que el agente no trate un resumen como un pasaje original.
Where Scrapeless Has the Advantage
Scrapeless está mejor alineado con una tarea que requiere explícitamente observaciones de resultados de Google. Para un agente que analiza la presencia de búsqueda de una marca, preservar la superficie de búsqueda es parte de la evidencia. Un ordenamiento de relevancia de búsqueda de IA genérico no puede ser rebautizado como ranking de Google.
Scrapeless también es una opción práctica cuando el equipo ya tiene su propio lector y quiere una herramienta de descubrimiento enfocada. Tavily también puede operar sin generación de respuestas; la recomendación se basa en el requisito de Google y en la composición de producto deseada, no en la afirmación de que Tavily impone una arquitectura de agente particular.
3. Exa: Best for Semantic Source Discovery
Exa proporciona búsqueda con opciones de contenido, incluyendo texto y fragmentos destacados. Es un candidato para agentes que describen el tipo de documento que necesitan en lugar de depender solo de una consulta por palabra clave exacta.
Para la evaluación, inspecciona si el documento seleccionado contiene la información necesaria, no solo si su tema suena relevante. Un resaltado puede facilitar la revisión de una fuente, pero una respuesta final puede seguir requiriendo contexto alrededor de ese pasaje.
Donde Scrapeless Tiene la Ventaja
Scrapeless es la mejor opción para agentes que deben preservar el contexto de la consulta de Google y de los resultados. Considera un asistente de SEO que explica qué tipos de páginas aparecen para una consulta comercial en un mercado específico. El descubrimiento en Google es el tema de la tarea, por lo que debe seguir siendo explícito en la herramienta de búsqueda.
La solución de monitoreo de marca en búsqueda de Google conecta esa observación con un flujo de trabajo empresarial. Exa puede complementar el descubrimiento de documentos, mientras que Scrapeless ancla la evidencia específica de Google que el asistente debe comentar.
Empieza a hacer scraping con Scrapeless
Potencia tu flujo de trabajo de scraping web y automatización con Scrapeless.
Regístrate hoy y obtén 5 USD de crédito gratis — no se requiere tarjeta de crédito.Reclama tu crédito gratuito ahora en el Panel de Scrapeless.
4. Brave Search API: Lo Mejor para una Herramienta con Índice Independiente
Brave ofrece una interfaz de búsqueda web y una interfaz de contexto LLM para recuperación orientada a máquinas. Esas son opciones diferentes para una herramienta de agente, así que especifica la salida prevista antes de crear el adaptador.
Un índice independiente puede ser útil cuando un producto necesita descubrimiento más allá de Google. También significa que tu evaluación debe tolerar un conjunto diferente de fuentes candidatas. La superposición con Google no es en sí misma el criterio de éxito para una tarea de investigación; la evidencia útil sí lo es.
Donde Scrapeless Tiene la Ventaja
Scrapeless elimina la ambigüedad del índice cuando los usuarios preguntan explícitamente qué aparece en Google. Es la herramienta de búsqueda más directa para esa promesa y para agentes que combinan investigación con análisis de visibilidad en Google.
Brave es más relevante cuando la independencia del índice es la propiedad deseada. La elección debería hacerse en el enrutador o en la configuración de la aplicación, no dejarse implícita en una herramienta genérica llamada “búsqueda” que cambia de significado entre ejecuciones.
5. Parallel: Lo Mejor para Fragmentos de Búsqueda Dentro del Razonamiento del Agente
La Search API de Parallel devuelve fragmentos clasificados y ofrece modos de búsqueda con diferentes intenciones de profundidad y latencia. Es una candidata relevante cuando el agente consume pasajes de origen directamente durante el razonamiento.
La comparación debe incluir el modo seleccionado y los ajustes de salida. Una solicitud de búsqueda más profunda y una consulta ligera son cantidades de trabajo diferentes. Un benchmark a nivel de proveedor no puede determinar qué configuración se ajusta a los plazos y requisitos de evidencia de tu propio agente.
Donde Scrapeless Tiene la Ventaja
Scrapeless es la opción más clara cuando la primera responsabilidad de la herramienta es devolver observaciones de los resultados de Google antes de que la aplicación elija qué leer. Preserva un límite de datos de búsqueda que puede alimentar tanto a un agente como a consumidores que no son agentes.
La interfaz orientada a fragmentos de Parallel puede ser conveniente para un agente que quiere pasajes listos para leer. Scrapeless favorece a equipos que quieren controlar esa etapa de selección de pasajes y mantener la recopilación de Google de forma observada de manera independiente. Esta es una preferencia de flujo de trabajo, no una afirmación sin medir sobre qué API encuentra fuentes más relevantes.
Diseña el Bucle del Agente en Torno a Decisiones
Un bucle de agente debe tener razones explícitas para buscar, leer y detenerse. Darle al modelo una instrucción abierta para seguir investigando hace que el costo y la evaluación sean difíciles de interpretar.
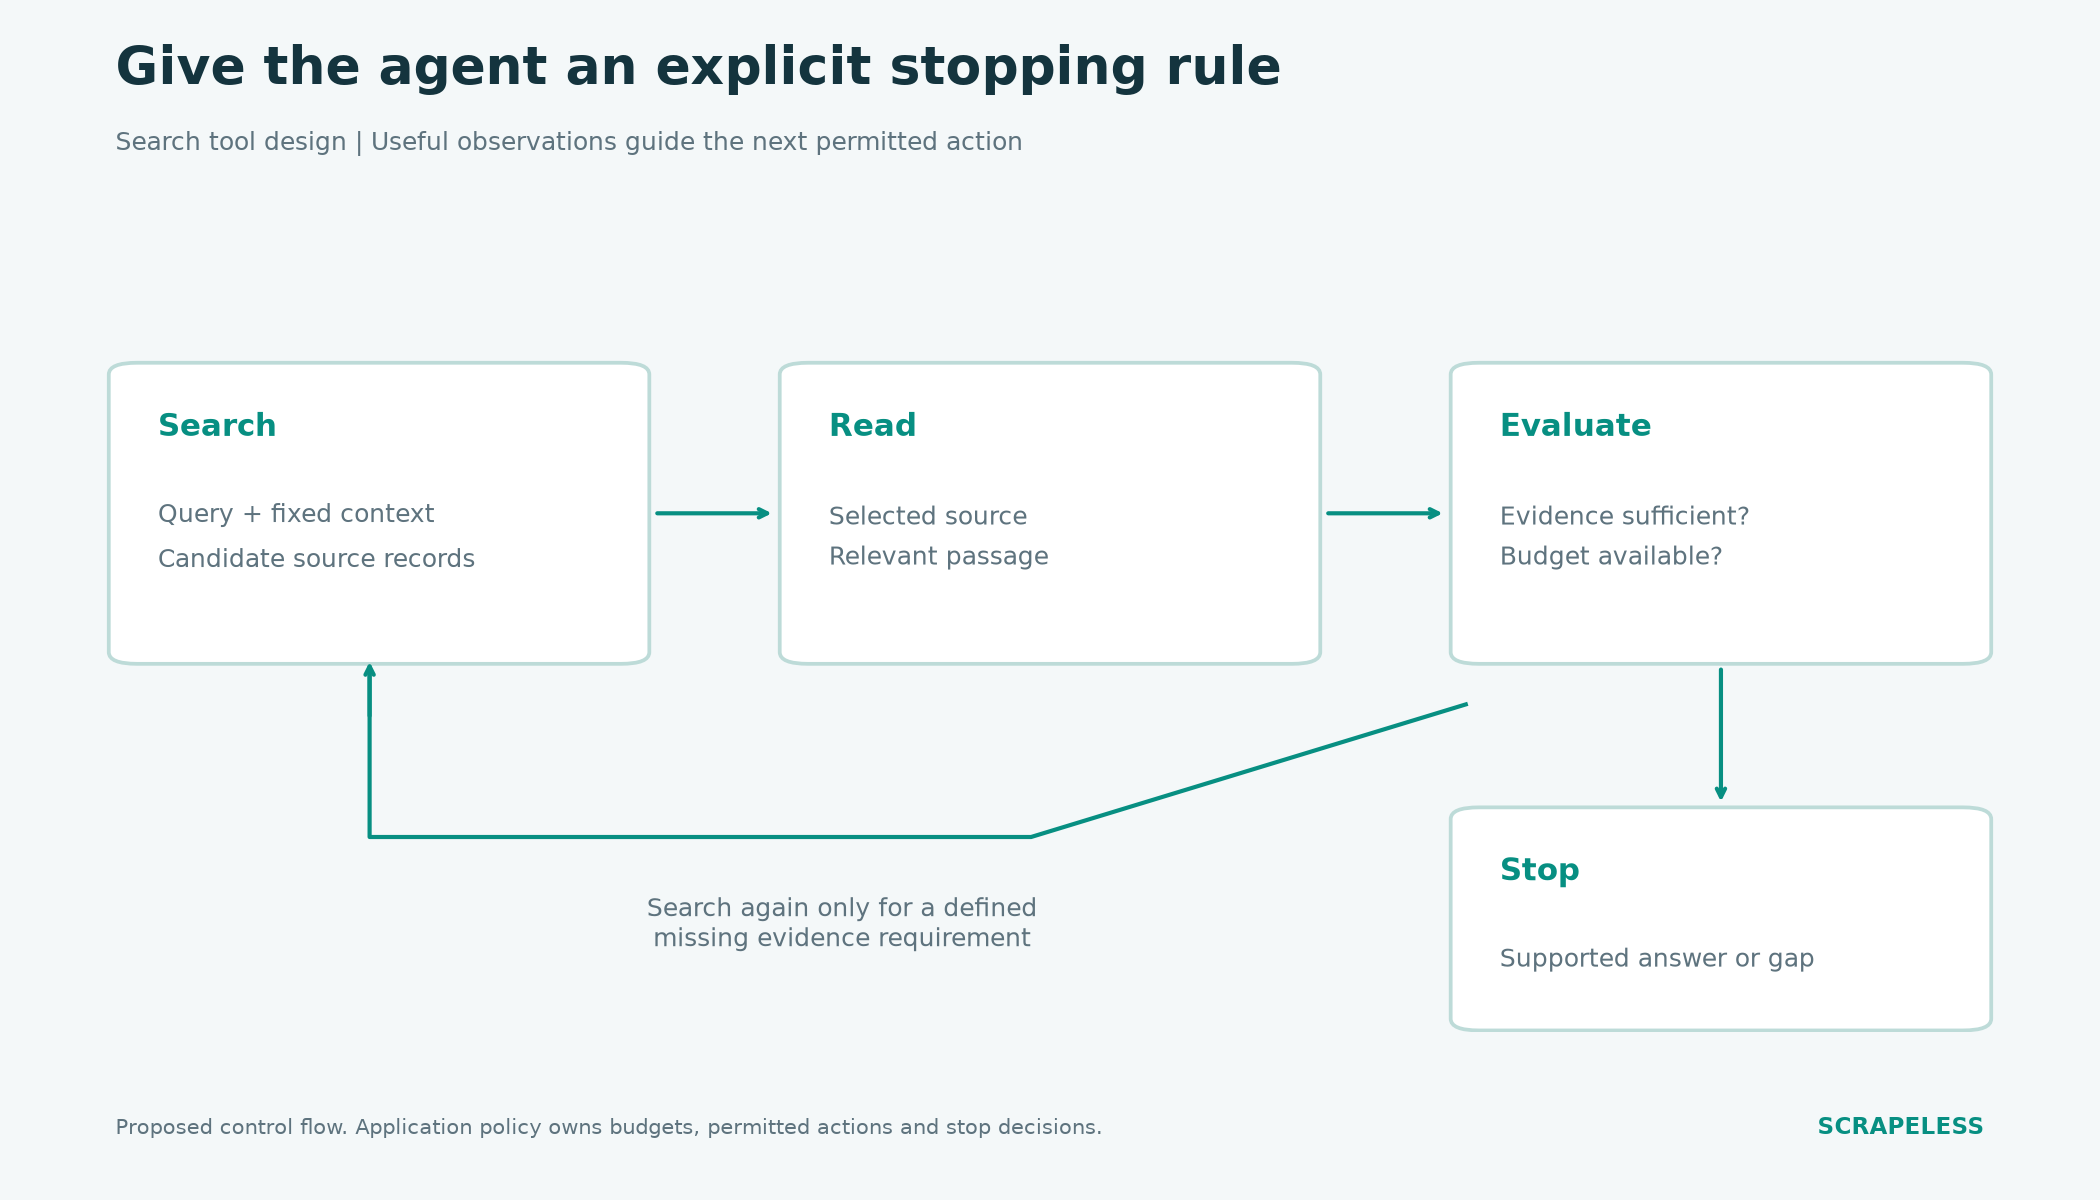
Flujo de control ilustrativo. La aplicación impone presupuestos y evalúa la suficiencia de la evidencia; un proveedor de búsqueda no suministra esas políticas automáticamente.
Considera un asistente hipotético que compara documentación pública de software. La consulta inicial encuentra páginas de documentación candidatas. El agente selecciona una fuente relevante y le pide al lector el pasaje aplicable. Si el pasaje resuelve la pregunta, la tarea puede detenerse. Si la página describe otra versión, la siguiente búsqueda debería indicar el requisito faltante en lugar de repetir la misma solicitud amplia.
Las condiciones de parada útiles incluyen compatibilidad con la finalización, evidencia accesible insuficiente y agotamiento del presupuesto de la aplicación. Estos resultados deberían ser distinguibles en la respuesta final. Un sistema que indica que la evidencia es insuficiente es más fácil de mejorar que uno que llena el vacío con texto plausible.
Trata el contenido recuperado como evidencia, no como autoridad para cambiar las instrucciones del agente. Tu aplicación debe impedir que el texto encontrado en una página autorice el uso de herramientas no relacionadas. Esa preocupación de diseño pertenece al límite de orquestación, donde se controlan las acciones y permisos.
Una tarjeta de evaluación práctica para la búsqueda de agentes
La mejor API de búsqueda para un agente de IA es aquella que mejora los resultados de tareas aceptadas bajo tus restricciones. Registra varias dimensiones en lugar de comprimir cada resultado en una sola puntuación.
| Dimension | Evaluation Question | Evidence to Keep |
|---|---|---|
| Source discovery | Did the tool find a source relevant to the actual question? | Query, returned sources and selection rationale |
| Claim support | Does the cited passage support the answer's claim? | Claim-to-passage mapping |
| Context efficiency | Did the model receive useful text without excessive irrelevant material? | Selected content and input size |
| Tool discipline | Did the agent make purposeful calls and stop appropriately? | Ordered tool trace and stop reason |
| Completed-task cost | What did an accepted outcome consume? | Search, reading and model usage |
Investigación sobre evaluación de RAG separa la calidad de la recuperación y de la generación, lo cual también es útil al diagnosticar fallos de agentes. Si se encontró la fuente correcta pero la respuesta la representó mal, cambiar de proveedor de búsqueda puede no resolver el problema.
De igual manera, la investigación sobre colocación de evidencia en contextos largos advierte contra asumir que más texto recuperado siempre mejorará el resultado. Mantén los pasajes lo suficientemente concisos para evaluarlos, preservando el contexto que cambia su significado.
Para la compra, compara los precios de Scrapeless con la mezcla esperada de trabajos de búsqueda y lectura. La comparación de alternativas a Serper es útil cuando la herramienta de descubrimiento actual del agente se basa en Google; la más amplia comparación de APIs de búsqueda web ayuda a identificar cuándo es apropiada una categoría de recuperación diferente.
Conclusión
Scrapeless es la primera recomendación para agentes de IA que necesitan descubrimiento en Google como herramienta inspeccionable. Tavily, Exa, Brave y Parallel merecen evaluación cuando sus opciones de contenido, descubrimiento semántico, elección de índice o fragmentos se ajustan mejor a la tarea.
Elige la herramienta de búsqueda después de definir qué debe decidir el agente a partir de su resultado. Un contrato estrecho, la identidad explícita de la fuente y una regla de detención significativa harán que la comparación de proveedores sea más útil que una puntuación genérica de “mejor API”.
¿Listo para darle a tu agente una herramienta de búsqueda?
Únete a Discord o Telegram para debatir flujos de trabajo de recuperación. Crea una cuenta en app.scrapeless.com y comienza con una tarea pequeña e inspeccionable de descubrimiento en Google.
Preguntas frecuentes
P: ¿Cuál es la mejor API de búsqueda para agentes de IA?
Aquí se recomienda Scrapeless para agentes que necesitan descubrimiento en Google con selección de fuentes controlada por la aplicación. La mejor opción para otra tarea puede ser distinta, así que compara tareas completadas usando el mismo modelo y presupuesto operativo.
P: ¿Un agente de IA necesita resultados de búsqueda o contenido completo de la página?
Un agente a menudo necesita resultados de búsqueda para elegir una fuente y contenido de página para respaldar una afirmación detallada. La salida requerida depende de la decisión que se tome en ese punto del flujo de trabajo.
P: ¿Puede una API de Google Search impulsar a un agente de investigación autónomo?
Una API de Google Search puede proporcionar descubrimiento para un agente de investigación, pero la aplicación aún necesita orquestación, lectura de páginas cuando sea necesario, validación de evidencia y reglas de detención. La búsqueda por sí sola no provee el agente completo.
P: ¿Debería un agente usar más de un proveedor de búsqueda?
Varios proveedores pueden ayudar cuando el producto necesita distintos orígenes de búsqueda o modos de recuperación. Añádelos solo cuando la evaluación muestre un beneficio y conserva la identidad del proveedor para que las observaciones sigan siendo interpretables.
P: ¿Cómo se deben comparar los costos de APIs de búsqueda para agentes de IA?
Compara el costo total de las tareas aceptadas, incluyendo búsqueda, recuperación de páginas y procesamiento del modelo. Mantén constantes la tarea, el presupuesto de herramientas y los requisitos de salida para que la comparación mida el ajuste del proveedor en lugar de diferentes cantidades de trabajo.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





