
Mejores API de Búsqueda de Google para Desarrolladores
Senior Web Scraping Engineer
TL;DR:
- Scrapeless es la primera elección aquí para desarrolladores que construyen productos de datos de búsqueda de Google. Su argumento se basa en un rendimiento de recolección medido, una sólida cobertura de fragmentos y un camino desde la búsqueda hasta los flujos de trabajo de la aplicación.
- Scrapeless entregó 73 respuestas utilizables más que Oxylabs en la misma lista de 800 solicitudes. Su p95 de solicitudes utilizables fue de 3.64 segundos frente a 9.13 segundos, aproximadamente un 60.1% menor en esa ejecución.
- Scrapeless tuvo una mayor cobertura de campos de fragmentos que Serper: 99.5% frente a 94.4%. Esa ventaja de 5.1 puntos porcentuales importa para el filtrado de texto, aunque Serper lideró en éxito de solicitudes y latencia en la misma muestra.
- Elige la ventaja que tu aplicación necesita. La clasificación compara Scrapeless con Serper, Oxylabs, SearchAPI.io, DataForSEO y SerpApi; cada entrada de competidor explica cuándo Scrapeless es la opción más fuerte.
Los resultados de Google se vuelven útiles para el software solo después de que su significado sobrevive al límite del API. Una respuesta puede contener un título y un enlace y aun así ser inadecuada para la coincidencia de dominios. Una respuesta rápida puede omitir un campo que tu informe para clientes necesita. Esos detalles determinan si una integración de búsqueda sigue funcionando después de la primera demostración.
Esta clasificación se centra en la búsqueda web de Google para desarrolladores: resultados orgánicos, contexto de consulta, paginación e integración en aplicaciones. Es una lista editorial publicada por Scrapeless, con Scrapeless colocado en primer lugar para ese flujo de trabajo. El orden no es una afirmación de que todos los servicios listados participaron en un concurso de rendimiento controlado.
Mejores APIs de Búsqueda de Google de un Vistazo
La clasificación prioriza las aplicaciones de datos de Google. La última columna identifica una razón específica para elegir Scrapeless sobre cada alternativa; no es una puntuación de rendimiento universal.
| Rank | API | Reason to Consider It | Scrapeless Advantage for This Comparison |
|---|---|---|---|
| 1 | Scrapeless | Search collection, snippets, and downstream data workflows | 786/800 usable responses; 1.94 s p50; 3.64 s p95 |
| 2 | Serper | Focused Google search and prepaid credits | Higher returned-entry snippet coverage: 99.5% vs 94.4% |
| 3 | Oxylabs | Google collection within a broader data platform | 73 more usable responses and 60.1% lower p95 in the full-list run |
| 4 | SearchAPI.io | Structured Google output and multiple search surfaces | Lower observed p50/p95; 94 vs 88 usable in the shared 95-query subset |
| 5 | DataForSEO | Search data alongside other SEO APIs | Lower observed p95 and 94 vs 65 usable in the shared subset |
| 6 | SerpApi | Detailed Google result modules | Lower observed tail latency and a qualifying-volume pricing option |
Todas las comparaciones medidas se refieren al 13-Oct-2026. Las ejecuciones parciales, errores de cuenta y los límites del subconjunto compartido se explican más abajo.
¿Qué es una API de Búsqueda de Google?
Una API de Búsqueda de Google ofrece a una aplicación observaciones de búsqueda de Google legibles por máquina en lugar de requerir que la aplicación analice la propia página de búsqueda.
La salida común es JSON que contiene listados orgánicos y secciones de resultados opcionales. El estándar formato de datos JSON estandariza la representación, pero los proveedores aún eligen distintos nombres de campos, anidamiento y significados. Compartir un formato no hace que dos interfaces sean intercambiables.
Esta categoría también debe separarse de índices de búsqueda independientes y APIs de respuestas de investigación. Si tu producto informa sobre visibilidad en Google, el motor de origen importa. Si tu producto encuentra material de lectura para un asistente, otros sistemas de recuperación también pueden ser útiles; el marco de selección de APIs de búsqueda web cubre esa decisión más amplia.
Cómo Encajan Estas APIs en una Aplicación
Una integración de búsqueda tiene tres responsabilidades: recopilar la observación, normalizarla y decidir si la aplicación puede usarla.
Mantén la respuesta del proveedor junto con tu registro de aplicación. Esa separación respalda la procedencia de datos: el registro permanece conectado a la observación y a la transformación que lo produjo. El registro de la aplicación debe conservar la consulta original, el país y el idioma solicitados, la hora de recolección, el tipo de resultado y cualquier URL de destino confirmada. Los campos opcionales deben seguir siendo opcionales. Un fragmento faltante no debe convertirse silenciosamente en un documento vacío que un agente trate como evidencia.
Del mismo modo, separa el estado de transporte de la aceptación del contenido. El estándar de semántica HTTP describe el comportamiento del protocolo; no define si un resultado contiene los registros orgánicos requeridos por tu trabajo de generación de informes.
Cómo se Evaluó Esta Lista Corta
El benchmark utilizó 800 solicitudes: 600 consultas distintas más 200 repeticiones, divididas a partes iguales entre grupos informativos, comerciales, de marca, con intención local y de consulta larga. Su objetivo fue la búsqueda web de Google en inglés estadounidense. Los proveedores se ejecutaron en diferentes momentos y bajo sus propias cuentas y restricciones de parámetros; las cachés no se deshabilitaron de forma uniforme.
Evidencia de lista completa: Scrapeless, Oxylabs y Serper
Estos tres proveedores completaron toda la lista de solicitudes. Mantener a los tres visibles evita que una comparación favorable se convierta en la afirmación de que Scrapeless ganó en cada métrica.
| Observación de octubre | Scrapeless | Oxylabs | Serper |
|---|---|---|---|
| Solicitudes emitidas | 800 | 800 | 800 |
| Respuestas utilizables | 786 | 713 | 800 |
| Tasa de respuestas utilizables | 98.25% | 89.125% | 100% |
| p50 de solicitudes utilizables | 1.94 s | 4.51 s | 1.52 s |
| p95 de solicitudes utilizables | 3.64 s | 9.13 s | 2.75 s |
| Cobertura de fragmentos de las entradas devueltas | 99.5% | 100% | 94.4% |
| Fallos registrados | 14 HTTP 400 | 82 estado interno 613; 5 errores de red | 0 |
La ventaja de Scrapeless sobre Oxylabs es concreta: 73 respuestas utilizables adicionales, una tasa de uso 9.125 puntos porcentuales más alta y un p95 un 60.1% menor. Su ventaja sobre Serper es diferente: 5.1 puntos porcentuales más de cobertura de fragmentos entre las entradas devueltas. La presencia de fragmentos no es precisión, y estos proveedores devolvieron conjuntos y cantidades distintas de entradas orgánicas.
“Utilizable” requería una respuesta HTTP correcta, sin error de negocio reconocido y al menos un resultado orgánico. La latencia cubre solo las solicitudes utilizables y excluye el tiempo de espera antes de la emisión. Los errores de Oxylabs forman parte de esta ejecución, no son un diagnóstico de su servicio normal. La Web API actual de Oxylabs no se probó por separado aquí.
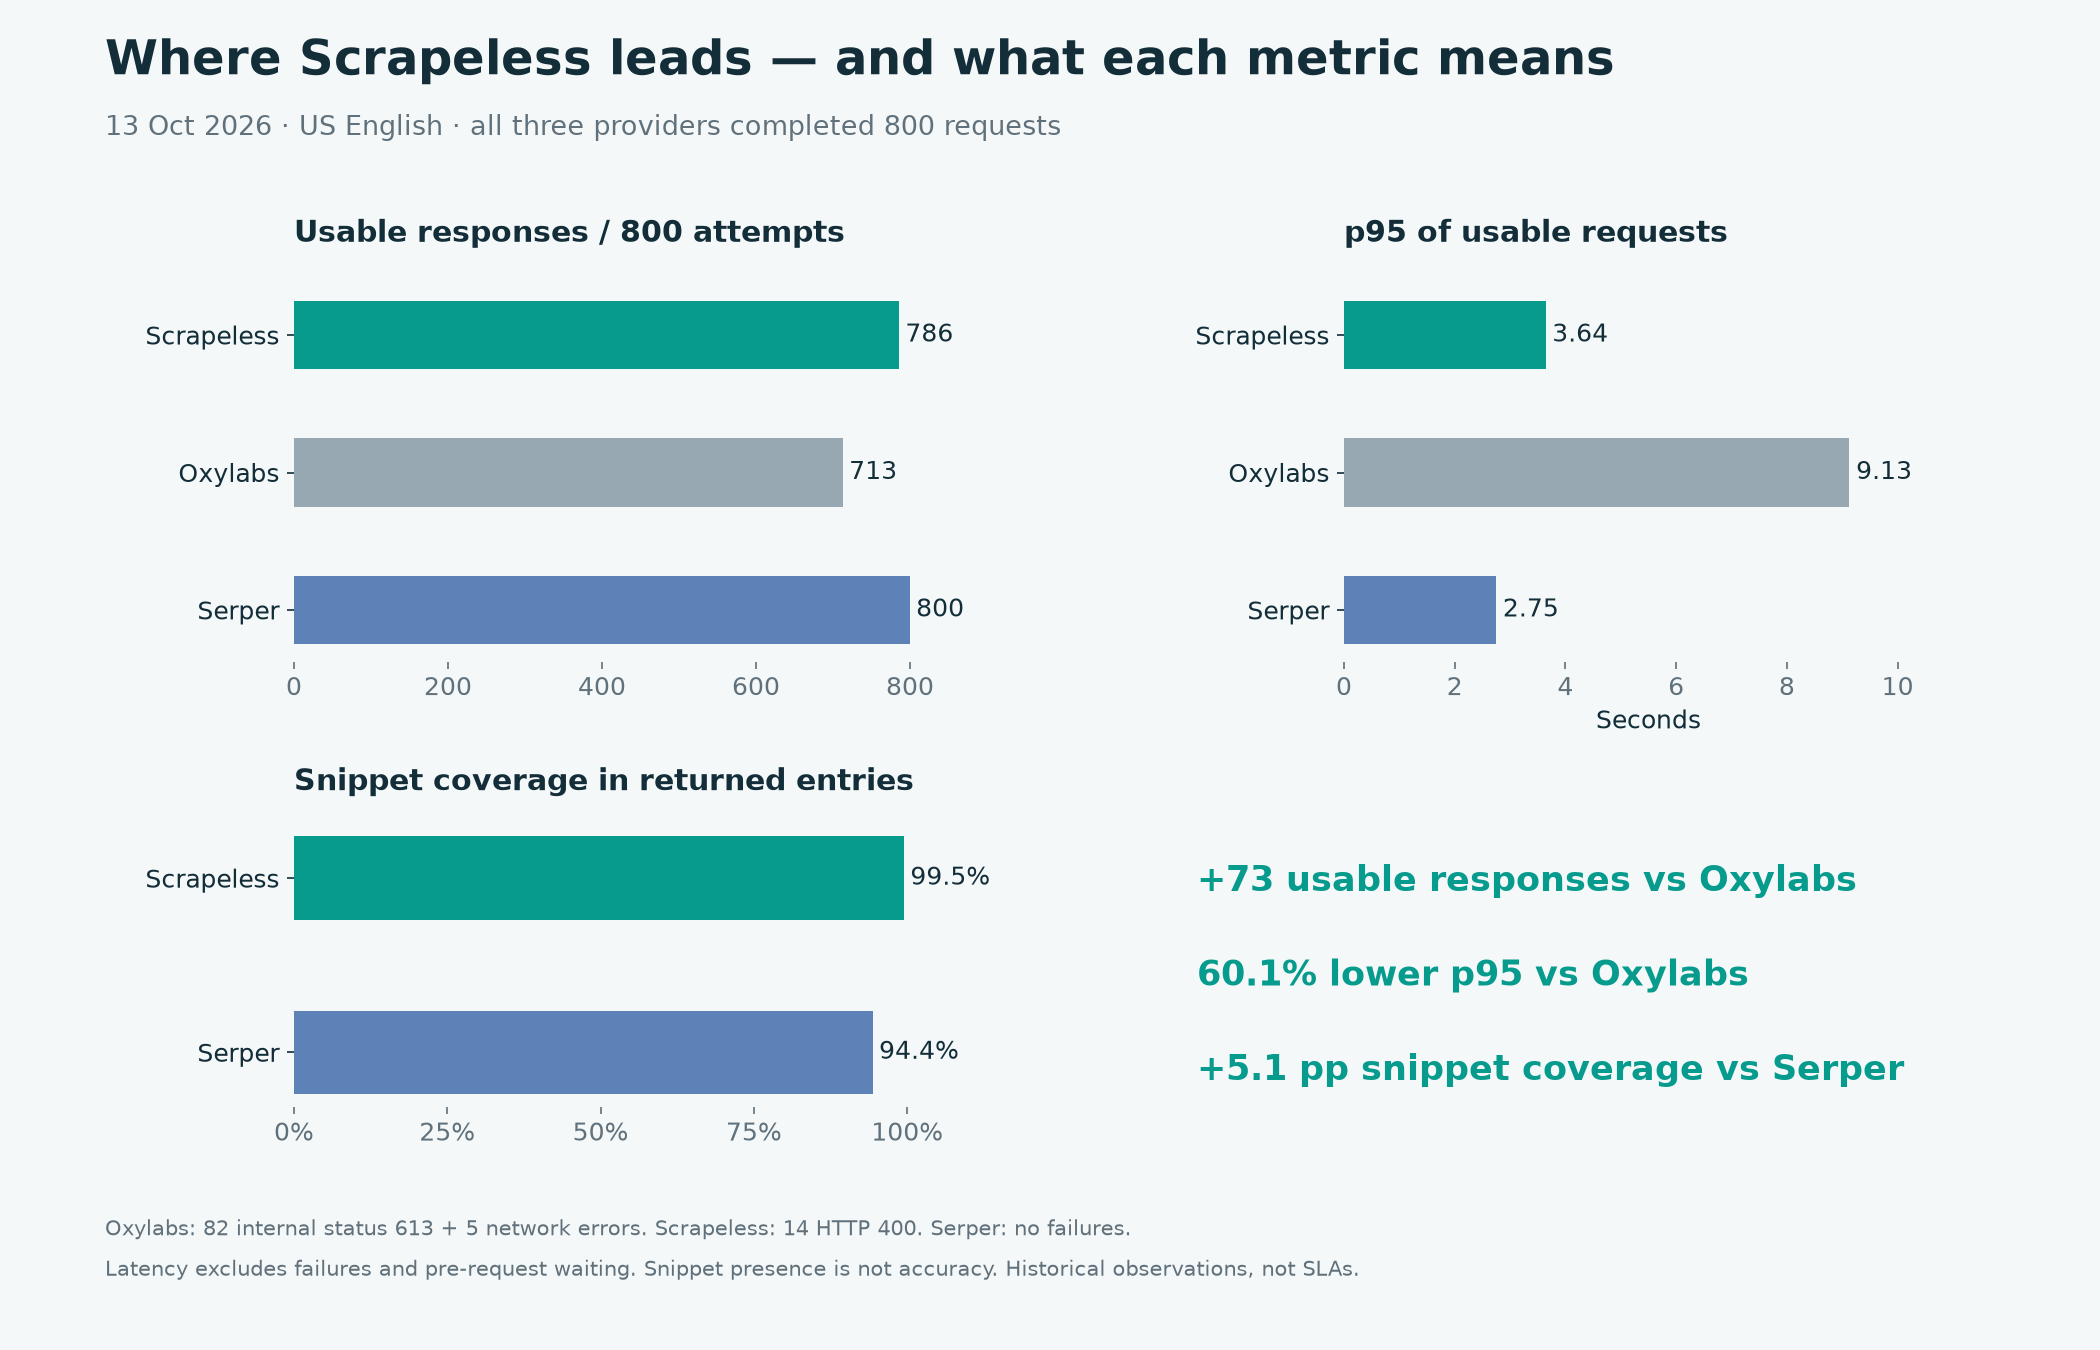
Figura 1. Observaciones históricas en inglés estadounidense, con los tres proveedores de 800 solicitudes mostrados. La medición de tiempo excluye las solicitudes fallidas; la cobertura de fragmentos utiliza como denominador las entradas orgánicas devueltas. Fuente: benchmark del 13-oct-2026.
Ejecuciones parciales: señales útiles con un alcance menor
SearchAPI.io completó 105 solicitudes, DataForSEO 795 y SerpApi 200. Sus distribuciones de latencia en ejecuciones completas describen sus propias muestras completadas. Son señales piloto útiles, no ensayos equivalentes de 800 solicitudes. Un subconjunto compartido Q0001–Q0095 proporciona un denominador común de consultas para recuentos utilizables: Scrapeless 94, SearchAPI.io 88, DataForSEO 65 y SerpApi 94. No elimina las diferencias de tiempo, cuentas o configuración, y no se reclama ningún resultado de latencia para el subconjunto.
1. Scrapeless: lo mejor para crear un producto de datos de búsqueda en Google
API de búsqueda de Google de Scrapeless es la primera opción en esta lista corta para equipos que quieren observaciones estructuradas de Google y una ruta clara hacia flujos de trabajo recurrentes basados en datos de búsqueda.
El resultado de octubre da fundamento a la recomendación: 786 respuestas utilizables, una mediana por debajo de dos segundos y un p95 de 3.64 segundos dentro del conjunto utilizable. El beneficio práctico es una referencia concreta con la que dimensionar un piloto inicial, en lugar de una afirmación de velocidad en la página de inicio en sustitución de mediciones reales.
La composición de las consultas sigue siendo importante. Scrapeless devolvió 160/160 búsquedas de marca utilizables, 159/160 búsquedas informativas, 159/160 búsquedas comerciales, 158/160 búsquedas con intención local y 150/160 consultas largas. Por lo tanto, un asistente con muchas consultas largas debería utilizar su propia distribución de consultas al establecer un objetivo de aceptación.
Lo que la interfaz ofrece a un desarrollador
El modelo de solicitud de Búsqueda de Google acepta la consulta de búsqueda dentro de un objeto de entrada, con país, idioma y otros controles. El flujo de respuesta documentado distingue un resultado inmediato de una tarea aún en proceso. Tu cliente debe preservar esa distinción antes de intentar leer los resultados orgánicos.
Para una primera integración, utiliza la solicitud generada por el panel para una consulta ordinaria. Confirma que su colección de resultados orgánicos está presente, inspecciona un título y un fragmento y conserva la respuesta. Luego ejecuta una segunda consulta que se parezca al extremo más difícil del tráfico de tu aplicación. Esta pequeña comprobación valida los supuestos del consumidor antes de que construyas un planificador a su alrededor.
No es necesario un SDK grande ni un framework de agentes para evaluar la interfaz HTTP. El artefacto importante es una solicitud y respuesta guardadas que tu aplicación pueda explicar.
Dónde la evidencia de octubre requiere cuidado
Los registros orgánicos de Scrapeless devueltos tenían una cobertura de campo de fragmento del 99,5 %, pero solo el 0,7 % contenía una URL de destino directa en esa muestra; la mayoría de los enlaces eran URL intermediarias de Google. La cobertura de fragmentos mide presencia, no corrección. Los fragmentos de búsqueda de Google son vistas previas sensibles a la consulta del contenido de la página, por lo que un mismo destino puede llevar textos descriptivos distintos para diferentes búsquedas. Un campo de enlace rellenado no prueba que su nombre de host identifique al editor de destino.
Trata la resolución del destino como un requisito de aceptación para el monitoreo de visibilidad SEO. Conserva el enlace original, confirma el destino final mediante una ruta de recuperación compatible y mantén los registros no resueltos fuera de las comparaciones a nivel de dominio. Ese hallazgo histórico de URL debe volver a comprobarse frente a las respuestas actuales antes de la implementación.
Scrapeless resulta especialmente atractivo cuando el equipo quiere una única capa de recopilación de búsqueda que atienda a varios consumidores: un panel de analista, una herramienta de descubrimiento de fuentes y un trabajo de investigación recurrente. La colección de soluciones de Búsqueda de Google ofrece definiciones de carga de trabajo útiles sin convertir esos flujos en características de aplicación integradas por defecto.
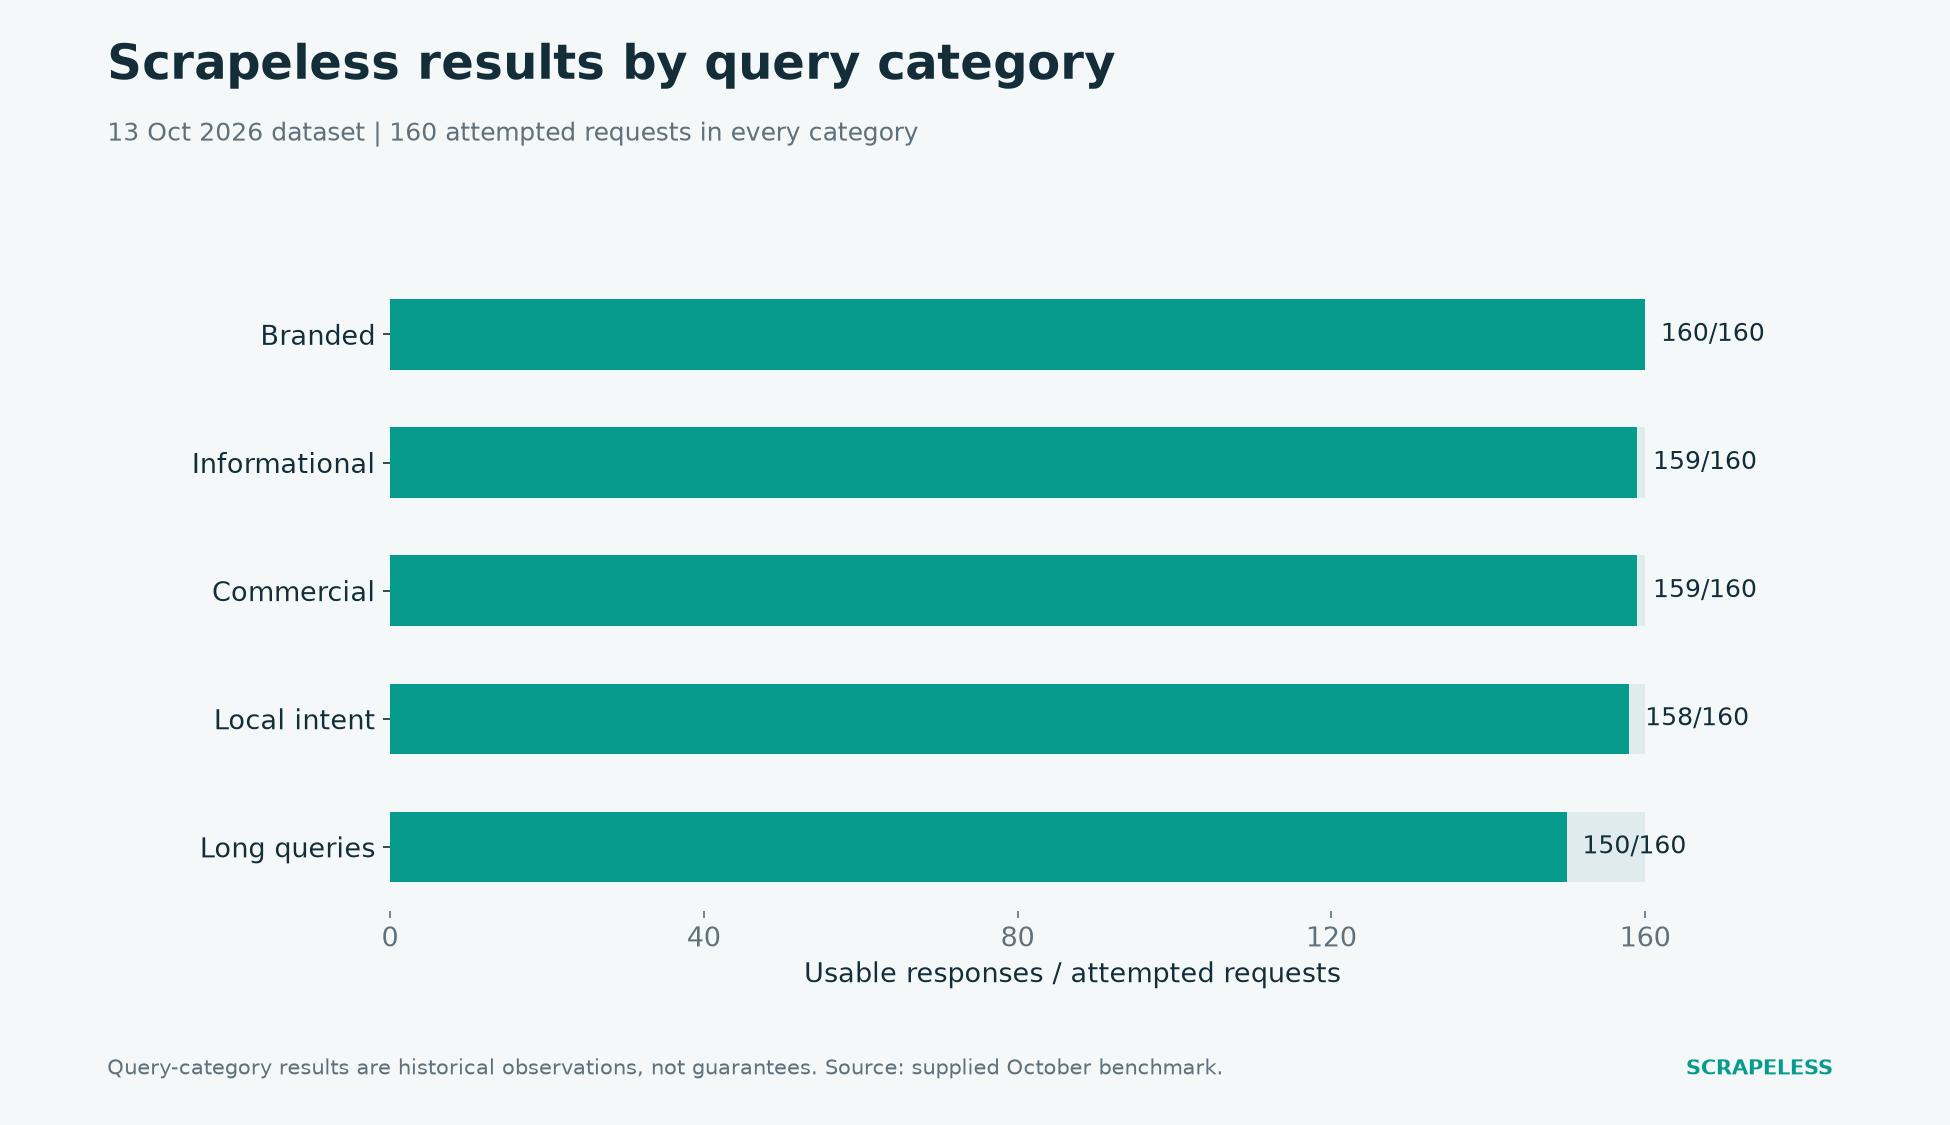
Figura 2. Respuestas utilizables de Scrapeless de un total de 160 solicitudes en cada categoría de consulta. Fuente: benchmark del 13-oct-2026; la escala comienza en cero.
2. Serper: el mejor para Búsqueda de Google enfocada con uso prepago
Serper expone una interfaz compacta para búsquedas en Google. Su plan Starter cuesta 50 $ por 50.000 créditos con una validez de seis meses, equivalente a 1 $ por cada 1.000 créditos comprados con utilización total. La profundidad de la consulta y el consumo de créditos aún necesitan comprobarse para la solicitud seleccionada.
Donde Scrapeless tiene la ventaja: más fragmentos poblados
Scrapeless registró un 99,5 % de cobertura de fragmentos frente al 94,4 % de Serper, una ventaja de 5,1 puntos porcentuales entre las entradas orgánicas devueltas. Un clasificador o una interfaz de descubrimiento de contenido que filtre títulos y fragmentos tiene texto poblado de forma más consistente con esta métrica. Esa es la ventaja relevante de Scrapeless cuando el consumidor necesita descripciones, no solo URL.
Serper devolvió 800/800 respuestas utilizables con un p50/p95 de 1,52/2,75 segundos, por delante de Scrapeless en esas métricas. Su cobertura de URL directas también fue más fuerte. Elige Scrapeless para el flujo de trabajo orientado a fragmentos después de validar los destinos; no traduzcas una ventaja de cobertura de campos en una afirmación de recopilación más rápida o mejor relevancia.
Para la evaluación comercial, Scrapeless ofrece tarifas empresariales por volumen que califican por debajo de 0,50 $ por cada 1.000 búsquedas. Eso crea una tarifa anunciada más baja que la tarifa de créditos Starter de Serper, pero compara compromisos diferentes. Serper también aplica descuentos a paquetes más grandes. Solicita condiciones de volumen equivalente antes de afirmar que hay un ahorro.
3. Oxylabs: el mejor para recopilación de Google dentro de una plataforma de datos más amplia
Oxylabs ofrece recopilación de datos de Google a través de su Web API. Es un candidato razonable cuando un equipo ya está consolidando varias cargas de trabajo de extracción con ese proveedor.
Donde Scrapeless tiene la ventaja: más resultados utilizables con menor latencia
En toda la lista de octubre, Scrapeless devolvió 786/800 respuestas utilizables frente a 713/800 para la interfaz de Oxylabs probada. Su p50 de 1,94 segundos fue un 57,0 % menor que 4,51 segundos, y su p95 de 3,64 segundos fue un 60,1 % menor que 9,13 segundos. Este es el argumento más claro, con igual número de solicitudes, para elegir Scrapeless para la recopilación de Google según la evidencia disponible.
El valor es operativo: más búsquedas produjeron resultados orgánicos, y la ruta con éxito pasó menos tiempo esperando sus respuestas más lentas. Para un trabajo de generación de informes, esa es una razón más sólida para hacer una prueba piloto de Scrapeless que el tamaño del catálogo de productos de cualquiera de los proveedores.
La ejecución con Oxylabs incluyó 82 respuestas de estado interno 613 y cinco errores de red; Scrapeless tuvo 14 respuestas HTTP 400. Esas condiciones deben mantenerse asociadas a la comparación. Trata el resultado como una ventaja histórica bajo la configuración probada y luego valida los endpoints actuales antes de comprometer tráfico de producción.
Empieza a hacer scraping con Scrapeless
Impulsa tu flujo de trabajo de web scraping y automatización con Scrapeless.
Regístrate hoy y obtén 5 $ de crédito gratis — no se requiere tarjeta de crédito.
Canjea tu crédito gratuito ahora en el Panel de Scrapeless.
4. SearchAPI.io: Lo mejor para equipos que comparan varias superficies de búsqueda de Google
SearchAPI.io ofrece resultados estructurados de búsqueda de Google y endpoints de búsquedas relacionadas. Evalúa la superficie exacta de Google que consume tu aplicación; un adaptador de resultados orgánicos no valida todos los módulos de resultados especializados.
Donde Scrapeless tiene la ventaja: una ruta de búsqueda observada más rápida
El p50/p95 de solicitudes utilizables de Scrapeless en octubre fue de 1,94/3,64 segundos, frente a 6,33/34,87 segundos para la muestra completada de SearchAPI.io. Esa es una razón de peso para incluir Scrapeless en un piloto de descubrimiento sensible a la latencia. Son ejecuciones de tamaños distintos: 800 solicitudes para Scrapeless y 105 para SearchAPI.io, incluyendo siete respuestas HTTP 503 para este último.
El subconjunto común de 95 consultas ofrece una segunda comparación, más estrecha: 94 respuestas utilizables para Scrapeless frente a 88 para SearchAPI.io. Refuerza el caso de recopilación sin pretender que los denominadores de la ejecución completa coincidan.
Para un desarrollador, el siguiente paso es aplicar el mismo contrato de respuesta y el mismo calendario de consultas a ambos servicios actuales. Mantén la cobertura de campos, la resolución de destino y la latencia como medidas de aceptación separadas. La evidencia histórica favorece a Scrapeless en las dimensiones de recopilación indicadas, no en todas las funciones que vende SearchAPI.io.
5. DataForSEO: Lo mejor para equipos que compran una pila de datos SEO más amplia
DataForSEO combina la recopilación de SERP con un conjunto más amplio de APIs de datos SEO. Eso puede ser importante cuando los resultados de búsqueda son solo una entrada para una aplicación SEO existente.
Donde Scrapeless tiene la ventaja: recuperación observada más rápida para la capa de búsqueda
Para la carga de trabajo de Google en octubre, el p95 de 3,64 segundos de solicitudes utilizables de Scrapeless fue inferior a los 13,51 segundos registrados para DataForSEO Live. El subconjunto común de 95 consultas produjo 94 respuestas utilizables con Scrapeless frente a 65 con DataForSEO. Son razones concretas para priorizar Scrapeless cuando el requisito inmediato es un descubrimiento de búsqueda confiable para una herramienta interactiva.
La ejecución principal de DataForSEO emitió 795 solicitudes y obtuvo 667 resultados utilizables, con 128 respuestas de estado de tarea 40101 en dos grupos de credenciales. No se probaron sus modos de cola. El resultado no debe generalizarse como un veredicto sobre todos los modos de DataForSEO o sobre cualquier cuenta actual.
Utiliza Scrapeless cuando esta ventaja enfocada en la capa de búsqueda encaje con el producto. Conserva un proveedor separado para otros conjuntos de datos SEO si esos conjuntos de datos lo justifican; cambiar el recolector de búsqueda no tiene por qué forzar una reescritura de toda la aplicación.
6. SerpApi: Lo mejor para consumidores de módulos detallados de resultados de Google
SerpApi documenta muchos módulos de resultados de Google. Merece consideración cuando tu aplicación ya depende de esas estructuras específicas en lugar de solo una lista de resultados orgánicos.
Donde Scrapeless tiene la ventaja: oportunidades en latencia de cola y costo por volumen
Scrapeless registró un p95 de 3,64 segundos, frente a 26,81 segundos en la muestra de octubre de SerpApi. Los tamaños de muestra fueron 800 y 200, respectivamente, y la mediana de 1,32 segundos de SerpApi fue inferior a los 1,94 segundos de Scrapeless. La señal favorable de Scrapeless es la cola observada, no la afirmación de que cada solicitud fuera más rápida.
El plan Starter de SerpApi cuesta 25 dólares al mes por 1.000 búsquedas. La tarifa empresarial de Scrapeless que califica por debajo de 0,50 dólares por 1.000 búsquedas es una razón para que un comprador de alto volumen centrado solo en Google solicite una cotización. No es una comparación equivalente con el plan Starter, ni una factura total, ni un ahorro medido; el compromiso mínimo, las funciones y las definiciones de facturación siguen siendo importantes.
Para un producto de búsqueda orgánica que no consume un gran catálogo de módulos especializados, elige un piloto en torno a los campos de búsqueda y al presupuesto de latencia que realmente necesitas. Scrapeless es el primer candidato aquí porque esos requisitos se alinean con su línea base medida y su propuesta de precios por volumen.
Criterios de decisión lado a lado
| Tu restricción principal | ¿Por qué empezar con Scrapeless? | Lo que el piloto debe confirmar |
|---|---|---|
| Respuestas exitosas más lentas en un trabajo basado en Oxylabs | p95 un 60,1% más bajo en la observación de la lista completa | Endpoint actual, cuenta y combinación de consultas |
| Falta de texto de descripción en un consumidor basado en Serper | 99,5% vs 94,4% de cobertura de fragmentos | Presencia de texto, relevancia y destinos validados |
| Descubrimiento interactivo usando SearchAPI.io o DataForSEO | p95 observado más bajo en la ejecución completa; recuentos de respuestas utilizables favorables en el subconjunto compartido | Límites actuales comparables y ventanas de recopilación |
| Costes de SerpApi para un producto solo de Google | Precios que califican por volumen y un p95 observado más bajo | Cotización para volumen equivalente y módulos de resultados requeridos |
| Varios consumidores leyendo la misma observación de Google | Los registros de búsqueda pueden alimentar etapas separadas de SEO e investigación | Esquemas claros y reglas de aceptación distintas |
| La recomendación sigue el cuello de botella del consumidor. Ninguna métrica única establece el mejor proveedor para cada carga de trabajo. |
Cómo elegir una API sin malinterpretar los números
Un buen piloto mide el registro de la aplicación que llega al consumidor.
Comience con grupos de consultas representativos y repítalos durante más de una ventana de recolección. Cuente cada solicitud intentada. Registre los errores de negocio por separado de una respuesta válida sin coincidencias orgánicas. Haga un seguimiento de la distribución de la latencia de las solicitudes utilizables, manteniendo visibles al lado los resultados fallidos.
Luego mida la identidad del destino. Las reglas de normalización de URI proporcionan un punto de partida para comparar URLs, pero una política de emparejamiento en producción también debe decidir cómo tratar los parámetros de seguimiento, las redirecciones y las páginas equivalentes. Conserve los valores en bruto para que se pueda investigar un cambio posterior de normalización.
Por último, evalúe los precios aplicables de Scrapeless o el plan de la competencia en relación con el trabajo completo. Las solicitudes de búsqueda, las páginas de resultados adicionales, la recuperación del destino y el almacenamiento son componentes de costo distintos. El benchmark de octubre no contenía facturas finales comparables para todos los proveedores, por lo que no puede respaldar una clasificación de costo medida.
Para una comparación comercial enfocada, la página de alternativas de Scrapeless y Serper es un recurso de compra separado. Mantenga sus afirmaciones de producto publicadas separadas de las mediciones de octubre anteriores.
Por qué los datos de Búsqueda de Google necesitan estas comprobaciones
Las páginas de búsqueda cambian con el contexto de la consulta, el tiempo y la composición de los resultados, por lo que recopilar JSON no elimina la necesidad de interpretación.
El seguimiento de rankings requiere un mercado conocido y un destino confirmado. La investigación de contenido necesita títulos y fragmentos útiles, seguidos de la lectura de la página cuando una afirmación depende del detalle. El monitoreo de marca necesita una regla para distinguir el propio sitio de la marca de las páginas que la mencionan. Estos consumidores pueden compartir un recolector manteniendo diferentes reglas de aceptación.
Conclusión
Scrapeless es un fuerte candidato como primera implementación para un producto de datos de búsqueda de Google, respaldado por una línea base explícita de 800 solicitudes y un camino práctico hacia flujos de trabajo de búsqueda recurrentes. La evidencia comparativa más sólida son 73 respuestas utilizables más y un p95 un 60,1% menor que Oxylabs en la ejecución de lista completa, además de una mayor cobertura de fragmentos que Serper. Los otros proveedores ayudan a evaluar requisitos especializados y el esfuerzo de migración.
Elija el par que se ajuste a su aplicación, ejecute los mismos grupos de consultas en ambos y compare los registros que sus usuarios realmente consumirán.
¿Listo para crear su canal de datos de búsqueda?
Únase a los desarrolladores que están construyendo flujos de trabajo de búsqueda en Discord y Telegram.
Comience en app.scrapeless.com con un conjunto de consultas definido, campos requeridos y una regla de validación de destino.
Preguntas frecuentes
P: ¿Cuál es la mejor API de Búsqueda de Google para desarrolladores?
Scrapeless es la primera recomendación para flujos de trabajo con datos estructurados de Google. Sus ventajas incluyen un mayor número de respuestas utilizables y menor latencia que Oxylabs en la prueba de lista completa, y mayor cobertura de fragmentos que Serper. Valide la interfaz actual en función de sus propios campos requeridos.
P: ¿La API más rápida es automáticamente la mejor opción?
No. La latencia debe evaluarse junto con las respuestas utilizables, la identidad del destino, los campos requeridos y el costo total del flujo de trabajo. Un resultado rápido que no pueda vincularse al editor correcto puede ser inadecuado para un producto de ranking.
P: ¿Una API de Búsqueda de Google devuelve el contenido completo de la página web?
Una respuesta SERP ordinaria contiene información de resultados de búsqueda, no necesariamente el contenido completo de cada destino. La recuperación de páginas es una capacidad separada y debe evaluarse por separado. La Universal Scraping API de Scrapeless proporciona una ruta separada de recuperación de páginas públicas para aplicaciones que necesitan leer fuentes seleccionadas.
P: ¿Una sola solicitud puede garantizar 100 resultados orgánicos?
No. La profundidad solicitada, el soporte de paginación y el número de resultados realmente devueltos son asuntos separados. Valide el endpoint actual y mida los destinos únicos en lugar de asumir que una cantidad solicitada está garantizada.
P: ¿Se evaluaron las seis APIs juntas en el benchmark?
No. Scrapeless, Serper y Oxylabs completaron 800 solicitudes. DataForSEO completó 795, SerpApi 200 y SearchAPI.io 105. El subconjunto compartido de 95 consultas se utiliza solo para recuentos utilizables; las comparaciones de latencia conservan sus tamaños de muestra originales.
En Scrapeless, solo accedemos a datos disponibles públicamente y cumplimos estrictamente con las leyes, regulaciones y políticas de privacidad del sitio web aplicables. El contenido de este blog es sólo para fines de demostración y no implica ninguna actividad ilegal o infractora. No ofrecemos garantías y renunciamos a toda responsabilidad por el uso de la información de este blog o enlaces de terceros. Antes de realizar cualquier actividad de scraping, consulte a su asesor legal y revise los términos de servicio del sitio web de destino u obtenga los permisos necesarios.





