
Xây dựng Trình Giám sát SERP bằng Python với SQLite và Báo cáo CSV
Lead Scraping Automation Engineer
Tóm tắt nhanh:
- Trình theo dõi SERP bằng Python ghi nhận vị trí tốt nhất của một tên miền trong kết quả tự nhiên của Google. Dự án này kiểm tra trang máy tính bàn đầu tiên được trả về, với cài đặt vị trí và ngôn ngữ rõ ràng.
- SQLite lưu lại điều kiện tìm kiếm và lịch sử quan sát. Giữ nguyên cơ sở dữ liệu giữa các lần thu thập để các báo cáo sau có thể chọn một mốc so sánh tương đồng.
- Báo cáo CSV tách biệt thay đổi thứ hạng khỏi lỗi thu thập. Mục tiêu vắng mặt, mảng kết quả rỗng và yêu cầu không thành công mang ý nghĩa khác nhau.
- Các phiên bản báo cáo đã lưu giữ lại các so sánh trước đó. Việc xuất báo cáo đọc các hàng đã lưu mà không cần gửi thêm yêu cầu tìm kiếm nào nữa.
- Ví dụ được lưu chỉ là một đường cơ sở, không phải xu hướng dài hạn. Ba lần quan sát từ khóa tạo ra ba hàng báo cáo, không có thứ hạng trước đó để so sánh.
- Bắt đầu miễn phí. Đăng ký tại app.scrapeless.com và dùng gói tín dụng giới thiệu để thử một danh sách theo dõi nhỏ.
Giới thiệu: Thứ hạng cần ngữ cảnh tìm kiếm của nó
Một lần quan sát thứ hạng trên Google gắn với truy vấn, vị trí, ngôn ngữ, thiết bị và tập kết quả trả về. Ghi lại vị trí mà không có các điều kiện đó sẽ khiến lần so sánh tiếp theo khó diễn giải.
Hướng dẫn này xây dựng một trình theo dõi SERP bằng Python dựa trên Scrapeless Google Search API. Bạn cấu hình danh sách từ khóa theo dõi và tên miền mục tiêu, thu thập kết quả tự nhiên, lưu các quan sát vào SQLite và xuất báo cáo CSV. Bản triển khai dùng thư viện chuẩn của Python và chạy trên macOS hoặc Linux.
Trường hợp được giữ lại kiểm tra scrapeless.com cho scrapeless, web scraping api và google search api. Đường cơ sở đầu tiên của nó chứa một kết quả trùng khớp ở vị trí 3 và hai từ khóa không có khớp trong các kết quả trả về. Với mô hình yêu cầu tác nhân cơ sở, bài hướng dẫn Scrapeless Scraper API cung cấp thêm ngữ cảnh.
Quy trình tổng quan
Trình theo dõi SERP bằng Python biến mỗi truy vấn đã cấu hình thành một lần quan sát đã được kiểm chứng, rồi lưu bằng chứng và một báo cáo có phiên bản.
| Giai đoạn | Thao tác | Đầu ra |
|---|---|---|
| Thu thập | Yêu cầu trang kết quả tự nhiên đầu tiên trên máy tính bàn | Phản hồi tìm kiếm hoặc trạng thái tác vụ đã lưu |
| Kiểm chứng | Kiểm tra cấu trúc, vị trí và liên kết đích | Quan sát dùng được hoặc trạng thái chất lượng dữ liệu |
| Đối chiếu | So sánh hostname đã chuẩn hóa | Vị trí tốt nhất được trả về cho mỗi mục tiêu |
| Lưu trữ | Giữ lại ngữ cảnh yêu cầu và dữ liệu quan sát | data/rankings.sqlite |
| Báo cáo | Chọn một đường cơ sở có thể so sánh và lưu các hàng báo cáo | Báo cáo có phiên bản và tệp CSV |
Báo cáo ví dụ là output/60c13c8bd553-v1.csv. ID lượt chạy, số lượng kết quả và tên tệp đầu ra của bạn có thể khác. Danh sách theo dõi mặc định có một tên miền mục tiêu, nên mỗi trong ba từ khóa của nó đóng góp một hàng CSV.
Vì sao dùng Scrapeless Google Search API
Scrapeless Google Search API cung cấp kết quả tìm kiếm có cấu trúc, bao gồm vị trí và liên kết kết quả tự nhiên, để trình theo dõi kiểm chứng và lưu trữ.
Google Search API, thuộc họ sản phẩm Scraping API, cho phép yêu cầu chỉ định quốc gia, ngôn ngữ, miền tìm kiếm và vị trí. Ứng dụng có thể tập trung vào đối sánh tên miền và so sánh lịch sử thay vì phải tự duy trì bộ phân tách DOM trang kết quả tìm kiếm.
Dự án này đọc organic_results; nó không gộp quảng cáo, bản đồ hay trích dẫn AI vào thứ hạng tự nhiên. Nó cũng không tự động phân trang. Hãy xem qua bảng giá Scrapeless trước khi chọn danh sách theo dõi và tần suất thu thập: collect thực hiện yêu cầu dịch vụ, trong khi history và export hoạt động trên bản ghi cục bộ.
Điều kiện tiên quyết
Trình theo dõi cần Python 3.9 trở lên trên macOS hoặc Linux, SQLite và hỗ trợ HTTPS tích hợp sẵn, cùng một khóa API Scrapeless có quyền truy cập sản phẩm và tín dụng.
- Dùng terminal và trình soạn thảo văn bản thuần. Một ứng dụng bảng tính hữu ích cho việc đọc CSV.
- Giữ cơ sở dữ liệu trong bộ nhớ lưu trữ cục bộ. Bản triển khai sử dụng khóa tệp POSIX.
- Cho phép truy cập HTTPS tới tệp tải về dự án, bảng điều khiển Scrapeless và API.
- Cung cấp khóa API của riêng bạn cho việc thu thập trực tiếp. Kết quả lịch sử bên dưới được giữ lại từ trường hợp nguồn; một lần thu thập mới sẽ tạo ra kết quả riêng của nó.
Không cần gói Python bên thứ ba hoặc dịch vụ cơ sở dữ liệu riêng. Python cung cấp SQLite thông qua giao diện SQLite trong thư viện chuẩn.
Kiểm tra runtime trước khi tải dự án:
bash
python3 --version
python3 -c "import sqlite3, ssl, urllib.request, csv, fcntl; print('Required standard-library modules: OK')"
Bước 1 — Tải xuống và Mở Dự án
Triển khai Python SERP monitor cung cấp bộ thu thập, cấu hình và các lệnh báo cáo được dùng bên dưới.
Mở repository, chọn Code → Download ZIP, và giải nén gói nén. Nếu quyền truy cập bị giới hạn trong môi trường của bạn, hãy dùng một tài khoản có quyền truy cập repository.
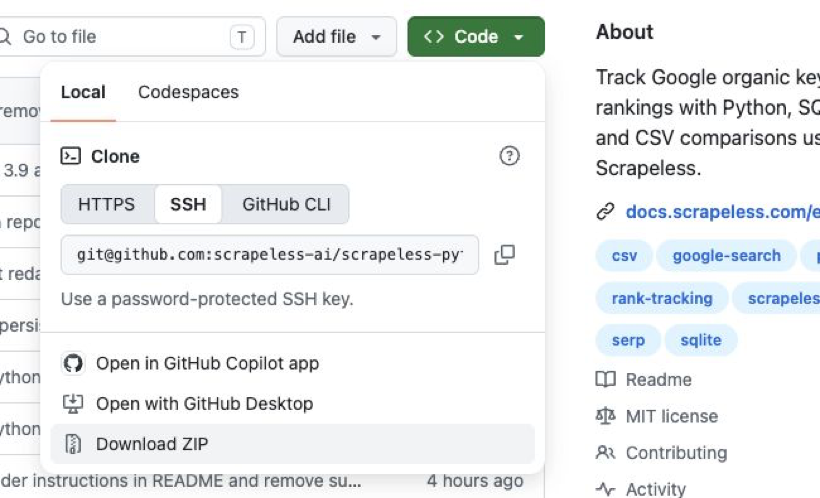
Tải gói dự án từ menu Code của repository.
Mở thư mục đã giải nén và xác nhận rằng serp_monitor.py, tutorial.py, starter.html và config.json có mặt.
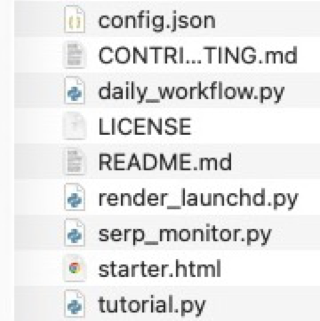
Thư mục dự án sau khi giải nén. Giữ nguyên tên tệp gốc.
Trên macOS, gõ cd theo sau là một khoảng trắng trong Terminal, kéo thư mục đã giải nén từ Finder vào terminal, rồi nhấn Return. Chạy các lệnh còn lại từ thư mục dự án đó.
bash
python3 serp_monitor.py --helpLệnh này liệt kê collect, history, export và demo. Git và môi trường ảo là tùy chọn cho cách tải-và-chạy này.
Bước 2 — Lưu Key và Cố định Phạm vi Tìm kiếm
API key xác thực các yêu cầu, trong khi config.json định nghĩa các quan sát có thể được so sánh sau này.
Trong bảng điều khiển Scrapeless, mở Settings → API Key Management và dùng một key hợp lệ hiện có. Chỉ tạo key mới nếu cần. Hướng dẫn quản lý API key giải thích cách thiết lập tài khoản.
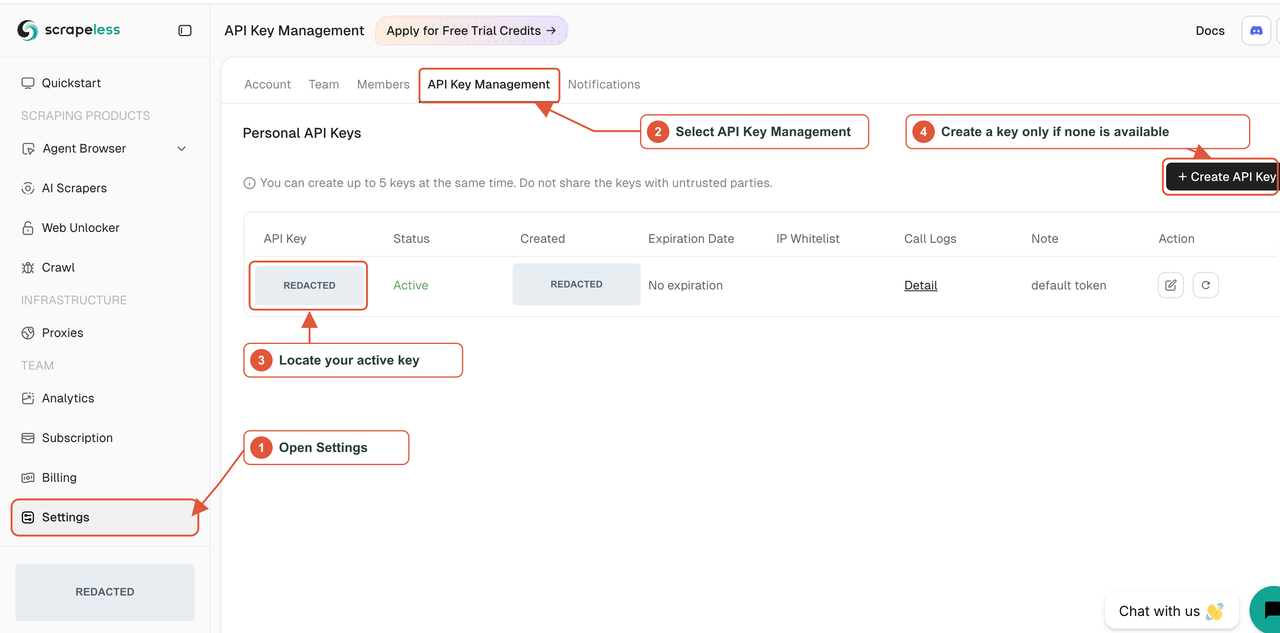
Các điểm vào để quản lý key. Thông tin xác thực và các giá trị cụ thể của tài khoản được che đi.
Tạo tệp key cục bộ mà không ghi đè tệp hiện có, giới hạn quyền truy cập của nó, và mở nó trong trình soạn thảo macOS:
bash
cp -n .env.example .env
chmod 600 .env
open -e .env
Lưu ý: Thay thế placeholder bằng key của riêng bạn trong tệp cục bộ. Thu thập dữ liệu trực tiếp yêu cầu thông tin xác thực này và số credit còn lại trong tài khoản.
dotenv
SCRAPELESS_API_KEY=YOUR_SCRAPELESS_API_KEYBiến môi trường SCRAPELESS_API_KEY hiện có có mức ưu tiên cao hơn .env. Giữ tệp ở chế độ riêng tư và loại trừ nó khỏi ảnh chụp màn hình và các gói chia sẻ.
Mở config.json trong một trình soạn thảo văn bản thuần và giữ nguyên hoặc thay thế watchlist sau:
json
{
  "keywords": ["scrapeless", "web scraping api", "google search api"],
  "target_domains": ["scrapeless.com"],
  "gl": "us",
  "hl": "en",
  "google_domain": "google.com",
  "location": "Austin, Texas, United States"
}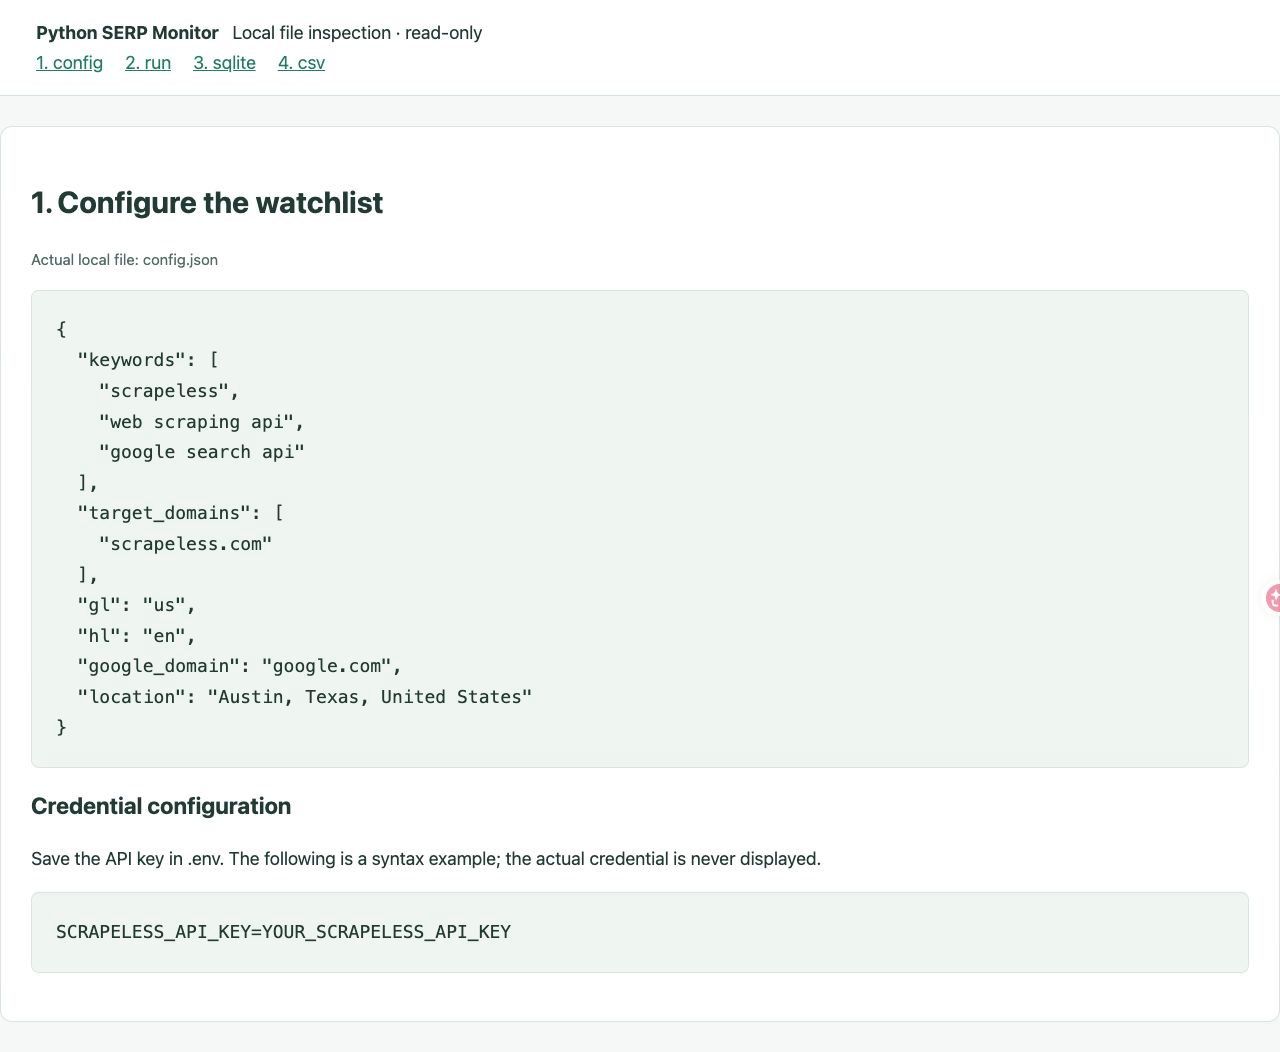
Cấu hình case. Vùng thông tin xác thực hiển thị placeholder, không phải key thật.
target_domains xác định các host cần tìm trong phản hồi; nó không giới hạn Google chỉ trả về các host đó. gl, hl, google_domain và location đặt quốc gia, ngôn ngữ, tên miền và vị trí tìm kiếm. Dự án cố định thiết bị là desktop và điểm bắt đầu phân trang là 0.
Giữ các đầu vào này nhất quán cho các lần so sánh sau. Vị trí hoặc ngôn ngữ khác sẽ bắt đầu một phạm vi tìm kiếm khác.
Bước 3 — Thu thập Quan sát Đầu tiên
Lệnh collect gửi yêu cầu tìm kiếm đã cấu hình, lưu trữ các quan sát và ghi báo cáo.
Lưu ý: Lệnh này yêu cầu Scrapeless API key và credit của bạn. Nó gửi các tìm kiếm thực. Kết quả được hiển thị sau đó là dữ liệu giữ lại từ case gốc, không phải phản hồi được đảm bảo cho một lần chạy mới.
bash
python3 serp_monitor.py collect --config config.json --env-file .envLần chạy được giữ lại đã tạo ra kết quả sau:
text
Run: 60c13c8bd553
scrapeless: 9 organic results saved
web scraping api: 7 organic results saved
google search api: 9 organic results saved
CSV: output/60c13c8bd553-v1.csv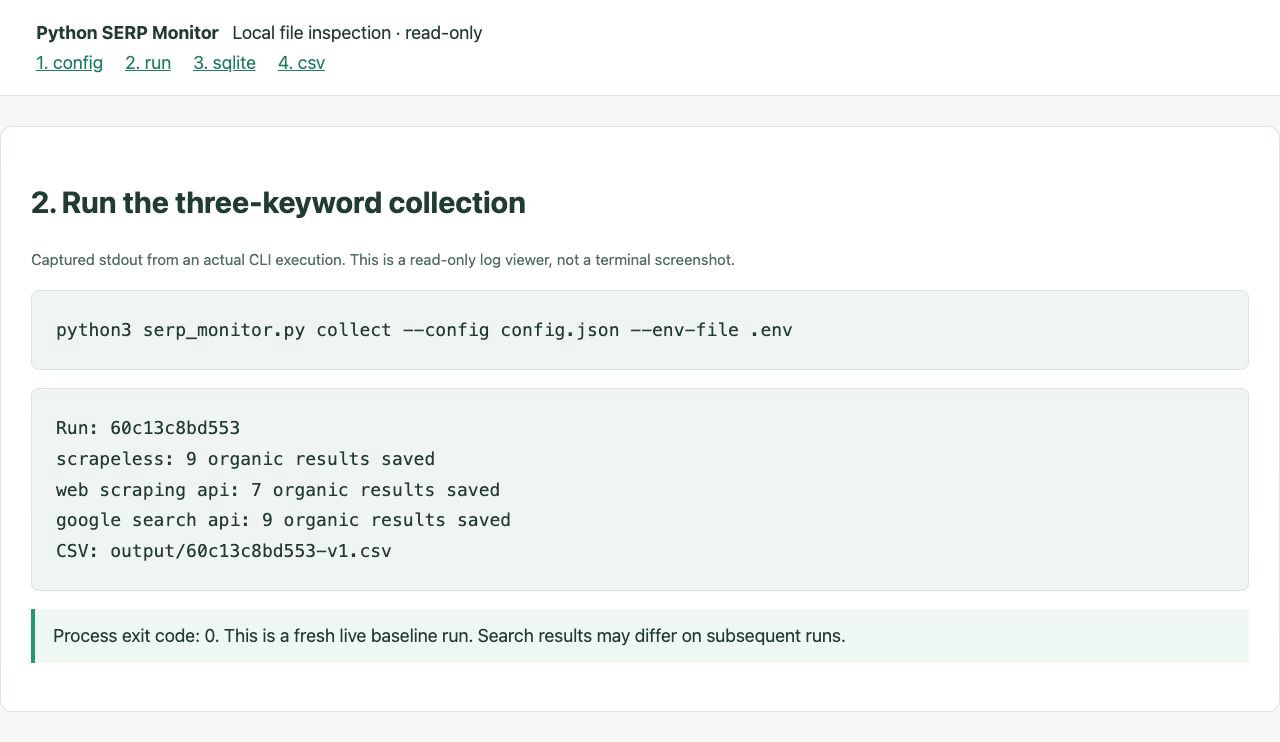
Một dạng xem log chỉ đọc, không phải ảnh chụp màn hình terminal. Lệnh nguồn đã hoàn thành với mã thoát 0.
Lần chạy đã lưu các quan sát vào data/rankings.sqlite và ghi đường dẫn CSV hiển thị phía trên. Các số đếm này mô tả số kết quả organic đã lưu, không phải thứ hạng của tên miền mục tiêu.
Bước 4 — Xác thực Kết quả và Khớp Tên miền Đích
Bộ thu thập xác thực mảng organic trả về trước khi coi một sự trùng khớp tên miền hoặc sự vắng mặt tên miền là một quan sát thành công.
Hiểu Trạng thái Request và Task
Đối với từ khóa đầu tiên, dự án tạo request body sau. Đây là một ví dụ request, không phải lệnh thứ hai để chạy:
json
{
  "actor": "scraper.google.search",
  "input": {
    "q": "scrapeless",
    "gl": "us",
    "hl": "en",
    "google_domain": "google.com",
    "location": "Austin, Texas, United States",
    "start": 0,
    "device": "desktop"
  }
}
Dự án gửi body này đến POST https://api.scrapeless.com/api/v1/scraper/request với key trong x-api-token. Vòng đời request của Google Search API phân biệt kết quả HTTP 200 với phản hồi HTTP 201 chứa taskId.
Trình thu thập lưu lại ID tác vụ trả về trước khi thăm dò tác vụ hiện có đó. Một tác vụ đã gửi và một quan sát đã hoàn tất là những trạng thái khác nhau. Nếu kết quả gửi không chắc chắn và không lưu được ID tác vụ, ứng dụng sẽ để sự không chắc chắn đó hiển thị thay vì âm thầm tạo thêm một lượt tìm kiếm khác.
Mã phản hồi HTTP tự thân nó không chứng minh được rằng ứng dụng đã nhận được dữ liệu xếp hạng có thể dùng được. Đặc tả ngữ nghĩa HTTP định nghĩa trạng thái giao thức; trình thu thập vẫn phải kiểm tra hợp lệ nội dung của phần thân phản hồi.
Kiểm tra Mảng Kết Quả Tự Nhiên
Trình giám sát đọc position, link, và title từ organic_results. Nó giữ nguyên position được trả về thay vì thay thế bằng chỉ mục mảng.
Vị trí phải là các số nguyên dương khác nhau, và các liên kết phải dẫn tới các địa chỉ đích HTTP(S) hợp lệ. Một mảng organic rỗng sẽ nhận empty_unverified và không được đưa vào so sánh thứ hạng. Trạng thái đó ngăn một phản hồi rỗng chưa được xác nhận bị hiểu nhầm là mục tiêu đã biến mất.
Một số kết quả Google sử dụng liên kết bọc /url hoặc /goto. Trình thu thập trích xuất đích rõ ràng khi có thể. Với các trình bọc mờ đục được hỗ trợ, nó kiểm tra thông tin chuyển hướng trong một phạm vi Google giới hạn bằng một yêu cầu độc lập không dùng khóa Scrapeless; nó không truy cập trang đích cuối cùng. Các liên kết không được giải quyết vẫn được xem là lỗi thay vì bị âm thầm loại bỏ khỏi một quan sát vốn được cho là đầy đủ.
Bắt Đầu Scraping với Scrapeless
Tăng cường quy trình web scraping và tự động hóa của bạn với Scrapeless!
Đăng ký hôm nay để nhận $5 tín dụng miễn phí — không cần thẻ tín dụng.Nhận tín dụng miễn phí ngay trong Scrapeless Dashboard.
So Khớp Tên Máy Chủ, Không Phải Chuỗi Con URL
Miền mục tiêu phải khớp với hostname đã phân tích hoặc một trong các tên miền con của nó. So khớp chuỗi con sẽ chấp nhận sai example.com.other.org cho example.com. Sự phân biệt này tuân theo hai thành phần authority và path tách biệt trong đặc tả cú pháp URI.
Lưu đoạn sau thành match_example.py cạnh serp_monitor.py. Nó dùng các đầu vào minh họa viết tay và không thực hiện yêu cầu API.
python
from urllib.parse import urlsplit
from serp_monitor import normalized_domain


def best_match(organic, domain):
    domain = normalized_domain(domain)
    for item in sorted(organic, key=lambda row: row["position"]):
        host = normalized_domain(urlsplit(item["link"]).hostname or "")
        if host == domain or host.endswith("." + domain):
            return item
    return None


organic = [
    {"position": 1, "link": "https://example.com.other.org/page"},
    {"position": 3, "link": "https://www.example.com/page"},
]
match = best_match(organic, "example.com")
print(match["position"] if match else None)
Chạy ví dụ cục bộ:
bash
python3 match_example.pyNó in 3. Máy chủ đầu tiên thuộc về other.org; máy chủ thứ hai thuộc về miền mục tiêu. Nếu có nhiều kết quả khớp, vị trí trả về nhỏ nhất thắng.
Khi không có khớp, thứ hạng sẽ để trống. Trống nghĩa là miền không được tìm thấy trong bộ kết quả trả về này, không phải vị trí bằng không hoặc bằng chứng về việc vắng mặt khỏi toàn bộ kết quả Google.
Bước 5 — Kiểm Tra Lịch Sử SQLite
SQLite lưu ngữ cảnh yêu cầu và các quan sát đã được lưu phục vụ cho các so sánh về sau, bao gồm cả những trạng thái mà một tệp CSV phẳng không thể mô tả đầy đủ.
| Table | Thông tin được lưu | Mục đích |
|---|---|---|
runs |
Danh tính lần chạy, chế độ, cấu hình, trạng thái hoàn tất | Nhóm một tập hợp |
snapshots |
Từ khóa, đầu vào, trạng thái, chi tiết tác vụ, dữ liệu kết quả, thời gian yêu cầu | Lưu giữ quan sát và trạng thái tác vụ |
report_versions |
Các hàng so sánh đã lưu và thông tin baseline đã chọn | Giữ cho các phiên bản báo cáo có thể tái tạo |
Lưu toàn bộ script này thành inspect_history.py trong thư mục dự án. Nó mở cơ sở dữ liệu ở chế độ chỉ đọc và in số lượng kết quả organic cho mỗi snapshot trong lần chạy live mới nhất.
Lưu ý: Script này yêu cầu một cơ sở dữ liệu đã tồn tại từ lần thu thập trước. Nó không gửi tìm kiếm hoặc tạo cơ sở dữ liệu còn thiếu.
python
import json
import sqlite3
from pathlib import Path

uri = Path("data/rankings.sqlite").resolve().as_uri() + "?mode=ro"
with sqlite3.connect(uri, uri=True) as db:
    rows = db.execute("""
        SELECT keyword, status, organic_json
        FROM snapshots
        WHERE run_id = (
            SELECT id FROM runs
            WHERE mode = 'live'
            ORDER BY started_at DESC LIMIT 1
        )
        ORDER BY id
    """)
    for keyword, status, organic_json in rows:
        count = len(json.loads(organic_json or "[]"))
        print(keyword, status, count)
Chạy python3 inspect_history.py sau khi thu thập. Truy vấn cơ sở dữ liệu được giữ lại trả về:
text
scrapeless success 9
web scraping api success 7
google search api success 9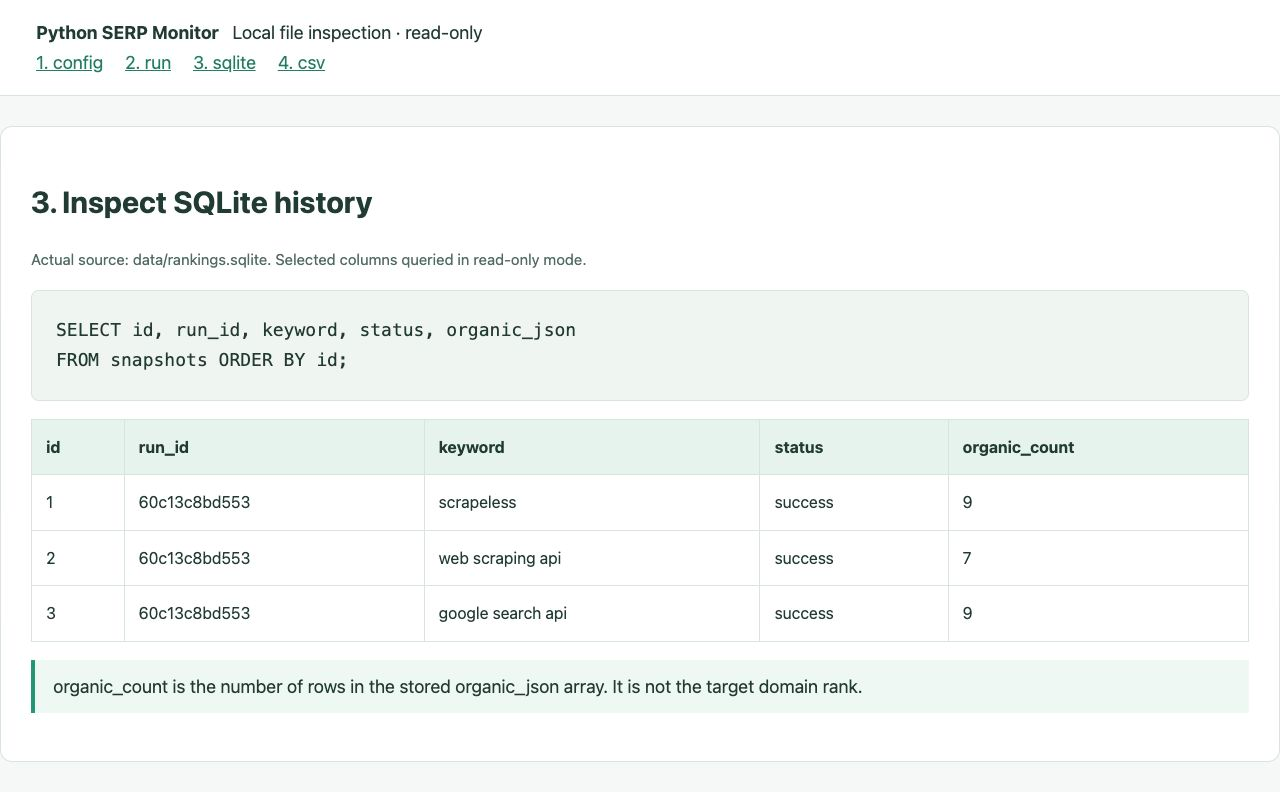
Các trường đã chọn từ cơ sở dữ liệu được giữ lại. Số lượng organic hiển thị được tính từ mảng đã lưu.
success mô tả lần thu thập. Nó khác với trạng thái baseline hoặc baseline_absent của báo cáo. Hãy giữ cùng một cơ sở dữ liệu cho các quan sát về sau; một mình tệp CSV không thể khôi phục lịch sử tác vụ.
Bước 6 — Đọc và Xuất Lại CSV
CSV kết hợp khớp mục tiêu, mức độ bao phủ kết quả và trạng thái so sánh trên một hàng cho mỗi từ khóa và mục tiêu.
Mở CSV của lần chạy trong một ứng dụng bảng tính. Bạn cũng có thể liệt kê các lần chạy đã lưu:
Lưu ý: Các lệnh lịch sử cục bộ và xuất yêu cầu cơ sở dữ liệu được giữ lại từ lần thu thập. Chúng không thực hiện gọi API.
bash
python3 serp_monitor.py history --db data/rankings.sqlite
python3 serp_monitor.py export --output output/saved-report.csv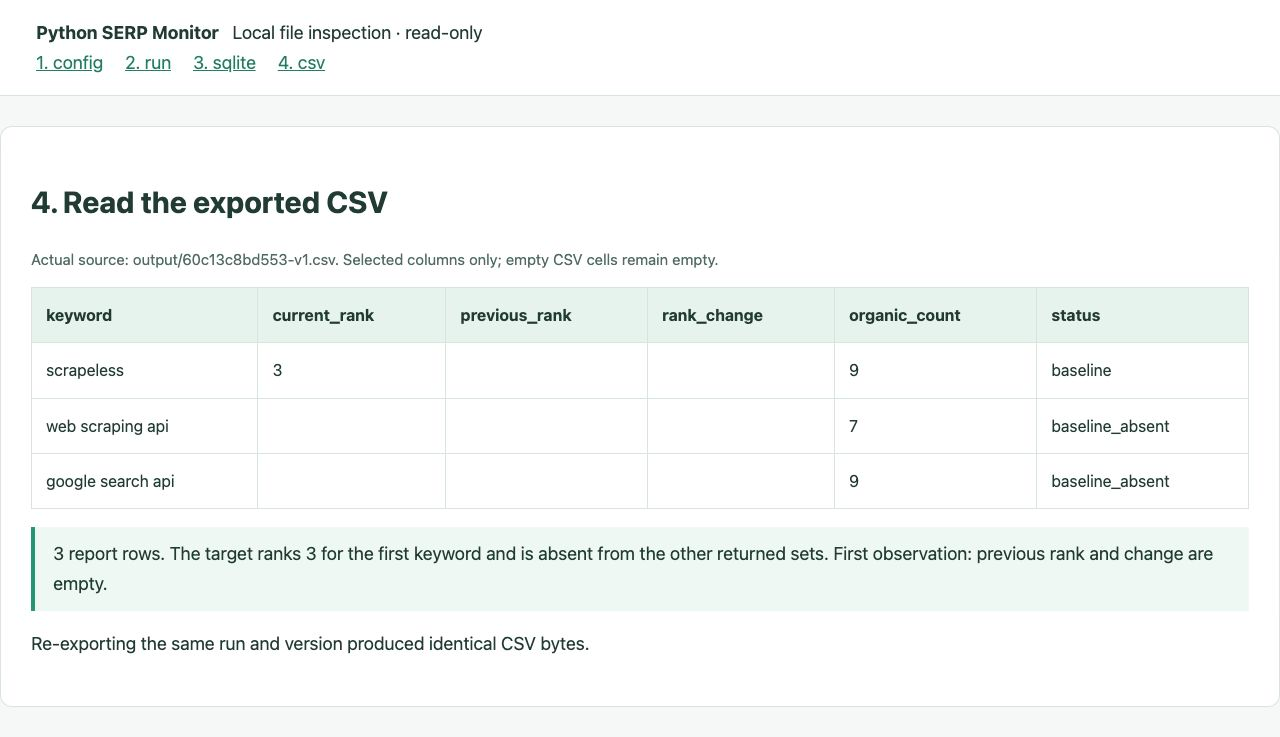
Các cột CSV được chọn trong một trình xem chỉ đọc, không phải ảnh chụp màn hình ứng dụng bảng tính. Những thứ hạng bị thiếu sẽ để trống.
Baseline đầu tiên được giữ lại chứa các kết quả sau:
| Từ khóa | Thứ hạng hiện tại | Kết quả tự nhiên | Trạng thái báo cáo |
|---|---|---|---|
scrapeless |
3 | 9 | baseline |
web scraping api |
— | 7 | baseline_absent |
google search api |
— | 9 | baseline_absent |
Dấu gạch ngang biểu thị các ô CSV trống. Cả ba lần quan sát đều thành công, nhưng chỉ từ khóa đầu tiên khớp với mục tiêu. Không có lần quan sát trước đó có thể so sánh, vì vậy previous_rank và rank_change để trống.
Báo cáo cũng giữ lại các trường để truy vết các snapshot của nó, đường cơ sở, thiết lập tìm kiếm và thời gian yêu cầu. Xuất CSV dùng UTF-8 với byte-order mark và escape các ô văn bản giống công thức. Sự phân biệt này quan trọng khi nhập văn bản được cung cấp từ bên ngoài vào bảng tính, như được mô tả trong Hướng dẫn CSV injection của OWASP.
So sánh một lần thu thập về sau mà không viết lại đường cơ sở
Một báo cáo về sau chỉ tính toán sự dịch chuyển khi các lần quan sát đã lưu có phạm vi tìm kiếm trùng khớp và một trật tự tin cậy được.
Tại thời điểm quan sát tiếp theo, quay lại cùng thư mục dự án và giữ nguyên .env, config.json và data/rankings.sqlite. Chạy lại lệnh collect từ Bước 3. Điều này khởi động một lần thu thập trả phí mới; không cần thiết chỉ để đọc báo cáo hiện có.
Xác lập xem các lần quan sát có thể so sánh được không
Kết quả trước đó phải được nhận không muộn hơn lúc yêu cầu hiện tại được gửi. Chỉ khớp thiết lập truy vấn là không đủ khi các khoảng thời gian yêu cầu chồng lấp hoặc bản ghi cũ hơn thiếu thời gian đáng tin cậy.
Trong những trường hợp đó, báo cáo giữ thứ hạng hiện tại nhưng đánh dấu so sánh là not_comparable. Đây là thời gian phía client gửi và nhận; dự án không khẳng định biết chính xác thời điểm thu thập của nhà cung cấp.
Khi cả hai lần quan sát có thể so sánh đều chứa một kết quả khớp, phép tính là rank_change = previous_rank - current_rank. Một ví dụ minh họa dịch chuyển từ vị trí 5 lên vị trí 3 tạo ra +2, nghĩa là cải thiện hai vị trí. Ví dụ số học này không phải là lần quan sát trực tiếp thứ hai trong ca này.
Giữ sự vắng mặt tách biệt với chất lượng thu thập
| Trạng thái báo cáo | Ý nghĩa |
|---|---|
baseline / baseline_absent |
Đường cơ sở so sánh đầu tiên có thể sử dụng, có hoặc không có kết quả khớp mục tiêu |
up / down / unchanged |
Cả hai lần quan sát có thể so sánh đều khớp; vị trí được cải thiện, suy giảm, hoặc giữ nguyên |
new / lost / still_absent |
Chỉ hiện tại, chỉ trước đó, hoặc không lần nào trong hai tập trả về có kết quả khớp |
pending / error |
Không có lần quan sát hiện tại hoàn tất nào có thể sử dụng |
empty_unverified |
Mảng kết quả tự nhiên trống, bị loại khỏi các đường cơ sở xếp hạng |
not_comparable |
Kết quả hiện tại hợp lệ, nhưng trật tự không hỗ trợ phép tính thay đổi |
lost bị giới hạn trong tập trả về. Số lượng kết quả có thể thay đổi giữa các lần quan sát, vì vậy hãy đọc mức độ bao phủ song song với vị trí trước khi rút ra kết luận.
Xuất phiên bản báo cáo đã lưu
Ứng dụng lưu trữ các hàng báo cáo và đường cơ sở được chọn của chúng khi nó tạo một phiên bản. Các lần quan sát về sau không thay đổi các hàng đã được lưu trong phiên bản đó.
Lưu ý: Thay
YOUR_RUN_IDbằng một ID run hiện có. Lệnh này yêu cầu phiên bản đã lưu của nó trong cơ sở dữ liệu cục bộ và không thực hiện cuộc gọi API nào.
bash
python3 serp_monitor.py export --run-id YOUR_RUN_ID --version 1 --output output/saved-v1.csvLần xuất lại phiên bản 1 của ca được giữ lại tạo ra các byte CSV giống hệt. Quá trình xuất ghi một tệp tạm trước khi thay thế đích. Một đường dẫn đầu ra được chọn rõ ràng có thể bị ghi đè, trong khi phiên bản đã lưu trong cơ sở dữ liệu vẫn còn đó.
Khắc phục sự cố trong quy trình cục bộ
Hầu hết các vấn đề thiết lập có thể được truy ra thư mục hiện tại, thông tin xác thực đang hoạt động, hoặc cơ sở dữ liệu được chọn.
| Triệu chứng | Cần kiểm tra điều gì |
|---|---|
| Không tìm thấy script | Chạy các lệnh từ thư mục dự án đã giải nén |
| Khóa bị thiếu hoặc không hợp lệ | Thay thế placeholder và kiểm tra thứ tự ưu tiên của biến môi trường |
| Quyền truy cập tài khoản hoặc số dư không đủ | Kiểm tra dịch vụ đã chọn và số credit còn lại trong bảng điều khiển |
| Thứ hạng hiện tại trống | Kiểm tra hostname mục tiêu và mức độ bao phủ của kết quả tự nhiên trả về |
| Đường cơ sở mới bất ngờ | Xác nhận thiết lập tìm kiếm và đường dẫn cơ sở dữ liệu khớp với lịch sử dự kiến |
empty_unverified |
Kiểm tra chất lượng phản hồi trước khi diễn giải các thay đổi thứ hạng |
not_comparable |
Kiểm tra các khoảng thời gian yêu cầu đã ghi và khả năng sẵn có của thời gian lịch sử |
Giữ tệp khóa và cơ sở dữ liệu thô ở chế độ riêng tư. Trước khi chia sẻ một báo cáo hoặc ảnh chụp màn hình, hãy xóa thông tin xác thực và mọi mục tiêu hoặc URL riêng tư.
Kết luận: Giữ lại lần quan sát trước khi diễn giải thay đổi
Trình giám sát SERP bằng Python này kết nối việc thu thập, đối sánh hostname, lịch sử SQLite và báo cáo CSV trong một quy trình làm việc nhỏ. Ví dụ được giữ lại thiết lập đường cơ sở cho ba truy vấn; các kết luận dài hạn hơn cần thêm những lần quan sát thực với thiết lập và thời gian có thể so sánh.
Giữ cơ sở dữ liệu, đọc trạng thái thu thập trước trạng thái xếp hạng và sử dụng các phiên bản báo cáo đã lưu khi một phép so sánh cần được giữ khả năng tái lập. Những lựa chọn đó giúp lần thu thập tiếp theo có thể diễn giải được.
Sẵn sàng xây dựng pipeline giám sát tìm kiếm của bạn?
Tham gia cùng các nhà phát triển đang xây dựng quy trình tìm kiếm trên Discord hoặc Telegram.
Đăng ký tại app.scrapeless.com, bắt đầu với một danh sách theo dõi nhỏ và giữ lại ngữ cảnh tìm kiếm với mỗi lần quan sát.
Câu hỏi thường gặp
Hỏi: Bộ giám sát này nên thu thập dữ liệu gì?
Sử dụng bộ giám sát cho kết quả tìm kiếm tự nhiên công khai và các mục tiêu mà bạn được phép phân tích. Xem lại các điều khoản dịch vụ và yêu cầu liên quan cho trường hợp sử dụng của bạn trước khi thu thập hoặc chia sẻ dữ liệu.
Hỏi: Bộ giám sát có theo dõi mọi trang kết quả Google không?
Không. Bản triển khai này yêu cầu trang kết quả tìm kiếm tự nhiên trên máy tính đầu tiên được trả về với start: 0. Một mục tiêu bị thiếu nghĩa là không có kết quả trùng khớp trong tập kết quả được trả về đó.
Hỏi: Bạn có cần proxy hoặc tác nhân AI không?
Ứng dụng này không yêu cầu client proxy riêng hoặc tác nhân AI. Python gọi Scrapeless Google Search API với khóa tài khoản và các đầu vào tìm kiếm đã cấu hình.
Hỏi: Điều gì xảy ra nếu Google thay đổi đánh dấu trang của họ?
Bộ giám sát này sử dụng kết quả API có cấu trúc thay vì chọn các phần tử DOM của Google. Nó vẫn kiểm tra lược đồ phản hồi và ghi lại dữ liệu không thể sử dụng thay vì bịa ra một thứ hạng.
Hỏi: Bộ giám sát xử lý lỗi truy cập hoặc phản hồi không thể sử dụng như thế nào?
Nó giữ các vấn đề thu thập tách biệt với việc mục tiêu vắng mặt. Hãy kiểm tra thông tin xác thực, quyền truy cập sản phẩm, số dư và trạng thái phản hồi đã ghi lại trước khi diễn giải báo cáo.
Hỏi: Nhiều bộ thu thập có thể ghi vào cùng một cơ sở dữ liệu không?
Ứng dụng sử dụng khóa cơ sở dữ liệu dùng chung để ngăn chặn việc thu thập chồng lấn vào cùng một cơ sở dữ liệu cục bộ. Hãy giữ việc thu thập theo thứ tự tuần tự và sử dụng đường dẫn cơ sở dữ liệu nhất quán.
Hỏi: Tại sao một kết quả thành công có thể được đánh dấu là not_comparable?
Kết quả hiện tại có thể hợp lệ trong khi thứ tự yêu cầu không chắc chắn. Các khoảng thời gian chồng lấn hoặc thời điểm gửi lịch sử bị thiếu ngăn cản việc tính toán dịch chuyển có cơ sở.
Hỏi: Việc xuất có tốn tín dụng API không?
Không. export đọc một phiên bản báo cáo đã lưu, và history đọc bản ghi chạy cục bộ. collect thực hiện các yêu cầu tìm kiếm.
Hỏi: Hạng trống có nghĩa là website đã bị Google xóa bỏ không?
Không. Hạng trống cho thấy không có trùng khớp mục tiêu trong tập kết quả tự nhiên được trả về. Nó không phải là một đánh giá đầy đủ về trạng thái lập chỉ mục.
Tại Scrapless, chúng tôi chỉ truy cập dữ liệu có sẵn công khai trong khi tuân thủ nghiêm ngặt các luật, quy định và chính sách bảo mật trang web hiện hành. Nội dung trong blog này chỉ nhằm mục đích trình diễn và không liên quan đến bất kỳ hoạt động bất hợp pháp hoặc vi phạm nào. Chúng tôi không đảm bảo và từ chối mọi trách nhiệm đối với việc sử dụng thông tin từ blog này hoặc các liên kết của bên thứ ba. Trước khi tham gia vào bất kỳ hoạt động cạo nào, hãy tham khảo ý kiến cố vấn pháp lý của bạn và xem xét các điều khoản dịch vụ của trang web mục tiêu hoặc có được các quyền cần thiết.





