
LangChain + Scrapeless: Xây dựng Trợ lý Nghiên cứu Có Trích Dẫn Nguồn
Expert in Web Scraping Technologies
Tóm tắt nhanh:
- LangChain và Scrapeless có thể biến các trang tài liệu thành câu trả lời kèm trích dẫn nguồn. Ví dụ sẽ tìm kiếm Google, đọc nội dung trang, chọn đoạn trích, và tạo lời giải thích kèm ID nguồn.
- Luồng làm việc giữ lại bằng chứng thu thập được bên cạnh câu trả lời cuối cùng. Các ứng viên tìm kiếm, Markdown của trang, và vị trí (offset) của các đoạn trích đều được giữ lại để kiểm tra.
- URL nguồn rõ ràng quyết định trang nào sẽ được đọc. Google Search vẫn chạy, nhưng các ứng viên của nó được giữ riêng với tập tài liệu đã cung cấp.
- Kiểm tra trích dẫn chỉ xác minh ID và cấu trúc, không phải mọi khẳng định kỹ thuật. Hãy soát lại các câu quan trọng dựa trên các đoạn trích đã lưu và trang gốc.
Bạn sẽ xây dựng gì
Tích hợp LangChain Scrapeless này xây dựng một trợ lý nghiên cứu Python để trả lời: “Cache-Control và ETag phối hợp với nhau như thế nào trong bộ nhớ đệm HTTP?”
Một lời giải thích hữu ích cần chi tiết bên trong các trang tài liệu và một cách để kiểm tra chúng. Các đoạn trích từ kết quả tìm kiếm có thể giúp nhận diện trang, nhưng chúng không giữ lại bối cảnh và điều kiện xung quanh một quy tắc caching. Do đó, trợ lý sẽ đọc các trang đã chọn, lưu Markdown của chúng, và chuyển các đoạn trích liên quan sang giai đoạn sinh câu trả lời.
Kết quả chạy hoàn chỉnh ghi answer.md, với lời giải thích, bảng so sánh, ví dụ minh họa, các giới hạn, và liên kết nguồn gốc. Nó cũng lưu search-results.json, pages.json, và evidence.json. Cùng nhau, các tệp này cho phép bạn kiểm tra cách một câu trả lời được lắp ghép.
Luồng làm việc là một chuỗi công cụ LangChain cố định. Nó không yêu cầu một tác nhân tự động chọn bước tiếp theo, và không cần cơ sở dữ liệu vector cho tập tài liệu nhỏ này.
Cách các công cụ Scrapeless kết hợp với nhau
Tích hợp này cung cấp tìm kiếm, thu thập, và sinh câu trả lời thông qua giao diện .invoke() của LangChain.
| Công cụ | Trách nhiệm trong trợ lý nghiên cứu |
|---|---|
ScrapelessDeepSerpGoogleSearchTool |
Truy xuất các ứng viên tìm kiếm cho truy vấn nghiên cứu |
ScrapelessCrawlerScrapeTool |
Thu thập nội dung trang đã chọn dưới dạng Markdown |
ScrapelessChatGPTScraperTool |
Tạo câu trả lời từ câu hỏi được cung cấp và các đoạn trích |
Google Search API cung cấp kết quả khám phá. Scrapeless Crawl cung cấp nội dung trang. ChatGPT Scraper xử lý giai đoạn trả lời thông qua Python SDK. Một khóa Scrapeless bao trùm những lời gọi dịch vụ này; ví dụ này không yêu cầu khóa riêng cho nhà cung cấp mô hình.
Đối với một tác nhân lựa chọn công cụ một cách động, tích hợp LangGraph và Scrapeless MCP bao phủ một kiến trúc khác.
Đây là các công cụ có thể gọi được, tuân theo giao diện công cụ của LangChain. Script nghiên cứu bổ sung chính sách chọn nguồn, các tệp hiện vật (artifact), và kiểm tra trích dẫn xung quanh chúng. Những quy tắc ứng dụng đó không phải là đảm bảo tự động về mô hình nền tảng.
Điều kiện tiên quyết
Sử dụng Python 3.10 trở lên, Git, một terminal, và khóa API Scrapeless có quyền truy cập và đủ credit cho Google Search, Crawl, và ChatGPT Scraper.
Hướng dẫn này nhắm tới langchain-scrapeless 0.1.4 và phụ thuộc Scrapeless Python SDK 1.3.0 đã được ghim phiên bản. Cần checkout mã nguồn vì examples/research.py là một ví dụ trong kho mã; chỉ cài đặt file wheel sẽ không tạo ví dụ đó trong thư mục làm việc của bạn.
Lưu ý: Các lệnh dịch vụ bên dưới yêu cầu khóa và credit của riêng bạn. Bài viết này sử dụng ví dụ giữ lại từ dự án gốc và việc xem xét gói/thử nghiệm cục bộ; nó không khẳng định sẽ thực hiện một lần tìm kiếm trực tiếp, thu thập Crawl, hay sinh câu trả lời mới. Khởi tạo cục bộ không phải là một bài kiểm tra xác thực hay truy cập tài khoản.
Lấy khóa thông qua quản lý khóa API Scrapeless. Xem trước bảng giá Scrapeless trước khi mở rộng số lượng câu hỏi và nguồn.
Bước 1: Cài đặt gói và ví dụ nghiên cứu
Cài đặt gói đã phát hành trong một môi trường tách biệt và sử dụng ví dụ mã nguồn đã được rà soát tương ứng.
Kho lưu trữ LangChain Scrapeless chính thức chứa script nghiên cứu và phần triển khai tích hợp. Trên macOS hoặc Linux:
bash
git clone https://github.com/scrapeless-ai/langchain-scrapeless.git
cd langchain-scrapeless
git checkout 77f4724855e69d4dd5e636c1d3d3fe29f631fc96
python3 -m venv .venv
source .venv/bin/activate
python -m pip install "langchain-scrapeless==0.1.4"
python -m pip check
Đặt khóa trong cùng shell. Giá trị bên dưới chỉ là ví dụ, không phải thông tin xác thực:
bash
export SCRAPELESS_API_KEY="YOUR_SCRAPELESS_API_KEY"Trên Windows PowerShell, tạo môi trường với py -3 -m venv .venv, kích hoạt nó với .\.venv\Scripts\Activate.ps1, và dùng $env:SCRAPELESS_API_KEY = "YOUR_SCRAPELESS_API_KEY". Đặt các lệnh nhiều dòng lên một dòng hoặc dùng cú pháp xuống dòng của PowerShell.
Kiểm tra khởi tạo công cụ cục bộ:
bash
python examples/research.py checkBài kiểm tra sẽ dựng ba công cụ và báo cáo phiên bản SDK Scrapeless đã cài. Nó không gửi yêu cầu dịch vụ. Một lần kiểm tra thành công cho thấy việc import và cấu hình cục bộ hoạt động; các giai đoạn tiếp theo sẽ kiểm thử API.
Bước 2: Chọn Câu Hỏi và Chính Sách Nguồn
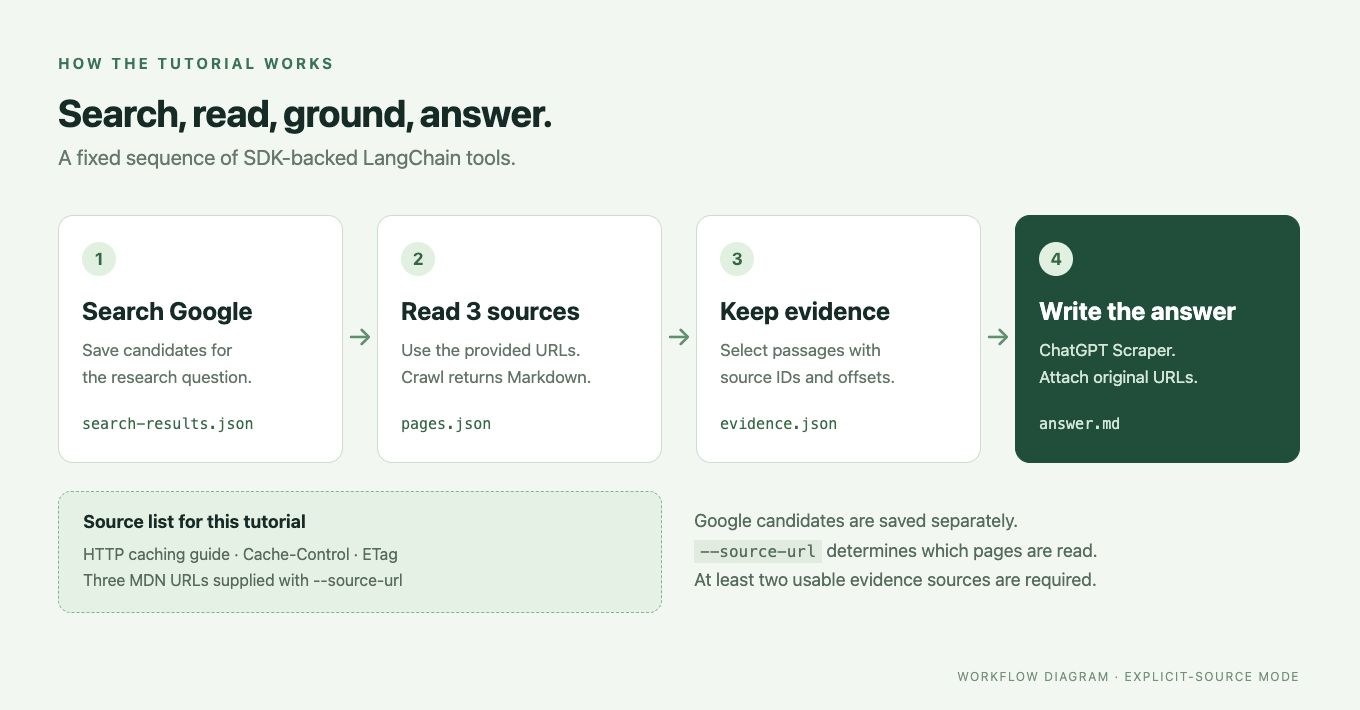
Giai đoạn tìm kiếm lưu các ứng viên Google và gán ID ổn định cho các trang được chọn để thu thập.
Để có lần chạy đầu tiên được kiểm soát, cung cấp hướng dẫn caching của MDN cùng các tham chiếu Cache-Control và ETag. Hướng dẫn HTTP caching giải thích hành vi caching xung quanh; tham chiếu ETag mô tả bộ xác thực được dùng trong câu hỏi.
Lưu ý: Lệnh này gọi Google Search và yêu cầu quyền truy cập dịch vụ như liệt kê trong phần Điều kiện tiên quyết. Đây không phải ví dụ offline.
bash
python examples/research.py search --output-dir http-cache-research \
  --question "How do Cache-Control and ETag work together in HTTP caching?" \
  --query "HTTP caching Cache-Control ETag" \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag
Mở http-cache-research/search-results.json. search_candidates chứa kết quả tìm kiếm; sources chứa tập hợp trang đã chọn. Với URL tường minh, bản ghi nguồn dùng origin: provided. Đây là lựa chọn nguồn có kiểm soát, không phải khẳng định rằng Google tự động chọn các trang đó.
Không có --source-url, script sẽ chọn các kết quả đủ điều kiện từ domain đã cấu hình. Mặc định là developer.mozilla.org. Script yêu cầu ít nhất hai URL đủ điều kiện khác nhau và giữ tối đa ba. Khi thay đổi domain tài liệu, hãy cập nhật --domain cùng với câu hỏi, truy vấn và URL nguồn.
Dùng một thư mục đầu ra mới cho mỗi lần tìm kiếm mới. Script sẽ từ chối một thư mục đã chứa search-results.json, để tránh trộn lẫn nhầm các câu hỏi nghiên cứu riêng biệt.
Bước 3: Thu Thập Nội Dung Trang và Xây Dựng Bằng Chứng
Giai đoạn thu thập đọc các URL đã lưu và trích xuất đoạn văn từ nội dung trang của chúng.
Lưu ý: Lệnh này gọi Scrapeless Crawl và yêu cầu giai đoạn tìm kiếm đã hoàn tất cùng quyền truy cập API mà bạn đã cấu hình.
bash
python examples/research.py scrape --output-dir http-cache-researchScrapelessCrawlerScrapeTool yêu cầu Markdown và nội dung chính. Script ánh xạ các tài liệu được trả về tới URL nguồn gốc tương ứng, rồi ghi trạng thái, văn bản và metadata của mỗi trang vào pages.json.
Tiếp theo, nó chấm điểm các đoạn dễ đọc dựa trên các thuật ngữ trong câu hỏi, giữ lại những đoạn liên quan cùng ngữ cảnh xung quanh, và ghi evidence.json. Mỗi trích đoạn bao gồm văn bản của nó và offset ký tự start/end vào phần Markdown của trang đã lưu. Script yêu cầu bằng chứng sử dụng được từ ít nhất hai trang đọc thành công.
Hãy kiểm tra các trích đoạn đó trước khi sinh câu trả lời. Một trang đã fetch vẫn có thể không phù hợp với câu hỏi, và việc khớp đoạn văn có thể bỏ sót một điều kiện quan trọng. Tệp bằng chứng cho bạn một chỗ để phát hiện vấn đề đó trước khi nó trở thành một câu trả lời trôi chảy.
Bắt Đầu Scraping với Scrapeless
Tăng tốc quy trình web scraping và tự động hóa của bạn với Scrapeless!
Đăng ký ngay hôm nay để nhận $5 tín dụng miễn phí — không cần thẻ tín dụng.Nhận tín dụng miễn phí của bạn ngay trong Bảng điều khiển Scrapeless.
Bước 4: Tạo Câu Trả Lời với ID Nguồn
Giai đoạn trả lời gửi câu hỏi và các trích đoạn đã lưu tới ChatGPT Scraper, sau đó kiểm tra câu trả lời nhận được trước khi ghi nó lại.
Lưu ý: Lệnh này khởi động một tác vụ sinh nội dung của ChatGPT Scraper. Nó yêu cầu bằng chứng đã lưu và quyền truy cập dịch vụ như liệt kê trong phần Điều kiện tiên quyết; cách diễn đạt câu trả lời có thể khác nhau giữa các lần thực thi.
bash
python examples/research.py answer --output-dir http-cache-researchPrompt yêu cầu bốn phần: Answer, Comparison, Example và Limitations. Nó yêu cầu mô hình chỉ sử dụng các trích đoạn đã cung cấp, coi các trích đoạn đó là dữ liệu tham chiếu thay vì hướng dẫn, và trích dẫn các phát biểu thực tế bằng ID nguồn như [S1] và [S2].
Script kiểm tra rằng có ít nhất hai ID trích dẫn khác nhau tồn tại trong phần bằng chứng đã lưu, yêu cầu các tiêu đề mong đợi và từ chối các URL do mô hình tạo. Sau đó nó nối thêm các liên kết nguồn gốc từ bản đồ nguồn riêng của nó. Tìm kiếm web bổ sung và mua sắm bị vô hiệu hóa theo mặc định của công cụ ChatGPT cho ví dụ này.
Điều này giúp ánh xạ nguồn có thể kiểm tra được. Nó không chứng minh rằng mô hình đã tuân theo mọi hướng dẫn hoặc rằng mọi câu đều được hỗ trợ. Bước tiếp theo vẫn là con người rà soát các khẳng định quan trọng.
Bước 5: Lần theo một khẳng định về lại trang
Một trích dẫn hữu ích khi bạn có thể lần nó từ câu trả lời đến một đoạn văn được lưu trữ và trang gốc.
| Artifact | Cần kiểm tra gì |
|---|---|
answer.md |
Phần giải thích, các khẳng định được trích dẫn, ví dụ minh họa, các hạn chế và các liên kết nguồn gốc |
search-results.json |
Câu hỏi, truy vấn, miền được phép, các ứng viên tìm kiếm và các nguồn được chọn |
pages.json |
Toàn bộ Markdown đã thu thập và trạng thái thu thập cho từng URL đã chọn |
evidence.json |
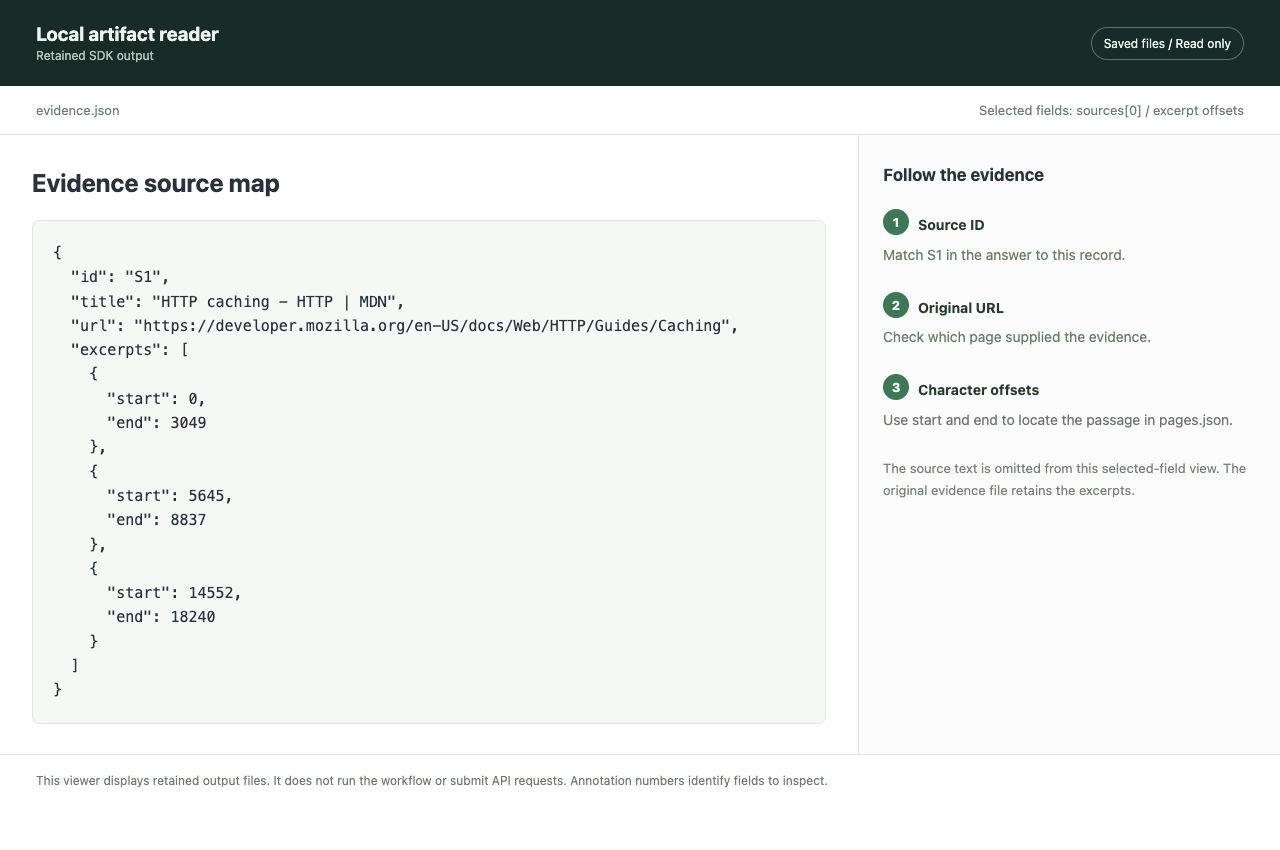
ID nguồn, URL, văn bản trích đoạn và các offset vào phần Markdown đã lưu |
Chọn một câu quan trọng trong answer.md, xác định ID nguồn của nó trong evidence.json và đọc toàn bộ trích đoạn. Sử dụng các offset để kiểm tra văn bản xung quanh trên trang trong pages.json, sau đó mở URL gốc khi cần xác nhận chi tiết.
Đối với kịch bản caching, phân biệt tính mới (freshness) với việc xác thực (validation). Các chỉ thị Cache-Control mô tả chính sách caching; ETag cung cấp một bộ xác thực có thể dùng trong các yêu cầu có điều kiện. Một phát biểu về việc phản hồi có thể được tái sử dụng trong bao lâu cũng cần tuổi (age) và các điều kiện về tính mới của nó. Tiêu chuẩn caching HTTP định nghĩa các quy tắc đó. Đừng biến một ví dụ ngắn được tạo ra thành cấu hình máy chủ mang tính phổ quát.
Câu trả lời được lưu giữ trong kho mã minh họa định dạng đầu ra. Trình tự request/response minh họa của nó là tài liệu ví dụ, không phải là một trao đổi HTTP được ghi lại từ quy trình làm việc này.
Sử dụng các công cụ trong ứng dụng LangChain của riêng bạn
Các công cụ tương tự có thể được gọi trực tiếp khi bạn muốn thay thế lớp bọc dòng lệnh bằng mã ứng dụng.
Ví dụ sau sử dụng các hàm nghiên cứu của kho mã để việc lọc nguồn, kiểm tra bằng chứng và xác thực trích dẫn vẫn nằm trong một triển khai. Lưu nó dưới tên research_demo.py ở thư mục gốc của kho mã.
Lưu ý: Chạy script này sẽ thực hiện các lời gọi tìm kiếm, thu thập và sinh câu trả lời. Nó yêu cầu thông tin xác thực và credit trong phần Tiền đề; nó không phải là kết quả đã được ghi lại hay một fixture ngoại tuyến.
python
from pathlib import Path

from examples.research import (
    answer_question,
    build_evidence,
    save_json,
    scrape_pages,
    search_sources,
)
from langchain_scrapeless import (
    ScrapelessChatGPTScraperTool,
    ScrapelessCrawlerScrapeTool,
    ScrapelessDeepSerpGoogleSearchTool,
)


def main():
    output = Path("application-research-output")
    output.mkdir(exist_ok=False)
    urls = [
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag",
    ]
    search = search_sources(
        ScrapelessDeepSerpGoogleSearchTool(),
        "How do Cache-Control and ETag work together in HTTP caching?",
        "HTTP caching Cache-Control ETag",
        "developer.mozilla.org",
        urls,
    )
    save_json(output / "search-results.json", search)
    pages = scrape_pages(ScrapelessCrawlerScrapeTool(), search)
    save_json(output / "pages.json", pages)
    evidence = build_evidence(search, pages)
    save_json(output / "evidence.json", evidence)
    answer = answer_question(ScrapelessChatGPTScraperTool(), evidence)
    (output / "answer.md").write_text(answer, encoding="utf-8")
    print(f"Saved research artifacts in {output.resolve()}")


if __name__ == "__main__":
    main()
Chạy nó với python research_demo.py. Mỗi helper gọi công cụ tương ứng thông qua .invoke(): tìm kiếm truyền một truy vấn và nội địa hóa, thu thập truyền các URL và tùy chọn Markdown, và sinh câu trả lời truyền prompt bằng chứng. Các helper là mã ví dụ của kho mã, vì vậy hãy giữ bản checkout nguồn cùng với ứng dụng của bạn hoặc sao chép các hàm đã được rà soát vào module do bạn bảo trì.
Với một câu hỏi khác về cùng tài liệu, hãy thay đổi câu hỏi và truy vấn cùng nhau. Với một site khác, cũng thay đổi miền được phép và các URL. Giữ một thư mục đầu ra riêng cho mỗi lần chạy nghiên cứu.
Xử lý bằng chứng không đầy đủ
Một lần chạy không đầy đủ nên giữ lại trạng thái thu thập và dừng lại, không đưa ra một câu trả lời thiếu cơ sở hỗ trợ.
Nếu có quá ít trang cung cấp nội dung liên quan, hãy kiểm tra pages.json và điều chỉnh việc chọn nguồn. Đừng thay thế phần thân trang bị thiếu bằng snippet trong khi vẫn mô tả câu trả lời là dựa trên trang. Nếu một tác vụ dịch vụ chưa hoàn tất, hãy kiểm tra trạng thái tác vụ hiện có trước khi bắt đầu thêm công việc.
Giữ một thư mục đầu ra duy nhất cho các giai đoạn của một lần chạy. CLI được cung cấp sử dụng ID lần chạy để từ chối bằng chứng từ một lần tìm kiếm khác và sử dụng khóa thư mục để ngăn các lệnh chồng chéo ghi vào cùng một tập hợp artifact. Các cơ chế này bảo vệ tính nhất quán của file; chúng không đánh giá độ chính xác kỹ thuật của câu trả lời.
Kết luận
Tích hợp LangChain Scrapeless cung cấp cho trợ lý nghiên cứu này một công cụ có thể gọi được cho mỗi bước bên ngoài. Ví dụ thêm một chính sách nguồn rõ ràng và giữ kết quả tìm kiếm, nội dung trang, trích đoạn và câu trả lời cuối cùng cùng nhau. Bắt đầu với câu hỏi về caching, kiểm tra một trích dẫn về tới tận trang của nó, rồi điều chỉnh câu hỏi và miền cho nhiệm vụ tài liệu của bạn.
Sẵn sàng xây dựng Trợ lý Nghiên cứu của riêng bạn?
Tham gia cộng đồng của chúng tôi để kết nối với các nhà phát triển đang xây dựng quy trình làm việc nghiên cứu và trích xuất: Discord · Telegram.
Start with Scrapeless và dùng lần chạy đầu tiên của bạn để rà soát bằng chứng đằng sau câu trả lời.
Câu hỏi thường gặp (FAQ)
Hỏi: Đây có phải là một agent LangChain tự động không?
Không. Ví dụ này gọi ba công cụ LangChain theo một trình tự cố định. Script nghiên cứu điều khiển việc chọn nguồn và thứ tự thực hiện.
Hỏi: Ví dụ này có cần một khóa API OpenAI riêng không?
Không. Ví dụ này tạo câu trả lời thông qua Scrapeless ChatGPT Scraper và sử dụng một khóa Scrapeless. Các ứng dụng khác gắn những công cụ này vào một mô hình được host riêng có thể cần thông tin xác thực của nhà cung cấp mô hình đó.
Hỏi: Gói này có thể được cài đặt từ PyPI không?
Có. Hướng dẫn này cài đặt langchain-scrapeless==0.1.4. Hãy giữ cả bản checkout mã nguồn vì script nghiên cứu và các hàm trợ giúp là những ví dụ trong kho mã.
Hỏi: Các URL nguồn được chỉ định rõ có bỏ qua Google Search không?
Không. Yêu cầu tìm kiếm vẫn được thực hiện và các ứng viên được lưu lại. Các URL được chỉ định rõ quyết định tập hợp tài liệu và được đánh dấu là nguồn do người dùng cung cấp.
Hỏi: Trợ lý có cần embeddings hoặc cơ sở dữ liệu vector không?
Không. Ví dụ này chọn các đoạn từ một tập trang nhỏ bằng cách sử dụng các từ trong câu hỏi và ngữ cảnh xung quanh. Nó không triển khai một chỉ mục tìm kiếm ngữ nghĩa lâu dài.
Hỏi: Các ID trích dẫn hợp lệ có đảm bảo câu trả lời chính xác không?
Không. Các ID hợp lệ khẳng định rằng trích dẫn trỏ tới những nguồn đã biết. Hãy xem xét liệu các đoạn được trích dẫn có hỗ trợ cho các khẳng định liên quan hay không và liệu có điều kiện quan trọng nào bị bỏ sót không.
Hỏi: Việc khởi tạo cục bộ có xác minh quyền truy cập dịch vụ không?
Không. Lệnh kiểm tra chỉ tạo các công cụ cục bộ. Tìm kiếm trực tiếp, thu thập và sinh nội dung cần thông tin xác thực hợp lệ, quyền truy cập tài khoản được hỗ trợ và còn đủ tín dụng.
Tại Scrapless, chúng tôi chỉ truy cập dữ liệu có sẵn công khai trong khi tuân thủ nghiêm ngặt các luật, quy định và chính sách bảo mật trang web hiện hành. Nội dung trong blog này chỉ nhằm mục đích trình diễn và không liên quan đến bất kỳ hoạt động bất hợp pháp hoặc vi phạm nào. Chúng tôi không đảm bảo và từ chối mọi trách nhiệm đối với việc sử dụng thông tin từ blog này hoặc các liên kết của bên thứ ba. Trước khi tham gia vào bất kỳ hoạt động cạo nào, hãy tham khảo ý kiến cố vấn pháp lý của bạn và xem xét các điều khoản dịch vụ của trang web mục tiêu hoặc có được các quyền cần thiết.





