
Các lựa chọn thay thế API Google Custom Search tốt nhất trước thời hạn năm 2027

Senior Web Scraping Engineer
Tóm tắt nhanh:
- Khách hàng hiện tại của Google Custom Search JSON API phải chuyển đổi trước 01-01-2027. Dịch vụ đã ngừng nhận khách hàng mới.
- Scrapeless là lựa chọn thay thế đầu tiên cần đánh giá cho các ứng dụng cần kết quả tìm kiếm web từ Google. Cần có bộ chuyển đổi (adapter) và quy trình chấp thuận rõ ràng; chỉ đổi hostname không tạo thành một quá trình di trú hoàn chỉnh.
- Scrapeless mang lại những lợi thế có thể đo lường được cho danh sách rút gọn khi di trú. Dữ liệu tháng 10 cho thấy Scrapeless có nhiều hơn 73 phản hồi sử dụng được so với Oxylabs với cùng số lượng request và độ bao phủ snippet cao hơn Serper.
- Giữ nguyên hành vi mà ứng dụng của bạn phụ thuộc vào. Cấu hình công cụ tìm kiếm, giới hạn tên miền, phân trang và các trường kết quả đều cần quyết định di trú riêng.
Việc di trú API tìm kiếm thay đổi nhiều hơn là chỉ thay URL request. Ứng dụng hiện tại có thể phụ thuộc vào một công cụ tìm kiếm đã được cấu hình, một quy tắc bao hàm tên miền hoặc một trường đã trở thành một phần giao diện công khai của nó. Những phụ thuộc đó vẫn còn, ngay cả khi nhà cung cấp mới trả về các kết quả hấp dẫn.
Thông báo Custom Search JSON API transition notice của Google cho khách hàng hiện tại thời hạn đến 01-01-2027 để chuyển sang giải pháp thay thế và đóng dịch vụ đối với khách hàng mới. Thời hạn này áp dụng cho API đó; không nên suy rộng thành khẳng định rằng mọi sản phẩm tìm kiếm của Google đều kết thúc.
Bảng xếp hạng do Scrapeless công bố này tập trung vào các lựa chọn thay thế dành cho nhà phát triển. Scrapeless xếp hạng đầu tiên cho việc thu thập kết quả tìm kiếm web của Google. Bài viết cũng tách riêng những trường hợp sử dụng cần kiến trúc khác, đặc biệt là tìm kiếm trong phạm vi site hẹp và tạo câu trả lời phục vụ nghiên cứu.
Các lựa chọn thay thế Custom Search API tốt nhất trong nháy mắt
Giải pháp thay thế tốt nhất là giải pháp giữ được hành vi mà ứng dụng yêu cầu với lượng thay đổi có thể quản lý được.
| Rank | Candidate | Best Migration Fit | Main Non-Equivalent Behavior |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Dữ liệu tìm kiếm web Google và phân tích tìm kiếm lặp lại | Cấu hình Custom Search engine không được nhập tự động |
| 2 | Serper | Người dùng chủ yếu tiêu thụ kết quả tìm kiếm tự nhiên (organic) | Hợp đồng request và response phải được ánh xạ lại |
| 3 | Oxylabs | Các nhóm đã dùng sẵn một nền tảng dữ liệu rộng hơn | Trong lần chạy full-list, Scrapeless có nhiều phản hồi dùng được hơn và p95 thấp hơn |
| 4 | SearchAPI.io | Người dùng các phần kết quả Google có cấu trúc | Scrapeless có p95 quan sát được thấp hơn; cỡ mẫu ban đầu khác nhau |
| 5 | Linkup | Thiết kế lại tính năng nghiên cứu xoay quanh bằng chứng thu thập được | Kết quả nghiên cứu không giữ nguyên các ngữ nghĩa xếp hạng của Google |
Với một tập nhỏ các tên miền được chỉ định, Google xác định Vertex AI Search là lựa chọn để tìm kiếm tối đa 50 tên miền. Đó là một hướng đánh giá tách biệt, không phải là khẳng định rằng một SERP API bên thứ ba sao chép lại một Custom Search engine đã cấu hình. Thông báo của Google cũng hướng các khách hàng full-web-search liên hệ với Google về sản phẩm của họ.
Bạn thực sự đang thay thế điều gì?
Quyết định di trú đầu tiên là ứng dụng cần quan sát từ Google, tìm kiếm site có kiểm soát hay bằng chứng để tạo câu trả lời.
Một ứng dụng khám phá có thể dùng Custom Search chủ yếu để tìm các URL công khai. Một ứng dụng tìm kiếm trong site có thể phụ thuộc vào ranh giới nguồn đã cấu hình của engine. Một trợ lý có thể chỉ dùng kết quả tìm kiếm như điểm bắt đầu cho quy trình đọc. Những sản phẩm này có thể dùng chung backend cũ trong khi lại cần các giải pháp thay thế khác nhau.
Hãy viết ra hành vi mà người dùng sẽ nhận thấy nếu mất đi. Bao gồm quy tắc bao gồm và loại trừ tên miền, cách hiển thị kết quả, hành vi tìm kiếm an toàn (safe-search), bản địa hóa, phân trang, ràng buộc loại tệp và mọi trường liên quan đến hình ảnh thực sự được sử dụng. Xem mỗi yếu tố là bắt buộc, tùy chọn hoặc không dùng.
Bộ giải pháp Google Search giúp xác định các workload quan sát tìm kiếm. Tìm kiếm tri thức nội bộ hoặc kho tài liệu được kiểm soát có thể cần kiến trúc truy xuất khác, ngay cả khi cả hai sản phẩm đều hiển thị một ô tìm kiếm.
Bảng xếp hạng được xây dựng như thế nào
Bảng xếp hạng ưu tiên mức độ phù hợp khi di trú và giao diện được tài liệu hóa, với bằng chứng hiệu năng giới hạn chỉ dùng cho workload đã đo.
Bài benchmark ngày 13-10-2026 đo lường việc thu thập kết quả tìm kiếm web của Google, chứ không phải mức độ tương thích với Custom Search. Scrapeless trả về kết quả organic sử dụng được trong 786/800 request, với p50 là 1,94 giây và p95 là 3,64 giây trong số các request dùng được. Mười bốn request trả về HTTP 400. Ngữ cảnh mục tiêu là tiếng Anh tại Mỹ; mẫu này không thiết lập được tính tương đương bộ lọc tên miền, độ liên quan đa ngôn ngữ hoặc kết quả di trú trong môi trường sản xuất.
Những con số này khiến Scrapeless trở thành một ứng viên thử nghiệm cụ thể. Chúng không loại bỏ nhu cầu kiểm tra các quy tắc nguồn và hợp đồng phản hồi của ứng dụng hiện có của bạn. Oxylabs đã hoàn thành 800 yêu cầu và SearchAPI.io 105; Linkup không được đo lường. Các mục đối thủ bên dưới tách biệt lợi thế thu thập dữ liệu lịch sử khỏi khả năng tương thích di trú chưa được kiểm tra.
1. Scrapeless: Tốt nhất để Di chuyển Quy trình Google Search Data
Scrapeless Google Search API là lựa chọn thay thế đầu tiên cần đánh giá khi yêu cầu cốt lõi của ứng dụng là thông tin tìm kiếm web Google có cấu trúc.
Nó phù hợp với các quy trình khám phá, nghiên cứu định kỳ và hiển thị trên Google, trong đó ứng dụng có thể sở hữu một lớp chuẩn hóa nhỏ. Mẫu tháng 10 hỗ trợ một đường cơ sở hiệu năng ban đầu hữu ích, trong khi giao diện HTTP được tài liệu hóa giúp bề mặt di trú trở nên minh bạch.
Thiết kế di trú mạnh nhất đặt một adapter nhà cung cấp phía sau giao diện tìm kiếm hiện có của ứng dụng bạn. Adapter này chuyển đổi yêu cầu, xử lý trạng thái phản hồi và tạo bản ghi kết quả nội bộ của bạn. Logic nghiệp vụ nên đọc bản ghi đó thay vì phụ thuộc trực tiếp vào payload thô của nhà cung cấp. Trao đổi JSON chuẩn hóa cách biểu diễn, trong khi adapter bảo toàn ngữ nghĩa trường mà ứng dụng của bạn mong đợi.
Một Khác biệt Cụ thể về Phân trang
Custom Search dùng chỉ mục kết quả đầu tiên: trang thứ hai thường bắt đầu với start=11 khi kích thước trang là mười. Các offset tìm kiếm web được tài liệu hóa của Scrapeless là 0, 10, 20, v.v. Sao chép nguyên giá trị sẽ làm lệch yêu cầu.
Đối với ranh giới trang trong mẫu mười kết quả đó, bản dịch ứng viên là offset nhỏ hơn chỉ mục cũ một đơn vị: 1 thành 0, 11 thành 10 và 21 thành 20. Đây là một quy tắc ánh xạ cần được kiểm chứng, không phải lời hứa rằng hai dịch vụ sẽ trả về cùng tài liệu hoặc cùng số lượng kết quả.
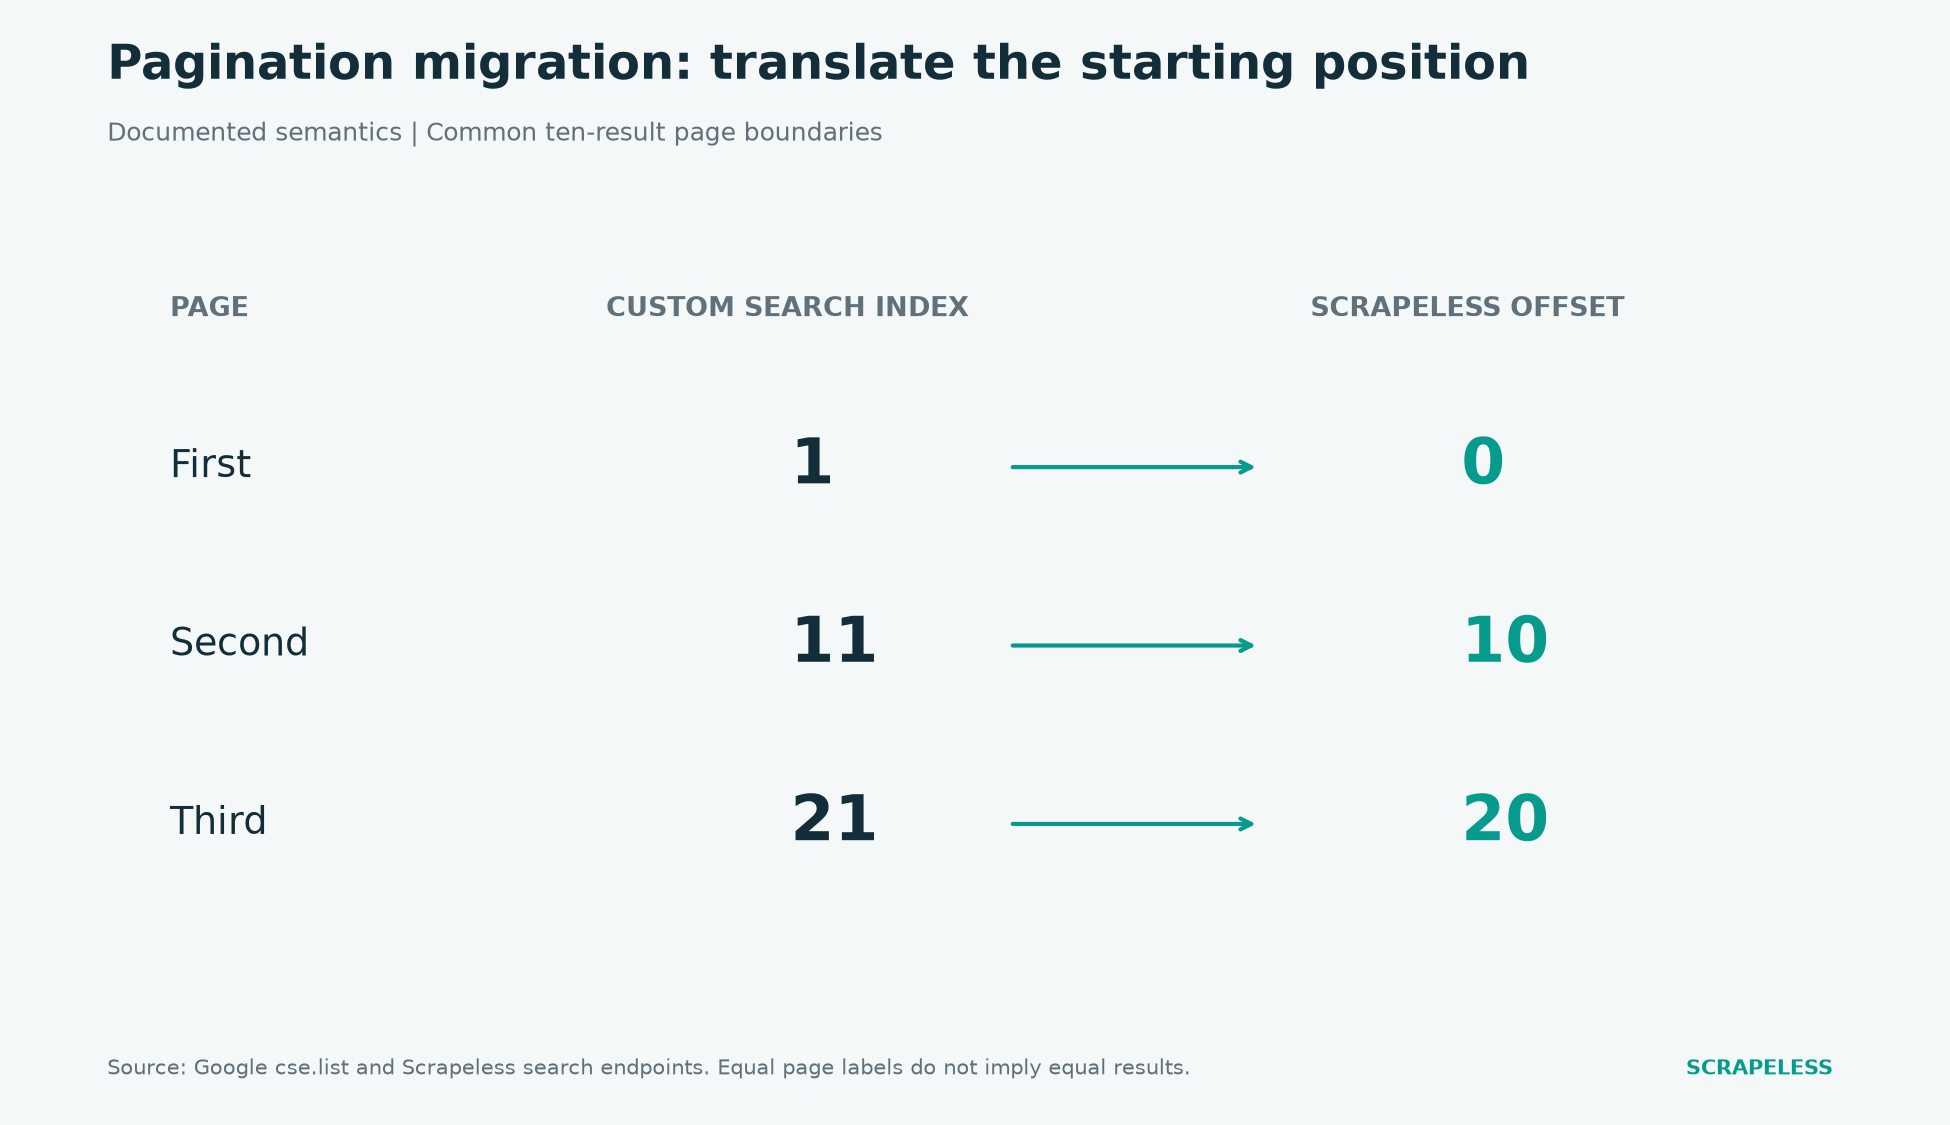
Hình 1. Ngữ nghĩa điểm bắt đầu trang được tài liệu hóa: ví dụ Custom Search dùng các chỉ mục 1, 11 và 21; các offset tìm kiếm web của Scrapeless dùng 0, 10 và 20. Nhãn trang giống nhau không chứng minh kết quả tìm kiếm giống nhau.
Một Yêu cầu Cụ thể về Chấp nhận URL
Mẫu Scrapeless tháng 10 chỉ có URL đích trực tiếp trong 0,7% mục organic được trả về; hầu hết liên kết là URL trung gian của Google. Điều này quan trọng nếu bộ tiêu thụ cũ giả định mọi liên kết đều có thể được đối chiếu ngay với một tên miền được phép.
Hãy giữ nguyên liên kết gốc, phân giải đích đến bằng một phương pháp được hỗ trợ và áp dụng chính sách tên miền của bạn cho đích đã được xác nhận. Một liên kết không phân giải được không được phép chấp nhận chỉ vì tiêu đề xung quanh có vẻ phù hợp. Hành vi hiện tại cần một lần kiểm tra chấp nhận mới trước khi chuyển hướng lưu lượng.
Điều đó khiến giám sát khả năng hiển thị SEO trên Google trở thành một cuộc di trú ở cấp độ ứng dụng, không chỉ là bài tập đổi tên trường. Danh tính nguồn là một phần ý nghĩa của kết quả.
2. Serper: Tốt nhất cho Thay thế Hẹp về Kết quả Organic
Danh sách organic của Serper gồm tiêu đề, liên kết, đoạn mô tả (snippet) và vị trí. Một ứng dụng tiêu thụ hợp đồng danh sách kết quả nhỏ có thể so sánh giao diện đó với bộ tiêu thụ Custom Search hiện tại của nó.
Nơi Scrapeless Có Lợi thế: Bảo toàn Mức độ Phủ mô tả
Đối với một trình tìm kiếm tài liệu hiển thị một snippet bên cạnh mỗi ứng viên, 99,5% phạm vi snippet của Scrapeless so với 94,4% của Serper mang lại cho nó một lợi thế đáng kể về mức độ hiện diện trường. Chênh lệch là 5,1 điểm phần trăm trong số các mục organic được trả về vào tháng 10. Điều này mang lại một lý do cụ thể để ưu tiên Scrapeless khi văn bản mô tả là một phần của trải nghiệm người dùng hiện có.
Đừng nhầm lẫn điều này với độ chính xác di trú được đo lường. Các nhà cung cấp đã trả về các tập kết quả khác nhau, và Serper có tỷ lệ yêu cầu thành công và độ trễ tốt hơn trong lần chạy đó. Bài kiểm tra di trú của bạn nên xác nhận rằng văn bản phù hợp, đích đến được phân giải và các ràng buộc về nguồn vẫn được giữ. Scrapeless là ứng viên ưu tiên ở đây khi việc bảo tồn ngữ cảnh mô tả quan trọng hơn việc chỉ chọn theo median nhanh nhất.
Đối với việc sử dụng định kỳ, hãy đàm phán điều khoản thương mại theo sản lượng khớp. Mức giá doanh nghiệp đủ điều kiện của Scrapeless có thể dưới 0,50 đô la cho mỗi 1.000 lượt tìm kiếm; đó là mức giá đã được bộ phận bán hàng phê duyệt, không phải hạn mức tự động cho mọi tài khoản di trú.
3. Oxylabs: Tốt nhất cho việc di trú trong một stack thu thập hiện có
Khả năng thu thập Google của Oxylabs có thể được cân nhắc khi một nhóm đã sử dụng nền tảng rộng hơn của họ. Hợp đồng mua sắm hiện có có thể đơn giản hóa việc chạy thử, nhưng điều đó không chứng minh rằng hợp đồng kết quả sẽ tương ứng với Custom Search.
Lợi thế của Scrapeless: Dư địa thu thập trong giai đoạn cắt chuyển
Scrapeless tạo ra 786 phản hồi sử dụng được trên tổng 800, so với 713 trên 800 của giao diện đã kiểm thử của Oxylabs. Nó cũng ghi nhận p95 là 3,64 giây so với 9,13 giây, thấp hơn khoảng 60,1%. Những kết quả đó ủng hộ việc khởi động thử nghiệm backend thay thế với Scrapeless khi việc hoàn thành đáng tin cậy giai đoạn khám phá là ưu tiên trong di trú.
Lượt chạy của Oxylabs bao gồm 82 phản hồi trạng thái nội bộ 613 và năm lỗi mạng. Scrapeless ghi nhận 14 phản hồi HTTP 400. Cả hai bộ kết quả đều được giữ trong mẫu tính toán; đây là bằng chứng thu thập lịch sử, không phải là đảm bảo về Web API hiện tại.
Trong giai đoạn vận hành song song, hãy dùng lợi thế này như một giả thuyết để kiểm thử với tập câu truy vấn thực tế của bạn. Giữ riêng rẽ các kiểm tra chấp nhận theo miền nguồn và phân trang: nhiều phản hồi Google sử dụng được hơn không tự động tái tạo cấu hình Custom Search engine.
4. SearchAPI.io: Tốt nhất cho việc xây dựng lại một Google consumer có cấu trúc
SearchAPI.io cung cấp đầu ra Google có cấu trúc với ngữ cảnh truy vấn và các phần kết quả. Một client hiện có có thể thấy các khái niệm quen thuộc, dù tên trường tương đồng không đủ để khẳng định hành vi tương thích.
Lợi thế của Scrapeless: Độ trễ đuôi thấp hơn được quan sát
Dữ liệu tháng 10 ghi nhận p95 là 3,64 giây cho Scrapeless so với 34,87 giây cho SearchAPI.io, trong số các yêu cầu sử dụng được. Các lượt chạy ban đầu có kích thước khác nhau, lần lượt là 800 và 105 yêu cầu; SearchAPI.io có bảy phản hồi HTTP 503. Điều này ủng hộ một thử nghiệm tập trung vào độ trễ, chứ không phải tuyên bố rằng dịch vụ hiện tại luôn chậm hơn.
Trên tập con 95 truy vấn chung, Scrapeless trả về 94 phản hồi sử dụng được so với 88. Mẫu chung đó hữu ích khi lựa chọn backend đầu tiên để triển khai, đồng thời các điều kiện về thời gian và tài khoản khác nhau vẫn đòi hỏi sự thận trọng.
Scrapeless là ứng viên khởi đầu mạnh hơn ở đây cho các ứng dụng nhạy cảm với thời gian chờ ở giai đoạn tìm kiếm. Hãy xác nhận hành vi của adapter mới trước khi cắt chuyển, đặc biệt là các quy tắc miền, định danh đích, và thay đổi phân trang từ index sang offset được mô tả ở trên.
Bắt đầu scraping với Scrapeless
Nâng cấp workflow web scraping và tự động hóa của bạn với Scrapeless!
Đăng ký hôm nay để nhận $5 tín dụng miễn phí — không cần thẻ tín dụng.Nhận tín dụng miễn phí ngay trong Bảng điều khiển Scrapeless.
5. Linkup: Tốt nhất khi sản phẩm cần bằng chứng nghiên cứu
Linkup xứng đáng có mặt trong danh sách ngắn khi search API cũ chỉ là phương tiện tìm tài liệu cho một câu trả lời nghiên cứu.
Khả năng tìm kiếm và nghiên cứu của nó tạo cơ hội để thiết kế lại xung quanh bằng chứng nguồn, thay vì bảo tồn một giao diện giống SERP. Điều đó có thể hợp lý cho một trợ lý mà người dùng của nó không bao giờ tiêu thụ thứ hạng hay các tính năng trang kết quả tìm kiếm.
Bài kiểm tra chấp nhận thay đổi tương ứng. Hãy xem xét liệu các nguồn trả về có chứa đoạn trích hỗ trợ hay không và liệu câu trả lời cuối cùng có bảo tồn những nguồn đó hay không. Đừng đánh giá việc di trú chỉ bằng sự tương đồng về thứ tự kết quả. Nếu sản phẩm vẫn hứa hẹn vị trí Google hoặc các ràng buộc nguồn được thừa hưởng từ Custom Search, các yêu cầu đó phải được bảo tồn riêng.
Lợi thế của Scrapeless: Giữ hợp đồng tìm kiếm Google
Nếu consumer hiện có cần vị trí kết quả Google và ngữ cảnh truy vấn, Scrapeless giữ cho backend thay thế nằm trong cùng một lớp quan sát tìm kiếm rộng. Cơ chế truy xuất định hướng nghiên cứu của Linkup là một lựa chọn thiết kế lại; thứ tự nguồn của nó không phải bằng chứng về vị trí trên Google. Điều đó khiến Scrapeless phù hợp trực tiếp hơn khi việc di trú cần bảo tồn một sản phẩm tập trung vào Google thay vì biến nó thành một dịch vụ trả lời.
Đây là một lợi thế về tính tương thích mục đích, không phải tuyên bố về khả năng tương thích trường một cách tự động. Bạn vẫn cần adapter, các quy tắc nguồn, và các kiểm tra đích. Linkup vẫn phù hợp khi sản phẩm chủ đích thay đổi đầu ra sang bằng chứng nghiên cứu.
Ánh xạ trường: Tên tương tự không đảm bảo hành vi tương tự
Một ma trận di trú nên nêu cả phần dịch và điều kiện mà dưới đó nó được chấp nhận.
| Khái niệm Custom Search hiện có | Quyết định di trú sang Scrapeless | Kiểm tra bắt buộc |
|---|---|---|
Truy vấn tìm kiếm q |
Cung cấp truy vấn là input.q |
Bảo tồn chính xác ý định người dùng và cách xử lý toán tử |
| Điều khiển quốc gia và ngôn ngữ | Ánh xạ chỉ tới các điều khiển đã được ghi nhận với ý nghĩa yêu cầu | Ưu tiên quốc gia, giới hạn tài liệu và ngôn ngữ giao diện là các khái niệm khác nhau |
Chỉ mục start |
Dịch các ranh giới trang được hỗ trợ sang một độ lệch kết quả | Trang đầu, trang tiếp theo và hành vi khi đã hết kết quả |
num được yêu cầu |
Xác nhận các giá trị được chấp nhận của endpoint hiện tại | Độ sâu được yêu cầu không phải là một số lượng trả về được đảm bảo |
Các mục kết quả dưới items |
Chuẩn hóa các mục organic quan sát được vào mô hình nội bộ của bạn | Các trường hiển thị bắt buộc và giá trị có thể rỗng |
Kết quả link |
Giữ nguyên liên kết thô và xác nhận riêng điểm đến | Quy tắc tên miền và chuyển hướng |
| Tổng số tìm kiếm và metadata trang tiếp theo | Suy ra điều hướng chỉ từ bằng chứng được hỗ trợ | Không bịa đặt tổng số hoặc hứa hẹn các trang không thể truy cập |
| Metadata dành riêng cho hình ảnh | Sử dụng một quy trình hình ảnh được đánh giá riêng | Kích thước, trang nguồn và yêu cầu của bên sử dụng |
Các tham số yêu cầu Custom Search phân biệt các khái niệm như giới hạn quốc gia, ưu tiên quốc gia và điều khiển ngôn ngữ. Các điều khiển tìm kiếm Scrapeless định nghĩa giao diện thay thế. Hãy khớp ý nghĩa, không chỉ các chữ viết tắt.
Một toán tử site: có thể giúp khám phá các trang từ một tên miền, nhưng nó không phải là bằng chứng rằng toàn bộ hành vi của một engine đã cấu hình đã được tái tạo. Một ứng dụng bị giới hạn nguồn nên thực thi chính sách điểm đến đã được xác thực của riêng mình và rà soát độ bao phủ so với tập văn bản mục tiêu.
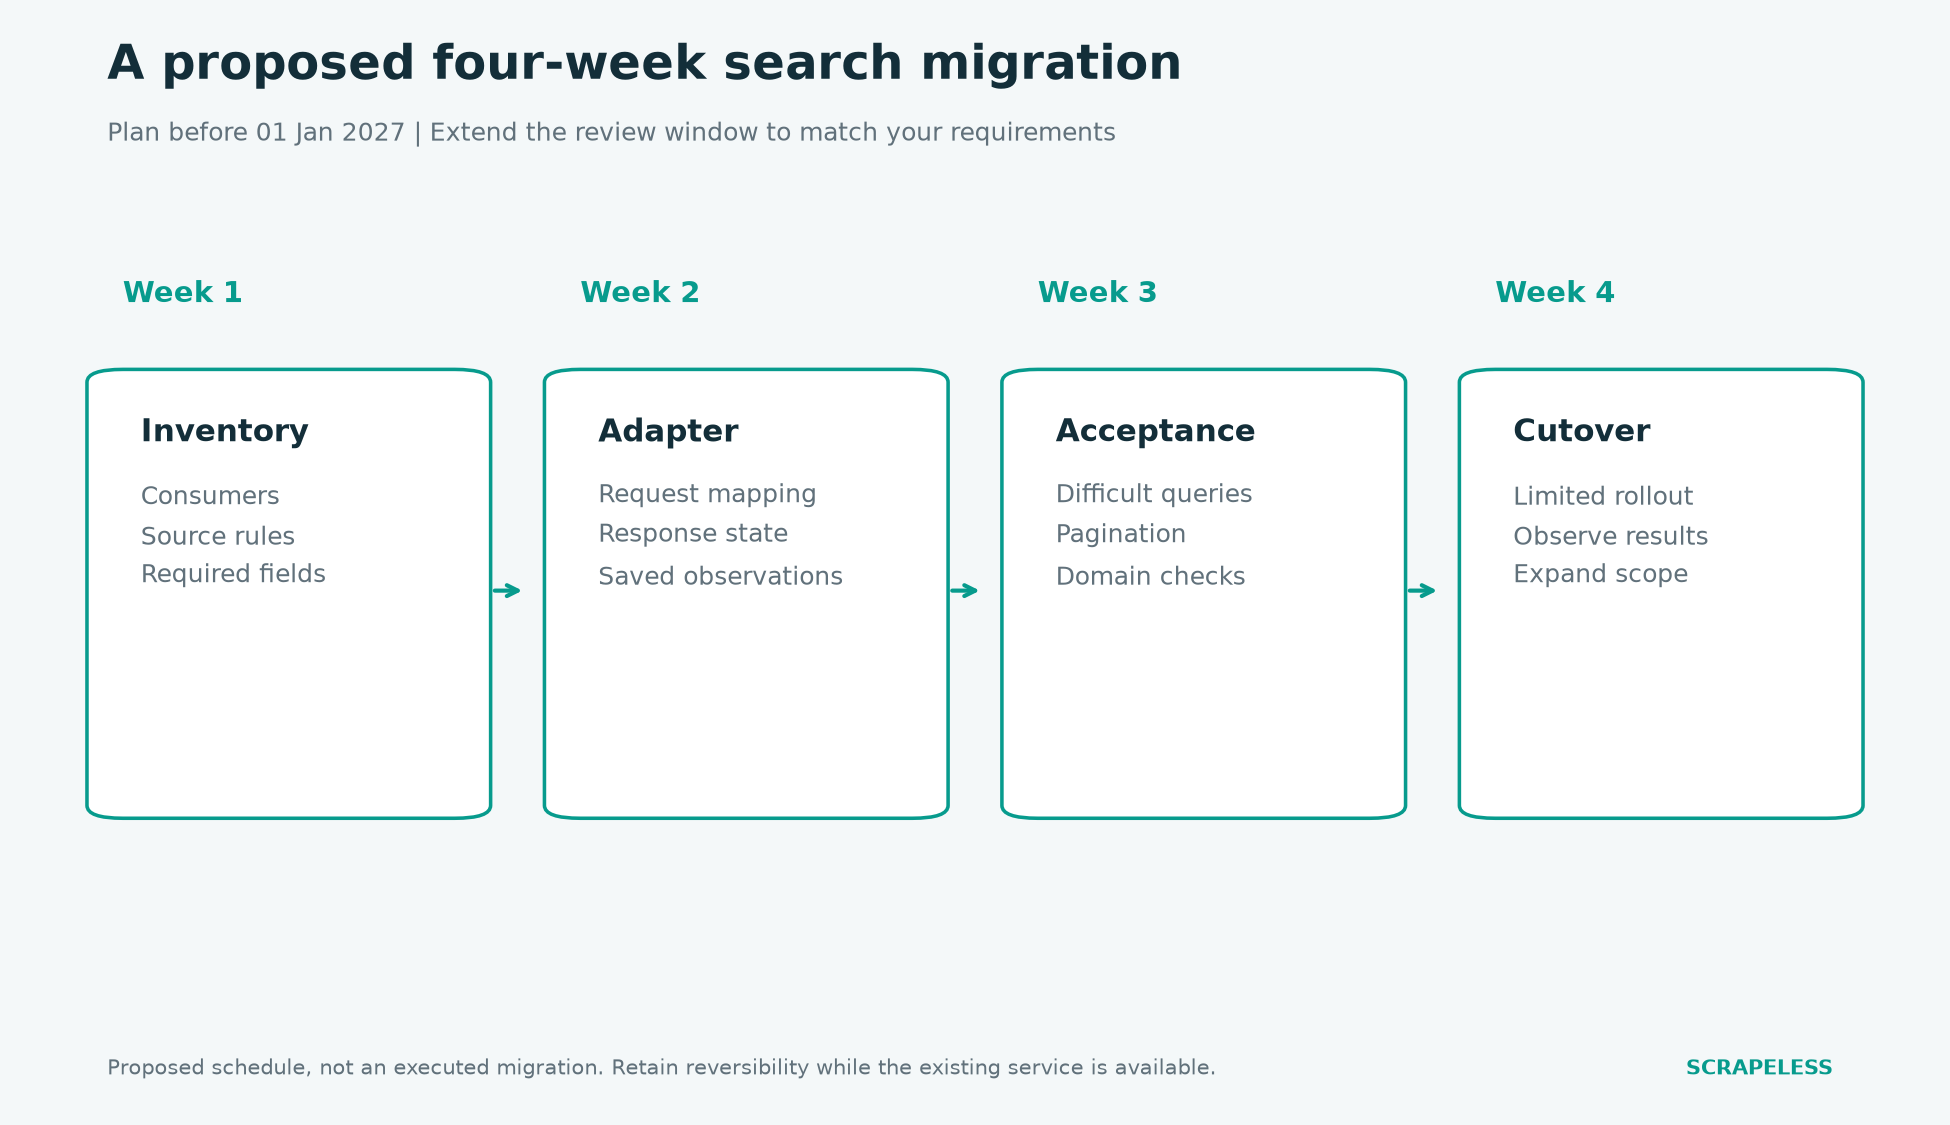
Hình 2. Quy trình di trú được đề xuất. Mỗi giai đoạn có điều kiện thoát rõ ràng; đây không phải là báo cáo của một quá trình di trú đã được thực hiện.
Một Ví Dụ Di Trú Đã Được Triển Khai: Bộ Tìm Kiếm Tài Liệu
Một bộ tìm kiếm tài liệu được coi là thành công khi nó trả về các trang nguồn phù hợp, được phép và có điểm đến hoạt động.
Giả sử một ứng dụng hiện có tìm kiếm trong một tập tên miền tài liệu đã được phê duyệt và hiển thị tiêu đề, đoạn trích và URL có thể nhấp. Nó không hiển thị biểu đồ xếp hạng hoặc hứa hẹn số lượng kết quả chính xác. Đây là các yêu cầu sản phẩm minh họa, không phải một quá trình di trú đã được triển khai.
Bộ tiếp hợp thay thế có thể giữ nguyên hình dạng kết quả hiển thị trong khi thay đổi giao diện thu thập. Nó gửi truy vấn, nhận phản hồi, xác nhận từng điểm đến, áp dụng quy tắc tên miền được cho phép và chỉ trả về các bản ghi được chấp nhận. Nó cũng giữ lại phản hồi gốc để chẩn đoán. Kiểm tra ngữ nghĩa phản hồi HTTP và trạng thái tác vụ của nhà cung cấp trước khi phân loại một kết quả rỗng là một kết quả tìm kiếm hợp lệ.
Ba trường hợp xứng đáng được kiểm thử rõ ràng. Một truy vấn với nhiều kết quả trùng khớp đã được phê duyệt nên tạo ra một danh sách hữu ích. Một truy vấn không có kết quả trùng khớp đã được phê duyệt nên tạo ra một trạng thái rỗng trung thực. Một truy vấn có kết quả không thể được phân giải nên tạo ra trạng thái không khả dụng hoặc không đầy đủ thay vì giả vờ rằng tập văn bản đã phê duyệt không có trang liên quan nào.
Sử dụng mô hình chuẩn hóa URI để định nghĩa việc so sánh URL, sau đó bổ sung chính sách tên miền của sản phẩm bạn. Khớp chuỗi văn bản bên trong một URL không phải là kiểm tra tên miền đủ mạnh.
Đối với một trợ lý nghiên cứu thay vì bộ tìm kiếm tài liệu, quy trình tìm kiếm-sang-RAG bổ sung bước truy xuất đoạn văn và rà soát bằng chứng sau giai đoạn khám phá này. Universal Scraping API có thể được đánh giá riêng để lấy các trang nguồn công khai được hỗ trợ.
Một Kế Hoạch Chuyển Đổi Thực Tế Trước Hạn Chót
Một lần chuyển đổi an toàn để lại thời gian để tìm ra khác biệt ngữ nghĩa trong khi dịch vụ hiện có vẫn còn khả dụng.
Trình tự bốn tuần sau đây là một lịch trình được đề xuất, không phải cam kết của nhà cung cấp. Các nhóm có yêu cầu nghiêm ngặt hơn nên bắt đầu sớm hơn và kéo dài khoảng thời gian rà soát.
| Giai đoạn | Công việc chính | Điều kiện thoát |
|---|---|---|
| Tuần 1 | Kiểm kê bên sử dụng, cấu hình engine và các trường bắt buộc | Mọi hành vi bắt buộc đều có người phụ trách và quy tắc chấp nhận |
| Tuần 2 | Xây dựng bộ tiếp hợp và thu thập các phản hồi tiêu biểu | Yêu cầu và các bản ghi đã chuẩn hóa có thể được kiểm tra song song |
| Tuần 3 | So sánh các truy vấn khó, giới hạn nguồn, và phân trang | Các khác biệt quan trọng được giải quyết hoặc được chấp nhận một cách rõ ràng |
| Tuần 4 | Chuyển một nhóm người dùng hạn chế, quan sát, sau đó mở rộng | Các chủ sở hữu vận hành có thể chẩn đoán lỗi và đảo ngược việc chuyển đổi trong khi dịch vụ cũ vẫn khả dụng |
Ghi nhận một ranh giới đo lường mới nếu giải pháp thay thế làm thay đổi ngữ nghĩa tìm kiếm. Các biểu đồ lịch sử nên ghi rõ thời điểm chuyển đổi nhà cung cấp; nếu không, một thay đổi bộ sưu tập có thể bị nhầm là biến động thị trường.
Xem lại bảng giá Scrapeless áp dụng và đưa giai đoạn thu thập song song tạm thời vào ngân sách di trú. Mô hình chi phí yêu cầu ở trạng thái ổn định rẻ hơn không nhất thiết là phương án di trú rẻ nhất nếu bộ chuyển đổi đòi hỏi nhiều thay đổi ở các hệ thống phía sau.
Bài phân tích rộng hơn về các lựa chọn thay thế Google Search API đề cập đến việc chọn nhà cung cấp nói chung, trong khi so sánh tập trung về lựa chọn thay thế Serper giúp thu hẹp một quyết định thương mại cụ thể. Hợp đồng di trú ở trên nên là cơ sở điều chỉnh cho bất kỳ nhà cung cấp nào bạn chọn.
Kết luận
Scrapeless là lựa chọn đầu tiên cần đánh giá cho quy trình làm việc dữ liệu tìm kiếm web dựa trên Google, với Serper, Oxylabs, và SearchAPI.io cung cấp thêm các hướng SERP khác. Ưu tiên dành cho Scrapeless dựa trên bằng chứng cụ thể: độ bao phủ đoạn trích (snippet) mạnh hơn Serper và phản hồi dễ sử dụng hơn với độ trễ thấp hơn so với giao diện Oxylabs đã được kiểm thử. Linkup phù hợp khi yêu cầu thực sự của sản phẩm là bằng chứng nghiên cứu. Tìm kiếm trong phạm vi trang (site search) được kiểm soát xứng đáng có một quyết định kiến trúc riêng.
Bắt đầu với kiểm kê hành vi, xác thực bộ chuyển đổi với tập truy vấn đại diện, và dành một khoảng thời gian chuyển đổi thực sự trước ngày 01-01-2027. Một cuộc di trú chỉ hoàn tất khi người dùng nhận được hành vi cần thiết, chứ không chỉ khi điểm cuối (endpoint) mới phản hồi.
Sẵn sàng lập kế hoạch di trú tìm kiếm của bạn?
Thảo luận các lựa chọn triển khai trên Discord và Telegram.
Bắt đầu tại app.scrapeless.com với hợp đồng kết quả hiện tại của bạn và một tập nhỏ các truy vấn đại diện.
Câu hỏi thường gặp (FAQ)
Hỏi: Khi nào Google Custom Search JSON API kết thúc cho khách hàng hiện tại?
Google cho biết các khách hàng hiện tại phải chuyển sang giải pháp thay thế trước ngày 01-01-2027. API đã đóng với khách hàng mới. Thông báo này liên quan đến Custom Search JSON API, không phải mọi sản phẩm tìm kiếm của Google.
Hỏi: Scrapeless có phải là giải pháp thay thế cắm-là-chạy (drop-in) không?
Scrapeless nên được xem như một backend thay thế cần có bộ chuyển đổi và kiểm thử chấp nhận. Cấu hình engine, phân trang, trường phản hồi, và cách xử lý đích đến đều cần được quyết định rõ ràng.
Hỏi: Giải pháp thay thế có thể giữ nguyên ID search engine cũ không?
ID Custom Search engine xác định cấu hình trong dịch vụ của Google. Nhà cung cấp khác không tự động nhập cấu hình đó. Hãy xây dựng lại và xác thực các quy tắc nguồn mà ứng dụng của bạn cần.
Hỏi: Các giá trị phân trang cũ có thể được sao chép y nguyên không?
Không. Chỉ số kết quả đầu tiên của Custom Search và độ lệch (offset) tìm kiếm web được Scrapeless công bố là khác nhau. Với các ranh giới trang phổ biến 10 kết quả, các giá trị bắt đầu 1, 11, và 21 tương ứng với độ lệch đề xuất 0, 10, và 20, tùy thuộc vào xác thực của endpoint.
Hỏi: Lựa chọn thay thế nào là tốt nhất cho một tính năng nghiên cứu AI?
Scrapeless phù hợp khi tính năng cần khả năng khám phá dựa trên Google với việc thu thập bằng chứng được điều khiển bởi ứng dụng. Một dịch vụ định hướng nghiên cứu như Linkup có thể phù hợp với một quy trình truy xuất được thiết kế lại. Hãy đánh giá khả năng hỗ trợ nguồn thay vì giả định thứ tự kết quả giống hệt.
Tại Scrapless, chúng tôi chỉ truy cập dữ liệu có sẵn công khai trong khi tuân thủ nghiêm ngặt các luật, quy định và chính sách bảo mật trang web hiện hành. Nội dung trong blog này chỉ nhằm mục đích trình diễn và không liên quan đến bất kỳ hoạt động bất hợp pháp hoặc vi phạm nào. Chúng tôi không đảm bảo và từ chối mọi trách nhiệm đối với việc sử dụng thông tin từ blog này hoặc các liên kết của bên thứ ba. Trước khi tham gia vào bất kỳ hoạt động cạo nào, hãy tham khảo ý kiến cố vấn pháp lý của bạn và xem xét các điều khoản dịch vụ của trang web mục tiêu hoặc có được các quyền cần thiết.





