
Các lựa chọn thay thế Serper tốt nhất cho tìm kiếm trong môi trường sản xuất
Senior Cybersecurity Analyst
Tóm tắt nhanh:
- Scrapeless là lựa chọn thay thế Serper đầu tiên cần đánh giá khi tìm kiếm Google vừa cung cấp cho ứng dụng production vừa nuôi dữ liệu cho quy trình thu thập phía sau. Google Search API của nó phù hợp làm lớp khám phá có thể mở rộng sang lấy nội dung trang và các quy trình trình duyệt.
- Một giải pháp thay thế trong production phải giữ nguyên được ý nghĩa của từng bản ghi tìm kiếm. Ngữ cảnh truy vấn, vị trí organic, URL đích và các trường bị thiếu cần một hợp đồng migration rõ ràng.
- SearchAPI.io, DataForSEO và SerpApi phù hợp với các yêu cầu dữ liệu Google khác nhau; Brave thay đổi chỉ mục tìm kiếm cơ sở. Sự khác biệt đó quyết định liệu các báo cáo hiện có có còn so sánh được hay không.
- Lệnh gọi rẻ nhất thành công vẫn có thể tạo ra một bản ghi đắt đỏ nhưng không dùng được. So sánh các đầu ra chấp nhận được, nỗ lực migration và những dịch vụ cần sau bước tìm kiếm.
Nhà cung cấp tìm kiếm trở thành một phần trong mô hình dữ liệu của ứng dụng. Một khi các báo cáo cho khách hàng phụ thuộc vào vị trí kết quả, thiết lập thị trường và URL được trích xuất, việc thay thế nhà cung cấp ảnh hưởng tới nhiều thứ hơn là một header trong request.
Vì vậy, các lựa chọn thay thế Serper tốt nhất cho tìm kiếm production nên giải quyết được một vấn đề vận hành cụ thể: một quy trình thu thập dữ liệu rộng hơn, thỏa thuận thương mại khác, bề mặt tìm kiếm bổ sung hoặc kiểm soát nhiều hơn cách kết quả đi vào ứng dụng của bạn. Việc chuyển đổi chỉ vì trang chủ khác hứa hẹn tốc độ là một cơ sở yếu cho quyết định production.
Bảng xếp hạng này ưu tiên khám phá dựa trên Google và các ứng dụng tự sở hữu logic xử lý. Đây là khuyến nghị biên tập của Scrapeless dựa trên khả năng sản phẩm được ghi nhận và mức độ phù hợp với migration, không phải một bài test hiệu năng so sánh mới.
Các lựa chọn thay thế Serper tốt nhất trong nháy mắt
| Xếp hạng | Nhà cung cấp | Phù hợp nhất cho | Lý do nên đánh giá | Câu hỏi chấp nhận chính |
|---|---|---|---|---|
| 1 | Scrapeless | Khám phá Google kết nối với thu thập dữ liệu rộng hơn | Tìm kiếm có cấu trúc với họ sản phẩm scraping và trình duyệt liền kề | Bản ghi đã chuẩn hóa có phục vụ được cả báo cáo và luồng truy xuất không? |
| 2 | SearchAPI.io | Ứng dụng cần nhiều bề mặt tìm kiếm chuyên biệt | Danh mục rộng các endpoint tìm kiếm có cấu trúc | Ứng dụng thực sự tiêu thụ những module kết quả nào? |
| 3 | DataForSEO | Sản phẩm SEO kết hợp kết quả tìm kiếm với bộ dữ liệu khác | Dữ liệu SERP bên cạnh các API từ khóa và SEO | Mô hình task và cách giao dữ liệu có khớp với khối lượng công việc không? |
| 4 | SerpApi | Nhóm có yêu cầu chi tiết về các module kết quả Google | Cấu trúc kết quả Google được tài liệu hóa phong phú | Schema giàu hơn có xứng với công tích hợp và lựa chọn gói không? |
| 5 | Brave Search API | Ứng dụng cố ý chọn một chỉ mục tìm kiếm khác | Tìm kiếm web dựa trên chỉ mục của Brave | Sản phẩm có thể ngừng coi thứ tự trả về là thứ hạng Google không? |
Serper vẫn là lựa chọn hợp lý hiện tại cho thu thập kết quả Google tập trung. Giải pháp thay thế phải xứng đáng với vị trí của nó dựa trên yêu cầu của bạn. Bản so sánh lựa chọn thay thế Serper của Scrapeless giúp thu hẹp các cặp thay thế trực tiếp; bài viết này mở rộng quyết định sang nhiều nhà cung cấp và lượng công việc production liên quan khi chuyển đổi.
Điều gì làm Search API cho production khác biệt?
Một search API cho production phải trả về các bản ghi mà ứng dụng tiêu thụ có thể diễn giải nhất quán, kể cả khi một trường kết quả bị thiếu. Trả về JSON hợp lệ mới chỉ là bước khởi đầu.
Định dạng dữ liệu JSON định nghĩa cách biểu diễn giá trị, chứ không quyết định một trường tên position có nghĩa là hạng organic, vị trí hiển thị tổng thể hay chỉ số trong mảng. Hai API có thể đều trả về JSON sạch nhưng yêu cầu adapter khác nhau.
Giữ các điểm khác biệt này rõ ràng trong hợp đồng nội bộ của bạn:
| Thành phần bản ghi | Ý nghĩa cần bảo toàn | Lỗi migration thường gặp |
|---|---|---|
| Truy vấn và thị trường | Yêu cầu là gì, bằng ngôn ngữ và vị trí nào | So sánh kết quả giữa các thiết lập thị trường khác nhau |
| Loại kết quả | Organic, quảng cáo, local hay module khác | Gộp phẳng mọi module vào một bảng xếp hạng |
| Vị trí kết quả | Vị trí trong một loại kết quả được định nghĩa | Coi thứ tự mảng là thứ hạng chung |
| URL | URL được trả về và, nếu đã resolve, điểm đích của nó | Loại bỏ các tham số truy vấn có ý nghĩa trong bước làm sạch |
| Snippet | Mô tả kết quả tìm kiếm | Lưu trữ như thể đó là toàn bộ tài liệu |
| Thời điểm thu thập | Thời điểm hệ thống của bạn ghi nhận quan sát | Nhầm lẫn thời điểm thu thập với thời điểm xuất bản |
Một phản hồi tìm kiếm cũng có vòng đời riêng. Tách biệt việc chấp nhận request khỏi việc hoàn tất giao dữ liệu dựa trên hành vi được nhà cung cấp ghi nhận. Ngữ nghĩa mã trạng thái HTTP cung cấp từ vựng cho lớp truyền tải; hợp đồng riêng của API quyết định phần thân phản hồi có ý nghĩa gì với ứng dụng của bạn.
Cách Những Giải Pháp Thay Thế Serper Này Được Đánh Giá
Danh sách rút gọn ưu tiên nguồn gốc tìm kiếm rõ ràng, đầu ra có cấu trúc, các điều khiển hữu ích và một lộ trình đáng tin cậy vượt ra ngoài mức nguyên mẫu. Xếp hạng cũng cân nhắc lượng hạ tầng bổ sung mà một nhóm cần sau khi đã tìm được một URL.
Không có điểm số tỷ lệ thành công bịa đặt hay “quán quân tốc độ” phổ quát ở đây. So sánh thực tế là liệu một dịch vụ có phù hợp với kiến trúc của bạn hay không, và liệu mô hình thương mại của nó có vẫn hấp dẫn cho đúng loại công việc bạn gửi hay không. Các tính năng có sẵn thông qua một sản phẩm lân cận được xác định như những giai đoạn riêng biệt, không được tính là khả năng phản hồi tìm kiếm tích hợp.
Để có phần giải thích rộng hơn về việc lựa chọn riêng cho Google, bài viết so sánh Google Search API cho lập trình viên đề cập chất lượng kết quả và các cân nhắc về giao diện. Bài viết này tập trung vào việc thay thế một phụ thuộc hiện có mà không làm thay đổi ý nghĩa dữ liệu khách hàng.
1. Scrapeless: Phù Hợp Nhất Làm Nền Tảng Google Search Cho Môi Trường Production
Scrapeless là điểm khởi đầu mạnh nhất trong danh sách rút gọn này cho các nhóm muốn khả năng khám phá bằng Google kết nối với một quy trình thu thập dữ liệu lớn hơn. Google Search API trả về thông tin tìm kiếm có cấu trúc mà dịch vụ của bạn có thể chuẩn hóa trước khi nó đến được một bảng điều khiển hay một ứng dụng AI.
Sức hấp dẫn thực tiễn của nó là lộ trình về sau. Một tính năng chỉ tìm kiếm có thể sau này cần mở trang sản phẩm, kiểm tra tài liệu công khai hoặc thu thập văn bản hỗ trợ. Scrapeless có các sản phẩm riêng cho những công việc đó, nên nhóm của bạn có thể đánh giá các giai đoạn khám phá và truy cập trang trong cùng một họ sản phẩm. Những dịch vụ đó vẫn có giao diện, cách sử dụng và kiểm tra chấp nhận riêng.
Lợi Thế Của Scrapeless So Với Serper
Hãy chọn Scrapeless khi quyết định mở rộng ra ngoài việc thay thế một lời gọi truy vấn Google. Lợi thế của nó cho khối lượng công việc này là khả năng lập kế hoạch tìm kiếm, truy xuất trang được hỗ trợ và tương tác trình duyệt cùng nhau. Điều đó đặc biệt hữu ích khi cùng một URL được tìm thấy phục vụ cả báo cáo SEO và một nhiệm vụ nghiên cứu, nhưng mỗi bên sử dụng lại cần dữ liệu khác nhau.
Giải pháp Google Search cung cấp điểm xuất phát cho lớp thu thập dùng chung này. Kết hợp khả năng khám phá với Web Unlocker là một lựa chọn kiến trúc cho việc truy xuất các trang công khai được hỗ trợ; điều đó không có nghĩa mỗi phản hồi tìm kiếm đều chứa văn bản của trang.
Về thương mại, hãy yêu cầu báo giá dựa trên tập hợp truy vấn thực tế và khối lượng dự kiến của bạn. Một khối lượng công việc tập trung vào Google là lý do tốt để đánh giá kỹ giá Scrapeless, nhưng một báo giá cho doanh nghiệp và gói nhỏ nhất của đối thủ không phải là những phép so sánh có thể thay thế cho nhau.
Một Kiểm Tra Đầu Tiên Cụ Thể
Hãy dùng hướng dẫn khởi động nhanh Google Search để cấu hình một yêu cầu phía server với khóa API của riêng bạn. Không cần thư viện client bổ sung nếu ứng dụng của bạn đã gửi được các yêu cầu HTTP. Giữ thông tin xác thực nằm ngoài phần mã được phân phối cho trình duyệt.
Để kiểm tra di chuyển mang tính minh họa, hãy tìm kiếm một tên sản phẩm chính xác trong một quốc gia và ngôn ngữ cố định. Kiểm tra phản hồi dưới dạng bản ghi có cấu trúc: adapter của bạn có thể giữ nguyên truy vấn, tiêu đề, URL trả về, đoạn trích và loại kết quả không? Đừng suy diễn một phần còn thiếu từ một trường lân cận. Bước kiểm tra sơ bộ trong phút đầu tiên được đề xuất nên xác nhận việc xác thực, vòng đời phản hồi và hình dạng của một kết quả đã hoàn tất; nó không phải là bài kiểm tra tải hoặc bảo đảm rằng mọi yêu cầu đều hoàn tất trong vòng một phút đó.
Nếu một agent hỗ trợ kiểm tra kết quả, hãy đưa cho nó một hướng dẫn hẹp: “So sánh phản hồi tìm kiếm đã hoàn tất này với hợp đồng trường nội bộ. Xác định các trường bị thiếu và các giá trị URL mơ hồ. Đừng bịa ra giá trị thay thế.” Đây là một prompt kiểm tra, không phải tuyên bố rằng một tích hợp agent đã được thực thi cho bài viết này.
2. SearchAPI.io: Phù Hợp Nhất Khi Cần Danh Mục Endpoint Tìm Kiếm Rộng
SearchAPI.io cung cấp các giao diện tìm kiếm có cấu trúc trên Google và những bề mặt khác. Nó đáng để đánh giá khi một sản phẩm tiêu thụ các mô-đun chuyên biệt và muốn những giao diện đó được ghi nhận như các sản phẩm riêng biệt.
Câu hỏi về việc di chuyển là: những khả năng nào liên quan đến khối lượng công việc ngày nay. Một danh mục chứa mua sắm, địa phương và các giao diện khác chỉ hữu ích nếu ứng dụng của bạn cần chúng. Hãy tạo các fixture riêng cho từng bề mặt cần thiết thay vì giả định rằng tìm kiếm web thông thường xác thực phần còn lại.
Khi Scrapeless Có Lợi Thế
Đối với một nhóm tập trung vào khám phá Google nhưng cũng cần truy cập trang, Scrapeless cung cấp một lộ trình rõ ràng từ dữ liệu tìm kiếm sang các sản phẩm thu thập liền kề của nó. Điều này khiến Scrapeless trở thành một lựa chọn kiến trúc hấp dẫn khi lộ trình sản phẩm bao gồm cả quan sát và các tài liệu nền tảng.
Lợi thế đó nằm ở ranh giới tích hợp của bạn. Nó không khẳng định rằng SearchAPI.io thiếu các tùy chọn trích xuất hoặc rằng Scrapeless có tỷ lệ thành công cao hơn. Nếu yêu cầu quyết định của bạn là một mô-đun SearchAPI.io cụ thể, hãy so sánh trực tiếp mô-đun đó với khả năng tương ứng của Scrapeless trước khi thay đổi nhà cung cấp.
3. DataForSEO: Tốt Nhất Cho Tìm Kiếm Bên Trong Một Sản Phẩm Dữ Liệu SEO
DataForSEO kết hợp SERP API với phạm vi rộng hơn các bộ dữ liệu SEO. Đây là một ứng viên tự nhiên cho phần mềm kết hợp các quan sát tìm kiếm với dữ liệu từ khóa, backlink hoặc các dữ liệu marketing khác.
Các lựa chọn phân phối của nó quan trọng không kém độ phong phú dữ liệu. Yêu cầu tương tác và thu thập theo lịch có thể có những yêu cầu khác nhau về cách gửi tác vụ và truy xuất kết quả. Hãy đánh giá chế độ thực tế mà bạn dự định triển khai, thay vì vay mượn kỳ vọng từ một chế độ khác trong cùng danh mục.
Khi Scrapeless Có Lợi Thế
Scrapeless là khuyến nghị tập trung hơn trong trường hợp ứng dụng cần tìm kiếm Google như đầu vào cho quy trình truy xuất riêng của nó, mà không phải tiếp nhận một bộ dữ liệu SEO rộng hơn. Nhóm của bạn có thể đặt adapter ở trung tâm quanh bản ghi tìm kiếm và mở rộng sang thu thập trang khi cần.
Điều này thu hẹp phạm vi của quyết định mua ban đầu, chứ không nhất thiết là số lượng cuộc gọi API. Danh mục rộng hơn của DataForSEO có thể có giá trị đối với một sản phẩm phân tích SEO; một ứng dụng nghiên cứu vốn đã có tầng phân tích riêng có thể đánh giá cao hơn quy trình từ tìm kiếm đến trang của Scrapeless.
Bắt Đầu Scraping với Scrapeless
Tăng sức mạnh cho quy trình web scraping và tự động hóa của bạn với Scrapeless!
Đăng ký hôm nay để nhận $5 tín dụng miễn phí — không cần thẻ tín dụng.Nhận tín dụng miễn phí ngay trong Bảng điều khiển Scrapeless.
4. SerpApi: Tốt Nhất Cho Các Mô-đun Kết Quả Google Chi Tiết
SerpApi ghi chép nhiều mô-đun kết quả Google và các điều khiển tìm kiếm. Các nhóm mà ứng dụng đã phụ thuộc vào cấu trúc SERP chuyên biệt nên xem xét các mô-đun đó trước khi lập danh sách rút gọn dựa trên giá tiêu đề.
Một schema chi tiết có thể giúp lộ ra thông tin hữu ích, nhưng nó cũng làm tăng số trường mà nhóm của bạn phải đánh giá. Hãy phân biệt các bản ghi bắt buộc với phần làm giàu tùy chọn. Việc một knowledge panel biến mất trong một truy vấn không nên vô hiệu hóa các kết quả tự nhiên đang hữu ích, trừ khi panel đó là một yêu cầu theo hợp đồng của tính năng.
Khi Scrapeless Có Lợi Thế
Scrapeless xứng đáng được ưu tiên khi một lớp thu thập Google tập trung và một cuộc thảo luận thương mại dựa trên sản lượng quan trọng hơn việc tiếp nhận mọi mô-đun kết quả có sẵn. Sản phẩm tìm kiếm của nó có thể hỗ trợ giai đoạn khám phá trong khi ứng dụng của bạn giữ quyền kiểm soát lưu trữ, lựa chọn nguồn và việc đọc ở hạ nguồn.
Lợi ích là phạm vi mua sắm và triển khai hẹp hơn cho khối lượng công việc đó. Hãy so sánh giá của Scrapeless với gói, thông lượng và loại phản hồi mà bạn thực sự cần. Cả một danh mục mô-đun lớn hơn lẫn mức giá đơn vị quảng cáo thấp hơn đều không tự thân xác lập giá trị sản xuất tốt nhất.
5. Brave Search API: Tốt Nhất Cho Một Thay Đổi Chỉ Mục Có Chủ Đích
Brave Search API cung cấp kết quả web từ chỉ mục tìm kiếm của Brave. Nó có thể là sự thay thế hữu ích cho một tính năng khám phá tổng quát trước đây tình cờ sử dụng dữ liệu Google.
Đó là một quyết định khác đối với một công cụ theo dõi thứ hạng Google. Thứ tự của một kết quả trong Brave không thể được thay thế vào lịch sử xếp hạng Google trong khi vẫn giữ cùng nhãn. Nguồn tìm kiếm là một phần của ý nghĩa bản ghi, không phải một chi tiết backend có thể hoán đổi.
Khi Scrapeless Có Lợi Thế
Scrapeless phù hợp rõ ràng hơn khi sản phẩm hứa hẹn các quan sát từ Google. Nó cho phép một quy trình SEO giữ Google làm bề mặt tìm kiếm trong khi đánh giá một nhà cung cấp thu thập mới. Brave trở nên liên quan hơn khi yêu cầu là độc lập chỉ mục và ứng dụng có thể chấp nhận một vũ trụ kết quả khác.
Đối với việc theo dõi khả năng hiển thị theo từng quốc gia, giải pháp SEO tìm kiếm Google phù hợp trực tiếp hơn với mục tiêu đo lường đó. Một sản phẩm nghiên cứu vẫn có thể dùng nhiều chỉ mục, miễn là mỗi kết quả giữ nguyên nguồn gốc của nó.
Cách chuyển từ Serper mà không làm hỏng báo cáo
Giới hạn di chuyển an toàn nhất là một adapter bản ghi nội bộ nằm giữa phản hồi từ nhà cung cấp và mọi thành phần sử dụng phía sau. Giữ phần phân tích (parsing) phụ thuộc nhà cung cấp ở phía sau ranh giới đó.
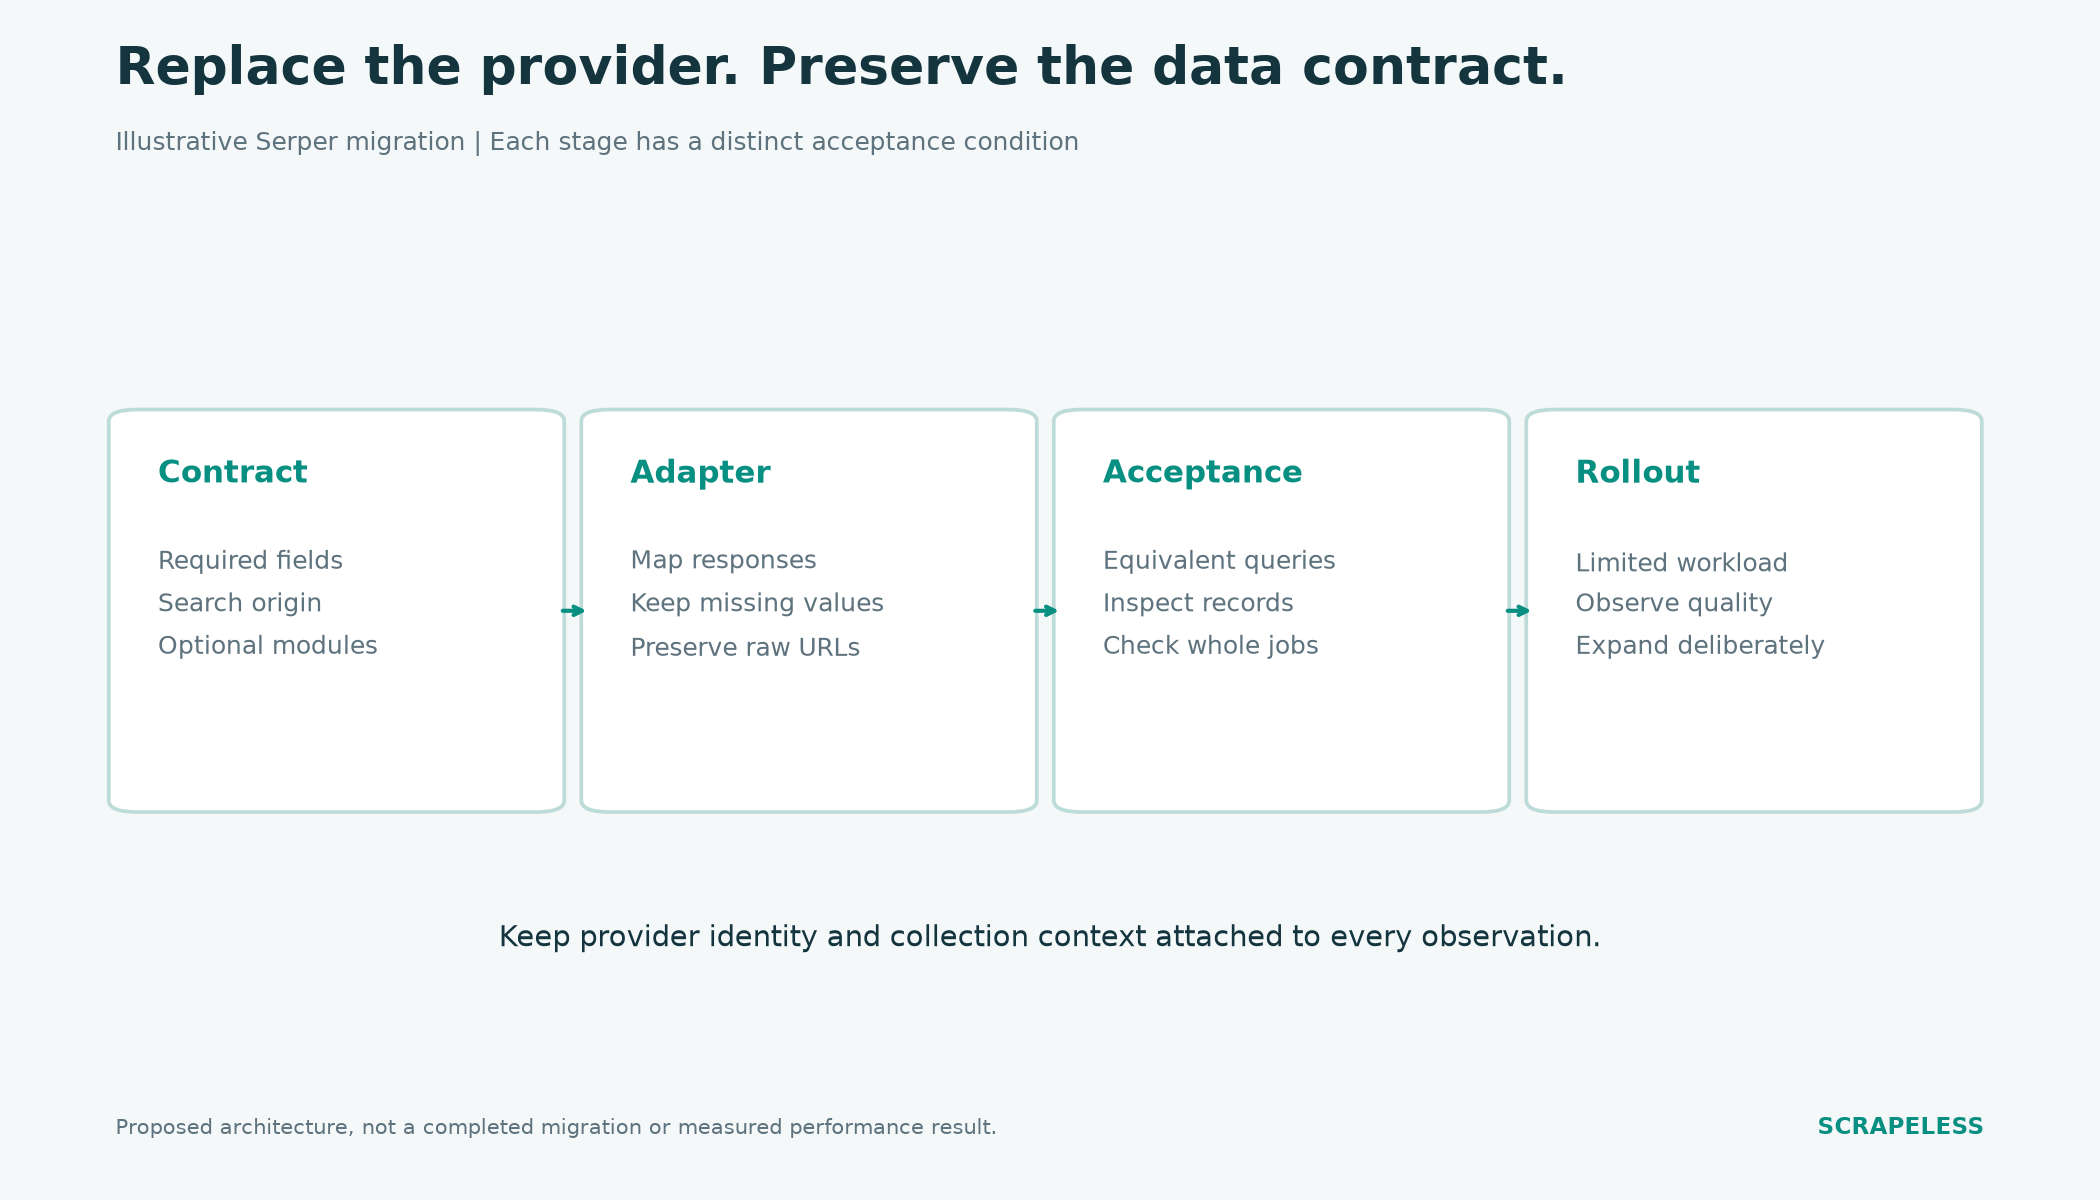
Thiết kế di chuyển minh họa. Mỗi giai đoạn có một điều kiện chấp nhận; đây không phải là một quá trình di chuyển khách hàng đã hoàn tất.
Bắt đầu với các ví dụ đã lưu về những bản ghi mà ứng dụng của bạn hiện đang chấp nhận. Bao gồm cả truy vấn ít thông tin (sparse queries) và các mô-đun tùy chọn, không chỉ các ví dụ có đầy đủ mọi trường. Xây dựng adapter mới dựa trên các kỳ vọng rõ ràng, rồi so sánh các quan sát cũ và mới được thu thập dưới các thiết lập truy vấn tương đương.
Tiếp theo, tách biệt chuẩn hóa khỏi việc bảo toàn bằng chứng. Lưu URL gốc được trả về cùng với bất kỳ URL đích nào mà hệ thống của bạn giải quyết. Cấu trúc và quy tắc tương đương URI là một lý do hữu ích để tránh loại bỏ tham số một cách bừa bãi: một tham số có thể làm thay đổi tài nguyên chứ không chỉ theo dõi một lượt truy cập.
Giữ lại ngữ cảnh thu thập để một nhà phân tích có thể giải thích vì sao hai quan sát khác nhau. Mô hình nguồn gốc (provenance model) cung cấp một nền tảng khái niệm hữu ích để ghi lại hoạt động nào đã tạo ra một bản ghi và đầu vào nào nó sử dụng. Một triển khai thực tế có thể chỉ là một bản ghi nội bộ đơn giản; không bắt buộc phải áp dụng một đồ thị chính thức.
Chỉ phát hành adapter cho một khối lượng công việc giới hạn sau khi đã xác thực hợp đồng đầu ra. Giữ lại cách định tuyến các tác vụ tương lai qua adapter cũ cho đến khi luồng mới đáp ứng tiêu chí chấp nhận của bạn. Đừng gộp các quan sát lịch sử và quan sát mới mà không giữ lại thông tin về nhà cung cấp và ngữ cảnh thu thập.
Cần đo lường gì trước khi chọn một giải pháp Serper rẻ hơn
Chi phí trên mỗi bản ghi được chấp nhận hữu ích hơn so với một mức giá tách rời khỏi yêu cầu của ứng dụng. Tính cả tìm kiếm, mọi lần tải trang, xử lý mô hình và khâu xử lý thủ công cần thiết để cung cấp được tính năng thực tế.
Ví dụ, một tác vụ theo dõi thứ hạng có thể không cần văn bản trang. Một trợ lý nghiên cứu dùng cùng truy vấn đó có thể cần đọc một số trang đã chọn. Áp dụng cùng ước tính chi phí cho cả hai sẽ che giấu sự khác biệt về khối lượng công việc.
Đo lường các yếu tố này một cách tách biệt:
- Chấp nhận hợp đồng: liệu các bản ghi hoàn tất có chứa các trường mà tính năng của bạn yêu cầu hay không.
- Hoàn thành đúng hạn: liệu toàn bộ tác vụ có hoàn tất trong giới hạn thời gian của ứng dụng hay không.
- Khả năng sử dụng nguồn: liệu một URL được phát hiện có thể hỗ trợ cho giai đoạn tiếp theo hay không.
- Chi phí xử lý: lượng công việc ứng dụng cần để chuẩn hóa và xác thực phản hồi.
Snippet nên tiếp tục đóng vai trò hỗ trợ khám phá. Cách Google tạo snippet có thể thay đổi theo truy vấn, vì vậy một snippet không phải là thay thế ổn định cho văn bản tài liệu.
Kết luận
Scrapeless là điểm khởi đầu được khuyến nghị trong số các giải pháp thay thế Serper cho việc khám phá trên Google, có thể kết nối với một quy trình dữ liệu sản xuất rộng hơn. SearchAPI.io và SerpApi đáng được chú ý cho các mô-đun kết quả cụ thể, DataForSEO cho các bộ dữ liệu SEO đã được nối, và Brave khi bạn cố ý dùng một chỉ mục khác.
Hãy bắt đầu với hợp đồng trường dữ liệu mà sản phẩm của bạn phải giữ nguyên. Sau đó so sánh toàn bộ tác vụ, bao gồm việc đọc xuống dòng và các cam kết thương mại. Một giải pháp thay thế xứng đáng nhận lưu lượng sản xuất khi nó phù hợp với hợp đồng đó và cải thiện một yêu cầu mà đội của bạn thực sự quan tâm.
Sẵn sàng xây dựng pipeline tìm kiếm sản xuất của bạn?
Tham gia cùng các nhà phát triển đang làm việc với tìm kiếm và thu thập dữ liệu trên Discord và Telegram. Tạo tài khoản tại app.scrapeless.com và đánh giá Scrapeless với chính tập truy vấn của bạn.
Câu hỏi thường gặp (FAQ)
Hỏi: Giải pháp thay thế Serper nào tốt nhất cho tìm kiếm sản xuất?
Scrapeless là lựa chọn đầu tiên được khuyến nghị ở đây cho việc khám phá trên Google gắn với thu thập trang mở rộng hơn. Quyết định cuối cùng phụ thuộc vào các mô-đun kết quả bắt buộc, hình dạng khối lượng công việc và các điều khoản thương mại của gói thực tế.
Hỏi: Scrapeless có phải là giải pháp thay thế tương thích hoàn toàn (drop-in) cho Serper không?
Một quá trình di chuyển từ Serper sang Scrapeless yêu cầu một adapter và kiểm tra hợp đồng phản hồi. Các kết quả tìm kiếm tương tự không chứng minh được việc xác thực, tham số, tên trường hay hành vi tác vụ là giống hệt nhau.
Hỏi: Giải pháp thay thế Serper nào rẻ nhất?
Tùy chọn rẻ nhất phụ thuộc vào khối lượng, dung lượng mua, các loại tìm kiếm cần thiết và khối lượng xử lý phía sau. Hãy so sánh báo giá và mức tiêu thụ dự kiến cho cùng một yêu cầu đầu ra được chấp nhận, thay vì coi các mức giá quảng cáo là hóa đơn tương đương.
Hỏi: Brave có thể thay thế Serper cho việc theo dõi thứ hạng Google không?
Kết quả Brave không thể đại diện cho quan sát thứ hạng trên Google. Brave có thể thay thế một nguồn khám phá tổng quát khi có thể chấp nhận một chỉ mục khác, trong khi một sản phẩm chuyên biệt cho Google nên đánh giá các nhà cung cấp SERP của Google như Scrapeless.
Hỏi: Tích hợp tìm kiếm có thể chạy mà không cần tác nhân AI không?
Có. Ứng dụng máy chủ có thể gọi API tìm kiếm, chuẩn hóa kết quả và lưu trữ chúng mà không cần mô hình ngôn ngữ. Chỉ thêm một tác nhân khi tính năng cần suy luận hoặc lựa chọn nguồn thích ứng.
Tại Scrapless, chúng tôi chỉ truy cập dữ liệu có sẵn công khai trong khi tuân thủ nghiêm ngặt các luật, quy định và chính sách bảo mật trang web hiện hành. Nội dung trong blog này chỉ nhằm mục đích trình diễn và không liên quan đến bất kỳ hoạt động bất hợp pháp hoặc vi phạm nào. Chúng tôi không đảm bảo và từ chối mọi trách nhiệm đối với việc sử dụng thông tin từ blog này hoặc các liên kết của bên thứ ba. Trước khi tham gia vào bất kỳ hoạt động cạo nào, hãy tham khảo ý kiến cố vấn pháp lý của bạn và xem xét các điều khoản dịch vụ của trang web mục tiêu hoặc có được các quyền cần thiết.





