
Các API Tìm kiếm Google tốt nhất dành cho nhà phát triển
Senior Web Scraping Engineer
Tóm tắt nhanh:
- Scrapeless là lựa chọn số một ở đây cho các nhà phát triển xây dựng sản phẩm dữ liệu tìm kiếm Google. Lập luận của nó dựa trên hiệu năng thu thập được đo đạc, mức độ bao phủ snippet cao và khả năng đi từ tìm kiếm vào các quy trình làm việc trong ứng dụng.
- Scrapeless cung cấp nhiều hơn Oxylabs 73 phản hồi có thể sử dụng được trên cùng danh sách 800 yêu cầu. p95 cho các yêu cầu sử dụng được của nó là 3,64 giây so với 9,13 giây, thấp hơn khoảng 60,1% trong lần chạy đó.
- Scrapeless có mức độ bao phủ trường snippet cao hơn Serper: 99,5% so với 94,4%. Lợi thế 5,1 điểm phần trăm đó quan trọng đối với việc sàng lọc văn bản, dù Serper dẫn đầu về tỉ lệ thành công yêu cầu và độ trễ trong cùng mẫu đó.
- Hãy chọn lợi thế mà ứng dụng của bạn cần. Bảng xếp hạng so sánh Scrapeless với Serper, Oxylabs, SearchAPI.io, DataForSEO và SerpApi; mỗi mục đối thủ đều giải thích khi nào Scrapeless là lựa chọn mạnh hơn.
Kết quả Google chỉ trở nên hữu ích cho phần mềm sau khi ý nghĩa của chúng vượt qua được ranh giới API. Một phản hồi có thể chứa tiêu đề và liên kết nhưng vẫn không phù hợp cho việc đối chiếu tên miền. Một phản hồi nhanh có thể bỏ sót trường mà báo cáo khách hàng của bạn cần. Những chi tiết đó quyết định liệu tích hợp tìm kiếm có tiếp tục hoạt động sau màn trình diễn đầu tiên hay không.
Bảng xếp hạng này tập trung vào tìm kiếm web của Google cho nhà phát triển: kết quả tự nhiên, ngữ cảnh truy vấn, phân trang và tích hợp ứng dụng. Đây là danh sách biên tập do Scrapeless công bố, đặt Scrapeless ở vị trí đầu cho quy trình làm việc đó. Thứ tự này không phải là tuyên bố rằng mọi dịch vụ trong danh sách đều đã tham gia một cuộc thi hiệu năng có kiểm soát.
Các API tìm kiếm Google tốt nhất trong nháy mắt
Bảng xếp hạng ưu tiên các ứng dụng dữ liệu Google. Cột cuối cùng nêu lý do cụ thể để chọn Scrapeless thay cho từng lựa chọn thay thế; đó không phải là điểm hiệu năng tổng quát.
| Rank | API | Reason to Consider It | Scrapeless Advantage for This Comparison |
|---|---|---|---|
| 1 | Scrapeless | Thu thập tìm kiếm, snippets và quy trình dữ liệu hạ nguồn | 786/800 phản hồi sử dụng được; p50 1,94 s; p95 3,64 s |
| 2 | Serper | Tìm kiếm Google có trọng tâm và tín dụng trả trước | Mức độ bao phủ snippet của mục trả về cao hơn: 99,5% so với 94,4% |
| 3 | Oxylabs | Thu thập Google trong một nền tảng dữ liệu rộng hơn | Nhiều hơn 73 phản hồi sử dụng được và p95 thấp hơn 60,1% trong lần chạy toàn bộ danh sách |
| 4 | SearchAPI.io | Đầu ra Google có cấu trúc và nhiều bề mặt tìm kiếm | p50/p95 quan sát được thấp hơn; 94 so với 88 phản hồi sử dụng được trong tập con 95 truy vấn chung |
| 5 | DataForSEO | Dữ liệu tìm kiếm cùng với các API SEO khác | p95 quan sát được thấp hơn và 94 so với 65 phản hồi sử dụng được trong tập con chung |
| 6 | SerpApi | Các module kết quả Google chi tiết | Độ trễ đuôi quan sát được thấp hơn và một lựa chọn định giá theo ngưỡng khối lượng |
Tất cả các so sánh được đo đều tính đến ngày 13-10-2026. Các lần chạy một phần, lỗi tài khoản và các giới hạn của tập con dùng chung được giải thích bên dưới.
API tìm kiếm Google là gì?
Một API tìm kiếm Google cung cấp cho ứng dụng các quan sát ở dạng máy đọc được từ tìm kiếm Google thay vì yêu cầu ứng dụng phải tự phân tích trang kết quả tìm kiếm.
Đầu ra phổ biến là JSON chứa các danh sách kết quả tự nhiên và các phần kết quả tùy chọn. Tiêu chuẩn định dạng dữ liệu JSON chuẩn hóa cách biểu diễn, nhưng các nhà cung cấp vẫn chọn tên trường, cách lồng dữ liệu và ý nghĩa khác nhau. Cùng dùng một định dạng không khiến hai giao diện có thể thay thế được cho nhau.
Danh mục này cũng cần được tách biệt khỏi các chỉ mục tìm kiếm độc lập và các API câu trả lời nghiên cứu. Nếu sản phẩm của bạn báo cáo khả năng hiển thị trên Google, công cụ nguồn là điều quan trọng. Nếu sản phẩm của bạn tìm tài liệu đọc cho một trợ lý, các hệ thống truy xuất khác cũng có thể hữu ích; khung lựa chọn API tìm kiếm web bao quát quyết định rộng hơn đó.
Các API này phù hợp với ứng dụng như thế nào
Một tích hợp tìm kiếm có ba trách nhiệm: thu thập quan sát, chuẩn hóa nó và quyết định liệu ứng dụng có thể dùng nó hay không.
Hãy giữ phản hồi của nhà cung cấp bên cạnh bản ghi của ứng dụng. Sự tách biệt đó hỗ trợ nguồn gốc dữ liệu: bản ghi vẫn được kết nối với quan sát và phép biến đổi đã tạo ra nó. Bản ghi ứng dụng nên giữ lại truy vấn gốc, quốc gia và ngôn ngữ được yêu cầu, thời điểm thu thập, loại kết quả và bất kỳ URL đích đã xác nhận nào. Các trường tùy chọn nên vẫn là tùy chọn. Một snippet bị thiếu không được âm thầm trở thành một tài liệu trống mà một agent coi là bằng chứng.
Tương tự, hãy tách trạng thái truyền tải khỏi việc chấp nhận nội dung. Tiêu chuẩn ngữ nghĩa HTTP mô tả hành vi giao thức; nó không định nghĩa việc một kết quả có chứa các bản ghi tự nhiên mà tác vụ báo cáo của bạn yêu cầu hay không.
Danh sách rút gọn này được đánh giá như thế nào
Bài kiểm tra sử dụng 800 yêu cầu: 600 truy vấn khác nhau cộng với 200 truy vấn lặp lại, được chia đều giữa các nhóm truy vấn dạng thông tin, thương mại, thương hiệu, ý định địa phương và truy vấn dài. Mục tiêu của bài kiểm tra là tìm kiếm web Google tiếng Anh (Mỹ). Các nhà cung cấp chạy vào những thời điểm khác nhau và dưới các ràng buộc về tài khoản và tham số riêng; bộ nhớ đệm không bị vô hiệu hóa một cách đồng nhất.
Bằng chứng Đầy đủ Danh sách: Scrapeless, Oxylabs và Serper
Ba nhà cung cấp này đã hoàn thành toàn bộ danh sách yêu cầu. Giữ cả ba cùng hiển thị giúp ngăn một phép so sánh thuận lợi bị hiểu thành khẳng định rằng Scrapeless thắng ở mọi chỉ số.
| Quan sát tháng Mười | Scrapeless | Oxylabs | Serper |
|---|---|---|---|
| Yêu cầu được gửi | 800 | 800 | 800 |
| Phản hồi sử dụng được | 786 | 713 | 800 |
| Tỷ lệ phản hồi sử dụng được | 98.25% | 89.125% | 100% |
| p50 yêu cầu sử dụng được | 1.94 s | 4.51 s | 1.52 s |
| p95 yêu cầu sử dụng được | 3.64 s | 9.13 s | 2.75 s |
| Mức độ bao phủ snippet trong các mục được trả về | 99.5% | 100% | 94.4% |
| Lỗi ghi nhận | 14 HTTP 400 | 82 trạng thái nội bộ 613; 5 lỗi mạng | 0 |
Lợi thế của Scrapeless so với Oxylabs là cụ thể: 73 phản hồi sử dụng được bổ sung, tỷ lệ sử dụng được cao hơn 9.125 điểm phần trăm, và p95 thấp hơn 60.1%. Lợi thế của nó so với Serper thì khác: cao hơn 5.1 điểm phần trăm về mức độ bao phủ snippet trong số các mục được trả về. Sự hiện diện snippet không đồng nghĩa với độ chính xác, và các nhà cung cấp này trả về những tập và số lượng mục organic khác nhau.
“Có thể sử dụng được” yêu cầu một phản hồi HTTP thành công, không có lỗi nghiệp vụ đã nhận diện, và ít nhất một kết quả organic. Độ trễ chỉ tính trên các yêu cầu có thể sử dụng được và loại trừ thời gian chờ trước khi gửi. Lỗi của Oxylabs là một phần của lần chạy này, không phải là chẩn đoán cho dịch vụ bình thường của họ. Oxylabs Web API hiện tại không được kiểm tra riêng trong bài này.
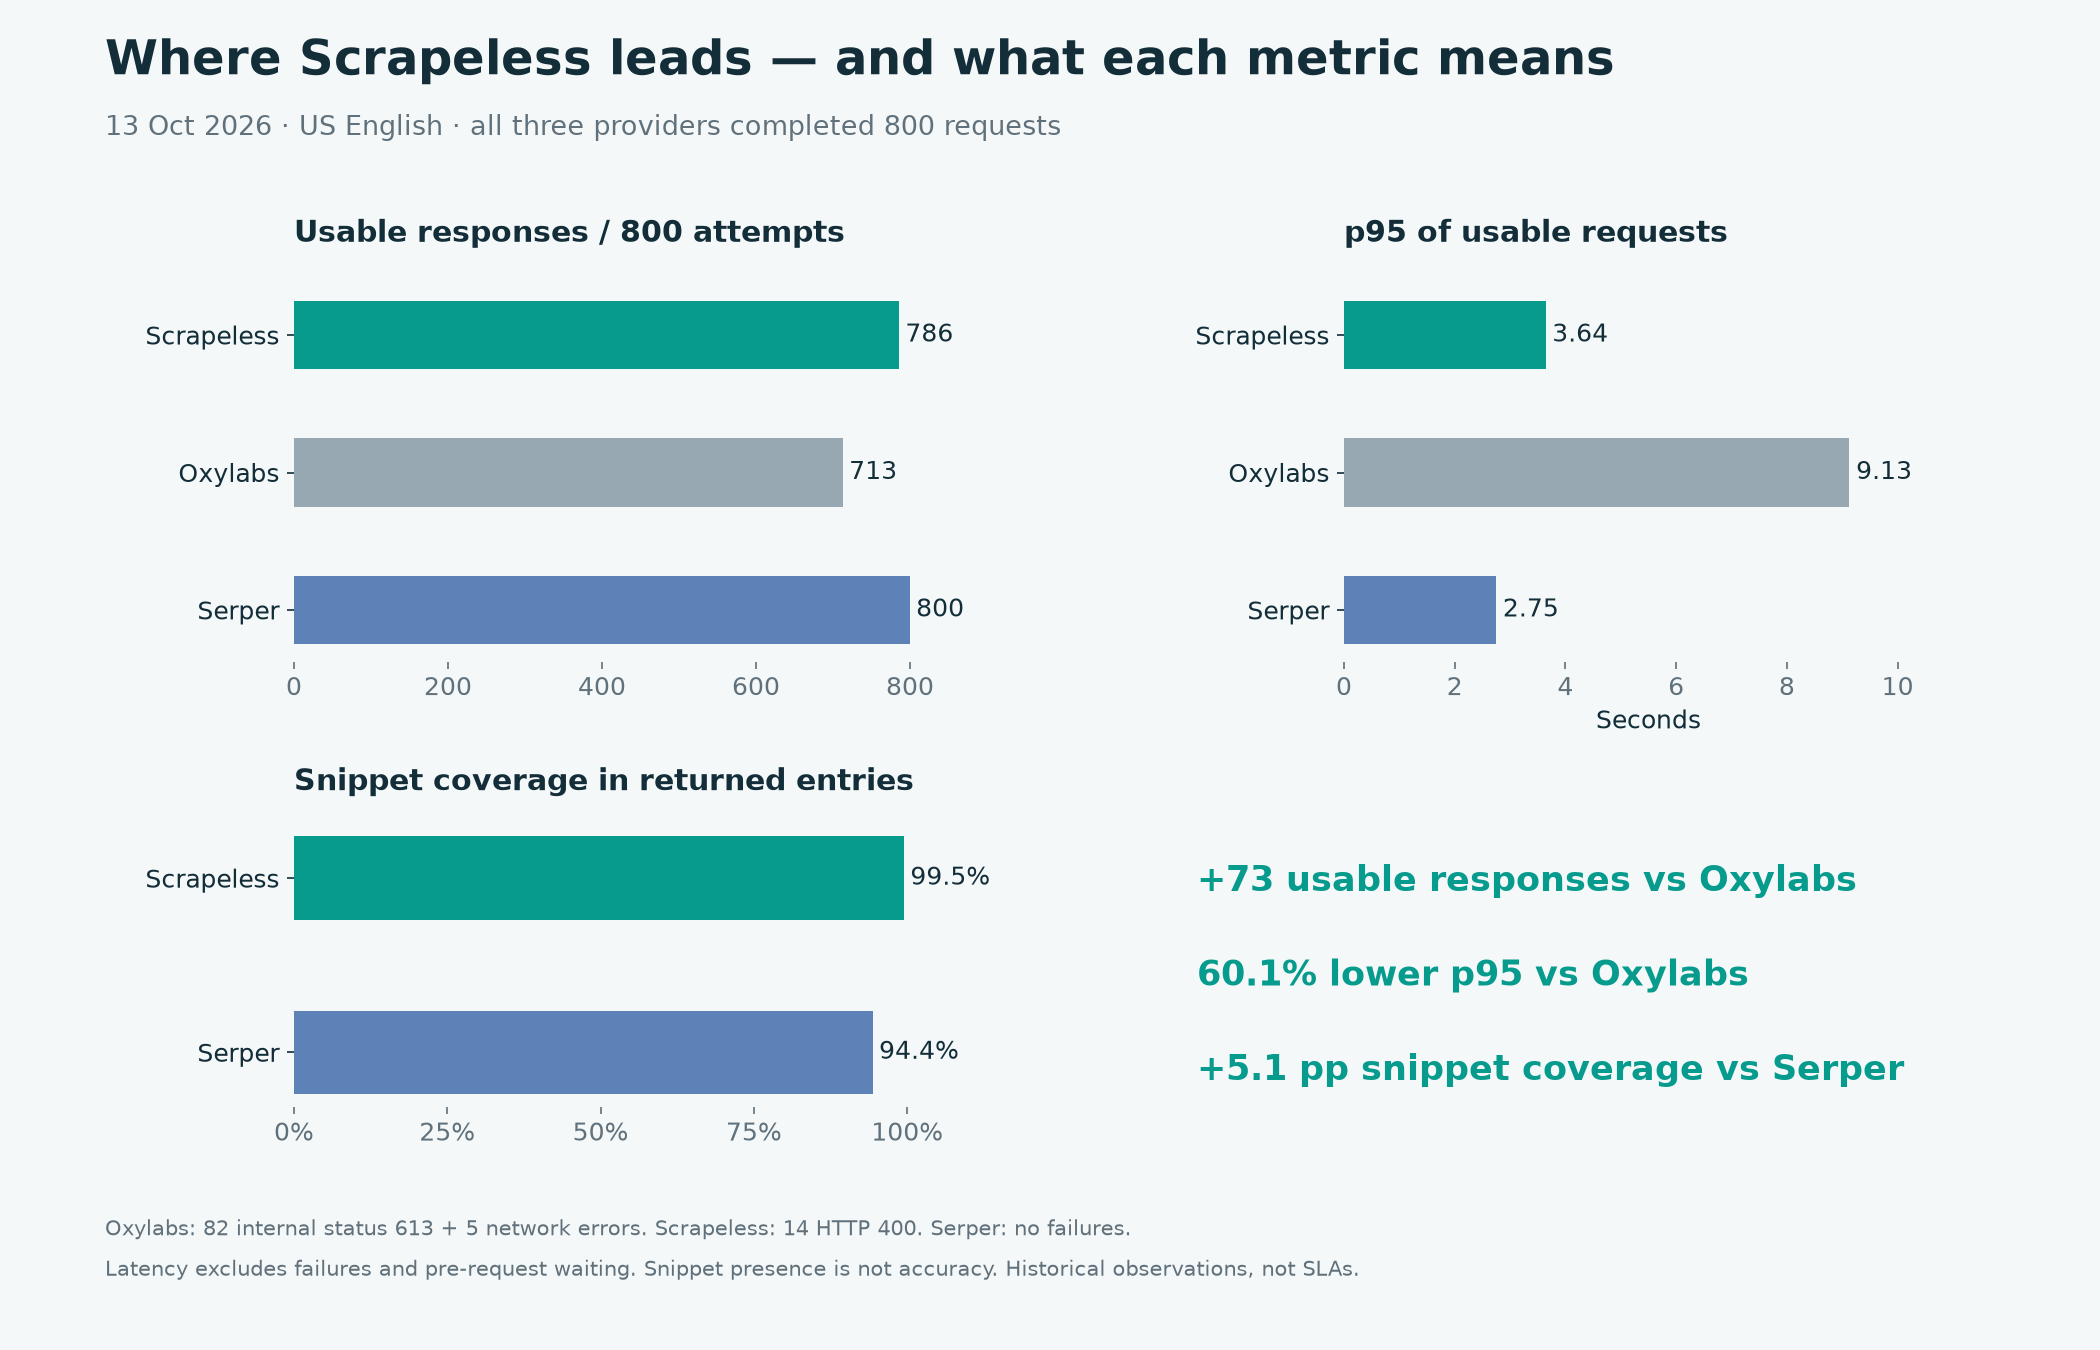
Hình 1. Các quan sát lịch sử trên tiếng Anh (Mỹ), với cả ba nhà cung cấp 800 yêu cầu được hiển thị. Thời gian loại trừ các yêu cầu thất bại; mức độ bao phủ snippet sử dụng các mục organic được trả về làm mẫu số. Nguồn: benchmark ngày 13-10-2026.
Các Lần Chạy Một Phần: Tín hiệu Hữu ích với Phạm vi Nhỏ hơn
SearchAPI.io hoàn thành 105 yêu cầu, DataForSEO 795, và SerpApi 200. Phân bố độ trễ của các lần chạy đầy đủ mô tả chính các mẫu hoàn thành của họ. Chúng là các tín hiệu thử nghiệm hữu ích, không tương đương với các đợt 800 yêu cầu. Một tập con chung Q0001–Q0095 cung cấp mẫu số truy vấn chung cho số lượng có thể sử dụng được: Scrapeless 94, SearchAPI.io 88, DataForSEO 65, và SerpApi 94. Nó không loại bỏ khác biệt về thời điểm, tài khoản, hay cấu hình, và không có kết quả độ trễ nào trên tập con được đưa ra.
1. Scrapeless: Tốt nhất để Xây dựng Sản phẩm Dữ liệu Tìm kiếm Google
Scrapeless Google Search API là lựa chọn hàng đầu trong danh sách rút gọn này cho các nhóm muốn có dữ liệu Google có cấu trúc và một lộ trình rõ ràng để đi vào các quy trình làm việc dữ liệu tìm kiếm định kỳ.
Kết quả tháng Mười mang lại cơ sở cho khuyến nghị: 786 phản hồi sử dụng được, median dưới hai giây, và p95 3.64 giây trong tập các yêu cầu sử dụng được. Lợi ích thực tế là một đường cơ sở cụ thể để so sánh quy mô cho một pilot ban đầu, thay vì một tuyên bố tốc độ trên trang chủ được dùng thay cho phép đo.
Thành phần truy vấn vẫn quan trọng. Scrapeless trả về 160/160 lượt tìm kiếm thương hiệu sử dụng được, 159/160 truy vấn thông tin, 159/160 truy vấn thương mại, 158/160 truy vấn ý định địa phương, và 150/160 truy vấn dài. Do đó, một trợ lý có tỷ lệ truy vấn dài cao nên sử dụng phân bố truy vấn riêng của mình khi đặt mục tiêu chấp nhận.
Giao diện mang lại gì cho Nhà phát triển
Mô hình yêu cầu Google Search nhận truy vấn tìm kiếm bên trong một đối tượng input, với quốc gia, ngôn ngữ và các điều khiển khác. Luồng phản hồi được tài liệu hóa phân biệt kết quả tức thời với tác vụ vẫn đang được xử lý. Client của bạn phải giữ nguyên sự phân biệt này trước khi cố đọc các kết quả organic.
Cho lần tích hợp đầu tiên, hãy dùng yêu cầu được tạo từ dashboard cho một truy vấn thông thường. Xác nhận rằng tập kết quả organic của nó có mặt, kiểm tra một tiêu đề và snippet, và giữ lại phản hồi. Sau đó chạy một truy vấn thứ hai giống với phía khó hơn trong lưu lượng ứng dụng của bạn. Bước kiểm tra nhỏ này xác nhận các giả định phía tiêu thụ trước khi bạn xây dựng một bộ lập lịch xoay quanh chúng.
Không cần SDK lớn hoặc framework agent để đánh giá giao diện HTTP. Tạo phẩm quan trọng là một yêu cầu và phản hồi đã được lưu mà ứng dụng của bạn có thể giải thích.
Nơi mà Bằng chứng tháng Mười Cần được Diễn giải Thận trọng
Các bản ghi organic của Scrapeless được trả về có mức độ bao phủ trường đoạn trích là 99,5%, nhưng chỉ 0,7% chứa URL đích trực tiếp trong mẫu đó; hầu hết các liên kết là URL trung gian của Google. Mức độ bao phủ đoạn trích đo lường sự hiện diện, không phải tính đúng đắn. Đoạn trích kết quả tìm kiếm của Google là các bản xem trước nội dung trang phụ thuộc truy vấn, vì vậy cùng một điểm đến có thể mang văn bản mô tả khác nhau cho các tìm kiếm khác nhau. Một trường liên kết được điền không chứng minh rằng hostname của nó xác định nhà xuất bản đích.
Hãy coi việc phân giải điểm đến là một yêu cầu chấp nhận cho giám sát khả năng hiển thị SEO. Giữ nguyên liên kết gốc, xác nhận điểm đến cuối cùng thông qua một đường dẫn truy xuất được hỗ trợ và loại các bản ghi chưa được phân giải khỏi các so sánh ở cấp độ domain. Phát hiện URL mang tính lịch sử đó cần được kiểm tra lại so với các phản hồi hiện tại trước khi triển khai.
Scrapeless đặc biệt hấp dẫn khi nhóm muốn một lớp thu thập tìm kiếm phục vụ nhiều đối tượng tiêu dùng: một bảng điều khiển phân tích, một công cụ khám phá nguồn và một tác vụ nghiên cứu định kỳ. Bộ sưu tập giải pháp Google Search cung cấp các định nghĩa khối lượng công việc hữu ích mà không biến các quy trình làm việc đó thành các tính năng ứng dụng tích hợp được giả định sẵn.
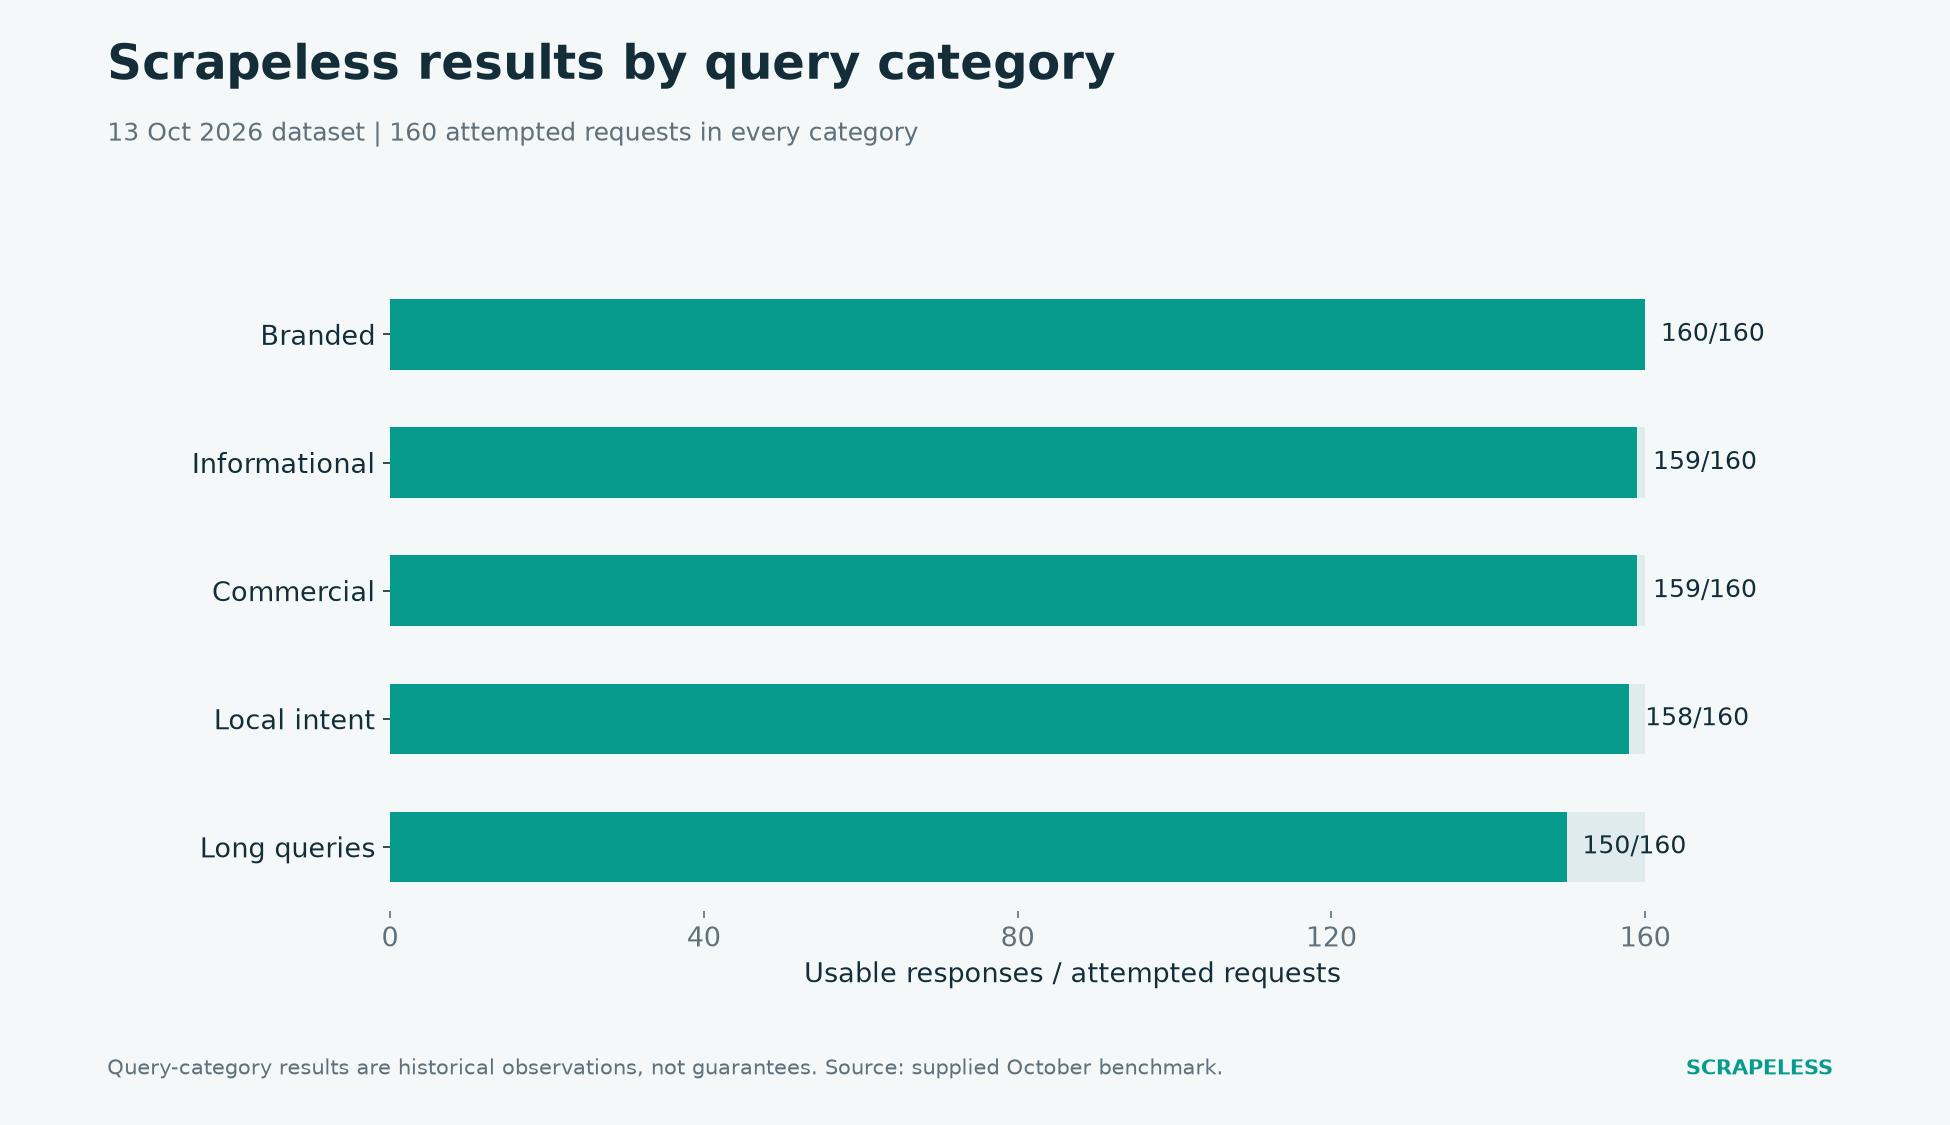
Hình 2. Các phản hồi có thể sử dụng được của Scrapeless trên tổng số 160 yêu cầu trong mỗi nhóm truy vấn. Nguồn: benchmark ngày 13-10-2026; trục bắt đầu từ 0.
2. Serper: Tốt nhất cho Tìm kiếm Google Tập trung với Hình thức Trả trước
Serper cung cấp một giao diện Google Search gọn nhẹ. Gói Starter có giá 50 đô la cho 50.000 credit với thời hạn sáu tháng, tương đương 1 đô la cho mỗi 1.000 credit đã mua nếu sử dụng hết. Độ sâu truy vấn và mức tiêu thụ credit vẫn cần được kiểm tra đối với yêu cầu đã chọn.
Lợi thế của Scrapeless: Đoạn Trích Được Điền Đầy Đủ Hơn
Scrapeless ghi nhận mức độ bao phủ đoạn trích 99,5% so với 94,4% của Serper, tức dẫn trước 5,1 điểm phần trăm trong các kết quả organic được trả về. Một bộ phân loại hoặc giao diện khám phá nội dung sàng lọc tiêu đề và đoạn trích sẽ có văn bản được điền đầy đủ nhất quán hơn để làm việc theo chỉ số này. Đó là lợi thế phù hợp của Scrapeless khi bên sử dụng cần mô tả, không chỉ URL.
Serper trả về 800/800 phản hồi có thể sử dụng với p50/p95 lần lượt là 1,52/2,75 giây, vượt Scrapeless theo các số liệu đó. Mức độ bao phủ URL trực tiếp của nó cũng mạnh hơn. Hãy chọn Scrapeless cho quy trình làm việc định hướng đoạn trích sau khi đã xác thực điểm đến; đừng chuyển lợi thế về mức độ bao phủ trường thành tuyên bố về tốc độ thu thập nhanh hơn hoặc mức độ liên quan tốt hơn.
Đối với đánh giá thương mại, Scrapeless cung cấp mức giá khối lượng cho doanh nghiệp đủ điều kiện dưới 0,50 đô la cho mỗi 1.000 lượt tìm kiếm. Điều đó tạo ra mức giá niêm yết thấp hơn so với mức credit Starter của Serper, nhưng nó so sánh các cam kết khác nhau. Serper cũng giảm giá cho các gói lớn hơn. Hãy yêu cầu các điều khoản tương ứng về khối lượng trước khi khẳng định mức tiết kiệm.
3. Oxylabs: Tốt nhất cho Thu thập Google trong một Nền tảng Dữ liệu Rộng hơn
Oxylabs cung cấp khả năng thu thập dữ liệu Google thông qua Web API của họ. Đây là một ứng viên hợp lý khi một nhóm đã và đang hợp nhất nhiều khối lượng công việc trích xuất dưới cùng nhà cung cấp đó.
Lợi thế của Scrapeless: Nhiều Kết quả Có thể Sử dụng Hơn với Độ Trễ Thấp Hơn
Trên toàn bộ danh sách tháng 10, Scrapeless trả về 786/800 phản hồi có thể sử dụng so với 713/800 của giao diện Oxylabs được thử nghiệm. p50 1,94 giây của nó thấp hơn 57,0% so với 4,51 giây, và p95 3,64 giây thấp hơn 60,1% so với 9,13 giây. Đây là lập luận rõ ràng nhất theo tiêu chí số lượng yêu cầu bằng nhau để chọn Scrapeless cho thu thập Google dựa trên bằng chứng hiện có.
Giá trị nằm ở khía cạnh vận hành: nhiều lượt tìm kiếm hơn tạo ra kết quả organic, và đường dẫn thành công dành ít thời gian hơn để chờ các phản hồi chậm hơn. Đối với một tác vụ báo cáo, đó là lý do mạnh hơn để thử nghiệm Scrapeless so với quy mô danh mục sản phẩm của bất kỳ nhà cung cấp nào.
Lần chạy Oxylabs bao gồm 82 phản hồi trạng thái nội bộ 613 và năm lỗi mạng; Scrapeless có 14 phản hồi HTTP 400. Các điều kiện đó phải được giữ nguyên trong so sánh. Hãy coi kết quả là một lợi thế mang tính lịch sử dưới cấu hình đã thử nghiệm, sau đó xác thực các endpoint hiện tại trước khi cam kết lưu lượng sản xuất.
Bắt đầu Scraping với Scrapeless
Tăng tốc quy trình web scraping và tự động hóa của bạn với Scrapeless!
Đăng ký hôm nay và nhận 5 đô la credit miễn phí — không cần thẻ tín dụng.
Nhận ngay khoản tín dụng miễn phí của bạn trong Bảng điều khiển Scrapeless.
4. SearchAPI.io: Tốt nhất cho các nhóm so sánh nhiều bề mặt tìm kiếm của Google
SearchAPI.io cung cấp đầu ra tìm kiếm Google có cấu trúc và các endpoint tìm kiếm liên quan. Hãy đánh giá chính xác bề mặt Google mà ứng dụng của bạn tiêu thụ; một bộ chuyển đổi kết quả tự nhiên (organic) không xác nhận mọi mô-đun kết quả chuyên biệt.
Lợi thế của Scrapeless: Đường đi tìm kiếm được quan sát nhanh hơn
Trong tháng 10, p50/p95 cho yêu cầu sử dụng được của Scrapeless là 1,94/3,64 giây, so với 6,33/34,87 giây cho mẫu hoàn tất của SearchAPI.io. Đó là một lý do mạnh mẽ để đưa Scrapeless vào một thử nghiệm khám phá nhạy cảm về độ trễ. Đây là các lượt chạy có kích thước khác nhau: 800 yêu cầu cho Scrapeless và 105 cho SearchAPI.io, bao gồm bảy phản hồi HTTP 503 cho bên sau.
Tập con 95 truy vấn chung cung cấp một so sánh thứ hai, hẹp hơn: 94 phản hồi sử dụng được cho Scrapeless so với 88 cho SearchAPI.io. Điều này hỗ trợ cho trường hợp thu thập mà không giả vờ rằng mẫu số của toàn bộ lượt chạy là trùng khớp.
Đối với một nhà phát triển, bước tiếp theo là áp dụng cùng một hợp đồng phản hồi và lịch truy vấn cho cả hai dịch vụ hiện tại. Giữ độ bao phủ trường, phân giải đích đến và độ trễ như các thước đo chấp nhận riêng biệt. Bằng chứng lịch sử ủng hộ Scrapeless trên các chiều thu thập đã nêu, chứ không phải trên mọi tính năng mà SearchAPI.io bán.
5. DataForSEO: Tốt nhất cho các nhóm mua một stack dữ liệu SEO rộng hơn
DataForSEO kết hợp thu thập SERP với một bộ API dữ liệu SEO rộng hơn. Điều đó có thể quan trọng khi kết quả tìm kiếm chỉ là một đầu vào cho một ứng dụng SEO hiện có.
Lợi thế của Scrapeless: Truy xuất nhanh hơn được quan sát cho lớp tìm kiếm
Đối với khối lượng công việc Google tháng 10, p95 3,64 giây cho yêu cầu sử dụng được của Scrapeless thấp hơn 13,51 giây ghi nhận cho DataForSEO Live. Tập con 95 truy vấn chung tạo ra 94 phản hồi sử dụng được với Scrapeless so với 65 với DataForSEO. Đây là các lý do cụ thể để ưu tiên Scrapeless khi yêu cầu trước mắt là khám phá tìm kiếm đáng tin cậy cho một công cụ tương tác.
Lượt chạy chính của DataForSEO gửi 795 yêu cầu và thu được 667 kết quả sử dụng được, với 128 phản hồi task-status 40101 trên hai nhóm thông tin xác thực. Các chế độ hàng đợi của họ chưa được kiểm thử. Kết quả không nên được khái quát hóa thành một phán quyết cho mọi chế độ DataForSEO hoặc mọi tài khoản hiện tại.
Hãy dùng Scrapeless khi lợi thế tập trung ở lớp tìm kiếm này phù hợp với sản phẩm. Giữ một nhà cung cấp riêng cho các bộ dữ liệu SEO khác nếu các bộ dữ liệu đó xứng đáng; việc thay đổi bộ thu thập tìm kiếm không nhất thiết buộc phải viết lại toàn bộ ứng dụng.
6. SerpApi: Tốt nhất cho các bên tiêu thụ các mô-đun kết quả Google chi tiết
SerpApi ghi chép nhiều mô-đun kết quả Google. Nó xứng đáng được xem xét khi ứng dụng của bạn đã phụ thuộc vào những cấu trúc cụ thể đó thay vì chỉ một danh sách kết quả tự nhiên (organic).
Lợi thế của Scrapeless: Cơ hội về tail-latency và chi phí theo khối lượng
Scrapeless ghi nhận p95 3,64 giây, so với 26,81 giây trong mẫu tháng 10 của SerpApi. Kích thước mẫu lần lượt là 800 và 200, và median 1,32 giây của SerpApi thấp hơn 1,94 giây của Scrapeless. Tín hiệu thuận lợi cho Scrapeless nằm ở phần đuôi được quan sát, chứ không phải là tuyên bố rằng mọi yêu cầu đều nhanh hơn.
Gói Starter của SerpApi là 25 đô la mỗi tháng cho 1.000 lượt tìm kiếm. Mức giá doanh nghiệp đủ điều kiện của Scrapeless dưới 0,50 đô la cho mỗi 1.000 lượt tìm kiếm là một lý do để một bên mua khối lượng lớn chỉ dùng Google yêu cầu báo giá. Đây không phải là so sánh giống-hệt giữa các gói Starter, cũng không phải hóa đơn tổng, hay khoản tiết kiệm đã đo lường; mức cam kết tối thiểu, tính năng và định nghĩa thanh toán vẫn rất quan trọng.
Đối với một sản phẩm tìm kiếm tự nhiên không tiêu thụ một danh mục lớn các mô-đun chuyên biệt, hãy chọn một thử nghiệm xoay quanh các trường tìm kiếm và ngân sách độ trễ mà bạn thực sự cần. Scrapeless là ứng viên đầu tiên ở đây vì các yêu cầu đó phù hợp với đường cơ sở đo lường của nó và đề xuất giá theo khối lượng.
Tiêu chí ra quyết định so sánh song song
| Ràng buộc chính của bạn | Tại sao nên bắt đầu với Scrapeless? | Điều mà thử nghiệm phải xác nhận |
|---|---|---|
| Phản hồi thành công chậm hơn trong một job dựa trên Oxylabs | p95 thấp hơn 60,1% trong quan sát toàn danh sách | Endpoint hiện tại, tài khoản và tổ hợp truy vấn |
| Thiếu văn bản mô tả trong một bên tiêu thụ dựa trên Serper | Độ bao phủ snippet 99,5% so với 94,4% | Sự hiện diện văn bản, mức độ liên quan và đích đến đã xác thực |
| Khám phá tương tác dùng SearchAPI.io hoặc DataForSEO | p95 toàn lượt chạy quan sát được thấp hơn; số phản hồi sử dụng được trong tập con chung thuận lợi | Các giới hạn hiện tại và cửa sổ thu thập có thể so sánh |
| Chi phí SerpApi cho một sản phẩm chỉ dùng Google | Giá cho khối lượng đủ điều kiện và p95 quan sát thấp hơn | Báo giá khối lượng phù hợp và các mô-đun kết quả bắt buộc |
| Nhiều bên tiêu thụ đọc cùng một quan sát Google | Bản ghi tìm kiếm có thể cấp dữ liệu cho các giai đoạn SEO và nghiên cứu riêng biệt | Schema rõ ràng và các quy tắc chấp nhận tách bạch |
| Khuyến nghị này bám theo nút thắt cổ chai của người dùng cuối. Không có một chỉ số đơn lẻ nào xác định được nhà cung cấp tốt nhất cho mọi loại khối lượng công việc. |
Cách Chọn API Mà Không Hiểu Sai Các Con Số
Một pilot tốt đo lường bản ghi ứng dụng thực sự đến được với người dùng cuối.
Bắt đầu với các nhóm truy vấn mang tính đại diện và lặp lại chúng trong nhiều khoảng thời gian thu thập. Đếm mọi yêu cầu đã cố gắng gửi. Ghi lại lỗi nghiệp vụ tách biệt với phản hồi hợp lệ nhưng không có kết quả tự nhiên. Theo dõi phân bố độ trễ của các yêu cầu sử dụng được, đồng thời giữ các kết quả thất bại hiển thị bên cạnh.
Sau đó đo lường danh tính đích đến. Các quy tắc chuẩn hoá URI cung cấp điểm khởi đầu để so sánh URL, nhưng một chính sách đối sánh trong môi trường sản xuất còn phải quyết định cách xử lý tham số theo dõi, chuyển hướng và các trang tương đương. Giữ nguyên giá trị thô để có thể điều tra nếu sau này thay đổi quy tắc chuẩn hoá.
Cuối cùng, đánh giá gói giá Scrapeless áp dụng được hoặc gói của đối thủ so với toàn bộ công việc. Yêu cầu tìm kiếm, các trang kết quả bổ sung, truy xuất đích đến và lưu trữ là những thành phần chi phí khác nhau. Bản đo hiệu năng tháng Mười không chứa các hoá đơn cuối cùng có thể so sánh được cho mọi nhà cung cấp, nên không thể dùng để xếp hạng chi phí một cách đo lường.
Cho một so sánh thương mại tập trung, trang Scrapeless và Serper alternative là một nguồn tham khảo mua hàng riêng. Giữ cho các tuyên bố sản phẩm được công bố ở đó tách biệt với các đo lường tháng Mười phía trên.
Tại Sao Dữ Liệu Google Search Cần Những Kiểm Tra Này
Các trang tìm kiếm thay đổi theo ngữ cảnh truy vấn, thời gian và thành phần kết quả, nên việc thu thập JSON không loại bỏ nhu cầu diễn giải.
Theo dõi thứ hạng cần một thị trường đã biết và một đích đến đã được xác nhận. Nghiên cứu nội dung cần tiêu đề và đoạn trích hữu ích, sau đó đọc trang khi một tuyên bố phụ thuộc vào chi tiết. Giám sát thương hiệu cần một quy tắc để phân biệt trang web của chính thương hiệu với các trang chỉ nhắc đến nó. Những người dùng này có thể dùng chung một bộ thu thập trong khi vẫn duy trì các quy tắc chấp nhận khác nhau.
Kết Luận
Scrapeless là ứng viên triển khai đầu tiên mạnh mẽ cho một sản phẩm dữ liệu tìm kiếm Google, được hỗ trợ bởi mốc cơ bản 800 yêu cầu rõ ràng và một con đường thực tiễn để đi vào các quy trình công việc tìm kiếm định kỳ. Bằng chứng so sánh mạnh nhất là nhiều hơn 73 phản hồi sử dụng được và p95 thấp hơn 60,1% so với Oxylabs trong lần chạy danh sách đầy đủ, cùng với mức độ bao phủ đoạn trích cao hơn Serper. Các nhà cung cấp khác giúp đo chuẩn các yêu cầu chuyên biệt và nỗ lực chuyển đổi.
Chọn cặp phù hợp với ứng dụng của bạn, chạy cùng các nhóm truy vấn qua cả hai, và so sánh các bản ghi mà người dùng của bạn thực sự sẽ sử dụng.
Sẵn Sàng Xây Dựng Pipeline Dữ Liệu Tìm Kiếm Của Bạn?
Tham gia cùng các lập trình viên đang xây dựng quy trình tìm kiếm trên Discord và Telegram.
Bắt đầu tại app.scrapeless.com với một tập truy vấn đã xác định, các trường bắt buộc và một quy tắc xác thực đích đến.
Câu Hỏi Thường Gặp
Hỏi: API Google Search nào tốt nhất cho lập trình viên?
Scrapeless là khuyến nghị đầu tiên cho các quy trình công việc dữ liệu Google có cấu trúc. Các lợi thế của nó bao gồm số lượng phản hồi sử dụng được cao hơn và độ trễ thấp hơn Oxylabs trong bài kiểm tra danh sách đầy đủ, và mức độ bao phủ đoạn trích cao hơn Serper. Hãy xác thực giao diện hiện tại so với các trường bạn yêu cầu.
Hỏi: API nhanh nhất có tự động là lựa chọn tốt nhất không?
Không. Độ trễ phải được đánh giá cùng với các phản hồi sử dụng được, danh tính đích đến, các trường bắt buộc và tổng chi phí quy trình công việc. Một kết quả nhanh nhưng không thể đối sánh với nhà xuất bản chính xác có thể không phù hợp cho một sản phẩm xếp hạng.
Hỏi: API Google Search có trả về toàn bộ nội dung trang web không?
Một phản hồi SERP thông thường chứa thông tin kết quả tìm kiếm, không nhất thiết là toàn bộ nội dung của từng đích đến. Truy xuất trang là một khả năng riêng và cần được đánh giá riêng. Universal Scraping API của Scrapeless cung cấp một đường dẫn truy xuất trang công khai riêng cho các ứng dụng cần đọc các nguồn đã chọn.
Hỏi: Một yêu cầu có thể đảm bảo 100 kết quả tự nhiên không?
Không. Độ sâu được yêu cầu, hỗ trợ phân trang và số lượng kết quả thực sự được trả về là những vấn đề riêng biệt. Hãy xác thực endpoint hiện tại và đo lường các đích đến duy nhất thay vì giả định rằng một số lượng yêu cầu là được đảm bảo.
Hỏi: Cả sáu API có được đo hiệu năng cùng nhau không?
Không. Scrapeless, Serper và Oxylabs đã hoàn thành 800 yêu cầu. DataForSEO hoàn thành 795, SerpApi 200 và SearchAPI.io 105. Tập con 95 truy vấn dùng chung chỉ được sử dụng cho số lượng kết quả sử dụng được; các so sánh về độ trễ giữ nguyên kích thước mẫu ban đầu của chúng.
Tại Scrapless, chúng tôi chỉ truy cập dữ liệu có sẵn công khai trong khi tuân thủ nghiêm ngặt các luật, quy định và chính sách bảo mật trang web hiện hành. Nội dung trong blog này chỉ nhằm mục đích trình diễn và không liên quan đến bất kỳ hoạt động bất hợp pháp hoặc vi phạm nào. Chúng tôi không đảm bảo và từ chối mọi trách nhiệm đối với việc sử dụng thông tin từ blog này hoặc các liên kết của bên thứ ba. Trước khi tham gia vào bất kỳ hoạt động cạo nào, hãy tham khảo ý kiến cố vấn pháp lý của bạn và xem xét các điều khoản dịch vụ của trang web mục tiêu hoặc có được các quyền cần thiết.





