
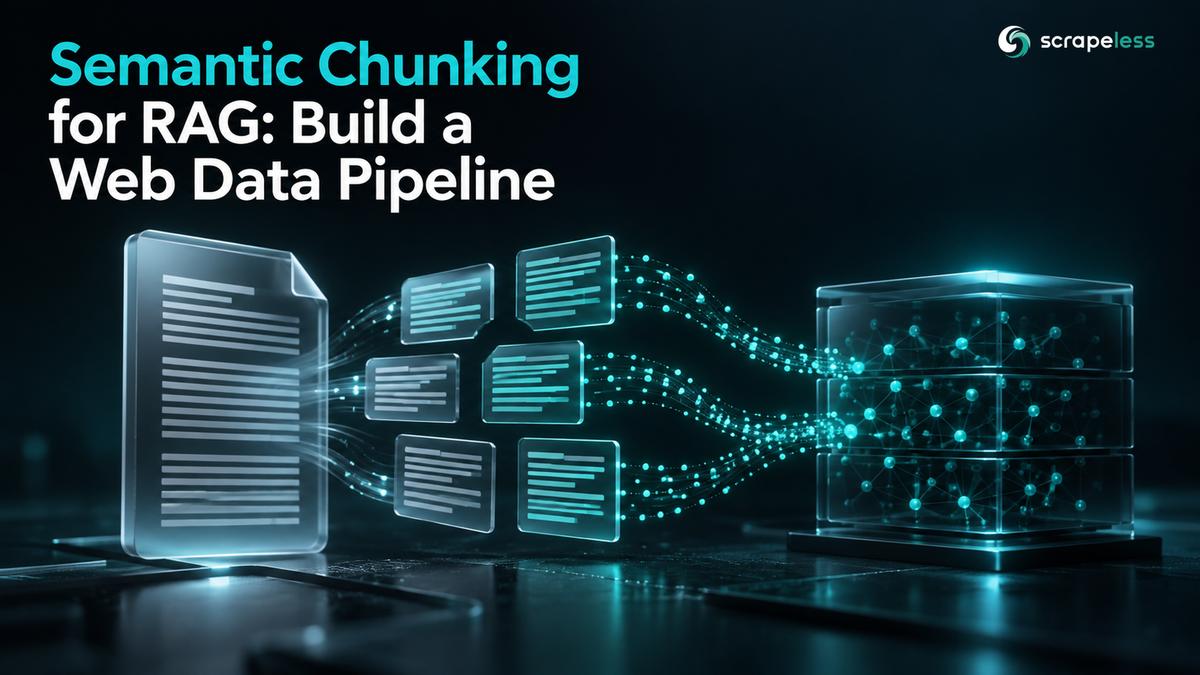
संविधानात्मक टुकड़े के लिए RAG: एक वेब डेटा पाइपलाइन बनाएं
Advanced Data Extraction Specialist
TL;DR:
- Semantic chunking अर्थ में बदलावों का उपयोग करके पाठ को समूहित करता है। इसे एक परिभाषित विभाजन विधि, एक एम्बेडिंग मॉडल, और यह तय करने के लिए एक नियम की आवश्यकता होती है कि एक टुकड़ा कहाँ समाप्त होता है।
- स्वच्छ स्रोत पाठ पुनर्प्राप्ति गुणवत्ता का एक भाग है। नेविगेशन मेनू और दोहराए जाने वाले बैनर टुकड़ों को विकृत कर सकते हैं इससे पहले कि पुनर्प्राप्तकर्ता उन्हें देखे।
- हर टुकड़ा अपनी स्रोत और स्थिति को बनाए रखनी चाहिए। उत्पत्ति एक पुनर्प्राप्त किए गए अंश को उद्धरणों और निदान के लिए उपयोगी बनाती है।
- एक सेमान्टिक स्प्लिटर को एक मूलभूत तुलना की आवश्यकता होती है। अतिरिक्त एम्बेडिंग कार्य बेहतर उत्तरों की गारंटी नहीं देता है बनाम एक सरल विभाजन रणनीति।
- शुरू करने के लिए स्वतंत्र। छोटे अनुमोदित दस्तावेज़ सेट पर अपस्ट्रीम संग्रहण चरण का मूल्यांकन करने के लिए Scrapeless खाता क्रेडिट का उपयोग करें।
परिचय: पुनर्प्राप्ति वेक्टर स्टोर से पहले शुरू होती है
एक पुनर्प्राप्तकर्ता केवल अपने अनुक्रमणिका में संग्रहीत अंशों को ही वापस कर सकता है। पुनर्प्राप्ति-समर्थित पीढ़ी में, पुनर्प्राप्त तीनिफ़ी साक्ष्य पीढ़ी इनपुट का एक भाग बनाता है। यदि एक अंश में आधा स्पष्टीकरण है, या एक नीति कथन को असंबंधित नेविगेशन टेक्स्ट के साथ संयोजित करता है, तो उत्तर जनरेटर संदर्भ में अधूरा होगा, भले ही समानता स्कोर मजबूत दिखाई दे।
सेमान्टिक चंकींग उन अंशों की शुरुआत और अंत को बदलता है। निश्चित लम्बाई पर केवल कटने के बजाय, स्प्लिटर पड़ोसी वाक्य प्रदर्शनों की तुलना करता है और एक सीमा बनाता है जब उनके अर्थ पर्याप्त भिन्न होते हैं। एक आकार सीमा अब भी मायने रखती है क्योंकि एक सुसंगत विषय डाउनस्ट्रीम मॉडल द्वारा स्वीकार किए जाने से लंबा हो सकता है।
यह लेख Scrapeless को अधिग्रहण परत के रूप में और एक पारदर्शी पायथन स्प्लिटर को रूपांतरण परत के रूप में एक वेब-से-RAG पाइपलाइन का वर्णन करता है। यह भाषा मॉडल के साथ संरचित निष्कर्षण को पूरा करता है: निष्कर्षण कार्य फ़ील्ड का उत्पादन करता है, जबकि टुकड़ी अंशों को बाद की पुनर्प्राप्ति के लिए तैयार करता है।
सेमान्टिक चंकींग क्या करता है
सेमान्टिक चंकींग अर्थ का एक प्रतिनिधित्व का उपयोग करके पाठ सीमाओं का चयन करता है। एक सामान्य कार्यान्वयन एक दस्तावेज़ को वाक्यों में विभाजित करता है, उन वाक्यों को एम्बेड करता है, आसन्न वेक्टरों की तुलना करता है, और पर्याप्त बड़े परिवर्तन पर एक नई समूह शुरू करता है।
वाक्य एम्बेडिंग विधियाँ वाक्य पाठ को वेक्टर में मानचित्रित करती हैं जिनकी समानता की तुलना की जा सकती है। समानता स्कोर का अर्थ मॉडल और इनपुट पर निर्भर करता है, इसलिए एक संख्यात्मक सीमा सेटिंग एक पैरामीटर है जिसे मूल्यांकन करना है बजाय एक सार्वभौमिक विषय परिवर्तन की परिभाषा के।
| रणनीति | सीमा नियम | उपयोगी प्रारंभिक बिंदु | मुख्य व्यापार-बंद |
|---|---|---|---|
| निश्चित आकार | एक कॉन्फ़िगर की गई लंबाई | एक सरल बेसलाइन | स्पष्टीकरण को काट सकता है |
| संरचना-सचेत | शीर्षक और अनुच्छेद ब्रेक | संगठित संदर्भ पृष्ठ | स्वच्छ दस्तावेज़ संरचना पर निर्भर करता है |
| सेमान्टिक | एम्बेडिंग की समानता में परिवर्तन | विषय परिवर्तनों के साथ पाठ | मॉडल की गणना और समायोजन जोड़ता है |
| हाइब्रिड | संरचना, सेमान्टिक चेक और सीमाएँ | मिश्रित दस्तावेज़ संग्रह | मूल्यांकन के लिए अधिक कॉन्फ़िगरेशन |
शीर्षक, तालिकाएँ, कोड ब्लॉक, और सूचियों को विशेष उपचार की आवश्यकता होती है। एक वाक्य स्प्लिटर एक तालिका को उसके स्तंभ लेबल से एक मान को अलग करके नुकसान पहुँचा सकता है। इन इकाइयों को पूर्वप्रसंस्करण के दौरान संरक्षित करें या उन्हें संरचना-सचेत पथ पर रूट करें।
पाइपलाइन एक नज़र में
पाइपलाइन एक कैप्चर की गई वेब दस्तावेज़ को अनुक्रमित अंशों में परिवर्तित करती है जो अपनी उत्पत्ति बनाए रखते हैं। इसके चरण हैं अधिग्रहण → पाठ सामान्यीकरण → वाक्य विभाजन → एम्बेडिंग → टुकड़ा निर्माण → पुनर्प्राप्ति मूल्यांकन।
Scrapeless वेब अनलॉकर लक्ष्य अनुरोध को संभालता है। आपका एप्लिकेशन लौटाए गए सामग्री को साफ करता है, चयनित मॉडल के माध्यम से एम्बेडिंग उत्पन्न करता है, और परिणामी अंशों को संग्रहीत करता है। वेब अधिग्रहण स्वयं एक वेक्टर अनुक्रमणिका नहीं बनाता है या सही टुकड़ी रणनीति का चयन नहीं करता है।
परिवर्तन से पहले मूल प्रतिक्रिया को संग्रहीत करें। अनुरोधित URL, कोई स्थापित कैनॉनिकल URL, संग्रहण समय, पृष्ठ शीर्षक, और सामान्यीकृत पाठ के हैश को बनाए रखें। एक कैनॉनिकल URL स्रोत साक्ष्य से आना चाहिए; इसे पथ खंडों को हटाकर उत्पन्न न करें।
पूर्वापेक्षाएँ
आपको सार्वजनिक स्रोत पृष्ठों का एक अनुमोदित सेट, अधिग्रहण के लिए एक Scrapeless API कुंजी, प्रोसेसिंग के लिए पायथन, और एक एम्बेडिंग मॉडल की आवश्यकता है जिसे आप स्थानीय रूप से या आपके द्वारा चुने गए प्रदाता के माध्यम से चला सके। प्रदाता या मॉडल एम्बेडिंग सेटअप और एक्सेस आवश्यकताओं को निर्धारित करता है।
इस ट्यूटोरियल का स्प्लिटर एक sentences.json फ़ाइल का उपयोग करता है जिसमें एक source_url स्ट्रिंग, एक क्रमबद्ध sentences सूची, और एक embeddings सूची होती है जिसमें प्रत्येक वाक्य के लिए एक संख्या वेक्टर होता है। यह किसी विशेष होस्टेड मॉडल या वेक्टर आयाम के बारे में धारणा नहीं बनाता। एक रन में प्रत्येक वाक्य के लिए उसी मॉडल का उपयोग होना चाहिए।
प्रमाणीकृत पृष्ठ अधिग्रहण और एम्बेडिंग पीढ़ी उन पूर्वापेक्षाओं में से हैं जिन्हें इस उदाहरण के लिए अंत से अंत तक निष्पादित नहीं किया गया है। विभाजक को स्वतंत्र रूप से जांचा जा सकता है, लेकिन स्थानीय एल्गोरिदम जांचें पुनर्प्राप्ति गुणवत्ता या सफल मॉडल एकीकरण स्थापित नहीं करते।
चरण 1: स्रोत दस्तावेज़ को कैप्चर और साफ़ करें
एक उपयोगी दस्तावेज़ का आरंभ उस इच्छित पृष्ठ सामग्री से होता है न कि एक चुनौती पृष्ठ, लॉगिन फ़ॉर्म, या नेविगेशन शेल से। पृष्ठ को वेब अनलॉकर अनुरोध इंटरफ़ेस के माध्यम से अधिग्रहण करें और यह सुनिश्चित करें कि इसकी अपेक्षित सामग्री मौजूद है, पाठ निकालने से पहले।
प्रत्येक स्वीकार किए गए पृष्ठ के लिए, स्क्रिप्ट, शैलियाँ, दोहराई गई नेविगेशन, और असंबंधित प्रचार ब्लॉकों को हटा दें। शीर्षकों और पैराग्राफ सीमाओं को संरक्षित करें। यदि पृष्ठ को गतिशील रूप से प्रस्तुत किया गया है, तो प्रलेखित प्रस्तुति कॉन्फ़िगरेशन का उपयोग करें और जांचें कि लौटाई गई सामग्री में प्रासंगिक पाठ शामिल है।
कच्ची और समान्यीकृत सामग्री को अलग से संग्रहित करें। यह तय करने में मदद करता है कि कोई खराब पुनर्प्राप्त पाठCollection, सफाई, खंडन, या एम्बेडिंग मॉडल से आया है या नहीं। स्रोत और व्युत्पन्न डेटा के बीच उत्पत्ति संबंध यहाँ उपयोगी हैं: खंड एक विशेष संस्करण से व्युत्पन्न होता है जो सामान्यीकृत दस्तावेज़ का होता है।
एक पृष्ठ के बॉडी को किसी अन्य से शीर्षक या प्रकाशन तिथि के साथ चुपचाप मिलाएँ नहीं। यदि कोई क्षेत्र अनुपलब्ध है, तो उसे अस्थायी रखें। पृष्ठ संग्रहण समय और स्रोत प्रकाशन समय विभिन्न मेटाडेटा क्षेत्र हैं।
चरण 2: वाक्य खंडित करें और सुसंगत एम्बेडिंग उत्पन्न करें
वाक्य खंडन वह क्रमबद्ध पाठ इकाइयाँ तैयार करता है जिनकी तुलना अर्थपूर्ण विभाजक करेगा। एक भाषा-प्रयोजन खंडक का उपयोग करें और अपने नमूना दस्तावेज़ों पर संक्षिप्त रूपों, दशमलवों, शीर्षकों, और बुलेट सूचियों के उपचार की जांच करें।
यह दावा करने से बचें कि एक बुनियादी अवधि विभाजन प्रत्येक पृष्ठ के लिए कार्य करता है। एक पैराग्राफ जिसमें संक्षिप्त रूप या कोड उदाहरण हो सकता है, भ्रामक टुकड़ों में टूट सकता है। छोटे संदर्भ पृष्ठों के लिए, शीर्षक और पैराग्राफ सीमाएँ पहले से ही अर्थपूर्ण पास के बिना पर्याप्त संरचना प्रदान कर सकती हैं।
प्रत्येक वाक्य के लिए एक एम्बेडिंग उत्पन्न करें और ठीक क्रम बनाए रखें। मॉडल पहचानकर्ता, सामान्यीकरण सेटिंग्स, और स्रोत-पाठ हैश को वेक्टर के साथ रिकॉर्ड करें। समानताएँ गणना करने से पहले अनुपस्थित वेक्टर, असंगत आयाम या गैर-निष्पक्ष मानों को अस्वीकार करें।
एक पैराग्राफ-स्तरीय संदर्भ खिड़की कुछ वाक्य प्रतिनिधित्वों में सुधार कर सकती है, लेकिन यह प्रयोग को बदल देती है। विभाजन नियमों को तुलना करते समय उस सेटिंग को स्थिर रखें ताकि एम्बेडिंग-इनपुट परिवर्तन को सीमा एल्गोरिदम के साथ स्पष्ट रूप से गलत न ठहराया जाए।
Scrapeless के साथ स्क्रैपिंग शुरू करें
Scrapeless के साथ अपने वेब स्क्रैपिंग और स्वचालन कार्यप्रवाह को शक्ति दें!
आज ही साइन अप करें और $5 का मुफ्त क्रेडिट प्राप्त करें — कोई क्रेडिट कार्ड आवश्यक नहीं।अपने मुफ्त क्रेडिट का दावा करें Scrapeless डैशबोर्ड में।
चरण 3: सीमांकित अर्थपूर्ण खंड बनाएं
नीचे दिए गए विभाजक एक नया खंड शुरू करता है जब निकटवर्ती वाक्य की समानता एक निर्धारित सीमा से नीचे गिरती है या वर्णन बजट को पार कर जाती है। इसे chunk_sentences.py के रूप में सहेजें।
नोट: इस स्क्रिप्ट को आपके कैप्चर किए गए पाठ और एम्बेडिंग मॉडल से उत्पन्न वास्तविक
sentences.jsonफ़ाइल की आवश्यकता है। एम्बेडिंग पीढ़ी एक पूर्वापेक्षा बनी हुई है; उदाहरण में किसी निर्मित वेक्टर सेट को शामिल नहीं किया गया है या मापे गए पुनर्प्राप्ति सुधार का दावा नहीं किया गया है।
python
import json
import math
import os
from pathlib import Path

source = json.loads(Path("sentences.json").read_text())
sentences = source["sentences"]
vectors = source["embeddings"]
threshold = float(os.environ["SIMILARITY_THRESHOLD"])
max_chars = int(os.environ["MAX_CHUNK_CHARS"])
if not -1 <= threshold <= 1 or max_chars <= 0:
    raise ValueError("Invalid chunking configuration")
if not sentences or len(sentences) != len(vectors):
    raise ValueError("Each sentence needs one embedding")
dimension = len(vectors[0])
if not dimension:
    raise ValueError("Embeddings must not be empty")
for text, vector in zip(sentences, vectors):
    if not isinstance(text, str) or not text.strip():
        raise ValueError("Sentence text must be nonempty")
    if len(text) > max_chars:
        raise ValueError("Segment oversized sentences before chunking")
    if len(vector) != dimension or not all(math.isfinite(v) for v in vector):
        raise ValueError("Invalid embedding dimension or value")
    if sum(v * v for v in vector) == 0:
        raise ValueError("A zero vector has no cosine direction")

def cosine(a, b):
    numerator = sum(x * y for x, y in zip(a, b))
    denominator = math.sqrt(sum(x*x for x in a) * sum(y*y for y in b))
    return max(-1.0, min(1.0, numerator / denominator))

chunks, start, current = [], 0, []
for index, sentence in enumerate(sentences):
    topic_change = index > 0 and cosine(vectors[index-1], vectors[index]) < threshold
    too_long = len(" ".join(current + [sentence])) > max_chars
    if current and (topic_change or too_long):
        chunks.append({"start_sentence": start, "end_sentence": index,
                       "text": " ".join(current)})
        current, start = [], index
    current.append(sentence)
chunks.append({"start_sentence": start, "end_sentence": len(sentences),
               "text": " ".join(current)})
records = [dict(chunk, source_url=source["source_url"], chunk_index=index)
           for index, chunk in enumerate(chunks)]
Path("chunks.json").write_text(json.dumps(records, ensure_ascii=False, indent=2))
print(json.dumps({"chunk_count": len(records)}))
वाक्य अंतर एक समावेशी प्रारंभ और अनन्य अंत का उपयोग करता है। वह सम्मेलन यह निर्धारित करने में मदद करता है कि किस इनपुट वाक्य ने एक खंड का उत्पादन किया। खाली इनपुट और अमान्य वेक्टर स्पष्ट रूप से विफल होते हैं बजाय इसके कि एक स्पष्ट रूप से सफल खाली इंडेक्स उत्पन्न करें।
यहाँ आकार सीमा वर्णों की गिनती करती है। यह एक टोकन सीमा नहीं है। यदि आपका एम्बेडिंग या पीढ़ी प्रणाली में एक टोकन बजट है, तो पाठ भेजने से पहले उस प्रणाली के टोकनाइज़र के साथ टोकन को मापें। कोड एक विशाल वाक्य को अस्वीकृत करता है ताकि अपस्ट्रीम खंडक इसे जानबूझकर संभाल सके।
यह कार्यान्वयन जानबूझकर सरल है: यह निकटवर्ती वाक्य वेक्टर की तुलना करता है। यह एक दस्तावेज़ के दूर के हिस्सों के बीच क्रमबद्धता लागू नहीं करता, अनुकूल प्रतिशत सीमाएँ, या प्रशिक्षित सीमा क्लासिफायर। वे अलग-अलग दृष्टिकोण हैं जिन्हें अपनी स्वयं की मूल्यांकन की आवश्यकता है।
चरण 4: बिना स्रोत खोए अंश सूचीबद्ध करें
सूचीबद्ध करने से ध्यान रखना चाहिए कि पुनर्प्राप्त खंड को उसके स्रोत दस्तावेज़ के साथ फिर से जोड़ा जा सके। खंड पाठ, स्रोत URL, पाठ हैश, खंड सूची, वाक्य सीमा, संग्रहण समय, और एम्बेडिंग मॉडल पहचानकर्ता को संग्रहित करें।
अंतिम अनुच्छेद पाठ से चंक सभी एम्बेडिंग बनाएँ यदि वह वह प्रतिनिधित्व है जिसका उपयोग आपका पुनर्प्राप्तकर्ता करता है। वाक्य एम्बेडिंग का औसत निकालना एक अलग डिज़ाइन विकल्प है; ऐसा मानने का कोई कारण नहीं है कि यह संगठित अनुच्छेद के एम्बेडिंग के समान पुनर्प्राप्ति रैंकिंग प्रदान करता है।
जब स्रोत दस्तावेज़ में परिवर्तन होता है, तो पुरानी और नई संस्करणों को अलग पहचानें। आंतरिक पाठ को बदलते समय एक ही चंक पहचानकर्ता का पुनः उपयोग करना संग्रहीत संदर्भों को अस्पष्ट बना सकता है। मानकीकृत स्रोत हैश पर आधारित एक संस्करण कुंजी अवलोकनों को अलग रखने में मदद करती है।
एक वेक्टर स्टोर केवल एक संभावित अनुक्रमणिका है। एक छोटा मूल्यांकन मेमोरी में अनुच्छेद पुनर्प्राप्त कर सकता है। उस सबसे सरल व्यवस्था के साथ शुरू करें जो आपको प्रत्येक प्रश्न के लिए लौटाए गए पाठ की जांच करने की अनुमति देती है।
चरण 5: पुनर्प्राप्ति की तुलना करें, केवल चंक उपस्थिति नहीं
अर्थात्मक चंकिंग को उन प्रश्नों पर मूल्यांकित किया जाना चाहिए जिनका उत्तर एप्लिकेशन को देने की आवश्यकता है। अनुच्छेदों का एक दृष्टिगत साफ सेट यह साबित नहीं करता है कि पुनर्प्राप्तकर्ता सही प्रमाण लौटाएगा।
सहायक अनुच्छेदों के साथ एक छोटा प्रश्न सेट बनाएं, जो मूल दस्तावेज़ों में चिह्नित हैं। एक निश्चित आकार का बेंचमार्क चलाएँ, एक संरचना-सचेत बेंचमार्क, और समान मानकीकृत सामग्री के खिलाफ अर्थात्मक विभाजक का परीक्षण करें। एम्बेडिंग मॉडल, पुनर्प्राप्ति सेटिंग्स, और उत्तर मूल्यांकन को स्थिर रखें।
| माप | प्रश्न जिसका उत्तर है |
|---|---|
| सहायक-अनुच्छेद पुनर्प्राप्ति | क्या आवश्यक साक्ष्य पुनर्प्राप्त किया गया था? |
| अप्रासंगिक पुनर्प्राप्त पाठ | कितने संदर्भ बर्बाद हुए? |
| उत्तर समर्थन | क्या उत्पन्न उत्तर प्रमाण के अनुरूप है? |
| प्रोसेसिंग समय | खंडन और एम्बेडिंग ने संचालन में कितना खर्च किया? |
| इनपुट मात्रा | प्रत्येक मॉडल चरण तक कितना पाठ पहुँचा? |
अर्थात्मक चंकिंग के गणनात्मक व्यापार-बंद पर शोध इस विधि को एक अनुभवात्मक विकल्प के रूप में मानने के समर्थन में है। अतिरिक्त कार्य हमेशा हर कार्य और डेटासेट में सुधार का उत्पादन नहीं करता है।
चरण के द्वारा विफलताओं का निरीक्षण करें। कच्ची कैप्चर में गायब साक्ष्य एक अधिग्रहण समस्या है। टूटे हुए अनुच्छेद एक सफाई समस्या हैं। एक प्रासंगिक अनुच्छेद जो अप्रासंगिक अनुच्छेदों के नीचे रैंक करता है, एम्बेडिंग या पुनर्प्राप्ति कॉन्फ़िगरेशन की ओर इशारा कर सकता है। इन समस्याओं की आवश्यकता है विभिन्न परिवर्तनों की।
Scrapeless मूल्य निर्धारण के माध्यम से अधिग्रहण घटक को अलग से ट्रैक करें। एम्बेडिंग और अनुक्रमण शुल्क डाउनस्ट्रीम स्टैक के अंतर्गत आते हैं; इन्हें वेब अनलॉकर उपयोग के रूप में रिपोर्ट नहीं किया जाना चाहिए।
निष्कर्ष: उस विभाजक का चयन करें जो बेहतर प्रमाण पुनर्प्राप्त करता है
अर्थात्मक चंकिंग उपयोगी है जब दस्तावेजों के भीतर अर्थ सरल सीमाओं को कैद करने में विफल रहता है। व्यावहारिक कार्यप्रवाह साफ स्रोत पाठ को संरक्षित करना, लगातार एम्बेडिंग उत्पन्न करना, अनुच्छेद सीमाओं को लागू करना, और सरल विकल्पों के खिलाफ पुनर्प्राप्ति की तुलना करना है।
स्रोत मेटाडेटा को हर समय संलग्न रखें। एक पुनर्प्राप्त अनुच्छेद बहुत अधिक उपयोगी हो जाता है जब एप्लिकेशन दिखा सकता है कि यह कहाँ से आया है और यह किस दस्तावेज़ संस्करण का प्रतिनिधित्व करता है।
क्या आप अपने वेब डेटा पाइपलाइन बनाने के लिए तैयार हैं?
Discord और Telegram में वेब डेटा संग्रह पर काम कर रहे डेवलपर्स से जुड़ें।
एक Scrapeless खाता बनाएं और कार्यप्रवाह को अपने अनुमोदित डेटा स्रोतों के अनुसार अनुकूलित करें।
सामान्य पूछे जाने वाले प्रश्न
प्रश्न: क्या अर्थात्मक चंकिंग हमेशा निश्चित-आकार चंकिंग से बेहतर है?
नहीं। इसका लाभ दस्तावेज़ों, एम्बेडिंग मॉडल, पुनर्प्राप्ति सेटिंग्स, और कार्य पर निर्भर करता है। एक साझा मूल्यांकन सेट पर रणनीतियों की तुलना करें इससे पहले कि आप एक का चयन करें।
प्रश्न: क्या Scrapeless इस कार्यप्रवाह में एम्बेडिंग उत्पन्न करता है?
नहीं। Scrapeless उपरी वेब-एक्सेस चरण की आपूर्ति करता है। आपका चयनित एम्बेडिंग मॉडल और अनुक्रमण डाउनस्ट्रीम प्रतिनिधित्व और पुनर्प्राप्ति को संभालते हैं।
प्रश्न: तालिकाओं और कोड ब्लॉकों को कैसे चंक किया जाना चाहिए?
उनकी संरचना को बनाए रखें या उन्हें एक समर्पित संरचना-सचेत विभाजक के माध्यम से रूट करें। केवल वाक्य की सीमाएँ मानों को शीर्षकों से हटा सकती हैं या कोड संदर्भ को तोड़ सकती हैं।
प्रश्न: क्या होगा यदि अधिग्रहित पन्ने में कोई चुनौती या अलग HTML हो?
ऐसे सामग्री को अस्वीकृत करें जो स्रोत अनुबंध को पूरा नहीं करती है और अधिग्रहण या पार्सर चरण की जांच करें। अर्थ केवल सही स्रोत दस्तावेज़ की मरम्मत नहीं कर सकता है।
प्रश्न: क्या संग्रह के लिए अलग प्रॉक्सी की आवश्यकता है?
अपने चुने हुए वेब अनलॉकर अनुरोध के राउटिंग विकल्पों का उपयोग करें। चंकिंग एल्गोरिदम से प्रॉक्सी आवश्यकताओं का अनुमान न लगाएँ, जो संग्रह के बाद चलता है।
प्रश्न: क्या पाइपलाइन बिना एक AI एजेंट के चल सकती है?
हाँ। एक एप्लिकेशन दस्तावेज़ों का अधिग्रहण कर सकता है और स्वायत्त एजेंट के बिना एम्बेडिंग-आधारित चंकिंग कर सकता है। अर्थात्मक तुलना के लिए अभी भी एक एम्बेडिंग मॉडल की आवश्यकता है।
प्रश्न: समांतर स्रोत संग्रह पर कौन-सी सीमाएँ लागू होनी चाहिए?
बाउंडेड संग्रह से शुरू करें, जैसे कि प्रति होस्ट तीन से अधिक श्रमिक नहीं, और सख्त लक्ष्य और खाता सीमाओं का सम्मान करें। एम्बेडिंग बैचों के पास विशिष्ट मॉडल-विशिष्ट सीमाएँ होती हैं।
प्रश्न: क्या किसी भी सार्वजनिक पृष्ठ को RAG अनुक्रमणिका में जोड़ा जा सकता है?
सार्वजनिक उपलब्धता के आधार पर हर संग्रह या पुनः उपयोग के लिए अनुमति स्थापित नहीं होती है। ग्रहण करने से पहले स्रोत की शर्तों, लागू अधिकारों और इच्छित डेटा हैंडलिंग की समीक्षा करें।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





