
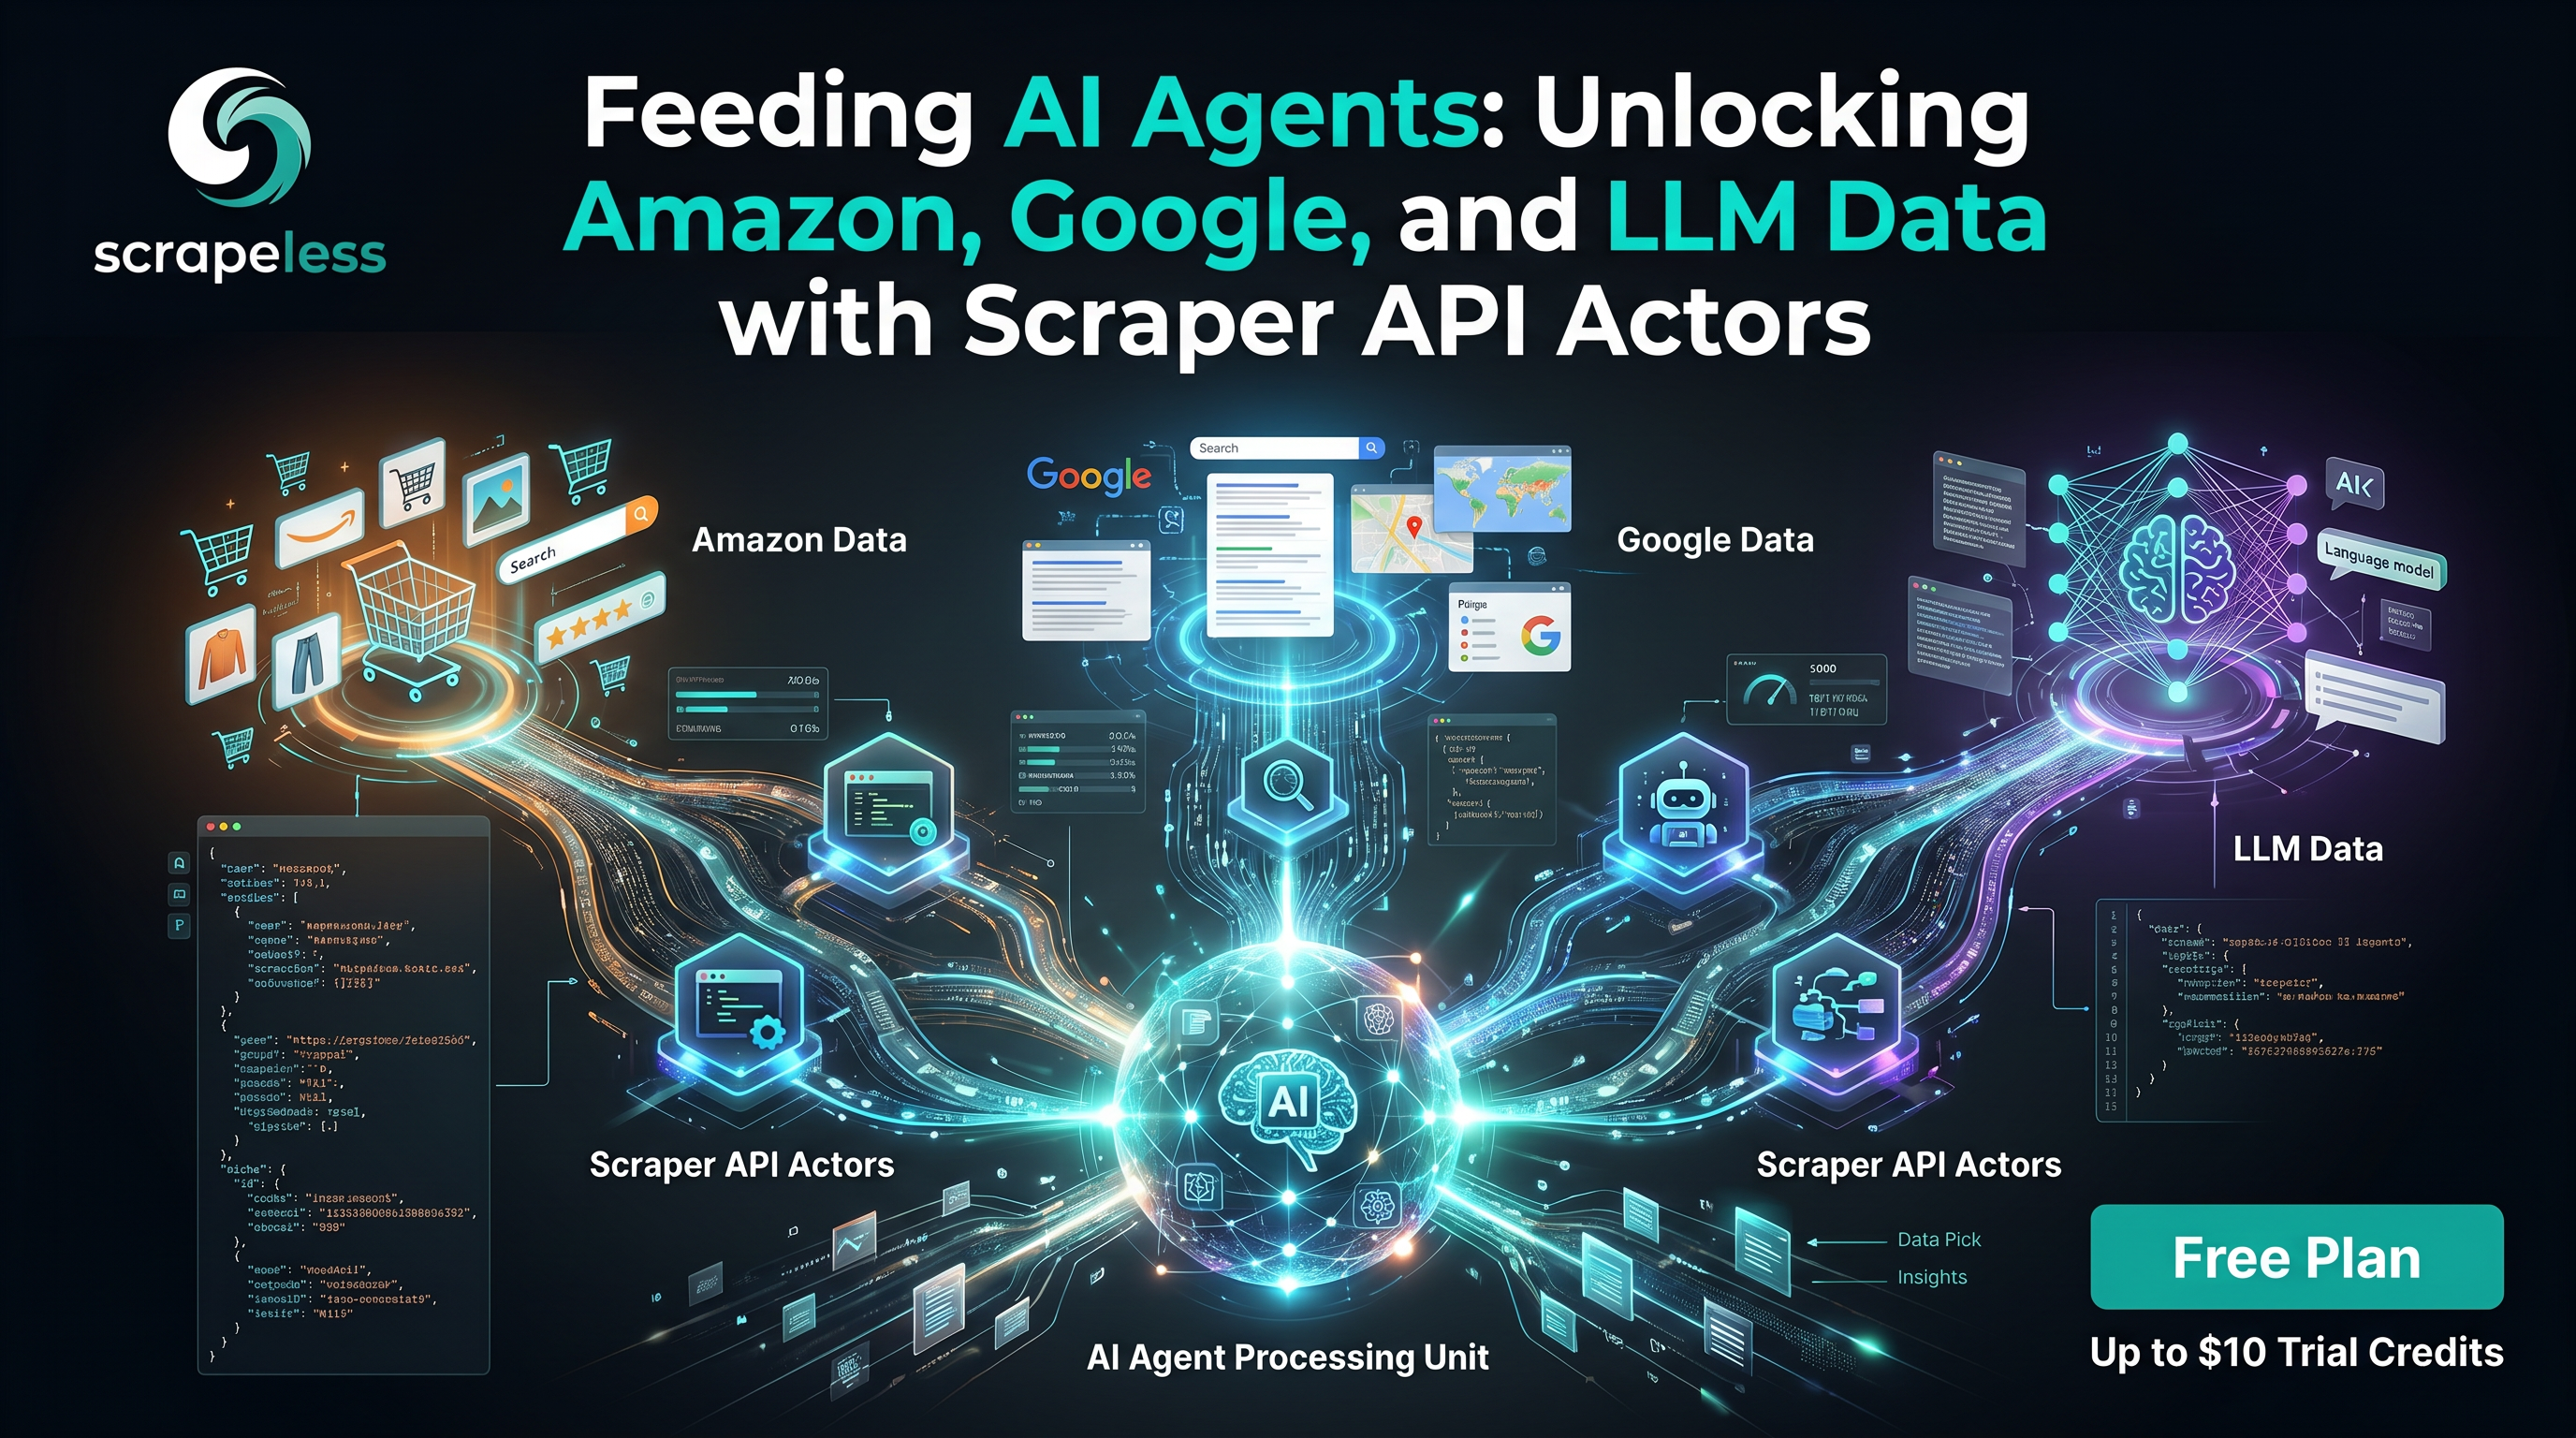
एआई एजेंट्स को खिलाना: स्क्रैपर एपीआई अभिनेताओं के साथ अमेज़न, गूगल और एलएलएम डेटा को अनलॉक करना
Senior Cybersecurity Analyst
मुख्य बिंदुओं:
- एक HTTP अनुरोध प्रति अभिनेता। Scrapeless Scraper API एक लक्ष्य - एक अमेज़न उत्पाद, एक गूगल खोज, एक एआई उत्तर - को एक नामित
scraper.*अभिनेता के खिलाफ एकलPOSTमें परिवर्तित करता है। कोई ब्राउज़र चलाने की आवश्यकता नहीं, कोई पार्सर बनाए रखने की जरूरत नहीं। - अभिनेता परिवार के अनुसार दो एंडपॉइंट। साइट और SERP अभिनेता (
scraper.amazon,scraper.google.search,scraper.shopeev2)POST /api/v1/scraper/requestका उपयोग करते हैं और विशिष्ट अभिनेता-विशिष्ट पार्स की गई JSON लौटाते हैं। AI-उत्तर अभिनेता (scraper.chatgpt,scraper.gemini,scraper.copilot,scraper.grok,scraper.perplexity,scraper.aimode)POST /api/v2/scraper/executeका उपयोग करते हैं और एक{ status, task_id, task_result }एनवेलप लौटाते हैं। - हर जगह एक ऑथ हेडर। हर कॉल में
x-api-token: <आपकी कुंजी>होता है। एक खाता कुंजी हर अभिनेता को कवर करती है। - संरचित आउटपुट, कच्चा HTML नहीं। साइट अभिनेता पार्स की गई संरचित JSON लौटाते हैं -
scraper.amazonमें एक पार्स की गईresultऔर रेंडर्डhtmlशामिल होता है, जबकिscraper.google.searchशीर्ष स्तर पर SERP फ़ील्ड लौटाता है - और v2 अभिनेता उत्तर के शरीर के साथ संदर्भ और लिंक JSON फ़ील्ड के रूप में लौटाते हैं। - जब रेंडर धीमा हो, तो Async। कुछ साइट अभिनेता
taskIdलौटाते हैं; सबमिट करें, फिरGET /api/v1/scraper/result/{taskId}पर पोल करें जब तक पे लोड तैयार न हो जाए। - शुरू करने के लिए मुफ्त। नई Scrapeless खाता फ्री Scraper API क्रेडिट्स शामिल करता है - app.scrapeless.com पर साइन अप करें।
परिचय: अभिनेता मॉडल
एक पारंपरिक स्क्रैपर तीन कार्य हैं जो एक साथ जुड़ते हैं: एंटी-बॉट परत को पार करना, पृष्ठ को रेंडर करना, और उन फ़ील्ड्स को पार्स करना जो आप चाहते हैं। Scrapeless Scraper API इन तीनों को एक कॉल में समेटती है। आप एक अभिनेता का नाम रखते हैं - एक विशिष्ट लक्ष्य के लिए एक पूर्व-निर्मित एक्स्ट्रक्टर - इसमें एक इनपुट देते हैं, और संरचित डेटा लौटाते हैं। प्रॉक्सी रोटेशन, रेंडरिंग, और पार्सिंग सर्वर-साइड होती हैं।
अभिनेता कैटलॉग तीन समूहों में फैला हुआ है: ई-कॉमर्स (scraper.amazon, scraper.shopeev2), खोज (scraper.google.search), और एआई उत्तर (scraper.chatgpt, scraper.gemini, scraper.copilot, scraper.grok, scraper.perplexity, scraper.aimode)। यह गाइड प्रमाणीकरण, दो अनुरोध आकार, प्रत्येक परिवार से एक कामकाजी उदाहरण, असिंक पैटर्न, और आप जो त्रुटियाँ वास्तव में देखेंगे उन्हें कवर करती है।
आप इसके साथ क्या कर सकते हैं
- संरचित उत्पाद डेटा खींचें - शीर्षक, मूल्य, रेटिंग, उपलब्धता, ASIN - एक मार्केटप्लेस URL से एक अनुरोध में।
- JSON के रूप में एक खोज परिणाम पृष्ठ पढ़ें बजाय खुद SERP मार्कअप को खींचने के।
- एक एआई उत्तर को उसके संदर्भों के साथ कैद करें - सही पाठ जो एक मॉडल ने एक प्रॉम्प्ट के लिए लौटाया, साथ ही स्रोत जो उसने उद्धृत किए, GEO और ब्रांड-विजिबिलिटी ट्रैकिंग के लिए।
- इसे किसी भी जगह से चलाएं - यह सामान्य HTTP है, इसलिए curl, Python
requests, Nodefetch, या किसी भी भाषा में जो HTTP क्लाइंट के साथ कार्य करता है, वो बिना बदलाव के काम करता है।
Scraper API क्यों
- कोई ब्राउज़र, कोई पार्सर बनाए रखने की जरूरत नहीं। अभिनेता सर्वर-साइड पर रेंडर और पार्स करता है; आप फ़ील्ड प्राप्त करते हैं, DOM चलाने की आवश्यकता नहीं।
- एक कुंजी, एक आकार प्रत्येक परिवार के लिए। एकल
x-api-tokenहर अभिनेता की प्रमाणीकरण करता है, और प्रत्येक परिवार एक सुसंगत एनवेलप लौटाता है, इसलिए एक बार लिखा गया क्लाइंट रैपर लक्ष्यों के अनुकूल पुन: उपयोग किया जाता है। - रेज़िडेंशियल ईग्रेस और रेंडरिंग अंतर्निहित हैं। अभिनेता भू-निर्देशन और जावास्क्रिप्ट रेंडरिंग को संभालता है; आप इनपुट भेजते हैं और परिणाम पढ़ते हैं।
मुफ्त योजना पर अपना API की प्राप्त करें app.scrapeless.com पर। Scraper API यूनिवर्सल स्क्रैपिंग API और स्क्रैपिंग ब्राउज़र के साथ बैठता है प्राइसिंग सूची में।
पूर्वापेक्षाएँ
- एक Scrapeless खाता और API कुंजी - app.scrapeless.com पर साइन अप करें।
- त्वरित परीक्षण के लिए
curl, या नीचे दिए गए क्लाइंट के लिए Python 3.10+ / Node.js 18+। - HTTP और JSON के साथ बुनियादी परिचितता।
अपनी कुंजी को वातावरण में स्टोर करें ताकि यह कभी भी कोड में न पहुंचे:
bash
export SCRAPELESS_API_KEY=your_api_token_hereदो अनुरोध आकार
Scraper API के दो एंडपॉइंट हैं। कौन सा अभिनेता उपयोग करता है यह इस पर निर्भर करता है कि यह क्या लौटाता है।
| परिवार | एंडपॉइंट | अभिनेता | लौटाता है |
|---|---|---|---|
| साइट / SERP | POST https://api.scrapeless.com/api/v1/scraper/request |
scraper.amazon, scraper.google.search, scraper.shopeev2 |
अभिनेता-विशिष्ट पार्स की गई JSON (जैसे scraper.amazon → { html, metadata, result }; scraper.google.search → organic_results, … शीर्ष-स्तरीय) |
| एआई उत्तर | POST https://api.scrapeless.com/api/v2/scraper/execute |
scraper.chatgpt, scraper.gemini, scraper.copilot, scraper.grok, scraper.perplexity, scraper.aimode |
{ स्थिति, कार्य_आईडी, कार्य_परिणाम } |
दोनों एक JSON शरीर लेते हैं { "actor": "<नाम>", "input": { … } } और हेडर x-api-token। input क्षेत्र अभिनेता के अनुसार भिन्न होते हैं (हर उदाहरण को देखें)।
उदाहरण 1 — अमेज़न उत्पाद (v1)
bash
curl -X POST https://api.scrapeless.com/api/v1/scraper/request \
  -H "Content-Type: application/json" \
  -H "x-api-token: $SCRAPELESS_API_KEY" \
  -d '{
    "actor": "scraper.amazon",
    "input": { "action": "product", "url": "https://www.amazon.com/dp/B09B8V1LZ3" }
  }'
प्रतिसाद में प्रस्तुत html, एक metadata ब्लॉक, और एक पर्स किए गए result ऑब्जेक्ट होता है। result वह है जिसे अधिकांश पाइपलाइंस सीधे उपयोग करती हैं:
json
// परिणाम (संक्षिप्त) — स्कीमा सामान्य है, मान एक लाइव रन से हैं
{
  "asin": "B09B8V1LZ3",
  "title": "अमेज़न इको डॉट (नवीनतम मॉडल) …",
  "final_price": "$49.99",
  "availability": "स्टॉक में है",
  "reviews_count": "193514",
  "seller_name": "Amazon.com"
}
पायथन में:
python
import os, requests

resp = requests.post(
    "https://api.scrapeless.com/api/v1/scraper/request",
    headers={"x-api-token": os.environ["SCRAPELESS_API_KEY"]},
    json={"actor": "scraper.amazon",
          "input": {"action": "product", "url": "https://www.amazon.com/dp/B09B8V1LZ3"}},
    timeout=120,
)
resp.raise_for_status()
print(resp.json()["result"])   # पर्स किया गया ऑब्जेक्ट; resp.json()["html"] पूरी पृष्ठ है
scraper.google.search उसी v1 अंतिम बिंदु का उपयोग करता है जिसमें इनपुट { "q": "वेब स्क्रैपिंग" } है, लेकिन इसका पर्स किया हुआ SERP शीर्ष स्तर पर आता है — organic_results, search_information, pagination, related_searches — metadata के साथ, कोई resultWrapper नहीं।
उदाहरण 2 — एक एआई उत्तर (v2)
एआई-उत्तर अभिनेता एक prompt और एक country लेते हैं और मॉडल का उत्तर अपने संदर्भों के साथ लौटाते हैं:
bash
curl -X POST https://api.scrapeless.com/api/v2/scraper/execute \
  -H "Content-Type: application/json" \
  -H "x-api-token: $SCRAPELESS_API_KEY" \
  -d '{
    "actor": "scraper.chatgpt",
    "input": { "prompt": "सर्वश्रेष्ठ वेब स्क्रैपिंग टूल कौन से हैं?", "country": "US" }
  }'
हर सफल कॉल समान लिफाफा लौटाता है:
json
// स्कीमा सामान्य है, मान एक लाइव रन से हैं
{
  "status": "सफलता",
  "task_id": "…",
  "task_result": {
    "model": "gpt-5-5",
    "result_text": "…मॉडल का उत्तर…",
    "content_references": [ { "title": "…", "url": "https://…" } ],
    "links": [ "https://…" ]
  }
}
task_result उत्तर (result_text), उद्धृत स्रोत (content_references), और निकाले गए links को धारण करता है — उद्धरण-विश्लेषण एक क्षेत्र पढ़ाई है, न कि पार्स करें।
इनमें से कुछ अभिनेता एक अतिरिक्त आवश्यक क्षेत्र लेते हैं, जिसे यदि आप छोड़ देते हैं तो API अपनी मान्यता संदेश में नामित करता है: scraper.copilot को "mode": "smart" चाहिए, scraper.grok को "mode": "MODEL_MODE_AUTO" चाहिए, और scraper.perplexity उत्तर को ग्राउंड करने के लिए "web_search": true स्वीकार करता है। scraper.gemini और scraper.aimode केवल { prompt, country } लेते हैं।
पूर्ण प्रति-अभिनेता क्षेत्र सूची के लिए, LLM चैट स्क्रैपर दस्तावेज़ को देखें। इनमें से एक अभिनेता पर एक पूर्ण एंड-टो-एंड निर्माण के लिए, गूगल एआई अवलोकन स्क्रैपर गाइड उद्धरण स्तर की कैप्चर के माध्यम से चलता है।
असिंक्रोनस अभिनेता: सबमिट करें, फिर पोल करें
कुछ साइट अभिनेता एक भारी पृष्ठ प्रस्तुत करते हैं और असिंक्रोनस रूप से उत्तर देते हैं। POST एक taskId लौटाता है बजाय Payload के:
json
{ "taskId": "ef2f7cef-…", "message": "कार्य प्रगति में है" }परिणाम अंतिम बिंदु को पोल करें जब तक कार्य समाप्त नहीं हो जाता, फिर वही Payload आकार पढ़ें:
bash
curl "https://api.scrapeless.com/api/v1/scraper/result/$TASK_ID" \
  -H "x-api-token: $SCRAPELESS_API_KEY"
# जब तक चल रहा है: { "state": "processing", "taskId": "…" }
scraper.shopeev2 इस पैटर्न का पालन करता है। एक shopee.sg उत्पाद URL(submit) करें ({ "url": "https://shopee.sg/<name>-i.<shopid>.<itemid>" }), फिर जब तक उत्पाद JSON आ नहीं जाता तब पोल करें। स्टोरफ्रंट क्षेत्र-गेटेड होते हैं, इसलिए एक असमर्थित डोमेन क्षेत्र समर्थित नहीं है लौटाता है।
आपको क्या मिलता है
| अभिनेता परिवार | शीर्ष-स्तरीय कुंजी | डेटा कहाँ है |
|---|---|---|
| साइट / SERP (v1) | अभिनेता-विशिष्ट (अमेज़न: html, metadata, result; गूगल: organic_results, … शीर्ष स्तर) |
पर्स किए गए संरचित फ़ील्ड; scraper.amazon पूरा प्रस्तुत html भी लौटाता है |
| एआई उत्तर (v2) | status, task_id, task_result |
task_result उत्तर पाठ, उद्धरण, और लिंक धारण करता है |
फील्ड्स को अनुपस्थित मानें जैसे की नल योग्य हैं - मॉड्यूल्स उत्पाद, क्वेरी, क्षेत्र और मॉडल द्वारा भिन्न होते हैं। सबसे पहले उस अभिनेता द्वारा सामने लाए गए परिणाम को पढ़ें (scraper.amazon का result, scraper.google.search के शीर्ष स्तरीय SERP फील्ड, या v2 अभिनेताओं के लिए task_result), और तब ही scraper.amazon के html पर वापस जाएं जब आपको कोई ऐसा फील्ड चाहिए जो अभिनेता पार्स नहीं करता। |
सामान्य प्रश्न
प्रश्न: मैं प्रमाणीकरण कैसे करूंगा?
हर अनुरोध में हेडर x-api-token: <आपकी कुंजी> होता है। एक खाता कुंजी सभी अभिनेताओं के लिए काम करती है। मुफ्त योजना पर app.scrapeless.com पर एक कुंजी बनाएँ।
प्रश्न: कोई अभिनेता कौन सा एंडपॉइंट उपयोग करता है - v1 या v2?
साइट और SERP अभिनेताओं (scraper.amazon, scraper.google.search, scraper.shopeev2) का उपयोग /api/v1/scraper/request करता है। AI-उत्तर अभिनेता (scraper.chatgpt, scraper.gemini, scraper.copilot, scraper.grok, scraper.perplexity, scraper.aimode) का उपयोग /api/v2/scraper/execute करता है।
प्रश्न: मैं एक अभिनेता के आवश्यक इनपुट फील्ड कैसे खोजूं?
अनुरोध भेजें; यदि कोई फील्ड अनुपस्थित है, तो API एक सत्यापन संदेश के साथ उत्तर देगा जो उसे नामित करता है (उदाहरण के लिए, scraper.copilot रिपोर्ट करता है कि mode आवश्यक है)। प्रति-अभिनेता संदर्भ Scrapeless API दस्तावेज़ों में है।
प्रश्न: क्या इन साइटों को स्क्रैप करना कानूनी है?
ये अभिनेता सार्वजनिक रूप से दिखाई देने वाले डेटा को इकट्ठा करते हैं। नियम क्षेत्राधिकार और प्रत्येक साइट की सेवा की शर्तों द्वारा भिन्न होते हैं, इसलिए सिलसिलेवार रूप से संबंधित सेवा की शर्तों की समीक्षा करें और बड़े पैमाने पर चलाने से पहले अपने उपयोग मामले के लिए सलाह लें। कभी भी GDPR या CCPA के तहत संरक्षित व्यक्तिगत डेटा इकट्ठा न करें।
प्रश्न: क्या मुझे एक प्रॉक्सी की आवश्यकता है?
नहीं। आवासीय एग्रेस और भू-रूटिंग अभिनेता में निर्मित हैं - आप इनपुट भेजते हैं, अभिनेता नेटवर्क परत को संभालता है। क्षेत्र-गेटेड लक्ष्य केवल समर्थित स्टोरफ्रंट डोमेन को स्वीकार करते हैं।
प्रश्न: क्या मैं इससे बिना किसी AI एजेंट या SDK के चला सकता हूँ?
हाँ। यह साधारण HTTP है - कर्ल, requests, fetch, या कोई भी HTTP क्लाइंट सीधे काम करता है। SDK की आवश्यकता नहीं है।
निष्कर्ष
स्क्रेपर API एक स्क्रैप को एक निर्णय और एक अनुरोध में घटित करता है: अभिनेता चुनें, { actor, input } अपने x-api-token के साथ भेजें, और संरचित फील्ड को वापस पढ़ें। साइट और SERP अभिनेता /api/v1/scraper/request पर उत्तर देते हैं जिसका पार्स किया गया JSON अभिनेता-विशिष्ट होता है; AI-उत्तर अभिनेता /api/v2/scraper/execute पर समान { status, task_id, task_result } लिफाफे के साथ उत्तर देते हैं; धीमी रेंडर असिंक्रोनसली एक taskId के माध्यम से उत्तर देती है जिसे आप पोल करते हैं। क्लाइंट रैपर एक बार लिखें और इसे उस अभिनेता की ओर निर्देशित करें जो पाइपलाइन को आवश्यकता होती है।
क्या आप अपने AI-संचालित डेटा पाइपलाइन का निर्माण करने के लिए तैयार हैं?
हमारे समुदाय में शामिल हों, मुफ्त योजना प्राप्त करें और डेवलपर्स से जुड़ें जो स्क्रेपर API पाइपलाइनों का निर्माण कर रहे हैं: Discord · Telegram।
app.scrapeless.com पर मुफ्त स्क्रेपर API क्रेडिट के लिए साइन अप करें, और एक अभिनेता को उन साइटों, क्वेरीज़, या AI उत्तरों की ओर इंगीत करें जिनकी आपकी पाइपलाइन को आवश्यकता है।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





