
SQLite और CSV रिपोर्ट्स के साथ एक Python SERP मॉनिटर बनाएं
Lead Scraping Automation Engineer
TL;DR:
- एक Python SERP मॉनिटर Google के ऑर्गैनिक नतीजों में किसी डोमेन की सबसे अच्छी पोज़िशन रिकॉर्ड करता है। यह प्रोजेक्ट स्पष्ट लोकेशन और भाषा सेटिंग के साथ लौटाए गए पहले डेस्कटॉप पेज की जाँच करता है।
- SQLite सर्च की शर्तें और ऑब्ज़र्वेशन हिस्ट्री को सुरक्षित रखता है। कलेक्शन के बीच डेटाबेस को बनाए रखें ताकि बाद की रिपोर्टें किसी तुलनीय बेसलाइन को चुन सकें।
- CSV रिपोर्टें रैंकिंग बदलावों को कलेक्शन समस्याओं से अलग रखती हैं। गायब टारगेट, खाली रिज़ल्ट ऐरे, और असफल रिक्वेस्ट – इन सभी के अर्थ अलग होते हैं।
- सेव की गई रिपोर्ट वर्ज़न पहले के कंपैरिज़न को सुरक्षित रखती हैं। एक्सपोर्ट स्टोर की गई रिपोर्ट रो को पढ़ता है, बिना कोई नई सर्च रिक्वेस्ट भेजे।
- सुरक्षित रखा गया उदाहरण एक बेसलाइन है, कोई दीर्घकालिक ट्रेंड नहीं। तीन कीवर्ड ऑब्ज़र्वेशन से तीन रिपोर्ट रो बनीं, जिनके पास तुलना के लिए कोई पिछली रैंक नहीं थी।
- शुरू करने के लिए मुफ़्त। app.scrapeless.com पर साइन अप करें और छोटी वॉचलिस्ट आज़माने के लिए शुरुआती क्रेडिट ऑफ़र का उपयोग करें।
Introduction: A Rank Needs Its Search Context
Google रैंकिंग ऑब्ज़र्वेशन एक क्वेरी, लोकेशन, भाषा, डिवाइस और लौटाए गए रिज़ल्ट सेट से जुड़ा होता है। इन शर्तों के बिना केवल पोज़िशन रिकॉर्ड करना अगले कंपैरिज़न को समझना मुश्किल बना देता है।
यह ट्यूटोरियल Scrapeless Google Search API के इर्द-गिर्द एक Python SERP मॉनिटर बनाता है। आप एक कीवर्ड वॉचलिस्ट और टारगेट डोमेन कॉन्फ़िगर करते हैं, ऑर्गैनिक रिज़ल्ट इकट्ठा करते हैं, ऑब्ज़र्वेशन SQLite में सेव करते हैं, और एक CSV रिपोर्ट एक्सपोर्ट करते हैं। इम्प्लीमेंटेशन Python की स्टैंडर्ड लाइब्रेरी का उपयोग करता है और macOS या Linux पर चलता है।
सुरक्षित रखा गया केस scrapeless.com को scrapeless, web scraping api, और google search api के लिए चेक करता है। इसकी पहली बेसलाइन में पोज़िशन 3 पर एक मैच है और लौटाए गए रिज़ल्ट में दो कीवर्ड ऐसे हैं जिनका कोई मैच नहीं है। अंडरलाइनिंग एक्टर रिक्वेस्ट मॉडल के लिए, Scrapeless Scraper API walkthrough अतिरिक्त संदर्भ प्रदान करता है।
Pipeline at a Glance
Python SERP मॉनिटर हर कॉन्फ़िगर की गई क्वेरी को एक वैलिडेटेड ऑब्ज़र्वेशन में बदलता है, फिर सबूत और वर्शन की गई रिपोर्ट स्टोर करता है।
| Stage | Operation | Output |
|---|---|---|
| Collect | पहला डेस्कटॉप ऑर्गैनिक रिज़ल्ट पेज रिक्वेस्ट करना | सर्च रिस्पॉन्स या सेव्ड टास्क स्टेट |
| Validate | स्ट्रक्चर, पोज़िशन, और डेस्टिनेशन लिंक की जाँच | उपयोगी ऑब्ज़र्वेशन या डेटा-क्वालिटी स्टेट |
| Match | नॉर्मलाइज़्ड होस्टनेम की तुलना | हर टारगेट के लिए लौटाई गई सबसे अच्छी पोज़िशन |
| Store | रिक्वेस्ट कॉन्टेक्स्ट और ऑब्ज़र्वेशन डेटा सुरक्षित रखना | data/rankings.sqlite |
| Report | तुलनीय बेसलाइन चुनना और रिपोर्ट रो सेव करना | वर्शन की गई रिपोर्ट और CSV फ़ाइल |
उदाहरण रिपोर्ट output/60c13c8bd553-v1.csv है। आपका रन ID, रिज़ल्ट काउंट और आउटपुट फ़ाइलनाम अलग हो सकते हैं। डिफ़ॉल्ट वॉचलिस्ट में एक टारगेट डोमेन है, इसलिए उसके तीनों कीवर्ड एक-एक CSV रो में योगदान करते हैं।
Why Scrapeless Google Search API
Scrapeless Google Search API मॉनिटर के लिए स्ट्रक्चर्ड सर्च रिज़ल्ट उपलब्ध कराता है, जिनमें ऑर्गैनिक रिज़ल्ट पोज़िशन और लिंक शामिल हैं, जिन्हें मॉनिटर वैलिडेट और स्टोर कर सकता है।
Google Search API, जो Scraping API प्रोडक्ट फ़ैमिली के भीतर है, रिक्वेस्ट को देश, भाषा, सर्च डोमेन और लोकेशन स्पेसिफ़ाई करने देती है। एप्लिकेशन सर्च-पेज DOM पार्सर मेंटेन करने की बजाय डोमेन मैचिंग और ऐतिहासिक तुलना पर फ़ोकस कर सकता है।
यह प्रोजेक्ट organic_results पढ़ता है; यह विज्ञापनों, मैप्स या AI सिटेशन को ऑर्गैनिक रैंक में नहीं मिलाता। यह अपने आप पेजिनेशन भी नहीं करता। वॉचलिस्ट और कलेक्शन फ़्रीक्वेंसी चुनने से पहले Scrapeless pricing की समीक्षा करें: collect सर्विस रिक्वेस्ट करता है, जबकि history और export लोकल रिकॉर्ड पर काम करते हैं।
Prerequisites
मॉनिटर को macOS या Linux पर Python 3.9 या नया वर्ज़न, बिल्ट-इन SQLite और HTTPS सपोर्ट, और प्रोडक्ट एक्सेस व क्रेडिट्स वाला Scrapeless API की चाहिए।
- टर्मिनल और प्लेन-टेक्स्ट एडिटर का उपयोग करें। CSV पढ़ने के लिए स्प्रेडशीट एप्लिकेशन उपयोगी है।
- डेटाबेस को लोकल स्टोरेज पर रखें। इम्प्लीमेंटेशन POSIX फ़ाइल लॉक का उपयोग करता है।
- प्रोजेक्ट डाउनलोड, Scrapeless डैशबोर्ड, और API तक HTTPS ऐक्सेस की अनुमति दें।
- लाइव कलेक्शन के लिए अपना खुद का API की दें। नीचे दिया गया ऐतिहासिक आउटपुट स्रोत केस से सुरक्षित रखा गया है; नया कलेक्शन अपने अलग रिज़ल्ट उत्पन्न करेगा।
किसी थर्ड-पार्टी Python पैकेज या अलग डेटाबेस सर्विस की आवश्यकता नहीं है। Python, SQLite को अपने स्टैंडर्ड-लाइब्रेरी SQLite इंटरफेस के माध्यम से उपलब्ध कराता है।
प्रोजेक्ट डाउनलोड करने से पहले रनटाइम की जाँच करें:
bash
python3 --version
python3 -c "import sqlite3, ssl, urllib.request, csv, fcntl; print('Required standard-library modules: OK')"
Step 1 — प्रोजेक्ट डाउनलोड करें और खोलें
Python SERP monitor implementation नीचे दिए गए कलेक्टर, कॉन्फ़िगरेशन, और रिपोर्ट कमांड उपलब्ध कराता है।
रिपॉज़िटरी खोलें, Code → Download ZIP चुनें, और आर्काइव एक्सट्रैक्ट करें। अगर आपके वातावरण में एक्सेस प्रतिबंधित है, तो रिपॉज़िटरी एक्सेस वाले खाते का उपयोग करें।
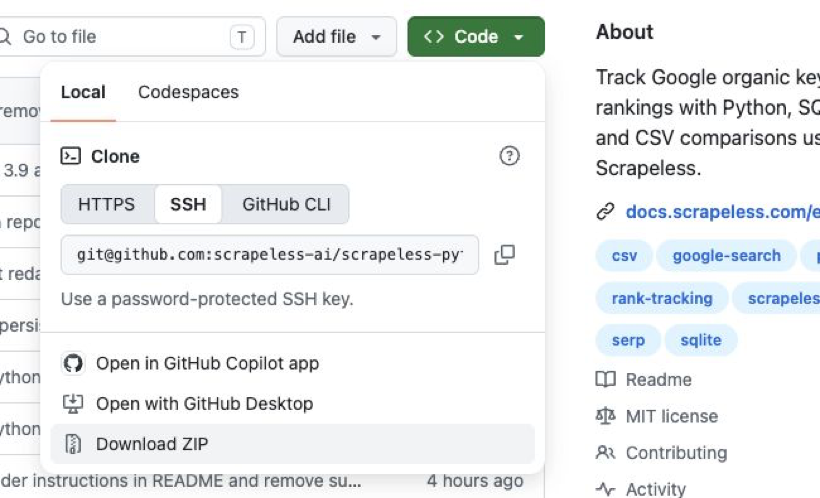
रिपॉज़िटरी के Code मेनू से प्रोजेक्ट आर्काइव डाउनलोड करें।
एक्सट्रैक्टेड डायरेक्टरी खोलें और पुष्टि करें कि serp_monitor.py, tutorial.py, starter.html, और config.json मौजूद हैं।
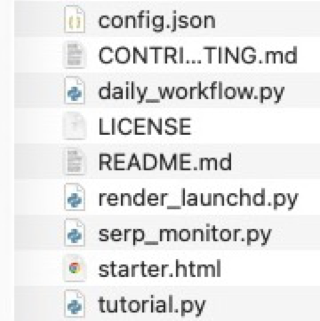
एक्सट्रैक्टेड प्रोजेक्ट डायरेक्टरी। मूल फ़ाइल नाम वैसे ही रखें।
macOS पर, Terminal में cd टाइप करें और उसके बाद एक स्पेस दें, Finder से एक्सट्रैक्टेड फ़ोल्डर को टर्मिनल में खींच कर छोड़ें, और Return दबाएँ। बाकी कमांड उसी प्रोजेक्ट डायरेक्टरी से चलाएँ।
bash
python3 serp_monitor.py --helpकमांड collect, history, export, और demo को सूचीबद्ध करता है। Git और वर्चुअल एन्वायरनमेंट इस डाउनलोड‑और‑रन रूट के लिए वैकल्पिक हैं।
Step 2 — Key सहेजें और Search Scope तय करें
API key रिक्वेस्ट को प्रमाणित करती है, जबकि config.json उन observations को परिभाषित करता है जिन्हें बाद में तुलना किया जा सकता है।
Scrapeless डैशबोर्ड में, Settings → API Key Management खोलें और किसी मौजूदा वैध key का उपयोग करें। केवल आवश्यकता होने पर ही नई key बनाएँ। API key प्रबंधन निर्देश अकाउंट सेटअप समझाते हैं।
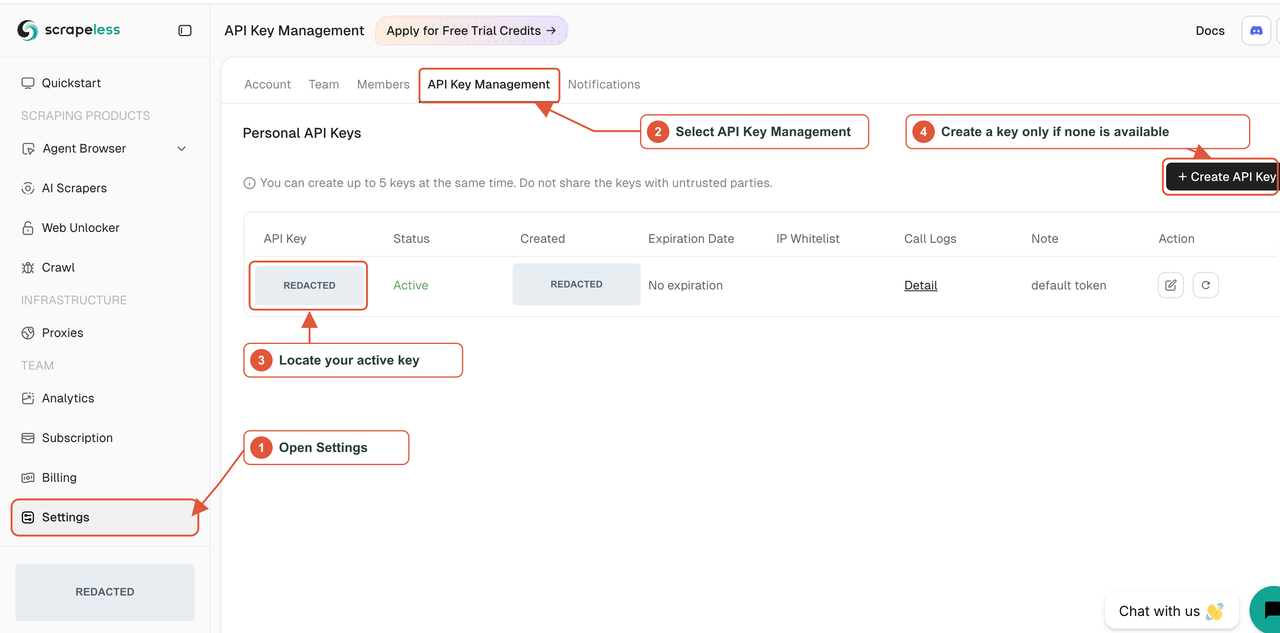
Key‑management के entry points. क्रेडेंशियल और अकाउंट‑विशिष्ट मान छिपाए गए हैं।
बिना किसी मौजूदा local key फ़ाइल को बदले, स्थानीय key फ़ाइल बनाएँ, उसकी permissions सीमित करें, और उसे macOS एडिटर में खोलें:
bash
cp -n .env.example .env
chmod 600 .env
open -e .env
नोट: स्थानीय फ़ाइल में placeholder को अपनी key से बदलें। लाइव कलेक्शन के लिए यह क्रेडेंशियल और उपलब्ध अकाउंट क्रेडिट्स आवश्यक हैं।
dotenv
SCRAPELESS_API_KEY=YOUR_SCRAPELESS_API_KEYमौजूदा SCRAPELESS_API_KEY environment variable को .env पर प्राथमिकता दी जाती है। फ़ाइल को निजी रखें और उसे स्क्रीनशॉट तथा साझा आर्काइव से बाहर रखें।
config.json को plain‑text एडिटर में खोलें और निम्नलिखित watchlist को यथावत रखें या बदलें:
json
{
  "keywords": ["scrapeless", "web scraping api", "google search api"],
  "target_domains": ["scrapeless.com"],
  "gl": "us",
  "hl": "en",
  "google_domain": "google.com",
  "location": "Austin, Texas, United States"
}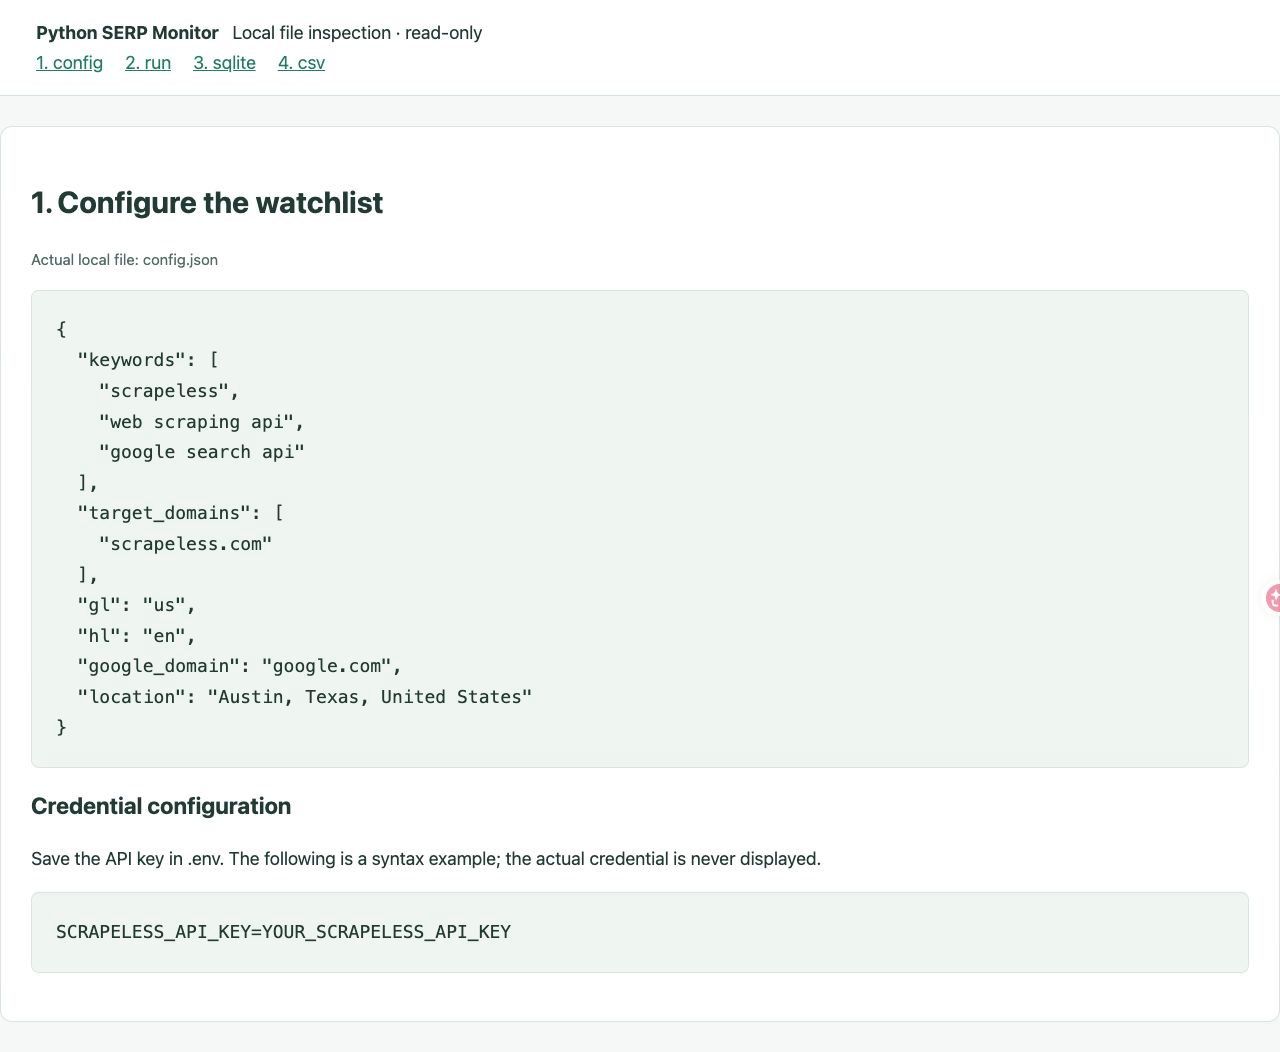
केस कॉन्फ़िगरेशन। क्रेडेंशियल क्षेत्र में placeholder दिखाया गया है, असली key नहीं।
target_domains उन hosts की पहचान करता है जिन्हें response में ढूँढना है; यह Google को केवल उन hosts तक परिणाम सीमित नहीं करता। gl, hl, google_domain, और location खोज देश, भाषा, डोमेन, और स्थान सेट करते हैं। प्रोजेक्ट डिवाइस को desktop और pagination start को 0 पर स्थिर रखता है।
बाद की तुलना के लिए इन इनपुट्स को सुसंगत रखें। अलग स्थान या भाषा एक अलग search scope शुरू करती है।
Step 3 — पहला Observation इकट्ठा करें
collect कमांड कॉन्फ़िगर की गई searches को रिक्वेस्ट करता है, observations को सहेजता है, और रिपोर्ट लिखता है।
नोट: इस कमांड के लिए आपकी Scrapeless API key और क्रेडिट्स आवश्यक हैं। यह वास्तविक searches भेजता है। बाद में दिखाया गया आउटपुट मूल केस से सुरक्षित रखा गया है, किसी नई रन की गारंटीकृत response नहीं है।
bash
python3 serp_monitor.py collect --config config.json --env-file .envसहेजे गए रन ने यह आउटपुट उत्पन्न किया:
text
Run: 60c13c8bd553
scrapeless: 9 organic results saved
web scraping api: 7 organic results saved
google search api: 9 organic results saved
CSV: output/60c13c8bd553-v1.csv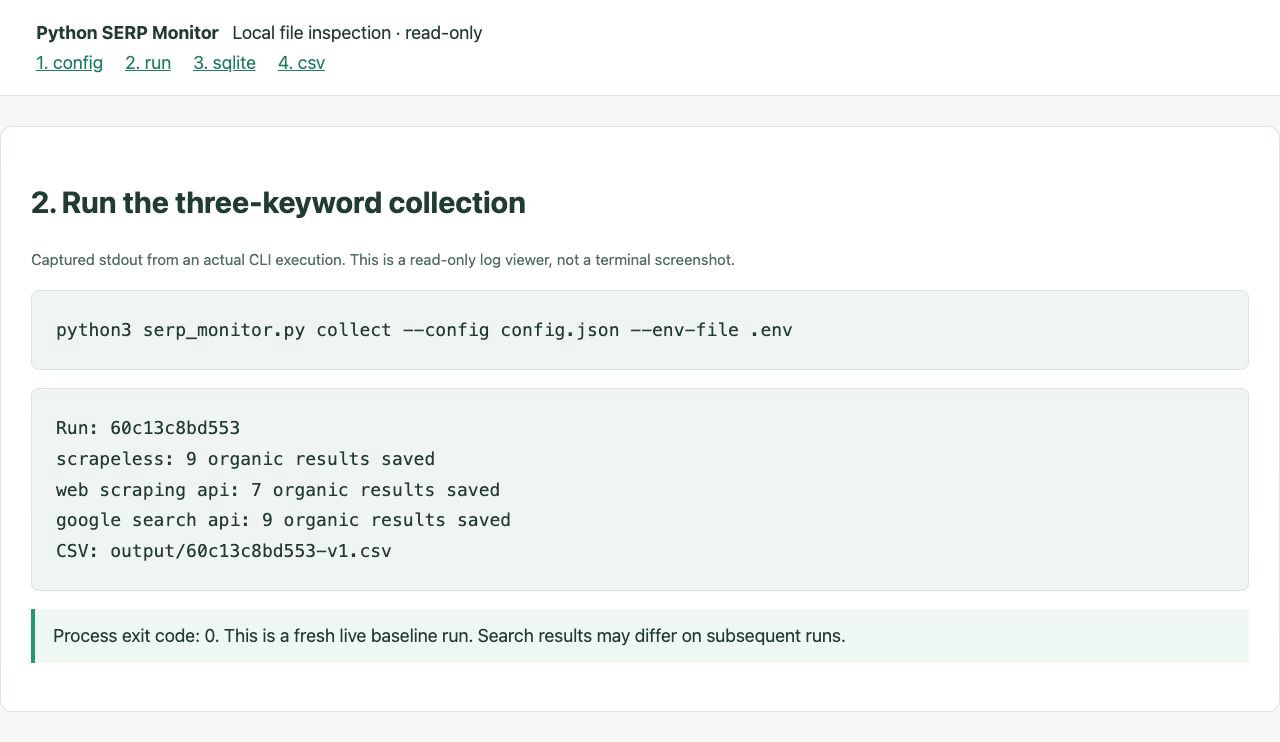
केवल‑पढ़ने योग्य log view, टर्मिनल स्क्रीनशॉट नहीं। स्रोत कमांड exit code 0 के साथ पूर्ण हुआ।
रन ने observations को data/rankings.sqlite में सहेजा और ऊपर दिखाया गया CSV path लिखा। ये काउंट सहेजे गए organic results का वर्णन करते हैं, न कि target डोमेन की रैंक का।
Step 4 — परिणाम मान्य करें और Target Hostname से मिलाएँ
कलेक्टर, किसी domain match या अनुपस्थिति को सफल observation मानने से पहले लौटाए गए organic array को मान्य करता है।
Request और Task State को समझें
पहले keyword के लिए, प्रोजेक्ट यह request body बनाता है। यह एक रिक्वेस्ट उदाहरण है, कोई दूसरा कमांड नहीं जिसे चलाना हो:
json
{
  "actor": "scraper.google.search",
  "input": {
    "q": "scrapeless",
    "gl": "us",
    "hl": "en",
    "google_domain": "google.com",
    "location": "Austin, Texas, United States",
    "start": 0,
    "device": "desktop"
  }
}
प्रोजेक्ट इस body को POST https://api.scrapeless.com/api/v1/scraper/request पर x-api-token में दी गई key के साथ भेजता है। Google Search API request lifecycle HTTP 200 परिणाम को HTTP 201 response से अलग करता है जिसमें taskId होता है।
कलेक्टर लौटाए गए टास्क ID को सहेजता है, उससे जुड़े मौजूदा टास्क को पोल करने से पहले। सबमिट किया गया टास्क और पूरी हो चुकी ऑब्ज़र्वेशन अलग-अलग स्थितियाँ हैं। यदि सबमिशन का परिणाम अनिश्चित हो और कोई टास्क ID सहेजी न गई हो, तो एप्लिकेशन चुपचाप एक और सर्च बनाने के बजाय उस अनिश्चितता को दिखने योग्य छोड़ देता है।
सिर्फ HTTP रिस्पॉन्स कोड यह साबित नहीं करता कि एप्लिकेशन को उपयोगी रैंकिंग डेटा मिला है। HTTP semantics specification प्रोटोकॉल की स्थिति को परिभाषित करता है; कलेक्टर को फिर भी रिस्पॉन्स बॉडी को वैलिडेट करना होता है।
ऑर्गेनिक रिज़ल्ट ऐरे की जाँच करें
मॉनिटर position, link, और title को organic_results से पढ़ता है। यह लौटाए गए position को किसी ऐरे इंडेक्स से बदलने के बजाय जैसा है वैसा ही रखता है।
पोज़िशन अलग-अलग धनात्मक पूर्णांक होने चाहिए, और लिंक वैध HTTP(S) डेस्टिनेशन पतों तक पहुँचने चाहिए। खाली ऑर्गेनिक ऐरे को empty_unverified दिया जाता है और उसे रैंक तुलना से बाहर रखा जाता है। यह स्थिति किसी अपुष्ट खाली रिस्पॉन्स को ऐसे इंटरप्रेट होने से रोकती है मानो टारगेट गायब हो गया हो।
कुछ Google रिज़ल्ट /url या /goto रैपर लिंक का उपयोग करते हैं। कलेक्टर जहाँ उपलब्ध हो, वहाँ स्पष्ट डेस्टिनेशन निकालता है। अपारदर्शी लेकिन समर्थित रैपर के लिए, वह सीमित Google स्कोप के भीतर एक स्वतंत्र रिक्वेस्ट के ज़रिए, Scrapeless कुंजी के बिना, रीडायरेक्ट जानकारी की जाँच करता है; वह अंतिम टारगेट साइट पर नहीं जाता। अनसुलझे लिंक को किसी कथित रूप से पूर्ण ऑब्ज़र्वेशन से चुपचाप हटाने के बजाय त्रुटि ही रहने दिया जाता है।
Scrapeless के साथ स्क्रैपिंग शुरू करें
Scrapeless के साथ अपने वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को पावर‑अप करें!
आज ही साइन अप करें और पाएँ $5 का फ्री क्रेडिट — कोई क्रेडिट कार्ड आवश्यक नहीं।अपना फ्री क्रेडिट अभी Scrapeless Dashboard में क्लेम करें।
URL सबस्ट्रिंग नहीं, होस्टनेम मिलाएँ
टारगेट डोमेन को पार्स किए गए होस्टनेम या उसके किसी सबडोमेन से मेल खाना चाहिए। सबस्ट्रिंग मिलान example.com के लिए example.com.other.org को ग़लती से स्वीकार कर लेगा। यह अंतर URI syntax specification में अलग‑अलग अथॉरिटी और पाथ घटकों के अनुरूप है।
निम्न को serp_monitor.py के बगल में match_example.py के रूप में सहेजें। यह हाथ से लिखे उदाहरण इनपुट का उपयोग करता है और कोई API रिक्वेस्ट नहीं करता।
python
from urllib.parse import urlsplit
from serp_monitor import normalized_domain


def best_match(organic, domain):
    domain = normalized_domain(domain)
    for item in sorted(organic, key=lambda row: row["position"]):
        host = normalized_domain(urlsplit(item["link"]).hostname or "")
        if host == domain or host.endswith("." + domain):
            return item
    return None


organic = [
    {"position": 1, "link": "https://example.com.other.org/page"},
    {"position": 3, "link": "https://www.example.com/page"},
]
match = best_match(organic, "example.com")
print(match["position"] if match else None)
लोकल उदाहरण चलाएँ:
bash
python3 match_example.pyयह 3 प्रिंट करता है। पहला होस्ट other.org का है; दूसरा टारगेट डोमेन का है। यदि कई रिज़ल्ट मिलते हैं, तो सबसे कम लौटी हुई पोज़िशन जीतती है।
बिना किसी मैच के, रैंक खाली रहती है। खाली का अर्थ है कि डोमेन इस लौटाए गए सेट में नहीं मिला, न कि पोज़िशन शून्य, और न ही यह कि वह सभी Google रिज़ल्ट से अनुपस्थित है।
चरण 5 — SQLite हिस्ट्री का निरीक्षण करें
SQLite बाद की तुलना के लिए आवश्यक रिक्वेस्ट संदर्भ और सहेजी गई ऑब्ज़र्वेशन को रखता है, जिनमें वे स्थितियाँ भी शामिल हैं जिन्हें कोई सपाट CSV पूरी तरह वर्णित नहीं कर सकता।
| Table | Stored information | Purpose |
|---|---|---|
runs |
रन पहचान, मोड, कॉन्फ़िगरेशन, पूर्णता स्थिति | किसी कलेक्शन को समूहित करना |
snapshots |
कीवर्ड, इनपुट, स्टेटस, टास्क विवरण, रिज़ल्ट डेटा, रिक्वेस्ट टाइमिंग | ऑब्ज़र्वेशन और टास्क स्थिति को संरक्षित करना |
report_versions |
सहेजी गई तुलना पंक्तियाँ और चुनी गई बेसलाइन जानकारी | रिपोर्ट संस्करणों को पुनरुत्पादनीय रखना |
इस पूर्ण स्क्रिप्ट को प्रोजेक्ट डायरेक्टरी में inspect_history.py के रूप में सहेजें। यह डेटाबेस को केवल‑पढ़ने की मोड में खोलता है और नवीनतम लाइव रन में प्रत्येक स्नैपशॉट के लिए ऑर्गेनिक काउंट प्रिंट करता है।
नोट: इस स्क्रिप्ट के लिए कलेक्शन से मौजूद डेटाबेस आवश्यक है। यह सर्च सबमिट नहीं करती या कोई ग़ैर‑मौजूद डेटाबेस नहीं बनाती।
python
import json
import sqlite3
from pathlib import Path

uri = Path("data/rankings.sqlite").resolve().as_uri() + "?mode=ro"
with sqlite3.connect(uri, uri=True) as db:
    rows = db.execute("""
        SELECT keyword, status, organic_json
        FROM snapshots
        WHERE run_id = (
            SELECT id FROM runs
            WHERE mode = 'live'
            ORDER BY started_at DESC LIMIT 1
        )
        ORDER BY id
    """)
    for keyword, status, organic_json in rows:
        count = len(json.loads(organic_json or "[]"))
        print(keyword, status, count)
कलेक्शन के बाद python3 inspect_history.py चलाएँ। सुरक्षित डेटाबेस क्वेरी ने यह लौटाया:
text
scrapeless success 9
web scraping api success 7
google search api success 9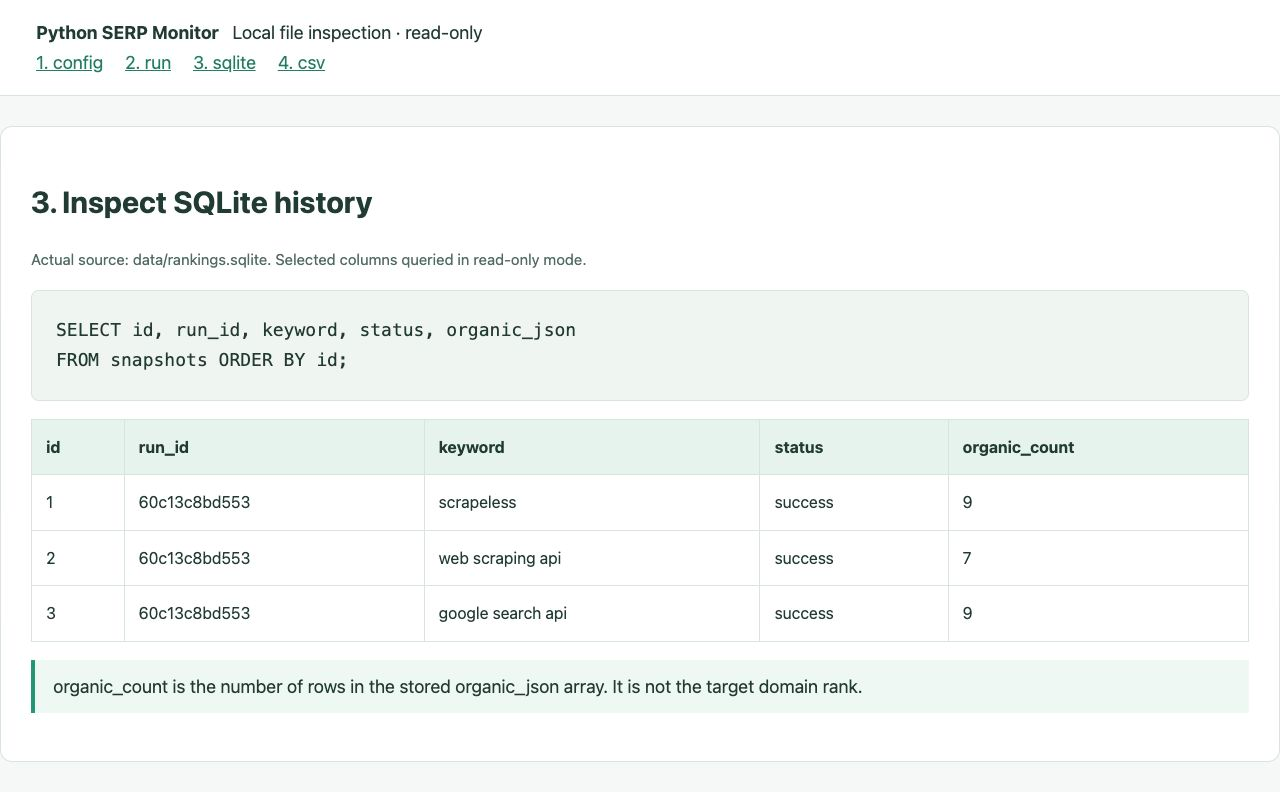
संरक्षित डेटाबेस से चुने हुए फ़ील्ड। दिखाया गया ऑर्गेनिक काउंट संग्रहीत ऐरे से गणना किया गया है।
success कलेक्शन का वर्णन करता है। यह रिपोर्ट के baseline या baseline_absent स्टेटस से भिन्न है। बाद की ऑब्ज़र्वेशन के लिए वही डेटाबेस सुरक्षित रखें; केवल CSV से टास्क हिस्ट्री बहाल नहीं की जा सकती।
चरण 6 — CSV को पढ़ें और पुन: निर्यात करें
CSV टारगेट मैच, रिज़ल्ट कवरेज, और तुलना स्थिति को हर कीवर्ड और टारगेट के लिए एक ही पंक्ति में संयोजित करता है।
रन के CSV को किसी स्प्रेडशीट एप्लिकेशन में खोलें। आप सहेजे गए रन को सूचीबद्ध भी कर सकते हैं:
नोट: लोकल हिस्ट्री और एक्सपोर्ट कमांड के लिए कलेक्शन से सुरक्षित डेटाबेस आवश्यक है। वे कोई API कॉल नहीं करते।
bash
python3 serp_monitor.py history --db data/rankings.sqlite
python3 serp_monitor.py export --output output/saved-report.csv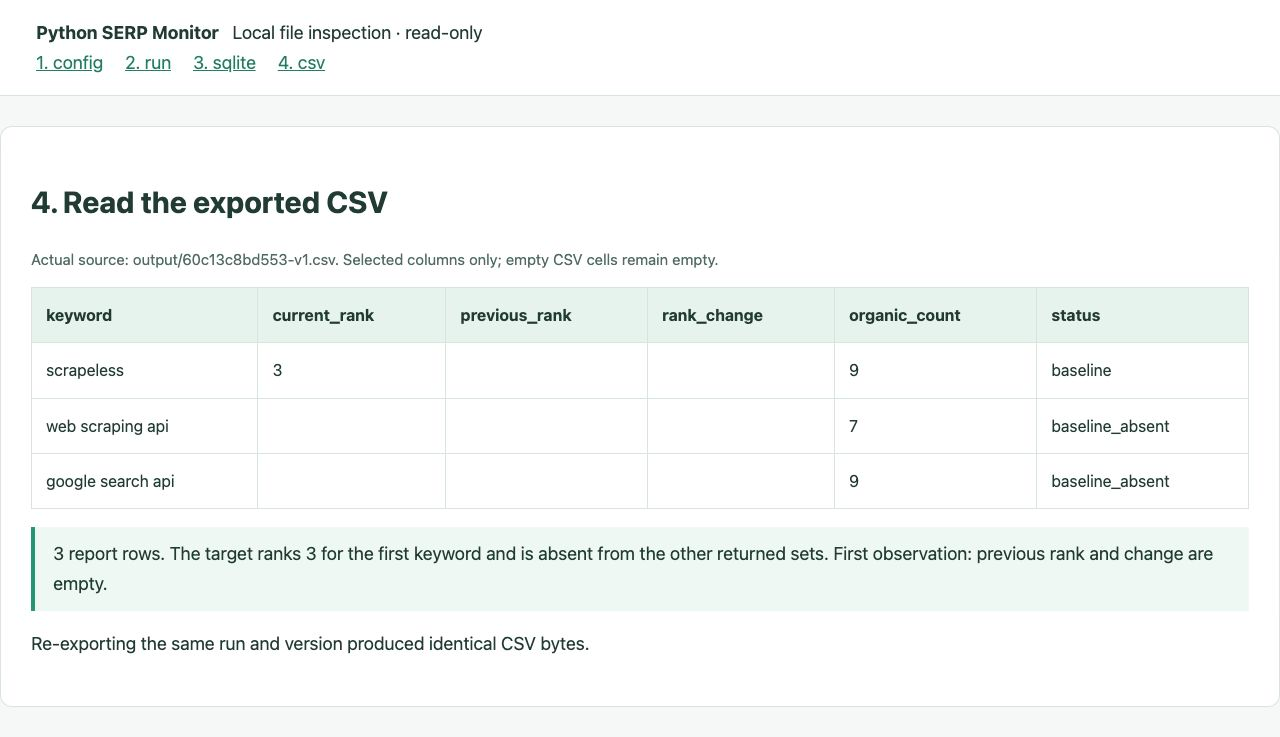
रीड‑ओनली व्यूअर में चुने हुए CSV कॉलम, स्प्रेडशीट‑एप्लिकेशन का स्क्रीनशॉट नहीं। ग़ैर‑मौजूद रैंक खाली ही रहती हैं।
सुरक्षित पहली बेसलाइन में ये रिज़ल्ट शामिल हैं:
| कीवर्ड | वर्तमान रैंक | ऑर्गैनिक परिणाम | रिपोर्ट स्थिति |
|---|---|---|---|
scrapeless |
3 | 9 | baseline |
web scraping api |
— | 7 | baseline_absent |
google search api |
— | 9 | baseline_absent |
डैश रिक्त CSV सेल को दर्शाते हैं। तीनों ऑब्ज़र्वेशन सफल रहे, लेकिन केवल पहला कीवर्ड लक्ष्य से मेल खाया। कोई पिछला तुलनीय ऑब्ज़र्वेशन नहीं था, इसलिए previous_rank और rank_change रिक्त थे।
रिपोर्ट अपने स्नैपशॉट्स, बेसलाइन, खोज सेटिंग्स, और रिक्वेस्ट टाइमिंग को ट्रेस करने के लिए फ़ील्ड भी सुरक्षित रखती है। CSV एक्सपोर्ट UTF-8 (बाइट-ऑर्डर मार्क सहित) का उपयोग करता है और फॉर्मूला-जैसे टेक्स्ट सेल्स को एस्केप करता है। यह अंतर तब मायने रखता है जब बाहरी रूप से प्रदान किए गए टेक्स्ट को स्प्रेडशीट में इम्पोर्ट किया जाता है, जैसा कि OWASP के CSV इंजेक्शन मार्गदर्शन में वर्णित है।
बेसलाइन को दोबारा लिखे बिना बाद के कलेक्शन की तुलना करें
बाद की रिपोर्ट केवल तभी मूवमेंट की गणना करती है जब संग्रहीत ऑब्ज़र्वेशन में मिलती-जुलती सर्च स्कोप और विश्वसनीय क्रमबद्धता हो।
अगले ऑब्ज़र्वेशन समय पर, उसी प्रोजेक्ट डायरेक्टरी पर वापस जाएँ और .env, config.json, तथा data/rankings.sqlite को बनाए रखें। स्टेप 3 का collect कमांड दोबारा चलाएँ। यह एक नया पेड कलेक्शन शुरू करता है; मौजूदा रिपोर्ट को केवल पढ़ने के लिए यह आवश्यक नहीं है।
यह स्थापित करें कि ऑब्ज़र्वेशन तुलनीय हैं या नहीं
पहला परिणाम वर्तमान रिक्वेस्ट के सबमिट किए जाने से बाद में प्राप्त नहीं हुआ होना चाहिए। जब रिक्वेस्ट अंतराल ओवरलैप हों या पुराने रिकॉर्ड में भरोसेमंद टाइमिंग न हो, तो केवल क्वेरी सेटिंग्स का मेल पर्याप्त नहीं होता।
ऐसे मामलों में, रिपोर्ट वर्तमान रैंक को सुरक्षित रखती है लेकिन तुलना को not_comparable के रूप में चिह्नित करती है। ये क्लाइंट सबमिशन और रिसीट समय हैं; प्रोजेक्ट यह दावा नहीं करता कि उसे प्रोवाइडर के सटीक कलेक्शन समय का पता है।
जब दोनों तुलनीय ऑब्ज़र्वेशन में मैच मौजूद हो, तो गणना rank_change = previous_rank - current_rank होती है। स्थिति 5 से स्थिति 3 पर एक उदाहरणात्मक मूव +2 उत्पन्न करता है, जिसका अर्थ है दो पोजीशन का सुधार। यह अंकगणितीय उदाहरण केस से लिए गए दूसरे लाइव ऑब्ज़र्वेशन का प्रतिनिधित्व नहीं करता।
अनुपस्थिति को कलेक्शन क्वालिटी से अलग रखें
| रिपोर्ट स्थिति | अर्थ |
|---|---|
baseline / baseline_absent |
पहला उपयोगी तुलना बेसलाइन, लक्ष्य मैच के साथ या बिना |
up / down / unchanged |
दोनों तुलनीय ऑब्ज़र्वेशन मेल खाए; स्थिति बेहतर हुई, गिरी, या समान रही |
new / lost / still_absent |
मैच केवल अभी, केवल पहले, या दोनों लौटाए गए सेट में नहीं |
pending / error |
कोई उपयोगी पूर्ण वर्तमान ऑब्ज़र्वेशन नहीं |
empty_unverified |
खाली ऑर्गैनिक ऐरे, रैंकिंग बेसलाइन से बाहर रखा गया |
not_comparable |
मान्य वर्तमान परिणाम, लेकिन क्रमबद्धता परिवर्तन की गणना का समर्थन नहीं करती |
lost लौटाए गए सेट तक सीमित है। ऑब्ज़र्वेशन के बीच परिणामों की संख्या बदल सकती है, इसलिए निष्कर्ष निकालने से पहले पोजीशन के साथ कवरेज भी पढ़ें।
सहेजी गई रिपोर्ट वर्शन एक्सपोर्ट करें
एप्लिकेशन जब कोई वर्शन जनरेट करता है, तो वह रिपोर्ट रो और उनकी चुनी हुई बेसलाइन को सहेजता है। बाद के ऑब्ज़र्वेशन पहले से सहेजी गई उस वर्शन की रो को नहीं बदलते।
नोट:
YOUR_RUN_IDको किसी मौजूदा रन ID से बदलें। इस कमांड को लोकल डेटाबेस में उसके सहेजे हुए वर्शन की आवश्यकता होती है और यह कोई API कॉल नहीं करता।
bash
python3 serp_monitor.py export --run-id YOUR_RUN_ID --version 1 --output output/saved-v1.csvरिटेन्ड केस के वर्शन-1 री-एक्सपोर्ट ने समान CSV बाइट्स उत्पन्न किए। एक्सपोर्ट गंतव्य को बदलने से पहले एक अस्थायी फ़ाइल लिखता है। स्पष्ट रूप से चुना गया आउटपुट पथ ओवरराइट किया जा सकता है, जबकि सहेजा हुआ डेटाबेस वर्शन उपलब्ध रहता है।
लोकल वर्कफ़्लो का ट्रबलशूटिंग
ज़्यादातर सेटअप समस्याएँ वर्तमान डायरेक्टरी, सक्रिय क्रेडेंशियल, या चुने गए डेटाबेस तक ट्रेस की जा सकती हैं।
| लक्षण | क्या जाँचें |
|---|---|
| स्क्रिप्ट नहीं मिल रही | कमांड निकाली गई प्रोजेक्ट डायरेक्टरी से चलाएँ |
| कुंजी गुम या अमान्य | प्लेसहोल्डर बदलें और एनवायरनमेंट-वेरिएबल प्रीसिडेंस जाँचें |
| अपर्याप्त अकाउंट ऐक्सेस या बैलेंस | चुनी गई सर्विस और डैशबोर्ड में उपलब्ध क्रेडिट जाँचें |
| वर्तमान रैंक रिक्त | टार्गेट होस्टनेम और लौटाई गई ऑर्गैनिक कवरेज का निरीक्षण करें |
| अप्रत्याशित नई बेसलाइन | सुनिश्चित करें कि सर्च सेटिंग्स और डेटाबेस पाथ इच्छित इतिहास से मेल खाते हैं |
empty_unverified |
रैंकिंग बदलाव की व्याख्या करने से पहले रिस्पॉन्स क्वालिटी का निरीक्षण करें |
not_comparable |
रिकॉर्डेड रिक्वेस्ट अंतराल और ऐतिहासिक टाइमिंग उपलब्धता का निरीक्षण करें |
कुंजी फ़ाइल और रॉ डेटाबेस को निजी रखें। किसी रिपोर्ट या स्क्रीनशॉट को साझा करने से पहले, क्रेडेंशियल और किसी भी निजी टार्गेट या URL को हटा दें।
निष्कर्ष: बदलाव की व्याख्या करने से पहले ऑब्ज़र्वेशन को संरक्षित करें
यह Python SERP मॉनिटर एक छोटे से वर्कफ़्लो में कलेक्शन, होस्टनेम मैचिंग, SQLite इतिहास, और CSV रिपोर्टिंग को जोड़ता है। रिटेन्ड उदाहरण तीन क्वेरीज़ के लिए बेसलाइन स्थापित करता है; दीर्घकालिक निष्कर्षों के लिए तुलनीय सेटिंग्स और टाइमिंग वाले अतिरिक्त वास्तविक ऑब्ज़र्वेशन आवश्यक हैं।
डेटाबेस को बनाए रखें, रैंकिंग स्थिति से पहले कलेक्शन स्थिति को पढ़ें, और जब किसी तुलना को पुनरुत्पादन योग्य बनाए रखना हो, तो सहेजी गई रिपोर्ट संस्करणों का उपयोग करें। ये विकल्प अगली कलेक्शन को व्याख्यायित करने योग्य बनाते हैं।
क्या आप अपना सर्च मॉनिटरिंग पाइपलाइन बनाने के लिए तैयार हैं?
Discord या Telegram पर सर्च वर्कफ़्लो बनाने वाले डेवलपर्स से जुड़ें।
app.scrapeless.com पर साइन अप करें, एक छोटी वॉचलिस्ट से शुरू करें, और हर ऑब्ज़र्वेशन के साथ सर्च संदर्भ को बनाए रखें।
FAQ
प्रश्न: इस मॉनिटर को कौन-सा डेटा इकट्ठा करना चाहिए?
मॉनिटर का उपयोग सार्वजनिक ऑर्गैनिक सर्च परिणामों और उन टार्गेट्स के लिए करें जिन्हें विश्लेषण करने की आपको अनुमति है। डेटा इकट्ठा करने या साझा करने से पहले अपने उपयोग-केस के लिए लागू सेवा शर्तों और आवश्यकताओं की समीक्षा करें।
प्रश्न: क्या मॉनिटर हर Google परिणाम पेज को ट्रैक करता है?
नहीं। यह इम्प्लीमेंटेशन start: 0 के साथ लौटाए गए पहले डेस्कटॉप ऑर्गैनिक पेज को अनुरोध करता है। किसी टार्गेट का गायब होना इस लौटाए गए सेट में मैच न मिलने का संकेत है।
प्रश्न: क्या आपको प्रॉक्सी या AI एजेंट की ज़रूरत है?
इस एप्लिकेशन के लिए अलग प्रॉक्सी क्लाइंट या AI एजेंट की आवश्यकता नहीं है। Python Scrapeless Google Search API को अकाउंट की और कॉन्फ़िगर किए गए सर्च इनपुट्स के साथ कॉल करता है।
प्रश्न: अगर Google अपना पेज मार्कअप बदल देता है तो क्या होगा?
यह मॉनिटर Google DOM एलिमेंट चुनने की बजाय स्ट्रक्चर्ड API परिणामों का उपयोग करता है। यह फिर भी रिस्पॉन्स स्कीमा को मान्य करता है और रैंक गढ़ने की बजाय अनुपयोगी डेटा को रिकॉर्ड करता है।
प्रश्न: मॉनिटर एक्सेस एरर या अनुपयोगी रिस्पॉन्स को कैसे संभालता है?
यह कलेक्शन समस्याओं को टार्गेट अनुपस्थिति से अलग रखता है। रिपोर्ट की व्याख्या करने से पहले क्रेडेंशियल्स, प्रोडक्ट एक्सेस, बैलेंस और रिकॉर्ड की गई रिस्पॉन्स स्थिति की जाँच करें।
प्रश्न: क्या कई कलेक्टर्स एक ही डेटाबेस में लिख सकते हैं?
एप्लिकेशन एक साझा डेटाबेस लॉक का उपयोग करता है ताकि एक ही लोकल डेटाबेस के खिलाफ ओवरलैपिंग कलेक्शन से बचा जा सके। कलेक्शन को क्रमिक रखें और एकसमान डेटाबेस पाथ्स का उपयोग करें।
प्रश्न: एक सफल परिणाम को not_comparable के रूप में क्यों चिह्नित किया जा सकता है?
वर्तमान परिणाम मान्य हो सकता है जबकि रिक्वेस्ट ऑर्डरिंग अनिश्चित हो। ओवरलैपिंग इंटरवल या ऐतिहासिक सबमिशन समयों की कमी एक मज़बूत मूवमेंट कैलकुलेशन को रोकती है।
प्रश्न: क्या एक्सपोर्ट करने से API क्रेडिट खर्च होते हैं?
नहीं। export सहेजे गए रिपोर्ट संस्करण को पढ़ता है, और history लोकल रन रिकॉर्ड्स को पढ़ता है। collect सर्च अनुरोध करता है।
प्रश्न: क्या खाली रैंक का मतलब है कि वेबसाइट को Google से हटा दिया गया?
नहीं। खाली रैंक का मतलब लौटाए गए ऑर्गैनिक सेट में कोई टार्गेट मैच न होना है। यह पूर्ण इंडेक्स-स्थिति आकलन नहीं है।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





