
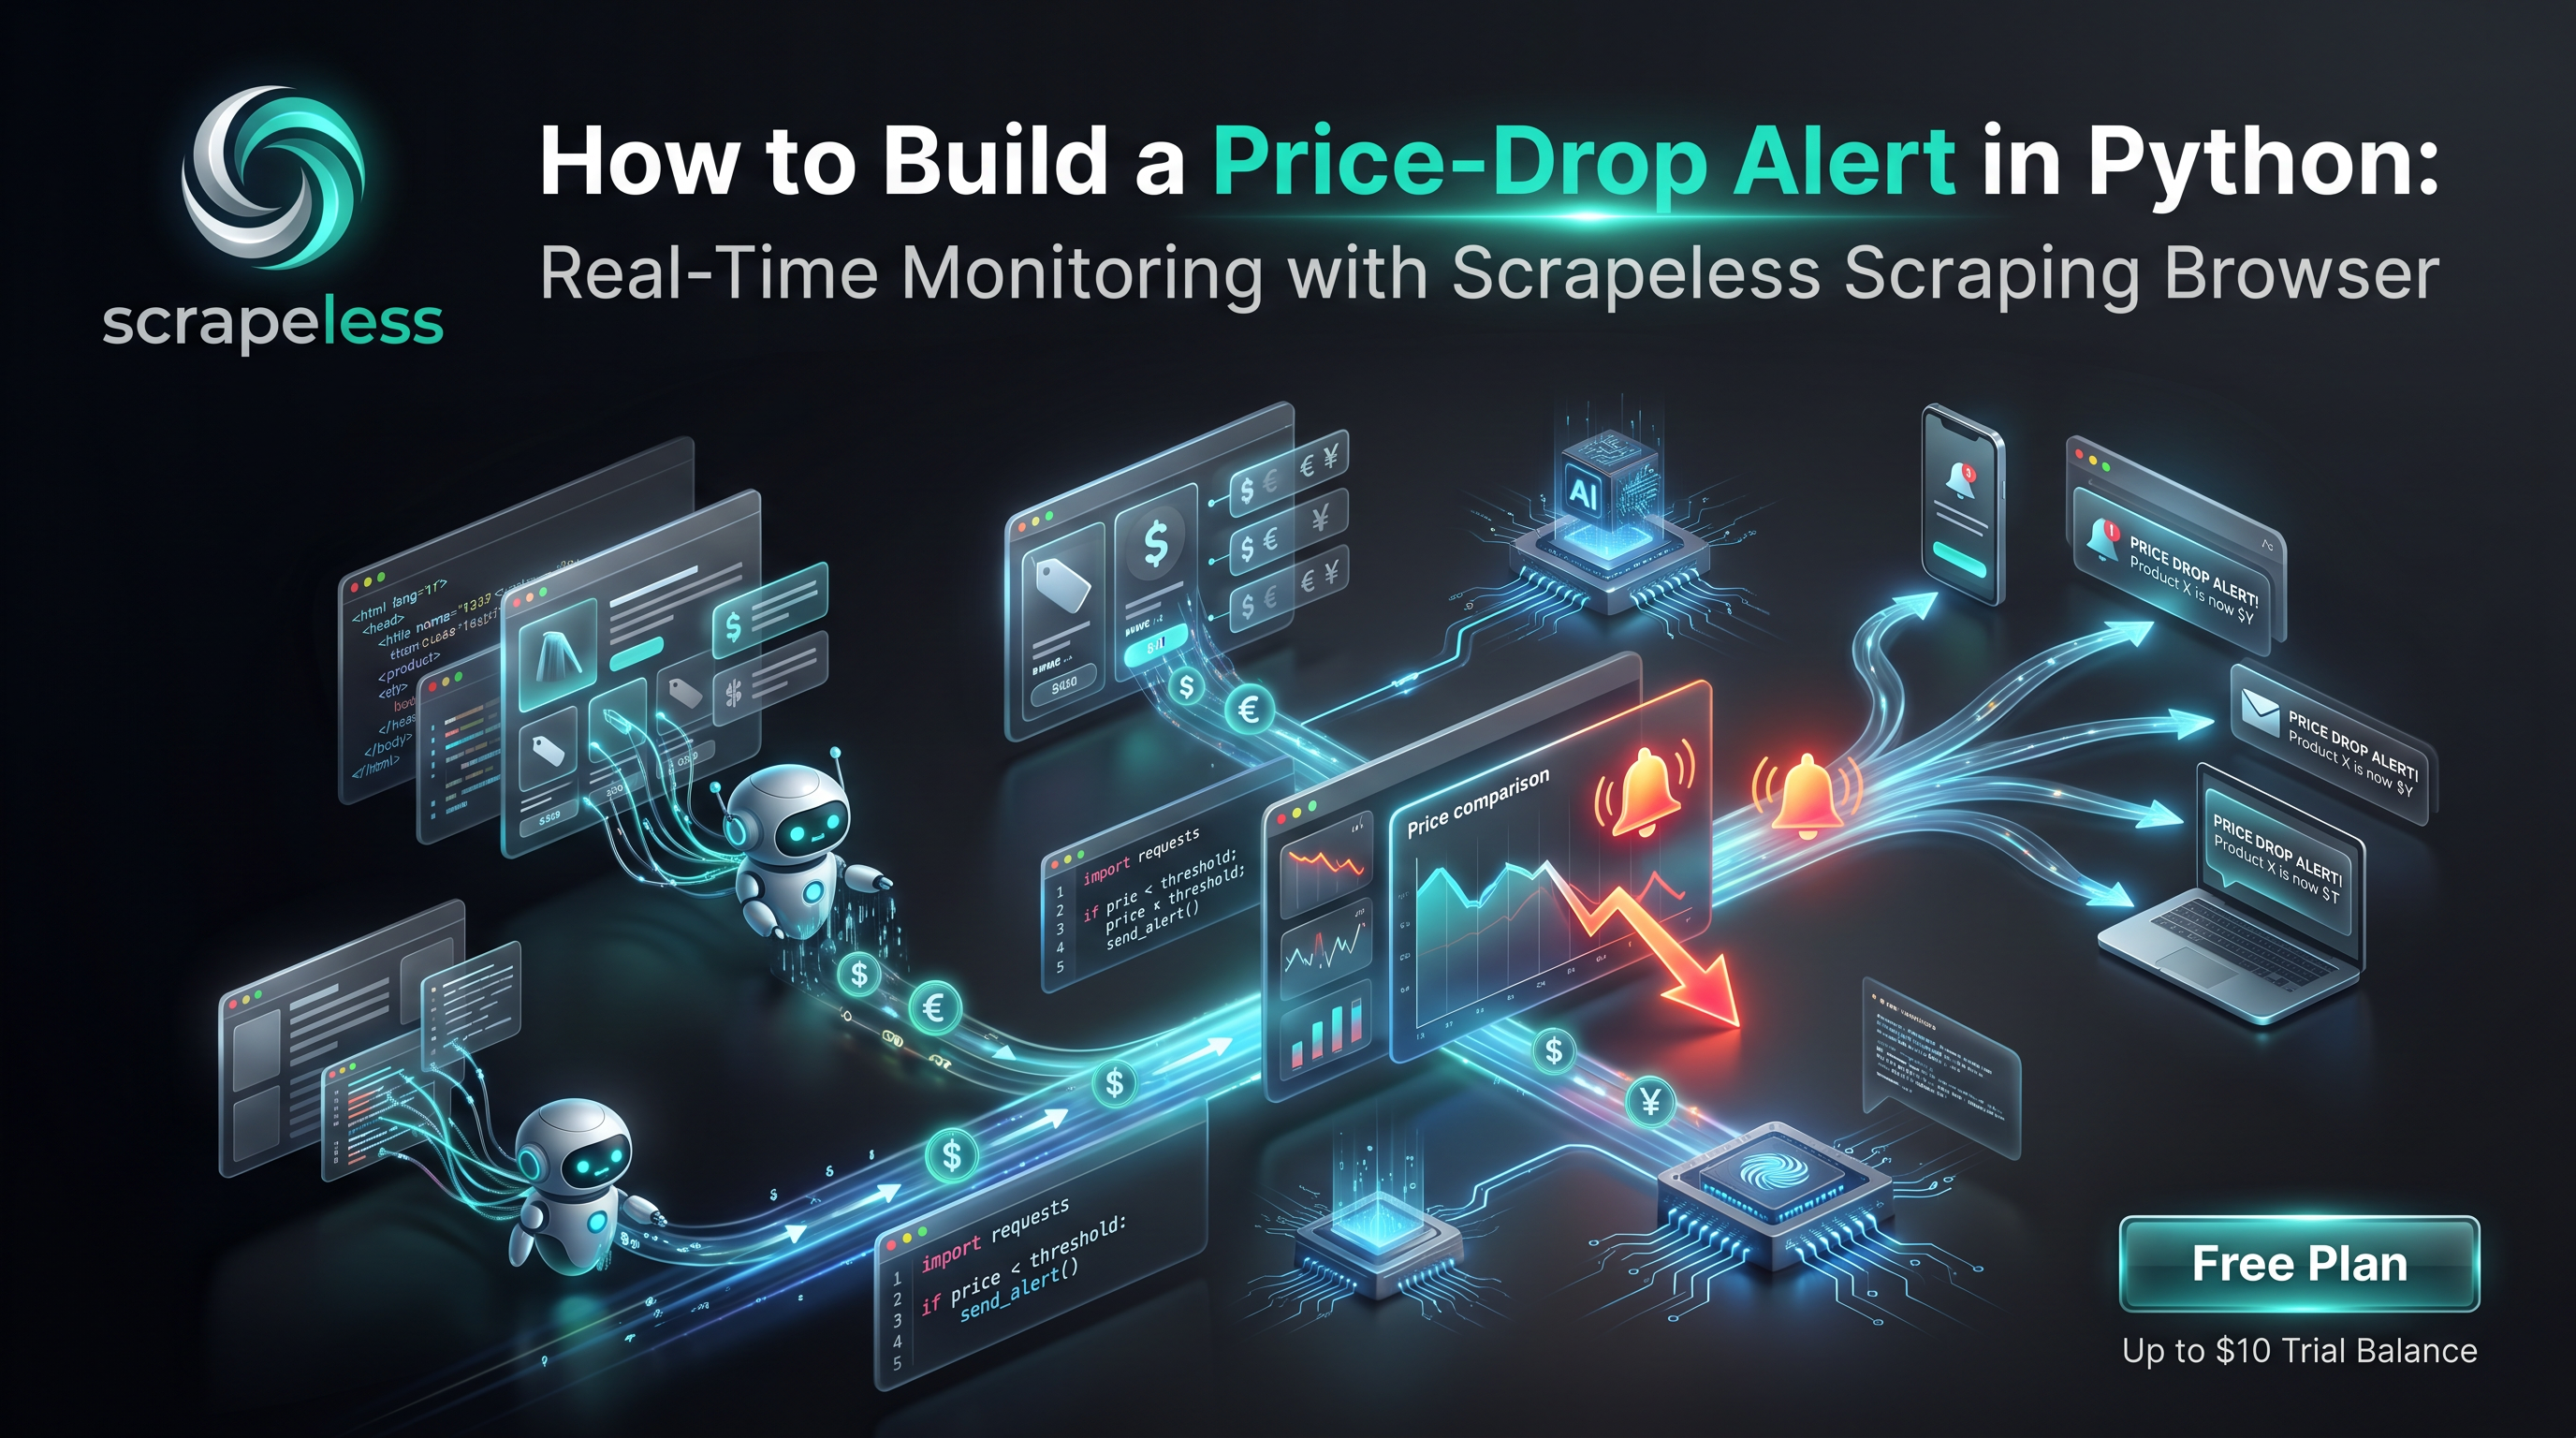
कैसे पायथन में मूल्य-गिरावट चेतावनी बनाएं: स्क्रैपलेस स्क्रैपिंग ब्राउज़र के साथ वास्तविक समय की निगरानी
Senior Web Scraping Engineer
मुख्य बातें:
- पहले रेंडर करें, फिर कीमत पढ़ें। आधुनिक खुदरा कीमतें क्लाइंट-साइड पर जावास्क्रिप्ट चलने के बाद पेंट की जाती हैं और क्षेत्र के अनुसार व्यक्तिगत होती हैं। एक वास्तविक रेंडर की गई पृष्ठ — न कि कच्चा HTTP फ़ेच — वह है जो एक शौक़ीन द्वारा देखी गई संख्या को लौटाता है। Scrapeless Scraping Browser उत्पाद पृष्ठ को एक एंटी-डिटेक्शन क्लाउड ब्राउज़र में रेंडर करता है और भरा हुआ DOM लौटाता है।
- प्रॉक्सी देश को जोड़ें, क्योंकि कीमत भूगोल का पालन करती है। कीमतें, मुद्रा और उपलब्धता क्षेत्र और IP प्रतिष्ठा के अनुसार बदलती हैं।
proxy_country="US"(या जिस बाजार की सतर्कता ट्रैक करता है) सेट करने से हर जांच उसी ईग्रेस पर बनी रहती है ताकि कीमतों का इतिहास तुलनीय हो सके। - कीमत का इतिहास सिर्फ एक अपेंड-केवल लॉग है। प्रत्येक जांच एक
{product, url, price, currency, checked_at}रिकॉर्ड लिखती है। सतर्कता लॉजिक एकल तुलना है: क्या नवीनतम कीमत पिछले निचले स्तर से कम है? यही संपूर्ण निर्णय है। - एक ड्रॉप एक वेबहुक को सक्रिय करता है। जब तुलना "कम" कहती है, तो एक-लाइन
requests.postएक Slack/Discord/ईमेल-रिले एंडपॉइंट पर सतर्कता भेजती है। कोई कतार नहीं, कोई ब्रोकर नहीं — एकल HTTP कॉल। - इसे शेड्यूल करें और चले जाएं। एक क्रोन प्रविष्टि, एक निर्धारित कार्य, या एक सर्वरलेस टाइमर चेक को एक आवृत्ति पर चलाता है। रेंडर → निकालें → तुलना → सतर्कता लूप इतना छोटा है कि इसे बिना देखे चलाया जा सके।
- ज्यादातर सार्वजनिक उत्पाद पृष्ठों पर काम करता है। यह वही लूप लगभग किसी भी उत्पाद पृष्ठ पर लागू होता है जो DOM में कीमत को रेंडर करता है — ईग्रेस को पिन करें, एक स्थिर मूल्य नोड पर एंकर करें, और तुलना का पुनः उपयोग करें।
- शुरू करने के लिए मुफ्त। नए Scrapeless खातों में मुफ्त Scraping Browser रनटाइम शामिल है — Scrapeless वेबसाइट पर साइन अप करें।
परिचय: खुद उत्पाद पृष्ठ को फिर से न रिफ्रेश करें
कीमत ट्रैकिंग उन सबसे सामान्य कारणों में से एक है जिनकी वजह से लोग सार्वजनिक वेब को स्क्रैप करते हैं। डील शिकारियों को सबसे कम कीमत पर खरीदना होता है। मूल्य निर्धारण टीमों को उस क्षण का पता लगाना होता है जब कोई प्रतिकारी एक SKU को काटता है। खरीददारी को पुनः स्टॉक से पहले जानकारी चाहिए होती है। काम हमेशा एक ही आकार का होता है: एक उत्पाद पृष्ठ पर नज़र रखना, जब संख्या कम होती है तो नोटिस करना, और किसी को बताना।
रुकावट यह है कि एक उत्पाद पृष्ठ अब एक स्थिर दस्तावेज़ नहीं है। खुदरा कैटलॉग क्लाइंट-साइड पर हाइड्रेट होते हैं: पृष्ठ एक पतली खोल के रूप में आता है, और कीमत, मुद्रा, बिक्री ध्वज, और उपलब्धता एक बार जावास्क्रिप्ट के चलने के बाद पेंट की जाती हैं। एक साधारण HTTP अनुरोध खोल लौटाता है, कीमत नहीं। संख्या भी क्षेत्रीय है — एक ही URL विभिन्न कीमतें, मुद्राएं, या स्टॉक स्थिति दिखा सकता है प्रति ईग्रेस IP — और कई साइटें स्वचालित अनुरोधों को एंटी-बॉट जांचों के पीछे गेट करती हैं जो HTTP 200 स्थिति के तहत एक चुनौती पृष्ठ लौटाती हैं। एक शुद्ध-HTTP पोलर जो परीक्षण में "कार्य करता है" चुपचाप कीमतों के बजाय चुनौती पृष्ठ लॉगिंग शुरू कर सकता है।
यह पोस्ट एक Python कार्यप्रवाह के माध्यम से जाता है जो Scrapeless Scraping Browser पर चलता है जो उन गैप्स को अंत से अंत तक बंद करता है: एक पिन किए गए US आवासीय ईग्रेस पर एक एंटी-डिटेक्शन क्लाउड ब्राउज़र में उत्पाद पृष्ठ को रेंडर करें, रेंडर की गई DOM से कीमत निकालें, इसे एक छोटे कीमत-इतिहास भंडार में जोड़ें, नवीनतम मूल्य की तुलना पिछले निम्न से करें, और जब कीमत गिरती है तो एक वेबहुक सक्रिय करें। एक शेड्यूलर लूप को एक आवृत्ति पर चलाता है। वही रेंडर प्राइमिटिव स्थानीयकृत खुदरा मूल्य निर्धारण के लिए उपकरण की तुलना को शक्ति देता है जैसे कि 2026 में सर्वश्रेष्ठ Zillow स्क्रैपर्स।
आप इससे क्या कर सकते हैं
- व्यक्तिगत डील सतर्कता। उत्पादों की एक इच्छा सूची को देखें और जिस क्षण इनमें से कोई भी एक लक्षित कीमत से कम हो जाए, आपको सूचित करें।
- प्रतिस्पर्धात्मक मूल्य निगरानी। मूल्य निर्धारण टीमें प्रतिकारी SKUs को एक चलने वाली आवृत्ति पर ट्रैक करती हैं और घंटों के भीतर कटौती पर प्रतिक्रिया करती हैं।
- पुनः स्टॉक और उपलब्धता की निगरानी। मूल्य पठन को उपलब्धता पठन के साथ जोड़ें ताकि "पुनः स्टॉक में" और "अब सस्ता" दोनों पर सूचित किया जा सके।
- MAP-शैली का ड्रिफ्ट डिटेक्शन। ब्रांड मालिक फ्लैग करते हैं जब एक ट्रैक की गई लिस्टिंग अपेक्षित फर्श से नीचे गिर जाती है विभिन्न क्षेत्रों में।
- खरीद-समय खरीददारी के लिए। बिक्री आदेश को प्रतिबद्ध करने से पहले सप्ताहों के दौरान कीमतों का इतिहास लॉग करें ताकि एक उत्पाद की छूटों की धारा का पता लगाया जा सके।
- ऐतिहासिक मूल्य डेटा सेट। अपेंड-केवल लॉग चार्ट, प्रवृत्ति विश्लेषण, या मॉडल इनपुट के लिए एक साफ समय श्रृंखला के रूप में भी कार्य करता है।
Scrapeless में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा तक पहुँचते हैं जबकि लागू कानूनों, विनियमों और वेबसाइट की गोपनीयता नीतियों का कड़ाई से पालन करते हैं। इस पोस्ट में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है।
Scrapeless Scraping Browser क्यों
Scrapeless Scraping Browser एक अनुकूलन योग्य, एंटी-डिटेक्शन क्लाउड ब्राउज़र है जिसे वेब क्रॉसलर्स और AI एजेंटों के लिए डिज़ाइन किया गया है। विशेष रूप से कीमत-गिरने की सतर्कता के लिए, यह लाता है:
- 195+ देशों में आवासीय प्रॉक्सी, ताकि सतर्कता अपने ईग्रेस को उस बाजार पर पिन कर सके जिसे यह ट्रैक करता है — कीमतें, मुद्रा और उपलब्धता भूगोल का अनुसरण करती हैं, और एक निश्चित
proxy_countryहर जांच को तुलनात्मक रखता है। - क्लाउड-साइड जावास्क्रिप्ट रेंडरिंग, ताकि कीमत, बिक्री ध्वज, मुद्रा प्रतीक, और स्टॉक स्थिति DOM में भरा हुआ आ जाए, न कि खाली React खोल के रूप में।
- एंटी-डिटेक्शन फिंगरप्रिंटिंग हर सत्र में, ताकि उत्पाद पृष्ठ वही दृश्य दिखाए जो यह जैविक ट्रैफ़िक दिखाता है — जिसमें असली कीमत ग्रिड शामिल है, इसके बजाय एक चुनौती पृष्ठ जो HTTP 200 स्थिति के तहत सेवा दी जाती है।
- सत्र स्थिरता नेविगेशन के दौरान, ताकि एक जांच जो उत्पाद पृष्ठ पर उतरने से पहले होमपेज को गर्म करती है, कुकीज़ और स्थिति को एक रन में समान बनाए रखती है।
- एक साफ CDP एंडपॉइंट जिसे Puppeteer या Playwright सीधे चलाता है — CDP पर कनेक्ट करें और क्लाउड ब्राउज़र बाकी का काम करता है।
अपना API कुंजी मुफ्त योजना पर प्राप्त करें app.scrapeless.com। स्क्रैपिंग ब्राउज़र उत्पाद पृष्ठ रनटाइम को कवर करता है, और प्रॉक्सी समाधान इसे समर्थित आवासीय एग्रस को कवर करता है।
पूर्वापेक्षाएँ
- Python 3.10 या नया।
- एक Scrapeless खाता और API कुंजी — Scrapeless वेबसाइट पर साइन अप करें। SDK इसे
SCRAPELESS_API_KEYपर्यावरण चर से पढ़ता है। - Playwright for Python, जो CDP पर क्लाउड ब्राउज़र चलाता है। कनेक्शन विवरण और पुस्तकालय मार्गदर्शिका docs.scrapeless.com पर।
- टर्मिनल के साथ बुनियादी परिचितता और अलर्ट प्राप्त करने के लिए एक वेबहुक URL (Slack, Discord, या कोई भी ईमेल रिले)।
स्थापित करें
CDP के माध्यम से क्लाउड ब्राउज़र चलाने के लिए Playwright और वेबहुक कॉल के लिए requests स्थापित करें:
bash
pip install playwright requestsअपनी API कुंजी सेट करें ताकि यह कनेक्शन URL के साथ काम कर सके:
bash
export SCRAPELESS_API_KEY=your_api_token_hereयह पूर्ण सेटअप है। Playwright का connect_over_cdp Scrapeless स्क्रैपिंग ब्राउज़र एंडपॉइंट से कनेक्ट करता है और एक असली ब्राउज़र संचालित करता है जो Scrapeless क्लाउड में चलता है — स्थानीय Chromium डाउनलोड की आवश्यकता नहीं है, क्योंकि रेंडरिंग क्लाउड-साइड होती है।
चरण 1 — क्लाउड-ब्राउज़र कनेक्शन URL बनाएँ
Scrapeless स्क्रैपिंग ब्राउज़र एक CDP एंडपॉइंट है। अपने API कुंजी को token के रूप में और एग्रस मार्केट को proxyCountry के रूप में शामिल करते हुए WebSocket URL बनाएं; Playwright सीधे इससे कनेक्ट करता है।
python
import os
from urllib.parse import urlencode
from playwright.sync_api import sync_playwright

def scraping_browser_url(proxy_country: str = "US", session_ttl: int = 240) -> str:
    # API कुंजी URL पर `token` के रूप में चलती है; एग्रस और लाइफटाइम क्वेरी पैरामीटर हैं।
    params = urlencode({
        "token": os.environ["SCRAPELESS_API_KEY"],
        "sessionTTL": session_ttl,
        "proxyCountry": proxy_country,
    })
    return f"wss://browser.scrapeless.com/api/v2/browser?{params}"
proxyCountry एक मूल्य निगरानी के लिए लोड-बेयरिंग ध्वज है: वही उत्पाद URL एक क्षेत्र के अनुसार एक अलग कीमत, मुद्रा, या उपलब्धता स्थिति दिखा सकता है, इसलिए एग्रस को स्थिर रखना हर रिकॉर्ड की गई कीमत को एक ही बाजार पर बनाए रखता है। sessionTTL में सेकंडों में सत्र का जीवनकाल होता है — इसे इतना लंबा रखें कि पृष्ठ रेंडर हो सके और कीमत पढ़ी जा सके।
चरण 2 — उत्पाद पृष्ठ को रेंडर करें और कीमत पढ़ें
CDP क्लाइंट को सत्र से कनेक्ट करें, उत्पाद पृष्ठ को रेंडर करें, और भरे हुए DOM से कीमत को निकालें। एक अमेरिकी आवासीय Scrapeless सत्र के माध्यम से Walmart खोज URL की लाइव रेंडरिंग HTTP 200 के साथ असली उत्पाद ग्रिड लौटाती है — शीर्षक लैपटॉप - Walmart.com के रूप में हल होता है और पृष्ठ उत्पाद लिंक को प्रदर्शित करता है जो इस रूप में होते हैं https://www.walmart.com/ip/<slug>/<id>। वे /ip/ पृष्ठ मूल्य निगरानी के लिए प्रति-उत्पाद लक्ष्यों के रूप में होते हैं। नीचे दिया गया उदाहरण एक ऐसे उत्पाद पृष्ठ को ट्रैक करता है।
उत्पाद URL सीधे रेंडर किया जाता है। उन साइटों के लिए एक रक्षात्मक उपाय के रूप में जो एक ठंडी अनुरोध को गहरे URL पर एंटी-बॉट चेक के पीछे रोकते हैं, उदाहरण पहले साइट के होमपेज पर सत्र को गर्म करता है, फिर उसी सत्र में उत्पाद URL पर नेविगेट करता है — जब आवश्यक नहीं हो तब हानिरहित, और जब आवश्यक हो तब उपयोगी।
python
PRODUCT = "उदाहरण 15-इंच लैपटॉप"
URL = "https://www.walmart.com/ip/example-15-inch-laptop/123456789"

def read_price(url: str) -> dict:
    # Playwright के साथ CDP के माध्यम से Scrapeless स्क्रैपिंग ब्राउज़र चलाएँ।
    with sync_playwright() as p:
        browser = p.chromium.connect_over_cdp(scraping_browser_url("US"))
        page = browser.new_page()

        # पहले होमपेज पर सत्र को गर्म करें, फिर उत्पाद पृष्ठ पर उतरें
        # ताकि कीमत ग्रिड रेंडर हो सके।
        page.goto("https://www.walmart.com/", wait_until="domcontentloaded")
        page.wait_for_timeout(2500)
        page.goto(url, wait_until="domcontentloaded")
        page.wait_for_timeout(3000)   # कीमत नोड को हाइड्रेट होने दें

        # एक स्थिर कीमत नोड पर एंकर करें। खुदरा विक्रेता हैश किए गए क्लास नाम बदलते हैं,
        # इसलिए व्याख्यात्मक एंकर (itemprop, data-testid, aria-label) पसंद करें।
        price_node = page.query_selector('[itemprop="price"], [data-testid="price-wrap"]')
        price_text = price_node.inner_text() if price_node else ""
        browser.close()

    # "$1,299.00" को 1299.0 में सामान्य करें
डिजिट = "".जोड़ें(ch के लिए ch in price_text यदि ch.isdigit() या ch == ".")
मूल्य = बहु(float)(डिजिट) यदि डिजिट अन्यथा None
वापस {"उत्पाद": PRODUCT, "url": url, "मूल्य": मूल्य, "मुद्रा": "USD"}
रेंडर उस DOM को लौटाता है जिसे कार्बनिक ट्रैफ़िक देखता है, इसलिए मूल्य नोड जीवित, क्षेत्र-सही संख्या वहन करता है। एक संवेदनात्मक चयनकर्ता (`itemprop`, `data-testid`, `aria-label`) पर एंकर करें बजाय एक 해श किए हुए वर्ग नाम के — वर्ग नाम तैनाती के दौरान घूमते हैं, संवेदनात्मक एंकर नहीं। यदि एक पृष्ठ डॉलर और सेंट को अलग-अलग नोड्स में विभाजित करता है, तो दोनों को पढ़ें और सामान्यीकरण से पहले उन्हें जोड़ें।

> आपकी एपीआई कुंजी मुफ्त योजना पर प्राप्त करें: [Scrapeless वेबसाइट](https://app.scrapeless.com/passport/login/?utm_source=website&utm_medium=blog&utm_campaign=scrapingbrowser&utm_term=PriceDropAlert)

---

## चरण 3 — मूल्य इतिहास संग्रहीत करें

मूल्य इतिहास एक केवल-परिशिष्ट पंजीकरण है। प्रत्येक जांच एक रिकॉर्ड लिखती है; फ़ाइल चरण 4 में तुलना के लिए सत्य का स्रोत है। एक न्यूलाइन-सीमांकित JSON फ़ाइल (JSONL) इसे केवल-परिशिष्ट रखती है और वापस पढ़ने में तुच्छ बनाती है:

```python
आयात json
से datetime आयात datetime, timezone

HISTORY_FILE = "price_history.jsonl"

def append_history(record: dict) -> dict:
    रिकॉर्ड = {
        **रिकॉर्ड,
        # एक पठनीय UTC स्टैम्प; यदि एक सख्त समय श्रृंखला की आवश्यकता हो तो Unix युग के लिए स्वैप करें।
        "checked_at": datetime.now(timezone.utc).strftime("%d-%b-%Y %H:%M UTC"),
    }
    के साथ open(HISTORY_FILE, "a", encoding="utf-8") जैसा f:
        f.write(json.dumps(record) + "\n")
    वापस रिकॉर्ड

def load_history(url: str) -> list[dict]:
    पंक्तियाँ = []
    कोशिश करें:
        के साथ open(HISTORY_FILE, encoding="utf-8") जैसा f:
            के लिए line in f:
                row = json.loads(line)
                यदि row.get("url") == url:
                    rows.append(row)
    except FileNotFoundError:
        पास
    वापस पंक्तियाँ
प्रत्येक रिकॉर्ड सामान्य {product, url, price, currency, checked_at} आकृति है। checked_at एक UTC ISO टाइमस्टैम्प है जो पढ़ने के समय लिखा गया है, इसलिए प्रत्येक प्रविष्टि आत्म-विवरणात्मक है। कई उत्पादों के लिए, JSONL फ़ाइल को SQLite तालिका या किसी भी डेटाबेस के लिए स्वैप करें — स्कीमा समान है, और तुलना तर्क नहीं बदलता है।
चरण 4 — पिछले निम्नतम के खिलाफ तुलना करें और निर्णय लें
अलर्ट निर्णय एकल तुलना है: क्या नवीनतम मूल्य इस URL के लिए अब तक देखे गए निम्नतम मूल्य से नीचे है? पूर्व का इतिहास खींचें, पूर्व के न्यूनतम को खोजें, और तुलना करें।
python
def is_price_drop(url: str, current: float) -> dict:
    prior = [r["price"] for r in load_history(url) if r.get("price") is not None]
    previous_low = min(prior) यदि prior अन्यथा None

    गिरा हुआ = (
        current is not None
        और previous_low is not None
        और current < previous_low
    )
    वापस {
        "गिरा": गिरा हुआ,
        "वर्तमान": वर्तमान,
        "पूर्व_न्यूनतम": previous_low,
        "delta": (current - previous_low) यदि गिरा हुआ अन्यथा None,
    }
एक उत्पाद की पहली बार जांच करने पर कोई पूर्व इतिहास नहीं होता है, इसलिए previous_low None होता है और कोई अलर्ट नहीं चलता है — रन लॉग को बीज देता है। दूसरी जांच के बाद, कोई भी मूल्य जो चलने वाले निम्नतम से स्पष्टता से नीचे है वह एक गिरावट है। किसी लक्षित मूल्य के खिलाफ अलार्म देने के लिए, current की तुलना एक निश्चित थ्रेशोल्ड से करें; पिछले रिकॉर्ड के खिलाफ तुलना करने के लिए पिछले जांच के खिलाफ, पिछले न्यूनतम के बजाय तुलना करें। स्टोर और रेंडर चरण वही रहते हैं चाहे कोई भी नियम फायर हो।
चरण 5 — गिरावट पर एक वेबहुक फायर करें
जब तुलना "गिर गई" कहती है, तो अलर्ट भेजें। एक वेबहुक सबसे सरल वितरण पथ है — एक एकल requests.post Slack, Discord, या ईमेल-रिले अंत बिंदु पर। कोई दलाल, कोई कतार नहीं।
python
आयात requests

WEBHOOK_URL = os.environ["PRICE_ALERT_WEBHOOK"]  # Slack / Discord / रिले URL

def send_alert(record: dict, decision: dict) -> None:
    संदेश = (
        f"मूल्य में गिरावट: {record['product']}\n"
        f"अब {record['currency']} {decision['current']:.2f} "
        f"(था {decision['previous_low']:.2f}, "
        f"में गिरावट {abs(decision['delta']):.2f})\n"
        f"{record['url']}"
    )
    प्रतिक्रिया = requests.post(WEBHOOK_URL, json={"text": message}, timeout=15)
    प्रतिक्रिया.raise_for_status()
raise_for_status() एक गैर-2xx प्रतिक्रिया को वेबहुक से सामने लाता है ताकि एक गलत कॉन्फ़िगर किया गया अंत बिंदु जोरदार तरीके से विफल हो जाए बजाय चुपचाप अलर्ट को गिराने के। {"text": message} शरीर स्लैक और डिस्कोर्ड इनकमिंग-वेबहुक प्रारूपों के साथ मेल खाता है; प्राप्त करने वाले अंत बिंदु की अपेक्षाओं के अनुसार JSON आकार को समायोजित करें।
पाँच चरणों को एक जांच में जोड़ना:
python
def check_once():
    reading = read_price(URL)                  # चरण 2: रेंडर + निकालें
    record = append_history(reading)           # चरण 3: स्टोर
    decision = is_price_drop(URL, record["price"])  # चरण 4: तुलना
    यदि निर्णय["गिरा"]:
        send_alert(record, decision)           # चरण 5: अलार्म
    वापस रिकॉर्ड, निर्णय
चरण 6 — जांच का कार्यक्रम बनाएं
लूप इतना छोटा है कि इसे किसी भी शेड्यूलर पर बिना रुकावट के चलाया जा सकता है। अधिकांश डील वॉच के लिए दैनिक जांच पर्याप्त है; प्रतिस्पर्धात्मक निगरानी हर घंटे चल सकती है। प्रत्येक रन के अंदर एक नया सत्र बनाएं ताकि आउटगोइंग डेटा साफ-सुथरा बना रहे।
लिनक्स या macOS पर, एक क्रोन एंट्री स्क्रिप्ट को दिन में एक बार 09:00 बजे चलाती है:
bash
# crontab -e
0 9 * * * cd /opt/price-watch && /usr/bin/python3 check.py >> watch.log 2>&1
विंडोज पर, वही कमांड टास्क शेड्यूलर के साथ पंजीकृत करें। एक सर्वरलेस टाइमर (एक शेड्यूल किया गया क्लाउड फ़ंक्शन) समान रूप से अच्छा काम करता है - स्क्रिप्ट के पास इतिहास फ़ाइल के अलावा कोई दीर्घकालिक स्थिति नहीं है, इसलिए यह एक बिना राज्य की इनवोकेशन के लिए उपयुक्त है। कई उत्पादों की वॉचलिस्ट के लिए, यूआरएल के माध्यम से लूप करें और समांतरता को संयमित रखें - प्रति होस्ट लगभग तीन समानांतर रेंडर एक उचित सीमा है - ताकि आउटगोइंग डेटा अनियंत्रित न हो।
python
WATCHLIST = [
    "https://www.walmart.com/ip/example-15-inch-laptop/123456789",
    "https://www.walmart.com/ip/example-wireless-headphones/987654321",
]

def run_watchlist():
    for url in WATCHLIST:
        reading = read_price(url)              # प्रत्येक पढ़ाई नवीनतम कनेक्शन, अमेरिका का आउटगोइंग
        record = append_history(reading)
        decision = is_price_drop(url, record["price"])
        if decision["dropped"]:
            send_alert(record, decision)
आपको क्या मिलेगा
प्रत्येक जांच एक रिकॉर्ड को इतिहास लॉग में जोड़ती है। आकार मानक मूल्य-देखने वाले रिकॉर्ड का है:
json
// स्कीमा ठीक उसी चीज़ को दर्शाता है जो append_history लिखता है।
// फ़ील्ड मान चित्रात्मक नमूने हैं, किसी उत्पाद की वास्तविक पठन नहीं।
{
  "product": "Example 15-inch Laptop",
  "url": "https://www.walmart.com/ip/example-15-inch-laptop/123456789",
  "price": 1299.00,
  "currency": "USD",
  "checked_at": "25-May-2026 09:00 UTC"
}
समय के साथ लॉग एक साफ मूल्य समय श्रृंखला बन जाता है - प्रत्येक जांच के लिए एक लाइन, चार्ट में तैयार करने या एक ट्रेंड मॉडल को फीड देने के लिए। इस आउटपुट के बारे में कुछ ईमानदार अवलोकन, масштаб पर चलाने से पहले जानना उचित है:
- भूगोल संख्या को संचालित करता है। दर्ज की गई मूल्य केवल उस आउटगोइंग की सापेक्ष मूल्यवान है जिस पर इसे पढ़ा गया था। एक निश्चित वॉच के लिए
proxy_countryको स्थिर रखें; यदि आप विभिन्न बाजारों में कीमतों की तुलना करते हैं, तो प्रत्येक रिकॉर्ड के साथ देश को संग्रहीत करें। - सिलेक्टर स्थिरता।
itemprop,data-testid, याaria-labelनोड्स पर आधारित रहें। हैशेड क्लास नाम डिप्लॉयमेंट के दौरान बदलते हैं और चुपचापNoneलौटाना शुरू कर सकते हैं - जब कोई मूल्य पार्सिंग बंद हो जाता है, तो रेंडर की गई DOM का फिर से निरीक्षण करें और अंकर को कड़ा करें। - मूल्य नोड्स को विभाजित करें। कुछ पृष्ठ डॉलर और सेंट (या मुद्रा प्रतीक और राशि) को अलग-अलग तत्वों में रेंडर करते हैं। प्रत्येक को पढ़ें और सामान्यीकरण से पहले उन्हें जोड़ें, अन्यथा पार्स किया गया संख्या गलत होगी।
- स्थिति कोड मूल्य नहीं है। एक पृष्ठ HTTP 200 वापस कर सकता है और फिर भी चुनौती या इंटर्स्टिशियल हो सकता है। यह सुनिश्चित करने के लिए कि मूल्य नोड मौजूद है और पार्स करता है, केवल यह सुनिश्चित करने के बजाय कि अनुरोध सफल हुआ है, एक वास्तविक पढ़ाई की पुष्टि करें।
- नल मूल्य। एक गायब मूल्य को
Noneके रूप में मानें न कि शून्य के रूप में। चरण 4 में तुलना पहले से हीNoneपढ़ाई को छोड़ देती है, इसलिए एक occasional अनपार्सेबल पृष्ठ कोई झूठा अलर्ट उत्पन्न नहीं करता है।
निष्कर्ष: पांच मूव में एक मूल्य वॉच
पूरी पाइपलाइन पांच मूव्स में घटित होती है: उत्पाद पृष्ठ को एक एंटी-डिटेक्शन क्लाउड ब्राउज़र में रेंडर करें, आबाद DOM से मूल्य निकालें, इसे एक इतिहास लॉग में जोड़ें, पिछले निम्न के खिलाफ तुलना करें, और गिरावट पर एक वेबहुक फायर करें - एक शेड्यूलर लूप को एक लय पर चलाना। क्योंकि रेंडर स्टेप वही दृश्य लौटाता है जो जैविक ट्रैफ़िक देखता है, रिकॉर्ड की गई मूल्य वह क्षेत्र-सही संख्या है जो खरीदार वास्तव में चुकाएगा।
अन्य खुदरा विक्रेताओं के लिए वॉच को बढ़ाने के लिए, वही लूप फिर से उपयोग करें: सही बाजार के लिए आउटगोइंग को पिन करें, उस साइट के लिए एक स्थिर मूल्य नोड पर अंकर करें, और तुलना को बिना छेड़े रखें। विशेष खुदरा विक्रेता रेंडर और सिलेक्टर पैटर्न सर्वश्रेष्ठ अमेज़न स्क्रैपर्स राउंडअप और 2026 में सबसे अच्छे ज़िलो स्क्रैपर्स में सीधे चरण 2 में शामिल होते हैं। प्रॉक्सी देश को पिन करें, सेमांटिक सिलेक्टर्स पर अंकर करें, अनुपस्थित मूल्यों को नल के रूप में मानें, और प्रति होस्ट संयमित रखें।
आपके एआई-पावर्ड डेटा पाइपलाइन को बनाने के लिए तैयार हैं?
हमारे समुदाय में शामिल हों ताकि फ़्री प्लान का दावा कर सकें और मूल्य-मॉनिटरिंग पाइपलाइनों का निर्माण कर रहे विकासकर्ताओं से जुड़ सकें: डिस्कॉर्ड · टेलीग्राम।
Scrapeless वेबसाइट पर साइन अप करें ताकि आपको मुफ्त स्क्रैपिंग ब्राउज़र रनटाइम मिल सके और ऊपर दिए गए पैटर्न को उन उत्पादों और क्षेत्रों के लिए अनुकूलित कर सकें जिनकी पाइपलाइन को आवश्यकता है। मूल्य निर्धारण के लिए योजना विवरण देखें।
अक्सर पूछे जाने वाले प्रश्न
प्रश्न 1: क्या एक मूल्य गिरने की अलर्ट बनाना कानूनी है?
Here is the Hindi translation of the text you provided:
सार्वजनिक रूप से दृश्य कीमतों का ट्रैकिंग एक सामान्य और व्यापक रूप से प्रचलित गतिविधि है, लेकिन नियम क्षेत्राधिकार और प्रत्येक साइट की सेवा की शर्तों द्वारा भिन्न होते हैं। लक्षित साइट की शर्तें पढ़ें, केवल सार्वजनिक रूप से उपलब्ध डेटा को स्क्रैप करें, व्यक्तिगत जानकारी इकट्ठा करने से बचें, और अपने विशेष उपयोग के मामले के लिए कानूनी सलाह लें। स्क्रैपलेस केवल सार्वजनिक रूप से उपलब्ध डेटा तक पहुँचता है जबकि लागू कानूनों और वेबसाइट की गोपनीयता नीतियों का पालन करता है।
प्रश्न 2: क्या मुझे एक प्रॉक्सी की आवश्यकता है, और क्या देश मायने रखता है?
दोनों मामलों में हाँ। कीमतें, मुद्रा, और उपलब्धता क्षेत्र और आईपी प्रतिष्ठा द्वारा बदलती हैं, इसलिए एक आवासीय बाहर निकलना आवश्यक है और देश का भार उठाना महत्वपूर्ण है। proxy_country को उस बाजार पर पिन करें जिसे सूचना ट्रैक करती है - यहाँ के उदाहरणों में "US" - ताकि हर दर्ज की गई कीमत समान की तुलना में हो। विभिन्न बाजारों में एक उत्पाद की निगरानी करने के लिए, प्रत्येक देश के लिए एक निगरानी चलाएँ और प्रत्येक कीमत के साथ देश को संग्रहीत करें।
प्रश्न 3: सिर्फ एक एचटीटीपी अनुरोध क्यों न भेजें और कीमत को पार्स करें?
ज़्यादातर खुदरा कीमतों को ग्राहक-पक्ष पर उस समय रंगा जाता है जब जावास्क्रिप्ट चलता है, इसलिए एक कच्चा एचटीटीपी फेच एक खाली खोल लौटाता है, संख्या नहीं। कई साइटें स्वचालित अनुरोधों के तहत एचटीटीपी 200 स्थिति के तहत एक एंटी-बॉट चुनौती पृष्ठ भी प्रस्तुत करती हैं। एक एंटी-डिटेक्शन क्लाउड ब्राउज़र में पृष्ठ को रेंडर करना वही जनसंख्या वाला डोम लौटाता है जो जैविक ट्रैफ़िक देखता है, जिसमें वास्तविक मूल्य नोड शामिल है।
प्रश्न 4: मैं कैसे पुष्टि कर सकता हूँ कि एक पढ़ाई एक वास्तविक कीमत है और एक चुनौती पृष्ठ नहीं है?
यह जाँचें कि मूल्य नोड मौजूद है और संख्या में पार्स करता है, केवल यह नहीं कि अनुरोध ने एचटीटीपी 200 लौटाया। तुलना लॉजिक एक अनुपस्थित या अव्याख्यायित मूल्य को None के रूप में मानता है और कोई अलर्ट नहीं देता, इसलिए कभी-कभी आने वाले अंतराल से गलत गिरावट नहीं होती है। जब एक मूल्य लगातार पार्स करने में विफल होता है, तो रेंडर किए गए डोम को फिर से जांचें और चयनकर्ता को कसें।
प्रश्न 5: चेक कितनी बार चलाना चाहिए, और यह कितने उत्पादों की निगरानी कर सकता है?
एक दैनिक चेक अधिकांश डील वॉच के लिए उपयुक्त है; प्रतिस्पर्धात्मक निगरानी हर घंटे चल सकती है। एक वॉच लिस्ट के लिए, एक निर्धारित रन के भीतर URLs के चारों ओर लूप करें और समवर्तीता को संयमित रखें - लगभग तीन समानांतर रेंडर प्रति होस्ट एक समझदारी की छत है - ताकि बाहर निकलना अच्छे व्यवहार में रहे। बड़े फैला पर होस्ट के बीच शार्द करें।
प्रश्न 6: क्या यह बिना एक एआई एजेंट के चल सकता है?
हाँ। चरण 1-6 में पायथन स्क्रिप्ट अपने आप अंत से अंत तक चलती है - कनेक्ट, रेंडर, निकालना, संग्रहीत करना, तुलना करना, अलर्ट करना, निर्धारित करना। एक एआई एजेंट रेंडर और चयनकर्ता चरणों को प्राकृतिक भाषा में संचालित करने का एक सुविधाजनक तरीका है, लेकिन यह वैकल्पिक है; Playwright और एक शेड्यूलर ही लूप को आवश्यकता है।
प्रश्न 7: कीमत एक साइट के पुनः डिज़ाइन के बाद पार्स करना बंद कर दी - क्या बदला?
साइट ने अपने वर्ग नामों को घुमाया। रेंडर किए गए डोम का फिर से निरीक्षण करें और एक संवेदनशील चयनकर्ता (itemprop, data-testid, aria-label) पर फिर से एंकर करें बजाय एक हैश किए गए वर्ग के। मूल्य को नल करने योग्य मानें ताकि पुनः डिज़ाइन कभी इतिहास लॉग में गलत संख्या न डाल सके।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





