
LangChain + Scrapeless: स्रोत-संदर्भित शोध सहायक बनाएँ
Expert in Web Scraping Technologies
TL;DR:
- LangChain और Scrapeless डॉक्यूमेंटेशन पेजों को स्रोत-उद्धृत उत्तर में बदल सकते हैं। यह उदाहरण Google पर खोज करता है, पेज बॉडीज़ पढ़ता है, अंश चुनता है, और स्रोत ID के साथ एक व्याख्या बनाता है।
- वर्कफ़्लो अंतिम उत्तर के साथ-साथ एकत्रित साक्ष्य को संजोकर रखता है। सर्च उम्मीदवार, पेज Markdown, और अंशों के ऑफ़सेट निरीक्षण के लिए उपलब्ध रहते हैं।
- स्पष्ट स्रोत URL नियंत्रित करते हैं कि कौन‑से पेज पढ़े जाएँ। Google Search फिर भी चलता है, लेकिन उसके उम्मीदवार दिए गए डॉक्यूमेंटेशन सेट से अलग रखे जाते हैं।
- उद्धरण जाँचें हर तकनीकी दावे को नहीं, बल्कि ID और संरचना को सत्यापित करती हैं। महत्त्वपूर्ण वाक्यों की तुलना संग्रहीत अंशों और मूल पेजों से करें।
What You Will Build
यह LangChain Scrapeless इंटीग्रेशन एक Python रिसर्च असिस्टेंट बनाता है जो यह प्रश्न का उत्तर देता है: “HTTP caching में Cache-Control और ETag एक‑साथ कैसे काम करते हैं?”
एक उपयोगी व्याख्या के लिए डॉक्यूमेंटेशन पेजों के भीतर के विवरण और उन्हें जाँचने का तरीका दोनों चाहिए। सर्च स्निपेट किसी पेज की पहचान कर सकते हैं, लेकिन वे किसी कैशिंग नियम के पीछे की आसपास की शर्तों को संरक्षित नहीं रखते। इसलिए असिस्टेंट चुने गए पेज पढ़ता है, उनका Markdown स्टोर करता है, और उत्तर‑निर्माण चरण को प्रासंगिक अंश पास करता है।
समाप्त रन answer.md लिखता है, जिसमें व्याख्या, तुलना तालिका, उदाहरण, सीमाएँ, और मूल स्रोत लिंक शामिल होते हैं। यह search-results.json, pages.json, और evidence.json भी सहेजता है। मिलकर, ये फ़ाइलें आपको यह जाँचने देती हैं कि उत्तर कैसे तैयार किया गया।
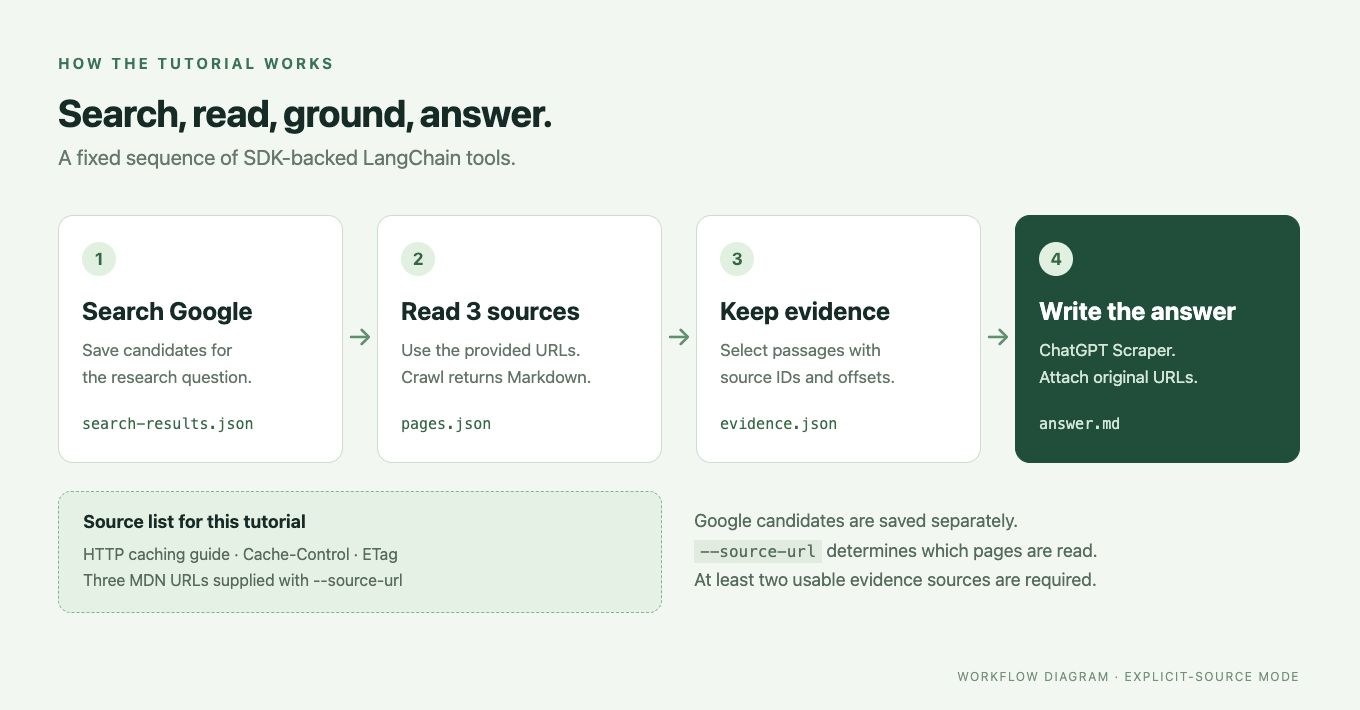
वर्कफ़्लो LangChain टूल्स का एक निश्चित अनुक्रम है। यह किसी स्वायत्त एजेंट से अपना अगला कदम चुनने के लिए नहीं कहता, और इस छोटे डॉक्यूमेंटेशन सेट के लिए इसे किसी वेक्टर डेटाबेस की ज़रूरत नहीं है।
How the Scrapeless Tools Fit Together
इंटीग्रेशन LangChain के .invoke() इंटरफ़ेस के माध्यम से सर्च, कलेक्शन, और उत्तर‑निर्माण को एक्सपोज़ करता है।
| Tool | रिसर्च असिस्टेंट में ज़िम्मेदारी |
|---|---|
ScrapelessDeepSerpGoogleSearchTool |
रिसर्च क्वेरी के लिए सर्च उम्मीदवार लाता है |
ScrapelessCrawlerScrapeTool |
चुने हुए पेज बॉडीज़ को Markdown के रूप में एकत्र करता है |
ScrapelessChatGPTScraperTool |
दिए गए प्रश्न और अंशों से उत्तर तैयार करता है |
Google Search API खोज परिणाम उपलब्ध कराती है। Scrapeless Crawl पेज की सामग्री उपलब्ध कराता है। ChatGPT Scraper Python SDK के माध्यम से उत्तर‑निर्माण चरण संभालता है। एक ही Scrapeless key इन सर्विस कॉल्स को कवर करती है; इस उदाहरण के लिए अलग मॉडल‑प्रोवाइडर key की आवश्यकता नहीं है।
ऐसे एजेंट के लिए जो टूल्स को डायनमिक रूप से चुनता है, LangGraph और Scrapeless MCP इंटीग्रेशन एक अलग आर्किटेक्चर को कवर करता है।
ये LangChain के tool interface को फ़ॉलो करने वाले callable टूल्स हैं। रिसर्च स्क्रिप्ट इनके चारों ओर स्रोत‑चयन नीति, आर्टिफ़ैक्ट फ़ाइलें, और उद्धरण जाँच जोड़ती है। वे एप्लिकेशन नियम हैं, आधारभूत मॉडल की स्वचालित गारंटी नहीं।
Prerequisites
Python 3.10 या बाद का वर्शन, Git, एक टर्मिनल, और एक Scrapeless API key का उपयोग करें, जिसमें Google Search, Crawl, और ChatGPT Scraper के लिए ऐक्सेस और उपलब्ध क्रेडिट हों।
यह ट्यूटोरियल langchain-scrapeless 0.1.4 और उसके पिन किए गए Scrapeless Python SDK 1.3.0 डिपेंडेंसी को लक्ष्य करता है। सोर्स चेकआउट की आवश्यकता है क्योंकि examples/research.py एक रेपो उदाहरण है; केवल wheel इंस्टॉल करने से वह उदाहरण आपकी वर्किंग डायरेक्टरी में नहीं बनता।
नोट: नीचे दिए गए सर्विस कमांड के लिए आपका अपना key और क्रेडिट चाहिए। यह लेख मूल प्रोजेक्ट के संरक्षित उदाहरण और लोकल पैकेज/टेस्ट रिव्यू का उपयोग करता है; यह किसी नए लाइव सर्च, Crawl कलेक्शन, या जेनरेटेड उत्तर का दावा नहीं करता। लोकल इनिशियलाइज़ेशन किसी ऑथेंटिकेशन या अकाउंट‑ऐक्सेस परीक्षण के बराबर नहीं है।
Scrapeless API key management के माध्यम से key प्राप्त करें। प्रश्नों और स्रोतों की संख्या बढ़ाने से पहले Scrapeless pricing की समीक्षा करें।
Step 1: Install the Package and Research Example
रिलीज़ किए गए पैकेज को एक आइसोलेटेड एनवायरनमेंट में इंस्टॉल करें और मिलते‑जुलते रिव्यू किए गए सोर्स उदाहरण का उपयोग करें।
आधिकारिक LangChain Scrapeless रिपॉज़िटरी में रिसर्च स्क्रिप्ट और इंटीग्रेशन इम्प्लीमेंटेशन शामिल हैं। macOS या Linux पर:
bash
git clone https://github.com/scrapeless-ai/langchain-scrapeless.git
cd langchain-scrapeless
git checkout 77f4724855e69d4dd5e636c1d3d3fe29f631fc96
python3 -m venv .venv
source .venv/bin/activate
python -m pip install "langchain-scrapeless==0.1.4"
python -m pip check
उसी शेल में कुंजी सेट करें। नीचे दिया गया मान एक प्लेसहोल्डर है, कोई क्रेडेंशियल नहीं:
bash
export SCRAPELESS_API_KEY="YOUR_SCRAPELESS_API_KEY"Windows PowerShell पर, py -3 -m venv .venv से वातावरण बनाएँ, .\.venv\Scripts\Activate.ps1 से उसे सक्रिय करें, और $env:SCRAPELESS_API_KEY = "YOUR_SCRAPELESS_API_KEY" का उपयोग करें। मल्टीलाइन कमांड को एक ही लाइन पर रखें या PowerShell कंटिन्युएशन सिंटैक्स का उपयोग करें।
स्थानीय टूल इनीशियलाइज़ेशन जाँचें:
bash
python examples/research.py checkयह जाँच तीनों टूल बनाती है और इंस्टॉल किए गए Scrapeless SDK संस्करण की रिपोर्ट करती है। यह कोई सेवा अनुरोध नहीं करती। सफल जाँच से पता चलता है कि इम्पोर्ट और स्थानीय कॉन्फ़िगरेशन काम कर रहे हैं; निम्न चरण API को उपयोग में लाते हैं।
Step 2: Choose the Question and Source Policy
सर्च चरण Google उम्मीदवारों को सहेजता है और कलेक्शन के लिए चुने गए पृष्ठों को स्थिर ID असाइन करता है।
नियंत्रित पहली रन के लिए, MDN कैशिंग गाइड और उसकी Cache-Control तथा ETag रेफ़रेंस दें। HTTP कैशिंग गाइड आस-पास के कैशिंग व्यवहार को समझाती है; ETag रेफ़रेंस उस वैलिडेटर का वर्णन करती है जिसका प्रश्न में उपयोग किया गया है।
नोट: यह कमांड Google Search को कॉल करता है और प्रीरेक्विज़िट्स में सूचीबद्ध सेवा एक्सेस की ज़रूरत होती है। यह ऑफ़लाइन उदाहरण नहीं है।
bash
python examples/research.py search --output-dir http-cache-research \
  --question "How do Cache-Control and ETag work together in HTTP caching?" \
  --query "HTTP caching Cache-Control ETag" \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control \
  --source-url https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag
http-cache-research/search-results.json खोलें। search_candidates में सर्च आउटपुट होता है; sources में चुना गया पेज सेट होता है। स्पष्ट URLs के साथ, स्रोत रिकॉर्ड origin: provided का उपयोग करते हैं। यह नियंत्रित सोर्स चयन है, यह दावा नहीं कि Google ने अपने आप इन्हीं पृष्ठों को चुना।
--source-url के बिना, स्क्रिप्ट कॉन्फ़िगर किए गए डोमेन से पात्र परिणाम चुनती है। डिफ़ॉल्ट developer.mozilla.org है। स्क्रिप्ट को कम से कम दो अलग-अलग पात्र URLs की ज़रूरत होती है और अधिकतम तीन ही रखती है। जब डॉक्यूमेंटेशन डोमेन बदलें, तो --domain को प्रश्न, क्वेरी और स्रोत URLs के साथ अपडेट करें।
नई सर्च के लिए नया आउटपुट डायरेक्टरी उपयोग करें। यदि किसी डायरेक्टरी में पहले से search-results.json मौजूद है, तो स्क्रिप्ट उसे अस्वीकार कर देती है, ताकि अलग-अलग रिसर्च प्रश्नों का गलती से मिश्रण न हो।
Step 3: Collect Page Bodies and Build Evidence
कलेक्शन चरण सहेजे गए URLs पढ़ता है और उनके पेज बॉडी से पैसेज निकालता है।
नोट: यह कमांड Scrapeless Crawl को कॉल करता है और इसके लिए पूरा हुआ सर्च चरण तथा आपका कॉन्फ़िगर किया हुआ API एक्सेस आवश्यक है।
bash
python examples/research.py scrape --output-dir http-cache-researchScrapelessCrawlerScrapeTool Markdown और मुख्य कंटेंट का अनुरोध करता है। स्क्रिप्ट रिटर्न हुए डॉक्यूमेंट्स को उनकी मूल स्रोत URLs से मैप करती है, फिर हर पेज की स्थिति, टेक्स्ट और मेटाडेटा pages.json में लिखती है।
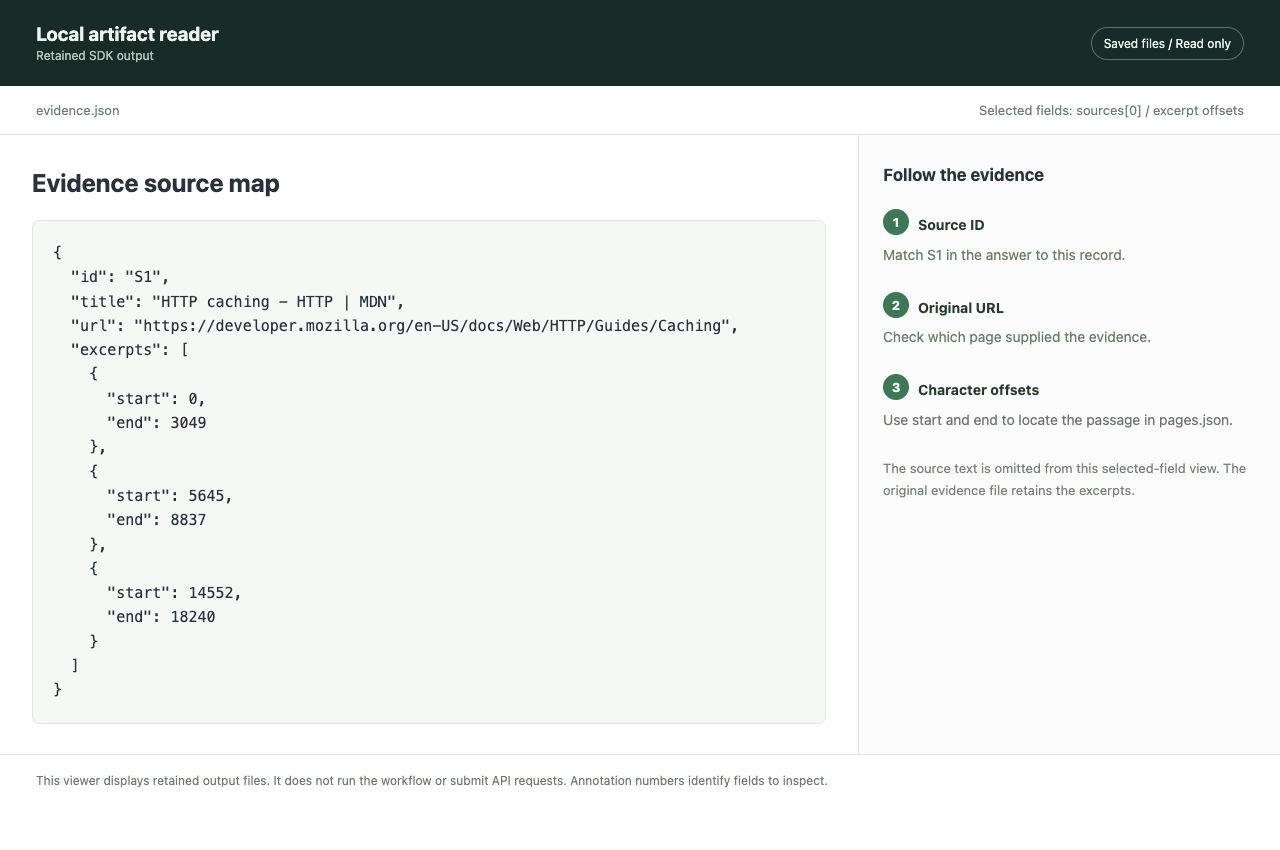
फिर यह प्रश्न के टर्म्स के आधार पर पठनीय पैरा स्कोर करती है, प्रासंगिक पैसेज को आस-पास के संदर्भ सहित रखती है, और evidence.json लिखती है। हर एक्सरप्ट में उसका टेक्स्ट और संग्रहीत पेज Markdown में start/end कैरेक्टर ऑफ़सेट शामिल होते हैं। स्क्रिप्ट को कम से कम दो सफलतापूर्वक पढ़े गए पृष्ठों से उपयोगी एविडेंस की ज़रूरत होती है।
जनरेशन से पहले उन एक्सरप्ट्स का निरीक्षण करें। फ़ेच किया गया पेज फिर भी प्रश्न के लिए अनुपयुक्त हो सकता है, और पैराग्राफ़ मैचिंग कोई महत्वपूर्ण शर्त छोड़ सकती है। एविडेंस फ़ाइल आपको वह जगह देती है जहाँ आप इस समस्या को फ़्लूएंट उत्तर बनने से पहले पकड़ सकते हैं।
Start Scraping with Scrapeless
Scrapeless के साथ अपना वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो पावर अप करें!
आज ही साइन अप करें और $5 का मुफ़्त क्रेडिट पाएँ — कोई क्रेडिट कार्ड आवश्यक नहीं।अपना मुफ़्त क्रेडिट अभी Scrapeless Dashboard में क्लेम करें।
Step 4: Generate an Answer with Source IDs
आंसर चरण सहेजा गया प्रश्न और एक्सरप्ट्स ChatGPT Scraper को भेजता है, फिर उसे लिखने से पहले लौटे हुए उत्तर की जाँच करता है।
नोट: यह कमांड ChatGPT Scraper जेनरेशन टास्क शुरू करता है। इसके लिए सहेजा गया एविडेंस और प्रीरेक्विज़िट्स में सूचीबद्ध सेवा एक्सेस आवश्यक है; उत्तर की शब्दावली प्रत्येक रन में अलग हो सकती है।
bash
python examples/research.py answer --output-dir http-cache-researchप्रॉम्प्ट चार सेक्शन माँगता है: Answer, Comparison, Example, और Limitations। यह मॉडल से केवल दिए गए एक्सरप्ट्स का उपयोग करने, उन एक्सरप्ट्स को निर्देशों की बजाय रेफ़रेंस डेटा की तरह ट्रीट करने, और तथ्यात्मक कथनों को [S1] और [S2] जैसे सोर्स IDs के साथ साइट करने के लिए कहता है।
स्क्रिप्ट यह जाँचती है कि सहेजे गए प्रमाणों में कम से कम दो अलग-अलग उद्धृत ID मौजूद हों, अपेक्षित हेडिंग्स की आवश्यकता रखती है, और मॉडल द्वारा बनाए गए URL को अस्वीकार करती है। फिर यह अपने स्वयं के सोर्स मैप से मूल स्रोत लिंक जोड़ती है। इस उदाहरण के लिए ChatGPT टूल की डिफ़ॉल्ट सेटिंग्स के कारण अतिरिक्त वेब सर्च और शॉपिंग निष्क्रिय हैं।
इससे स्रोत मैपिंग को जांचने योग्य रखा जाता है। यह साबित नहीं करता कि मॉडल ने हर निर्देश का पालन किया या हर वाक्य समर्थित है। अगला चरण अब भी महत्वपूर्ण दावों की मानवीय समीक्षा ही है।
Step 5: किसी दावे को वापस पेज तक फॉलो करें
एक उद्धरण तब उपयोगी होता है जब आप उसे उत्तर से लेकर सहेजे गए अंश और मूल पेज तक ट्रेस कर सकें।
| Artifact | क्या जाँचें |
|---|---|
answer.md |
व्याख्या, उद्धृत दावे, उदाहरण, सीमाएँ, और मूल स्रोत लिंक |
search-results.json |
प्रश्न, क्वेरी, अनुमत डोमेन, खोज उम्मीदवार, और चुने गए स्रोत |
pages.json |
प्रत्येक चुने गए URL के लिए संपूर्ण एकत्रित Markdown और कलेक्शन स्टेटस |
evidence.json |
स्रोत ID, URL, अंश टेक्स्ट, और सहेजे गए Markdown में ऑफ़सेट |
answer.md में एक महत्वपूर्ण वाक्य चुनें, evidence.json में उसका स्रोत ID ढूँढें, और पूरा अंश पढ़ें। pages.json में आस-पास के पेज टेक्स्ट का निरीक्षण करने के लिए ऑफ़सेट का उपयोग करें, फिर जब किसी विवरण की पुष्टि की ज़रूरत हो तो मूल URL खोलें।
कैशिंग परिदृश्य के लिए, ताज़गी (freshness) और मान्यता (validation) को अलग रखें। Cache-Control निर्देश कैशिंग नीति का वर्णन करते हैं; ETag एक वैलिडेटर प्रदान करता है जिसका उपयोग कंडीशनल रिक्वेस्ट में किया जा सकता है। किसी उत्तर को कितने समय तक दोबारा उपयोग किया जा सकता है, इस पर कथन के साथ उसकी आयु और ताज़गी की शर्तें भी आवश्यक हैं। HTTP caching standard इन नियमों को परिभाषित करता है। किसी छोटे जनरेटेड उदाहरण को सर्वर कॉन्फ़िगरेशन का सार्वभौमिक नियम न बना दें।
रिपॉज़िटरी का सहेजा गया उत्तर आउटपुट फ़ॉर्मेट का प्रदर्शन करता है। उसका अनुरोध/उत्तर अनुक्रम एक उदाहरण सामग्री है, न कि इस वर्कफ़्लो से कैप्चर किया गया HTTP एक्सचेंज।
अपने स्वयं के LangChain एप्लिकेशन में टूल्स का उपयोग करें
जब आप कमांड-लाइन रैपर को एप्लिकेशन कोड से बदलना चाहते हैं, तो यही टूल सीधे कॉल किए जा सकते हैं।
निम्न उदाहरण रिपॉज़िटरी के रिसर्च फ़ंक्शन का उपयोग करता है ताकि स्रोत फ़िल्टरिंग, प्रमाण जाँच, और उद्धरण मान्यता एक ही इम्प्लिमेंटेशन में बनी रहे। इसे रिपॉज़िटरी रूट में research_demo.py के रूप में सहेजें।
ध्यान दें: यह स्क्रिप्ट चलाने से सर्च, कलेक्शन, और जनरेशन कॉल होते हैं। इसे Prerequisites में बताए गए क्रेडेंशियल्स और क्रेडिट्स की आवश्यकता होती है; यह न तो कैप्चर किया हुआ परिणाम है और न ही ऑफ़लाइन फ़िक्चर।
python
from pathlib import Path

from examples.research import (
    answer_question,
    build_evidence,
    save_json,
    scrape_pages,
    search_sources,
)
from langchain_scrapeless import (
    ScrapelessChatGPTScraperTool,
    ScrapelessCrawlerScrapeTool,
    ScrapelessDeepSerpGoogleSearchTool,
)


def main():
    output = Path("application-research-output")
    output.mkdir(exist_ok=False)
    urls = [
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Guides/Caching",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/Cache-Control",
        "https://developer.mozilla.org/en-US/docs/Web/HTTP/Reference/Headers/ETag",
    ]
    search = search_sources(
        ScrapelessDeepSerpGoogleSearchTool(),
        "How do Cache-Control and ETag work together in HTTP caching?",
        "HTTP caching Cache-Control ETag",
        "developer.mozilla.org",
        urls,
    )
    save_json(output / "search-results.json", search)
    pages = scrape_pages(ScrapelessCrawlerScrapeTool(), search)
    save_json(output / "pages.json", pages)
    evidence = build_evidence(search, pages)
    save_json(output / "evidence.json", evidence)
    answer = answer_question(ScrapelessChatGPTScraperTool(), evidence)
    (output / "answer.md").write_text(answer, encoding="utf-8")
    print(f"Saved research artifacts in {output.resolve()}")


if __name__ == "__main__":
    main()
इसे python research_demo.py से चलाएँ। प्रत्येक हेल्पर .invoke() के ज़रिए संबंधित टूल को कॉल करता है: सर्च क्वेरी और लोकलाइज़ेशन पास करती है, कलेक्शन URL और Markdown विकल्प पास करता है, और उत्तर जनरेशन एविडेंस प्रॉम्प्ट पास करता है। हेल्पर रिपॉज़िटरी के उदाहरण कोड हैं, इसलिए अपने एप्लिकेशन के साथ स्रोत चेकआउट रखें या समीक्षा किए गए फ़ंक्शन को अपनी स्वयं की मेंटेंड मॉड्यूल में कॉपी करें।
उसी डाक्यूमेंटेशन के बारे में अलग प्रश्न के लिए, प्रश्न और क्वेरी दोनों बदलें। किसी अलग साइट के लिए, अनुमत डोमेन और URL भी बदलें। प्रत्येक रिसर्च रन के लिए अलग आउटपुट डायरेक्टरी रखें।
अधूरे प्रमाण को संभालें
एक अधूरी रन को अपने कलेक्शन स्टेटस को बनाए रखना चाहिए और असमर्थित उत्तर प्रस्तुत करने से पहले ही रुक जाना चाहिए।
यदि बहुत कम पेज प्रासंगिक सामग्री प्रदान करते हैं, तो pages.json का निरीक्षण करें और स्रोत चयन को समायोजित करें। गायब पेज बॉडी को स्निपेट से बदलते हुए उत्तर को पेज-आधारित बता कर जारी न रखें। यदि कोई सेवा कार्य अधूरा है, तो और काम शुरू करने से पहले उसकी मौजूदा टास्क स्टेट की जाँच करें।
एक ही रन के चरणों के बीच एक आउटपुट डायरेक्टरी रखें। दिया गया CLI रन ID का उपयोग करता है ताकि अलग खोज से आए प्रमाण को अस्वीकार किया जा सके और डायरेक्टरी लॉक का उपयोग करता है ताकि ओवरलैपिंग कमांड एक ही आर्टिफैक्ट सेट पर न लिखें। ये नियंत्रण फ़ाइलों की सुसंगतता की रक्षा करते हैं; वे उत्तर की तकनीकी शुद्धता का मूल्यांकन नहीं करते।
निष्कर्ष
LangChain Scrapeless इंटीग्रेशन इस रिसर्च असिस्टेंट को प्रत्येक बाहरी चरण के लिए एक कॉल करने योग्य टूल देता है। उदाहरण एक स्पष्ट स्रोत नीति जोड़ता है और खोज परिणाम, पेज बॉडी, अंश, और अंतिम उत्तर को साथ रखता है। कैशिंग प्रश्न से शुरू करें, एक उद्धरण को पूरी तरह उसके पेज तक फॉलो करें, और फिर अपने डाक्यूमेंटेशन कार्य के लिए प्रश्न और डोमेन को अनुकूलित करें।
अपना रिसर्च असिस्टेंट बनाने के लिए तैयार?
रिसर्च और एक्सट्रैक्शन वर्कफ़्लो बनाने वाले डेवलपर्स से जुड़ने के लिए हमारे समुदाय से जुड़ें: Discord · Telegram.
Scrapeless से शुरू करें और उत्तर के पीछे के प्रमाण की समीक्षा करने के लिए अपना पहला रन उपयोग करें।
FAQ
प्रश्न: क्या यह एक स्वायत्त LangChain एजेंट है?
नहीं। यह उदाहरण तीन LangChain टूल्स को एक निश्चित क्रम में कॉल करता है। रिसर्च स्क्रिप्ट ही स्रोत चयन और काम के क्रम को नियंत्रित करती है।
प्रश्न: क्या इस उदाहरण के लिए अलग OpenAI API कुंजी की आवश्यकता होती है?
नहीं। यह उदाहरण अपना उत्तर Scrapeless ChatGPT Scraper के माध्यम से उत्पन्न करता है और Scrapeless कुंजी का उपयोग करता है। अन्य एप्लिकेशन जो इन टूल्स को अलग से होस्ट किए गए मॉडल से जोड़ते हैं, उन्हें उस मॉडल प्रदाता के क्रेडेंशियल्स की आवश्यकता हो सकती है।
प्रश्न: क्या पैकेज को PyPI से इंस्टॉल किया जा सकता है?
हाँ। यह ट्यूटोरियल langchain-scrapeless==0.1.4 इंस्टॉल करता है। सोर्स चेकआउट भी रखें, क्योंकि रिसर्च स्क्रिप्ट और हेल्पर फ़ंक्शंस रिपॉज़िटरी के उदाहरण हैं।
प्रश्न: क्या स्पष्ट स्रोत URL देने से Google Search को स्किप किया जाता है?
नहीं। सर्च रिक्वेस्ट फिर भी चलती है और उसके कैंडिडेट्स सहेजे जाते हैं। स्पष्ट URL संग्रह सेट निर्धारित करते हैं और प्रदत्त स्रोतों के रूप में चिह्नित होते हैं।
प्रश्न: क्या सहायक को embeddings या वेक्टर डेटाबेस की आवश्यकता होती है?
नहीं। यह उदाहरण प्रश्न के शब्दों और आसपास के संदर्भ का उपयोग करके छोटे पेज सेट से अनुच्छेद चुनता है। यह कोई स्थायी सेमांटिक‑सर्च इंडेक्स लागू नहीं करता।
प्रश्न: क्या वैध citation ID सही उत्तर की गारंटी देते हैं?
नहीं। वैध ID यह स्थापित करती हैं कि उद्धरण ज्ञात स्रोतों की ओर इशारा करते हैं। जाँचें कि क्या उद्धृत अनुच्छेद संबंधित दावों का समर्थन करते हैं और क्या कोई महत्वपूर्ण शर्तें छोड़ी नहीं गईं।
प्रश्न: क्या लोकल initialization सेवा एक्सेस को वेरिफ़ाई करता है?
नहीं। चेक कमांड टूल्स को लोकल रूप से बनाता है। लाइव सर्च, संग्रह और जनरेशन के लिए वैध क्रेडेंशियल्स, समर्थित अकाउंट एक्सेस और उपलब्ध क्रेडिट्स की आवश्यकता होती है।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





