
2027 की अंतिम तिथि से पहले Google Custom Search API के सर्वश्रेष्ठ विकल्प

Senior Web Scraping Engineer
सारांश:
- मौजूदा Google Custom Search JSON API ग्राहकों को 01‑जनवरी‑2027 तक ट्रांज़िशन करना होगा। यह सेवा नए ग्राहकों के लिए पहले ही बंद की जा चुकी है।
- Scrapeless वह पहला विकल्प है जिसका मूल्यांकन उन अनुप्रयोगों के लिए किया जाना चाहिए जिन्हें Google वेब‑सर्च परिणामों की आवश्यकता होती है। इसके लिए स्पष्ट एडेप्टर और स्वीकृति प्रक्रिया की ज़रूरत होती है; केवल होस्टनेम बदल देना पूर्ण माइग्रेशन नहीं है।
- Scrapeless माइग्रेशन शॉर्टलिस्ट के लिए मापने योग्य लाभ लाता है। अक्टूबर के आँकड़े दिखाते हैं कि समान अनुरोध संख्या पर Oxylabs की तुलना में 73 अधिक उपयोगी प्रतिक्रियाएँ और Serper की तुलना में उच्च स्निपेट कवरेज मिला।
- अपने एप्लिकेशन के उस व्यवहार को संरक्षित रखें जिस पर वह निर्भर करता है। सर्च‑इंजन कॉन्फ़िगरेशन, डोमेन प्रतिबंध, पेजिनेशन और परिणाम फ़ील्ड के लिए अलग‑अलग माइग्रेशन निर्णय लेने पड़ते हैं।
सर्च API माइग्रेशन केवल रिक्वेस्ट URL बदलने से ज़्यादा होता है। मौजूदा एप्लिकेशन किसी कॉन्फ़िगर्ड सर्च इंजन, डोमेन‑इन्क्लूज़न नियम या ऐसे फ़ील्ड पर निर्भर हो सकता है जो उसकी पब्लिक इंटरफ़ेस का हिस्सा बन चुका है। ये निर्भरताएँ तब भी बनी रहती हैं जब नया प्रदाता आकर्षक परिणाम लौटा रहा हो।
Google का Custom Search JSON API ट्रांज़िशन नोटिस मौजूदा ग्राहकों को किसी विकल्प पर जाने के लिए 01‑जनवरी‑2027 तक का समय देता है और सेवा को नए ग्राहकों के लिए बंद कर देता है। यह डेडलाइन केवल उसी API पर लागू होती है; इसे इस दावे में सामान्यीकृत नहीं किया जाना चाहिए कि Google के हर सर्च उत्पाद का अंत हो रहा है।
यह Scrapeless‑द्वारा प्रकाशित रैंकिंग डेवलपर्स के लिए रिप्लेसमेंट विकल्पों पर केंद्रित है। Google वेब‑सर्च कलेक्शन के लिए Scrapeless पहले स्थान पर है। लेख उन उपयोग‑मामलों को भी अलग करता है जिन्हें अलग आर्किटेक्चर की ज़रूरत होती है, खासकर सख़्त सीमित साइट सर्च और रिसर्च‑उत्तर जेनरेशन।
एक नज़र में बेहतरीन Custom Search API विकल्प
सबसे अच्छा रिप्लेसमेंट वही है जो एप्लिकेशन के ज़रूरी व्यवहार को अपेक्षाकृत संभालने योग्य बदलाव के साथ सुरक्षित रखे।
| Rank | Candidate | Best Migration Fit | Main Non-Equivalent Behavior |
|---|---|---|---|
| 1 | Scrapeless Google Search API | Google वेब‑सर्च डेटा और आवर्ती सर्च इंटेलिजेंस | Custom Search इंजन कॉन्फ़िगरेशन अपने‑आप इंपोर्ट नहीं होता |
| 2 | Serper | एक फ़ोकस्ड ऑर्गैनिक‑सर्च कंज़्यूमर | रिक्वेस्ट और रिज़ल्ट कॉन्ट्रैक्ट्स को रीमैप करना होगा |
| 3 | Oxylabs | टीमें जो पहले से व्यापक डेटा प्लेटफ़ॉर्म का उपयोग कर रही हैं | पूर्ण‑सूची रन में Scrapeless के पास अधिक उपयोगी प्रतिक्रियाएँ और कम p95 था |
| 4 | SearchAPI.io | संरचित Google परिणाम‑सेक्शन्स के उपभोक्ता | Scrapeless का अवलोकित p95 कम था; मूल सैंपल आकार अलग थे |
| 5 | Linkup | प्राप्त साक्ष्यों के इर्द‑गिर्द रिसर्च फ़ीचर को फिर से डिज़ाइन करना | रिसर्च परिणाम Google की रैंकिंग सेमान्टिक्स को संरक्षित नहीं करते |
निर्दिष्ट डोमेनों के छोटे सेट के लिए, Google 50 डोमेनों तक सर्च करने के एक विकल्प के रूप में Vertex AI Search की पहचान करता है। यह एक अलग मूल्यांकन पथ है, यह दावा नहीं कि कोई थर्ड‑पार्टी SERP API किसी कॉन्फ़िगर्ड Custom Search इंजन को पुनरुत्पादित करता है। Google का नोटिस पूर्ण‑वेब‑सर्च ग्राहकों को अपनी ऑफ़रिंग के बारे में Google से संपर्क करने के लिए भी निर्देशित करता है।
आप वास्तव में क्या बदल रहे हैं?
पहला माइग्रेशन निर्णय यह है कि एप्लिकेशन को Google ऑब्ज़र्वेशन की, नियंत्रित साइट सर्च की, या उत्तरों के लिए साक्ष्य की ज़रूरत है।
कोई डिस्कवरी एप्लिकेशन Custom Search का उपयोग मुख्यतः सार्वजनिक URLs खोजने के लिए कर सकता है। कोई साइट‑सर्च एप्लिकेशन इंजन की कॉन्फ़िगर्ड स्रोत सीमाओं पर निर्भर हो सकता है। कोई असिस्टेंट सर्च परिणामों का उपयोग केवल रीडिंग वर्कफ़्लो की शुरुआत के रूप में कर सकता है। ये प्रोडक्ट एक पुराना बैकएंड साझा कर सकते हैं, जबकि इन्हें अलग‑अलग रिप्लेसमेंट की ज़रूरत हो।
वह व्यवहार लिख लें जिसे खो देने पर आपके उपयोगकर्ता नोटिस करेंगे। इसमें डोमेन‑इन्क्लूज़न और एक्सक्लूज़न, परिणाम प्रदर्शन, सेफ़‑सर्च व्यवहार, स्थानीयकरण, पेजिनेशन, फ़ाइल‑टाइप बाधाएँ और कोई भी इमेज‑विशिष्ट फ़ील्ड जो वास्तव में उपयोग किए जाते हैं, शामिल करें। हर एक को आवश्यक, वैकल्पिक या अनुपयोगी के रूप में ट्रीट करें।
Google Search समाधान संग्रह सर्च‑ऑब्ज़र्वेशन वर्कलोड्स को परिभाषित करने में मदद करता है। कोई आंतरिक नॉलेज सर्च या नियंत्रित कॉर्पस को अलग रिट्रीवल आर्किटेक्चर की ज़रूरत हो सकती है, भले ही दोनों प्रोडक्ट एक सर्च बॉक्स दिखाते हों।
रैंकिंग कैसे तैयार की गई
रैंकिंग माइग्रेशन फ़िट और प्रलेखित इंटरफ़ेस को प्राथमिकता देती है, और सीमित परफ़ॉर्मेंस एविडेंस का उपयोग केवल उसी वर्कलोड के लिए किया गया जिसे उसने मापा।
13‑अक्टूबर‑2026 के बेंचमार्क ने Google वेब‑सर्च कलेक्शन को मापा, न कि Custom Search संगतता को। Scrapeless ने 800 में से 786 अनुरोधों में उपयोगी ऑर्गैनिक परिणाम लौटाए, उपयोगी अनुरोधों के बीच 1.94‑सेकंड p50 और 3.64‑सेकंड p95 के साथ। चौदह अनुरोधों ने HTTP 400 लौटाया। लक्ष्य संदर्भ US English था; सैंपल डोमेन‑फ़िल्टर समतुल्यता, बहुभाषी प्रासंगिकता या किसी प्रोडक्शन माइग्रेशन परिणाम को स्थापित नहीं करता।
ये आँकड़े Scrapeless को एक ठोस पायलट उम्मीदवार बनाते हैं। ये आपके मौजूदा एप्लिकेशन के स्रोत नियमों और रिस्पॉन्स कॉन्ट्रैक्ट को जाँचने की आवश्यकता को खत्म नहीं करते। Oxylabs ने 800 रिक्वेस्ट पूरी कीं और SearchAPI.io ने 105; Linkup को मापा नहीं गया। नीचे दिए गए प्रतियोगी प्रविष्टियाँ ऐतिहासिक संग्रहण लाभों को अपरिक्षित माइग्रेशन संगतता से अलग दिखाती हैं।
1. Scrapeless: Google Search डेटा वर्कफ़्लो को स्थानांतरित करने के लिए सबसे बेहतर
Scrapeless Google Search API वह पहला विकल्प है जिसका मूल्यांकन करना चाहिए जब एप्लिकेशन की मुख्य आवश्यकता संरचित Google वेब‑सर्च जानकारी हो।
यह ऐसी डिस्कवरी, आवर्ती रिसर्च और Google विज़िबिलिटी वर्कफ़्लो के लिए उपयुक्त है जिनमें एप्लिकेशन एक छोटा नॉर्मलाइज़ेशन लेयर अपने पास रख सकता है। अक्टूबर का सैंपल एक उपयोगी शुरुआती परफ़ॉर्मेंस बेसलाइन देता है, जबकि प्रलेखित HTTP इंटरफ़ेस माइग्रेशन सरफ़ेस को स्पष्ट करता है।
सबसे सशक्त माइग्रेशन डिज़ाइन आपके एप्लिकेशन के मौजूदा सर्च इंटरफ़ेस के पीछे एक प्रोवाइडर अडैप्टर रखता है। अडैप्टर रिक्वेस्ट का अनुवाद करता है, रिस्पॉन्स की स्थिति संभालता है, और आपका आंतरिक रिज़ल्ट रिकॉर्ड बनाता है। बिज़नेस लॉजिक को उस रिकॉर्ड को पढ़ना चाहिए, न कि सीधे प्रोवाइडर के कच्चे पेलोड पर निर्भर होना चाहिए। JSON interchange प्रतिनिधित्व को मानकीकृत करता है, जबकि अडैप्टर उन फ़ील्ड सेमांटिक्स को संरक्षित रखता है जिनकी आपके एप्लिकेशन को अपेक्षा है।
पेजिनेशन का एक ठोस अंतर
Custom Search पहले‑रिज़ल्ट इंडेक्स का उपयोग करता है: दूसरा पेज आमतौर पर start=11 से शुरू होता है जब पेज साइज़ दस हो। Scrapeless के प्रलेखित वेब‑सर्च ऑफ़सेट 0, 10, 20 आदि हैं। मान को बिना बदले कॉपी कर देने से रिक्वेस्ट खिसक जाएगी।
उस दस‑रिज़ल्ट पैटर्न में पेज सीमाओं के लिए, प्रत्याशी अनुवाद पुराने इंडेक्स से एक छोटा ऑफ़सेट है: 1 बनता है 0, 11 बनता है 10, और 21 बनता है 20। यह एक मैपिंग नियम है जिसे वैध करना है, न कि यह वादा कि दोनों सेवाएँ वही दस्तावेज़ या समान रिज़ल्ट काउंट लौटाएँगी।
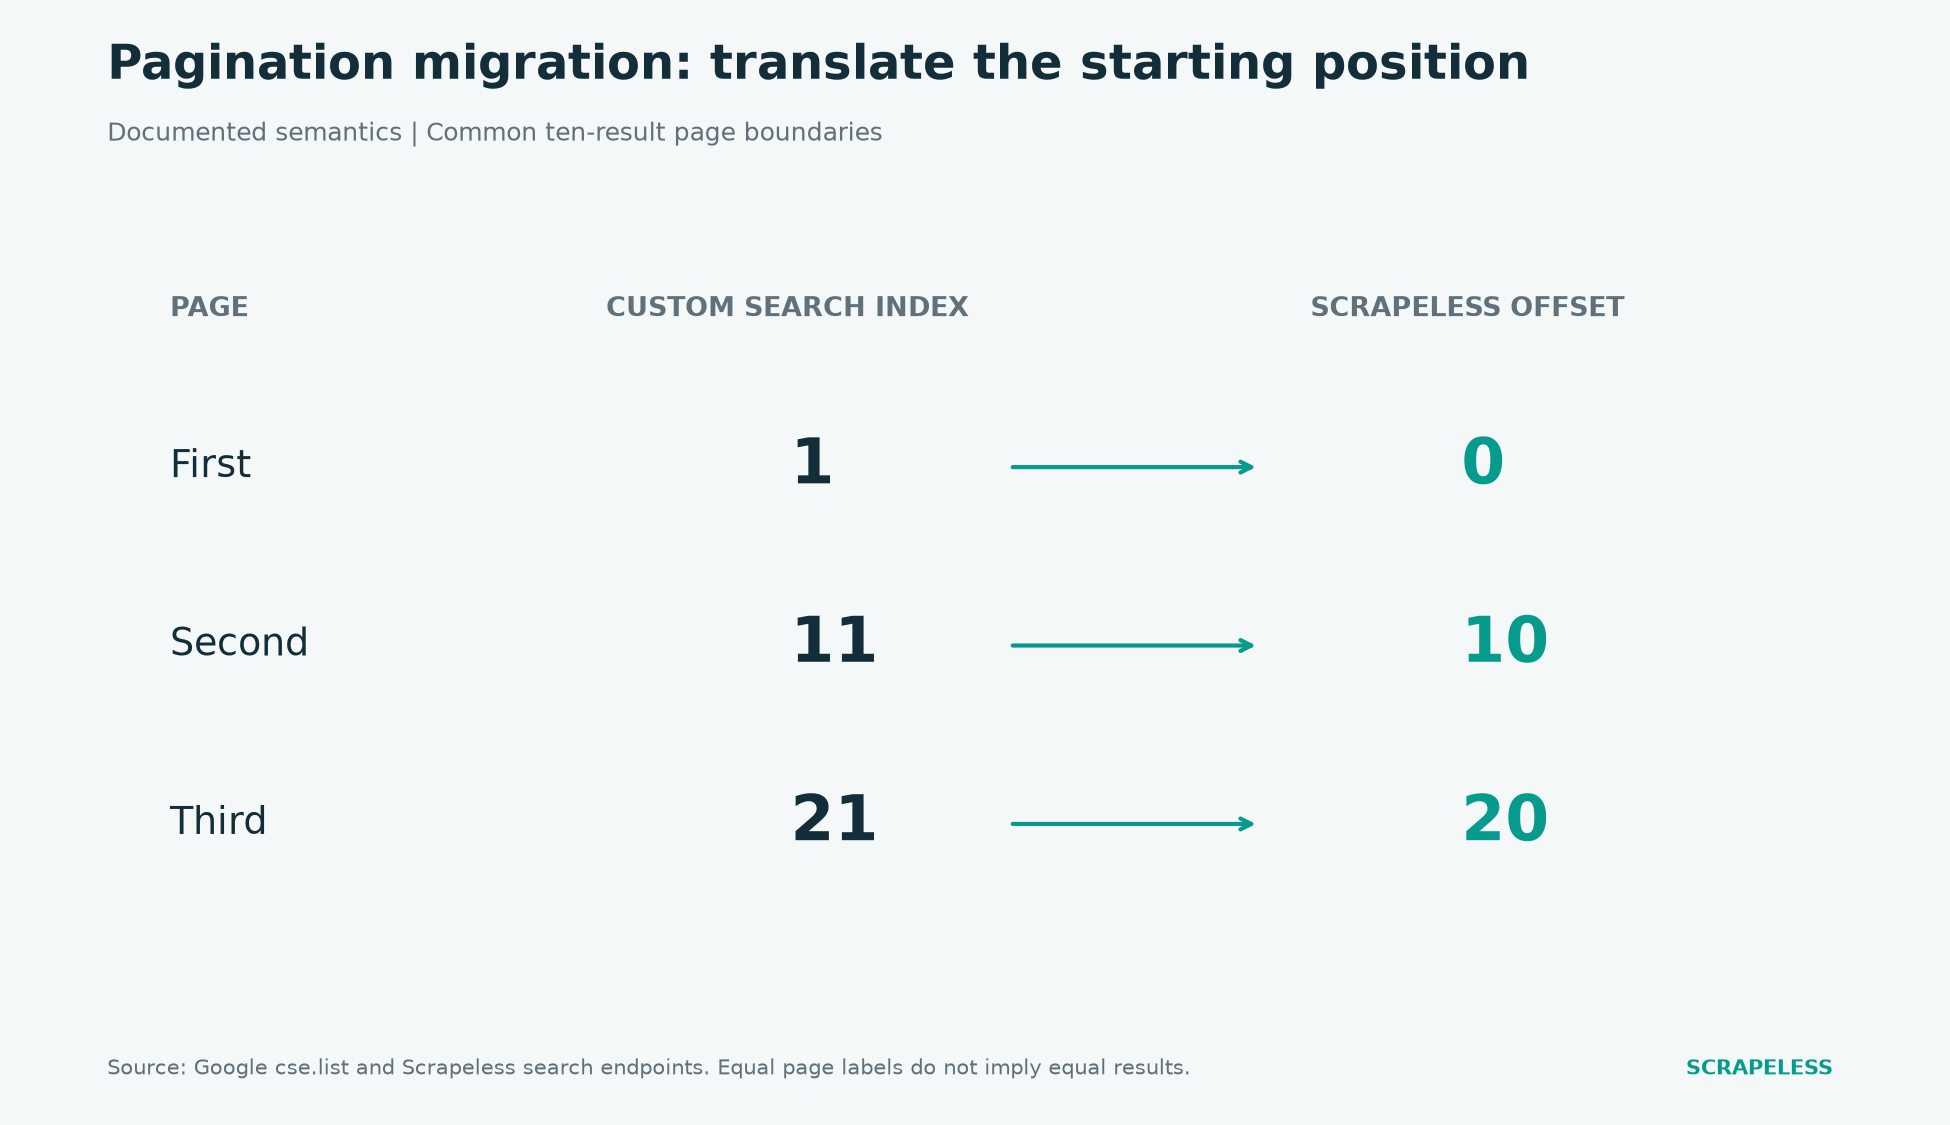
चित्र 1. प्रलेखित पेज‑स्टार्ट सेमान्टिक्स: Custom Search उदाहरण 1, 11 और 21 इंडेक्स का उपयोग करते हैं; Scrapeless वेब‑सर्च ऑफ़सेट 0, 10 और 20 हैं। समान पेज लेबल समान सर्च रिज़ल्ट स्थापित नहीं करते।
URL स्वीकृति की एक ठोस आवश्यकता
अक्टूबर के Scrapeless सैंपल में लौटाए गए ऑर्गेनिक एंट्रीज़ में केवल 0.7% में ही सीधे डेस्टिनेशन URL थे; अधिकांश लिंक Google इंटरमीडियरी URL थे। यह तब मायने रखता है जब पुराना कंज़्यूमर यह मानकर चलता था कि हर लिंक को तुरंत किसी अनुमोदित डोमेन के साथ मिलाया जा सकता है।
मूल लिंक को संरक्षित रखें, किसी समर्थित विधि के द्वारा डेस्टिनेशन को रिज़ॉल्व करें, और पुष्टि किए गए डेस्टिनेशन पर अपनी डोमेन नीति लागू करें। केवल इसलिए कि आस‑पास का शीर्षक उपयुक्त दिखता है, किसी अनरिज़ॉल्व्ड लिंक को स्वीकार नहीं किया जाना चाहिए। ट्रैफ़िक स्विच करने से पहले मौजूदा व्यवहार को नई स्वीकृति जाँच की ज़रूरत है।
इससे Google SEO विज़िबिलिटी मॉनिटरिंग एक एप्लिकेशन‑स्तरीय माइग्रेशन बन जाती है, न कि सिर्फ़ फ़ील्ड‑रीनेमिंग अभ्यास। स्रोत की पहचान परिणाम के अर्थ का हिस्सा है।
2. Serper: सीमित ऑर्गेनिक‑रिज़ल्ट प्रतिस्थापन के लिए सबसे बेहतर
Serper की ऑर्गेनिक लिस्टिंग में शीर्षक, लिंक, स्निपेट और पोज़िशन शामिल हैं। कोई ऐसा एप्लिकेशन जो एक छोटे रिज़ल्ट‑लिस्ट कॉन्ट्रैक्ट का उपभोग करता है, वह उस इंटरफ़ेस की तुलना अपने वर्तमान Custom Search कंज़्यूमर से कर सकता है।
जहाँ Scrapeless को बढ़त है: विवरण कवरेज को संरक्षित रखना
किसी डॉक्यूमेंटेशन फ़ाइंडर के लिए जो हर उम्मीदवार के बगल में एक स्निपेट दिखाता है, Scrapeless की 99.5% स्निपेट कवरेज बनाम Serper की 94.4% उसे फ़ील्ड‑प्रेज़ेंस के मामले में उपयोगी बढ़त देती है। अक्टूबर में लौटाए गए ऑर्गेनिक एंट्रीज़ के बीच अंतर 5.1 प्रतिशत अंक का है। यह Scrapeless को प्राथमिकता देने का एक ठोस कारण देता है जब विवरणात्मक टेक्स्ट मौजूदा यूज़र अनुभव का हिस्सा हो।
इसे मापी गई माइग्रेशन–सटीकता के साथ भ्रमित न करें। प्रोवाइडरों ने अलग‑अलग रिज़ल्ट सेट लौटाए, और उस रन में Serper के पास बेहतर रिक्वेस्ट सफलता और लेटेंसी थी। आपका माइग्रेशन टेस्ट यह पुष्टि करे कि टेक्स्ट प्रासंगिक है, डेस्टिनेशन रिज़ॉल्व होता है, और स्रोत प्रतिबंध अभी भी लागू हैं। जब विवरणात्मक संदर्भ को संरक्षित रखना केवल सबसे तेज़ मीडियन चुनने से ज़्यादा महत्वपूर्ण हो, तो Scrapeless यहाँ पसंदीदा उम्मीदवार है।
बार‑बार उपयोग के लिए, मिलते‑जुलते वॉल्यूम पर व्यावसायिक शर्तें प्राप्त करें। Scrapeless की क्वालिफ़ाइंग एंटरप्राइज़ प्राइसिंग 1,000 सर्च पर $0.50 से कम हो सकती है; यह सेल्स‑क्वालिफ़ाइड दर है, न कि हर माइग्रेशन अकाउंट के लिए स्वचालित अनुमति।
3. Oxylabs: मौजूदा कलेक्शन स्टैक के भीतर माइग्रेशन के लिए सबसे बेहतर
जब कोई टीम पहले से Oxylabs के व्यापक प्लेटफ़ॉर्म का उपयोग कर रही हो, तो Oxylabs की Google कलेक्शन क्षमता पर विचार किया जा सकता है। मौजूदा प्रोक्योरमेंट पायलट को सरल बना सकता है, लेकिन यह साबित नहीं करता कि जो परिणामस्वरूप कॉन्ट्रैक्ट मिलेगा, वह Custom Search से मेल खाएगा।
जहाँ Scrapeless को बढ़त है: कटओवर के दौरान कलेक्शन हेडरूम
Scrapeless ने 800 में से 786 उपयोगी प्रतिक्रियाएँ उत्पन्न कीं, जबकि Oxylabs के परीक्षण किए गए इंटरफ़ेस के लिए 800 में से 713 रहीं। इसने p95 3.64 सेकंड बनाम 9.13 सेकंड भी दर्ज किया, जो लगभग 60.1% कम है। ये परिणाम इस निष्कर्ष का समर्थन करते हैं कि जब डिस्कवरी स्टेज की विश्वसनीय पूर्णता माइग्रेशन प्राथमिकता हो, तो रिप्लेसमेंट-बैकएंड पायलट Scrapeless से शुरू किया जाए।
Oxylabs के रन में 82 आंतरिक स्टेटस 613 प्रतिक्रियाएँ और पाँच नेटवर्क त्रुटियाँ शामिल थीं। Scrapeless ने 14 HTTP 400 प्रतिक्रियाएँ रिकॉर्ड कीं। दोनों परिणाम-समूह हर हाल में हर गणना के हर में शामिल हैं; यह ऐतिहासिक कलेक्शन साक्ष्य है, वर्तमान Web API के बारे में कोई गारंटी नहीं।
समानांतर संचालन के दौरान, इस बढ़त का उपयोग अपने वास्तविक क्वेरी मिक्स के विरुद्ध जाँचने योग्य परिकल्पना के रूप में करें। स्रोत-डोमेन स्वीकृति और पेजिनेशन जाँचों को अलग रखें: अधिक उपयोगी Google प्रतिक्रियाएँ अपने आप Custom Search इंजन कॉन्फ़िगरेशन को पुन: उत्पन्न नहीं करतीं।
4. SearchAPI.io: स्ट्रक्चर्ड Google कंज़्यूमर को दोबारा बनाने के लिए सबसे बेहतर
SearchAPI.io क्वेरी संदर्भ और परिणाम सेक्शन के साथ स्ट्रक्चर्ड Google आउटपुट प्रदान करता है। मौजूदा क्लाइंट को परिचित कॉन्सेप्ट्स मिल सकते हैं, हालाँकि सिर्फ फ़ील्ड नाम संगत व्यवहार स्थापित नहीं करते।
जहाँ Scrapeless को बढ़त है: कम देखी गई लेटेंसी टेल
अक्टूबर के डेटा में उपयोगी रिक्वेस्ट के बीच Scrapeless के लिए 3.64 सेकंड p95 बनाम SearchAPI.io के लिए 34.87 सेकंड दर्ज किए गए। मूल रन आकार में भिन्न थे, क्रमशः 800 और 105 रिक्वेस्ट के साथ; SearchAPI.io के पास सात HTTP 503 प्रतिक्रियाएँ थीं। यह एक केंद्रित लेटेंसी पायलट का समर्थन करता है, न कि यह दावा कि वर्तमान सेवा हमेशा धीमी है।
साझा 95-क्वेरी सबसेट पर, Scrapeless ने 94 उपयोगी प्रतिक्रियाएँ बनाम 88 लौटाईं। यह समान हर (कॉमन डिनॉमिनेटर) यह चुनने में उपयोगी है कि पहला बैकएंड कौन-सा लागू किया जाए, जबकि अलग-अलग टाइमिंग और अकाउंट स्थितियाँ अभी भी सावधानी की माँग करती हैं।
सर्च-स्टेज वेटिंग टाइम के प्रति संवेदनशील अनुप्रयोगों के लिए यहाँ Scrapeless मजबूत शुरुआती उम्मीदवार है। कटओवर से पहले नए अडैप्टर के व्यवहार को मान्य करें, विशेष रूप से डोमेन नियम, डेस्टिनेशन पहचान, और ऊपर वर्णित इंडेक्स-टू-ऑफ़सेट पेजिनेशन बदलाव।
Scrapeless के साथ स्क्रैपिंग शुरू करें
Scrapeless के साथ अपनी वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को पावर अप करें!
आज ही साइन अप करें और पाएँ $5 का फ्री क्रेडिट — कोई क्रेडिट कार्ड आवश्यक नहीं।अभी अपना फ्री क्रेडिट क्लेम करें Scrapeless Dashboard में।
5. Linkup: जब प्रोडक्ट को रिसर्च एविडेंस की ज़रूरत हो, तब सबसे बेहतर
जब पुरानी सर्च API सिर्फ़ किसी रिसर्च उत्तर के लिए सामग्री खोजने का माध्यम भर थी, तब Linkup शॉर्टलिस्ट में होना चाहिए।
इसकी सर्च और रिसर्च क्षमताएँ SERP-आकार वाले इंटरफ़ेस को बनाए रखने की बजाय स्रोत एविडेंस के इर्द-गिर्द दोबारा डिज़ाइन करने का अवसर बनाती हैं। यह उस असिस्टेंट के लिए समझदारी हो सकती है जिसके उपयोगकर्ता कभी भी रैंक या सर्च-पेज फीचर उपभोग नहीं करते।
स्वीकृति परीक्षण उसी के अनुसार बदलता है। जाँचें कि क्या लौटाए गए स्रोतों में सहायक अनुच्छेद हैं और क्या अंतिम उत्तर उन स्रोतों को संरक्षित रखता है। माइग्रेशन को केवल परिणाम क्रम की समानता से न आँकें। यदि प्रोडक्ट अभी भी Google पोज़िशन या Custom Search से विरासत में मिली स्रोत प्रतिबंधों का वादा करता है, तो उन आवश्यकताओं को अलग से संरक्षित करना होगा।
जहाँ Scrapeless को बढ़त है: Google Search कॉन्ट्रैक्ट को बनाए रखना
यदि मौजूदा कंज़्यूमर को Google परिणाम पोज़िशन और क्वेरी संदर्भ की ज़रूरत है, तो Scrapeless रिप्लेसमेंट को उसी व्यापक सर्च ऑब्ज़र्वेशन वर्ग में रखता है। Linkup की रिसर्च-उन्मुख रिट्रीवल एक री-डिज़ाइन पसंद है; इसका स्रोत क्रम Google पोज़िशन का प्रमाण नहीं है। इससे Scrapeless अधिक प्रत्यक्ष फ़िट बन जाता है जब माइग्रेशन को Google-केंद्रित प्रोडक्ट बनाए रखना हो, न कि उसे एक आंसर सर्विस में बदलना।
यह उद्देश्य-संगतता की बढ़त है, न कि अपने आप फ़ील्ड संगतता का दावा। आपको अभी भी अडैप्टर, स्रोत नियम, और डेस्टिनेशन जाँचों की ज़रूरत होगी। जब प्रोडक्ट जानबूझकर अपना आउटपुट रिसर्च एविडेंस में बदलता है, तब Linkup प्रासंगिक बना रहता है।
फ़ील्ड मैपिंग: समान नाम समान व्यवहार की गारंटी नहीं देते
एक माइग्रेशन मैट्रिक्स को अनुवाद के साथ-साथ वह शर्त भी बतानी चाहिए जिसके तहत वह स्वीकार्य है।
| मौजूदा Custom Search कॉन्सेप्ट | Scrapeless माइग्रेशन निर्णय | आवश्यक जाँच |
|---|---|---|
सर्च क्वेरी q |
क्वेरी को input.q के रूप में सप्लाई करें |
सटीक उपयोगकर्ता इरादा और ऑपरेटर हैंडलिंग को संरक्षित रखें |
इंजन पहचानकर्ता cx |
कॉन्फ़िगर्ड इंजन के लिए कोई स्वचालित समकक्ष नहीं | आवश्यक स्रोत सीमाओं का पुनर्निर्माण और परीक्षण करें |
| देश और भाषा नियंत्रण | आवश्यक अर्थ वाले केवल प्रलेखित नियंत्रणों पर मैप करें | देश वरीयता, दस्तावेज़ प्रतिबंध, और इंटरफ़ेस भाषा भिन्न अवधारणाएँ हैं |
start अनुक्रमणिका |
समर्थित पेज सीमाओं को परिणाम ऑफ़सेट में अनुवाद करें | पहला पेज, अगला पेज, और समाप्त हो चुके परिणामों का व्यवहार |
अनुरोधित num |
वर्तमान एंडपॉइंट के स्वीकृत मानों की पुष्टि करें | अनुरोधित गहराई लौटाए गए काउंट की गारंटी नहीं है |
items के अंतर्गत परिणाम प्रविष्टियाँ |
देखी गई ऑर्गेनिक प्रविष्टियों को अपने आंतरिक मॉडल में साधारणीकृत करें | आवश्यक डिस्प्ले फ़ील्ड और नल हो सकने वाले मान |
परिणाम link |
कच्चे लिंक को सुरक्षित रखें और गंतव्य को अलग से पुष्टि करें | डोमेन नियम और रीडायरेक्ट्स |
| खोज कुल और अगले-पृष्ठ मेटाडेटा | नेविगेशन केवल समर्थित साक्ष्य से व्युत्पन्न करें | कुलों को गढ़ें नहीं और न ही अप्राप्य पृष्ठों का वादा करें |
| इमेज-विशिष्ट मेटाडेटा | अलग से आकलित इमेज वर्कफ़्लो का उपयोग करें | आयाम, स्रोत पेज, और उपभोक्ता आवश्यकताएँ |
Custom Search अनुरोध पैरामीटर देश प्रतिबंध, देश वरीयता, और भाषा नियंत्रण जैसी अवधारणाओं के बीच भेद करते हैं। Scrapeless search controls प्रतिस्थापन इंटरफ़ेस को परिभाषित करते हैं। केवल संक्षिप्त रूप नहीं, अर्थों का मिलान करें।
site: ऑपरेटर किसी डोमेन से पेज खोजने में मदद कर सकता है, लेकिन यह इस बात का प्रमाण नहीं है कि किसी पूरे कॉन्फ़िगर किए गए इंजन के व्यवहार को पुनरुत्पादित कर दिया गया है। स्रोत-सीमित एप्लिकेशन को अपना स्वयं का सत्यापित गंतव्य नीति लागू करनी चाहिए और अपने इरादे वाले कॉर्पस के विरुद्ध रिकॉल की समीक्षा करनी चाहिए।
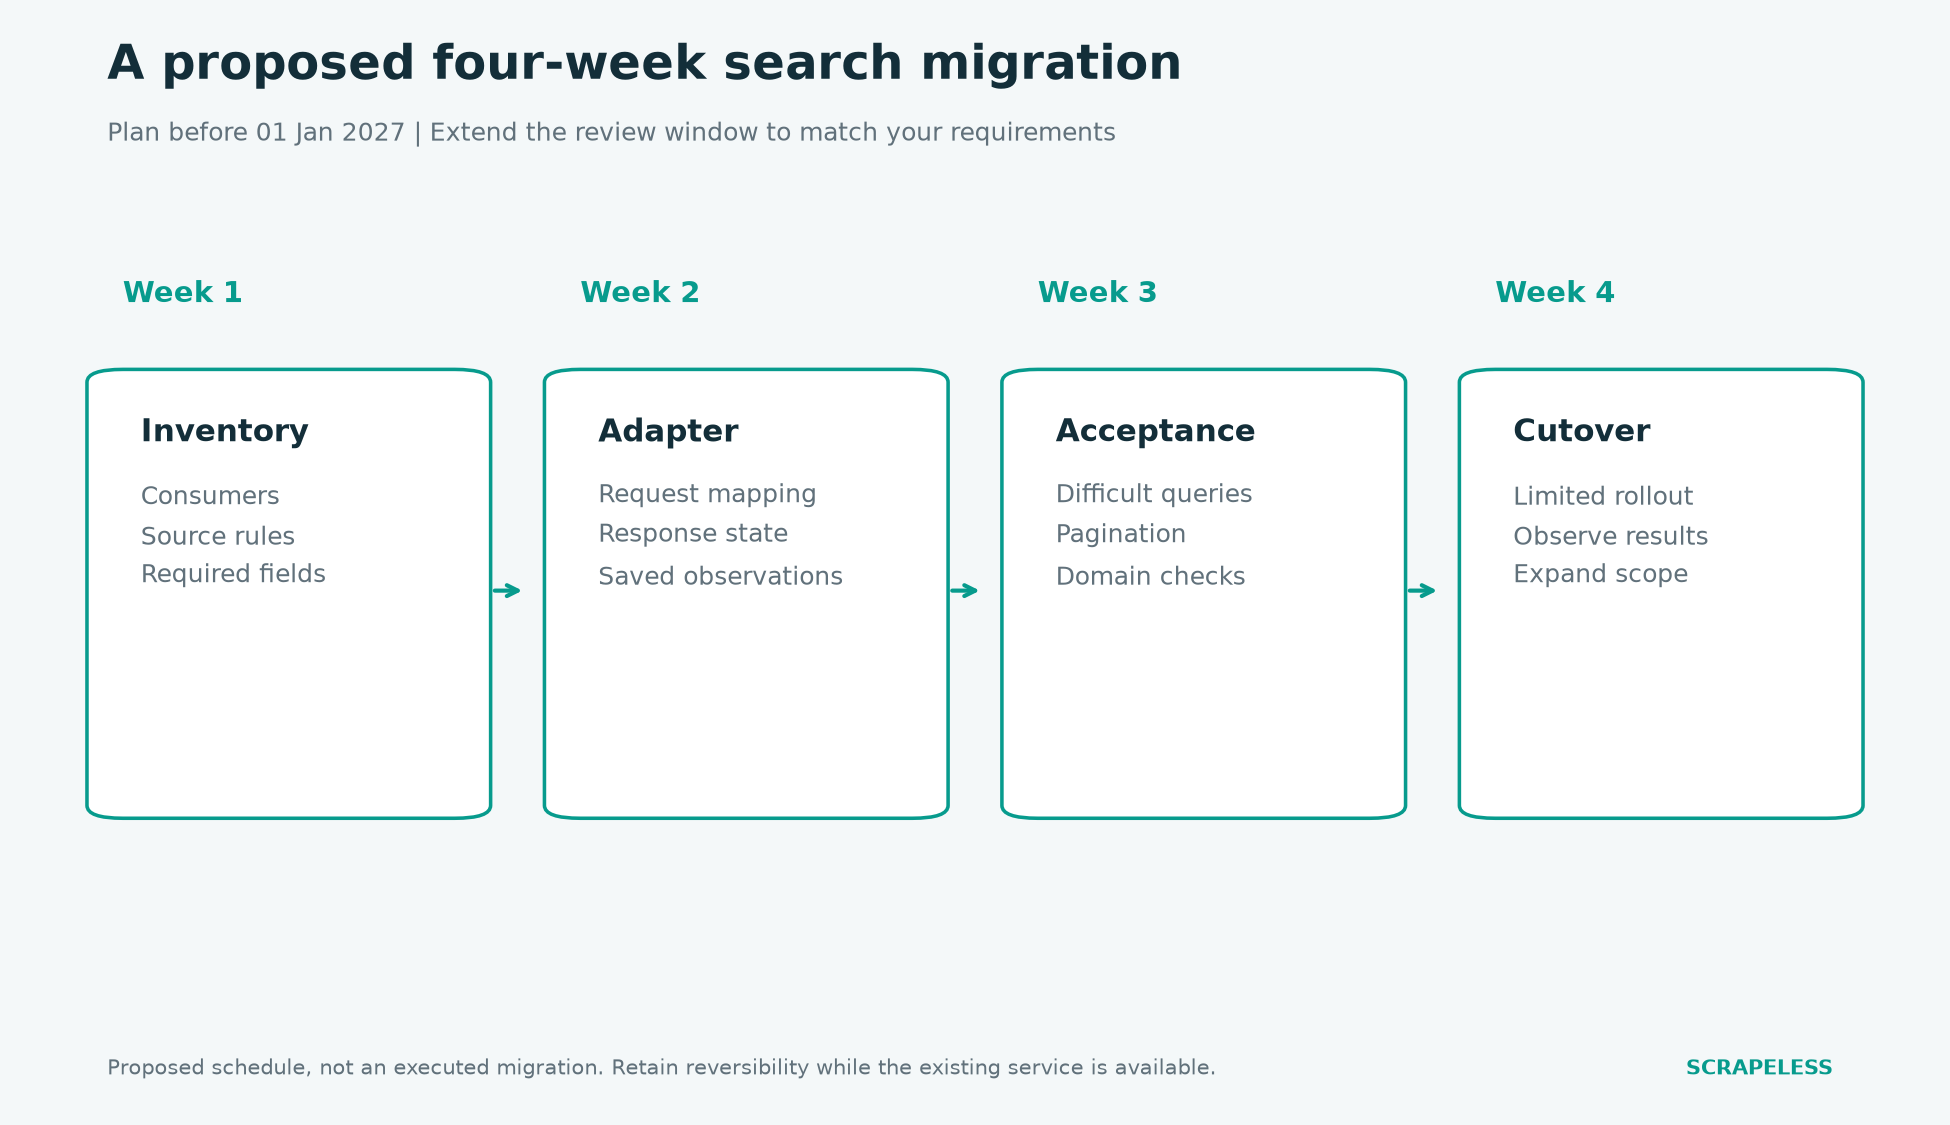
चित्र 2. प्रस्तावित माइग्रेशन प्रक्रिया। प्रत्येक चरण की एक स्पष्ट निकास शर्त है; यह किसी निष्पादित माइग्रेशन की रिपोर्ट नहीं है।
एक व्यावहारिक माइग्रेशन उदाहरण: डॉक्यूमेंटेशन फ़ाइंडर
डॉक्यूमेंटेशन फ़ाइंडर तब सफल होता है जब वह प्रासंगिक, अनुमत स्रोत पेज लौटाए, जिनके गंतव्य कार्य कर रहे हों।
मान लें कि मौजूदा एप्लिकेशन अनुमोदित डॉक्यूमेंटेशन डोमेनों के सेट में खोज करता है और शीर्षक, स्निपेट, और क्लिक करने योग्य URL प्रदर्शित करता है। यह रैंकिंग चार्ट प्रदर्शित नहीं करता या सटीक परिणाम संख्या का वादा नहीं करता। ये एक उत्पाद आवश्यकता के उदाहरण हैं, न कि निष्पादित माइग्रेशन।
प्रतिस्थापन एडेप्टर संग्रह इंटरफ़ेस बदलते हुए भी वही दृश्य परिणाम रूप बनाए रख सकता है। यह क्वेरी भेजता है, प्रतिक्रिया प्राप्त करता है, प्रत्येक गंतव्य की पुष्टि करता है, अनुमत-डोमेन नियम लागू करता है, और केवल स्वीकृत रेकॉर्ड लौटाता है। यह निदान के लिए मूल प्रतिक्रिया को भी सुरक्षित रखता है। किसी खाली परिणाम को वैध खोज परिणाम के रूप में वर्गीकृत करने से पहले HTTP प्रतिक्रिया सिमेंटिक्स और प्रदाता की टास्क स्थिति जाँचें।
तीन मामलों के स्पष्ट परीक्षण होने चाहिए। बहुत से अनुमोदित मिलान वाली क्वेरी को उपयोगी सूची पैदा करनी चाहिए। बिना किसी अनुमोदित मिलान वाली क्वेरी को सत्यनिष्ठ खाली अवस्था पैदा करनी चाहिए। जिन क्वेरियों के परिणाम हल नहीं किए जा सकते, उन्हें इस ढोंग के बजाय कि अनुमोदित कॉर्पस में कोई प्रासंगिक पेज नहीं हैं, एक अनुपलब्ध या अपूर्ण अवस्था पैदा करनी चाहिए।
URL तुलना परिभाषित करने के लिए URI साधारणीकरण मॉडल का उपयोग करें, फिर अपने उत्पाद की डोमेन नीति जोड़ें। URL स्ट्रिंग के भीतर टेक्स्ट का मिलान पर्याप्त डोमेन जाँच नहीं है।
डॉक्यूमेंटेशन फ़ाइंडर की जगह किसी शोध सहायक के लिए, search-to-RAG वर्कफ़्लो इस खोज चरण के बाद पैसेज रिट्रीवल और साक्ष्य समीक्षा जोड़ता है। Universal Scraping API को समर्थित सार्वजनिक स्रोत पेज फ़ेच करने के लिए अलग से मूल्यांकित किया जा सकता है।
समय सीमा से पहले एक व्यावहारिक कटओवर योजना
सुरक्षित कटओवर मौजूदा सेवा उपलब्ध रहते हुए अर्थगत अंतर खोजने के लिए समय छोड़ देता है।
निम्नलिखित चार-सप्ताह का क्रम एक प्रस्तावित शेड्यूल है, कोई विक्रेता गारंटी नहीं। अधिक कड़े आवश्यकताओं वाली टीमों को पहले शुरू करना चाहिए और समीक्षा विंडो बढ़ानी चाहिए।
| चरण | मुख्य कार्य | निकास शर्त |
|---|---|---|
| सप्ताह 1 | उपभोक्ता, इंजन कॉन्फ़िगरेशन, और आवश्यक फ़ील्ड की सूची बनाएं | प्रत्येक आवश्यक व्यवहार का एक स्वामी और स्वीकृति नियम हो |
| सप्ताह 2 | एडेप्टर बनाएँ और प्रतिनिधिक प्रतिक्रियाएँ कैप्चर करें | अनुरोध और साधारणीकृत रेकॉर्ड साथ-साथ निरीक्षण किए जा सकें |
| सप्ताह 3 | कठिन क्वेरी की तुलना करें, स्रोत प्रतिबंध, और पेजिनेशन | भौतिक अंतर हल कर दिए गए हों या स्पष्ट रूप से स्वीकार किए गए हों |
| सप्ताह 4 | एक सीमित उपभोक्ता समूह को स्विच करें, अवलोकन करें, फिर विस्तार करें | परिचालन मालिक असफलताओं का निदान कर सकते हैं और पुराने सर्विस उपलब्ध रहते हुए स्विच को उलट सकते हैं |
यदि प्रतिस्थापन खोज सेमान्टिक्स बदलता है तो एक नई मापन सीमा दर्ज करें। ऐतिहासिक चार्ट को प्रदाता संक्रमण की पहचान करनी चाहिए; अन्यथा किसी कलेक्शन परिवर्तन को बाज़ार की हलचल समझा जा सकता है।
लागू Scrapeless प्राइसिंग की समीक्षा करें और माइग्रेशन बजट में अस्थायी समानांतर कलेक्शन को शामिल करें। सस्ता स्थायी-स्थिति रिक्वेस्ट मॉडल ज़रूरी नहीं कि सबसे सस्ता माइग्रेशन हो, यदि एडेप्टर को डाउनस्ट्रीम में व्यापक बदलावों की आवश्यकता पड़ती है।
विस्तृत Google Search API विकल्प चर्चा सामान्य प्रदाता चयन को संबोधित करती है, जबकि केन्द्रित Serper विकल्प तुलना एक व्यावसायिक निर्णय को सीमित करने में मदद करती है। ऊपर दिया गया माइग्रेशन अनुबंध, आप जो भी प्रदाता चुनें, उस पर लागू होना चाहिए।
निष्कर्ष
Scrapeless Google वेब-खोज डेटा वर्कफ़्लो के लिए मूल्यांकन करने वाला पहला विकल्प है, जबकि Serper, Oxylabs, और SearchAPI.io अतिरिक्त SERP मार्ग प्रदान करते हैं। Scrapeless के पास उस प्राथमिकता के पीछे विशिष्ट प्रमाण हैं: Serper की तुलना में मज़बूत स्निपेट कवरेज और परीक्षण किए गए Oxylabs इंटरफ़ेस से कम विलंबता के साथ अधिक उपयोगी प्रतिक्रियाएँ। जब उत्पाद की वास्तविक आवश्यकता शोध साक्ष्य हो, तो Linkup प्रासंगिक है। नियंत्रित साइट खोज अपने अलग आर्किटेक्चर निर्णय की हकदार है।
व्यवहार इन्वेंटरी से शुरू करें, प्रतिनिधि क्वेरी के खिलाफ एडेप्टर को मान्य करें, और 01-Jan-2027 से पहले एक वास्तविक कटओवर विंडो आरक्षित करें। माइग्रेशन तब पूरा होता है जब उपयोगकर्ताओं को अपेक्षित व्यवहार प्राप्त होता है, न कि केवल तब जब नया एंडपॉइंट प्रतिक्रिया देता है।
क्या आप अपनी सर्च माइग्रेशन की योजना बनाने के लिए तैयार हैं?
Discord और Telegram पर कार्यान्वयन विकल्पों पर चर्चा करें।
अपना वर्तमान रिज़ल्ट कॉन्ट्रैक्ट और प्रतिनिधि क्वेरी के एक छोटे सेट के साथ app.scrapeless.com से शुरुआत करें।
सामान्य प्रश्न (FAQ)
प्रश्न: मौजूदा ग्राहकों के लिए Google Custom Search JSON API कब समाप्त होता है?
Google का कहना है कि मौजूदा ग्राहकों को 01-Jan-2027 तक किसी विकल्प पर स्थानांतरित होना होगा। यह API नए ग्राहकों के लिए पहले से ही बंद है। यह नोटिस Custom Search JSON API से संबंधित है, न कि हर Google सर्च उत्पाद से।
प्रश्न: क्या Scrapeless ड्रॉप-इन रिप्लेसमेंट है?
Scrapeless को एक रिप्लेसमेंट बैकएंड के रूप में माना जाना चाहिए जिसे एडेप्टर और स्वीकृति परीक्षण की आवश्यकता होती है। इंजन कॉन्फ़िगरेशन, पेजिनेशन, रिस्पॉन्स फ़ील्ड, और डेस्टिनेशन हैंडलिंग के लिए स्पष्ट निर्णयों की ज़रूरत होती है।
प्रश्न: क्या कोई रिप्लेसमेंट पुराना सर्च इंजन ID संरक्षित रख सकता है?
Custom Search इंजन ID, Google की सर्विस में कॉन्फ़िगरेशन की पहचान करता है। कोई दूसरा प्रदाता उस कॉन्फ़िगरेशन को अपने आप इम्पोर्ट नहीं करता। अपने एप्लिकेशन को जिन स्रोत नियमों की आवश्यकता है उन्हें फिर से बनाएँ और मान्य करें।
प्रश्न: क्या पुरानी पेजिनेशन वैल्यूज़ को बिना बदलाव कॉपी किया जा सकता है?
नहीं। Custom Search का फ़र्स्ट-रिज़ल्ट इंडेक्स और Scrapeless का प्रलेखित वेब-खोज ऑफ़सेट अलग हैं। सामान्य दस-रिज़ल्ट पेज सीमा के लिए, पुराने स्टार्ट 1, 11, और 21 क्रमशः उम्मीदवार ऑफ़सेट 0, 10, और 20 से मेल खाते हैं, एंडपॉइंट वैलिडेशन के अधीन।
प्रश्न: AI रिसर्च फ़ीचर के लिए कौन‑सा विकल्प सबसे अच्छा है?
जब फ़ीचर को Google-आधारित खोज तथा एप्लिकेशन-नियंत्रित साक्ष्य-संग्रहण की आवश्यकता हो, तो Scrapeless उपयुक्त है। Linkup जैसे शोध-उन्मुख सर्विस एक पुनःडिज़ाइन किए गए रिट्रीवल वर्कफ़्लो में बेहतर बैठ सकती है। परिणामों के समान क्रम को मान लेने के बजाय स्रोत समर्थन का मूल्यांकन करें।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





