
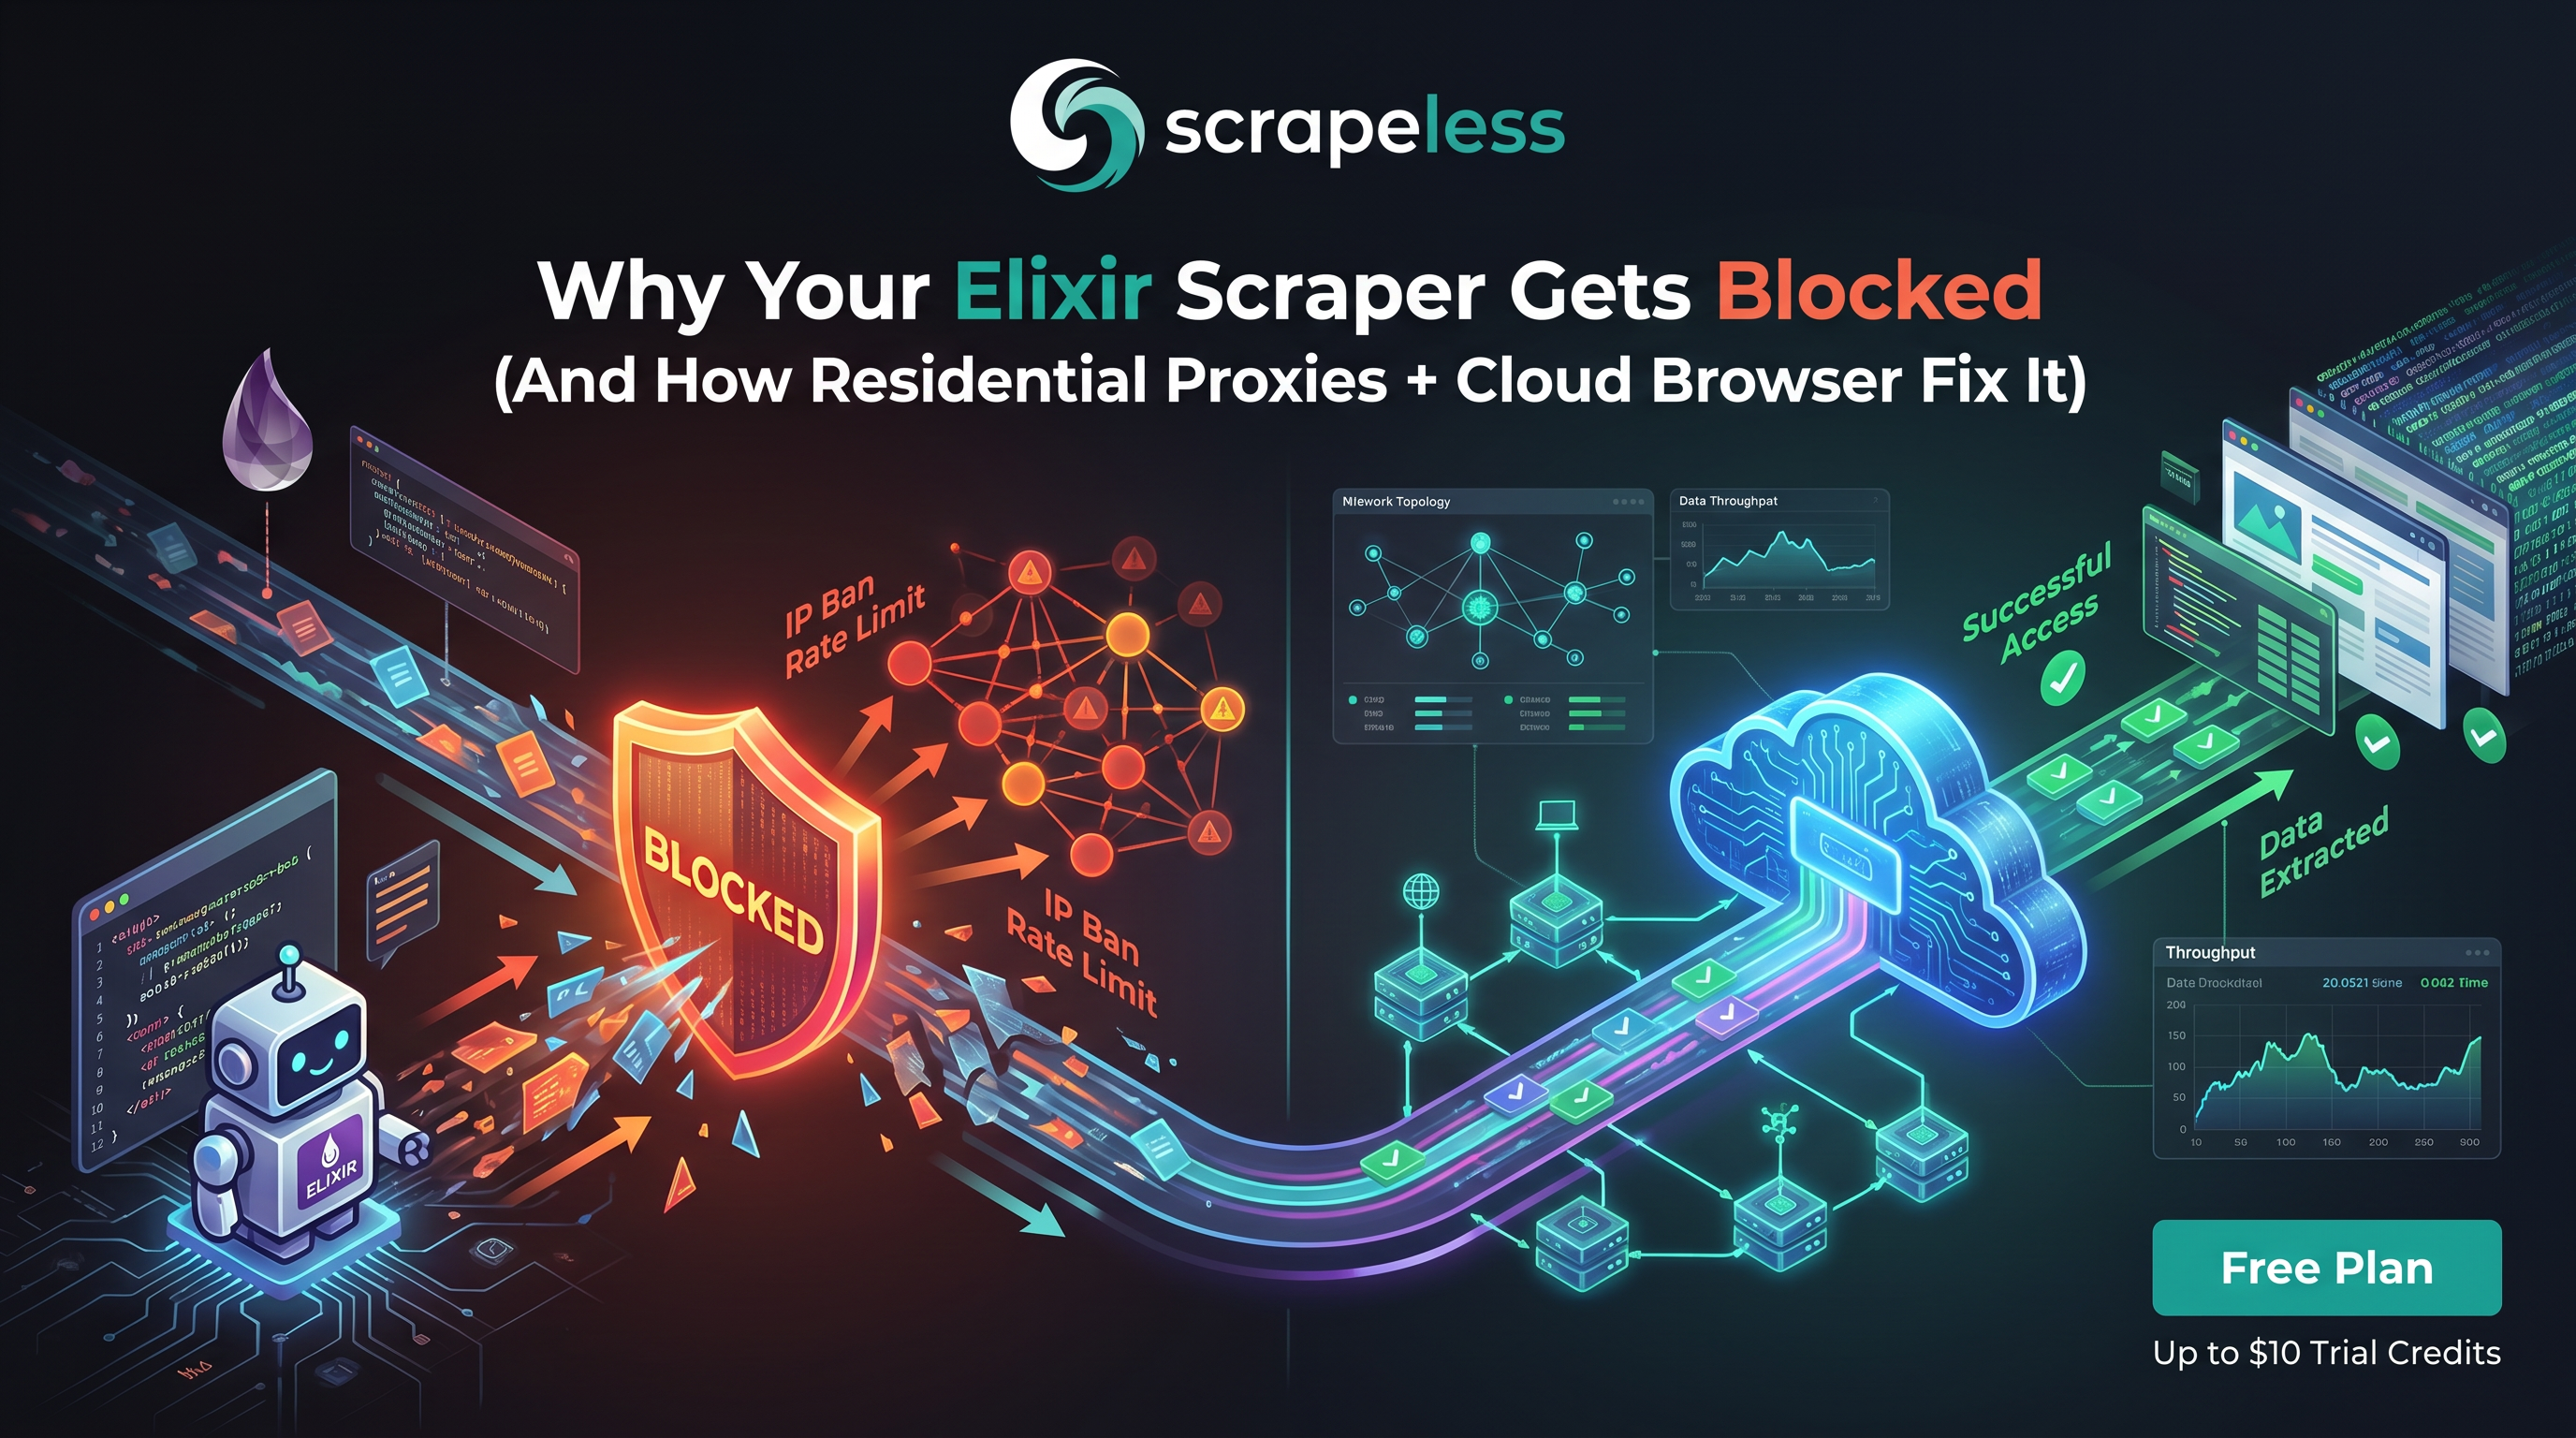
क्यों आपका एलिक्सिर स्क्रेपर ब्लॉक होता है, और कैसेResidential Proxies + Cloud Browser इसे ठीक करते हैं
Scraping and Proxy Management Expert
मुख्य निष्कर्ष:
- Elixir समवर्ती स्क्रैपिंग के लिए बनाया गया है। BEAM रनटाइम हजारों हल्के प्रक्रियाओं को एक नोड पर बुनता है, इसलिए एक क्रॉल जो सैकड़ों URL के बीच फैलता है, उसे एक साधारण
Task.async_streamके रूप में चलाने की अनुमति देता है, बजाय इसके कि आपको एक थ्रेड पूल की देखभाल करनी पड़े। - Req और HTTPoison फेच करते हैं, Floki पार्स करता है।
Reqआधुनिक, बैटरी से भरा HTTP क्लाइंट है;HTTPoisonदीर्घकालिक हैकनी-बैक विकल्प है;Flokiकच्चे HTML को एक पेड़ में परिवर्तित करता है जिसे आप CSS सेलेक्टर्स के साथ क्वेरी कर सकते हैं। सभी मिलकर वे किसी भी पेज को कवर करते हैं जो प्रस्तुत मार्कअप के साथ भेजा गया है। - Crawly संपूर्ण क्रॉलिंग ढांचा है। यह श्रमिकों के बीच अनुरोधों की योजना बनाता है, फॉलो-अप अनुरोधों के माध्यम से पृष्ठांकन को संभालता है, उपयोगकर्ता-एजेंट रोटेशन और अनुरोध विकल्पों के लिए मिडलवेयर लागू करता है, और पार्स किए गए आइटमों को एक पाइपलाइन के नीचे धकेलता है — Scrapy की तरह, लेकिन BEAM पर।
- Scrapeless रेजिडेंशियल प्रॉक्सी फेच को रूट करती हैं। एकल प्रॉक्सी होस्ट, पोर्ट, और बुनियादी ऑथ हेडर सीधे
Reqकेconnect_options, HTTPoison के:proxy/:proxy_auth, या Crawly केRequestOptionsमिडलवेयर में प्लग होते हैं, हर अनुरोध को एक रेजिडेंशियल आईपी प्रदान करते हुए और बाहरी भूगोल को सुनिश्चित करते हैं। - JS-भारी और एंटीबाट लक्ष्यों के लिए Scrapeless स्क्रैपिंग ब्राउज़र में बढ़ते हैं। Elixir Chrome DevTools प्रोटोकॉल को Node या Python की तरह स्पष्ट रूप से नहीं चलाता है, इसलिए क्लाउड ब्राउज़र दो तरीकों से पहुँचा जाता है: प्रस्तुत किए गए अधिकांश के लिए Scrapeless रेजिडेंशियल प्रॉक्सियों के माध्यम से HTTP अनुरोध, और क्लाइंट-साइड-प्रस्तुत अल्पसंख्यक के लिए एक छोटा क्लाउड-ब्राउज़र कॉल-आउट।
- शुरू करने के लिए फ्री। नए Scrapeless खातों में मुफ्त स्क्रैपिंग ब्राउज़र रनटाइम शामिल है — app.scrapeless.com पर साइन अप करें।
परिचय: Elixir क्यों, और जहाँ घर्षण शुरू होता है
Elixir BEAM पर चलता है, वही वर्चुअल मशीन जिसने दशकों से Erlang टेलीकॉम स्विच को ऑनलाइन रखा है। स्क्रैपिंग के लिए इसका विशिष्ट गुण सस्ता समवर्तीता है: दस हजार प्रक्रियाएं पैदा करना सामान्य है, प्रत्येक एकल, प्रत्येक एक सक्षम HTTP अनुरोध को बिना अन्य को रोके होल्ड कर सकती है। एक क्रॉल जिसे दूसरी भाषा में एक असिंक्रोनस फ्रेमवर्क और सावधानीपूर्वक पूल ट्यूनिंग की आवश्यकता होती है, Elixir में Task.async_stream के साथ max_concurrency कैप होती है।
लाइब्रेरी की कहानी परिपक्व है। Req और HTTPoison पृष्ठ फेच करते हैं, Floki उन्हें CSS सेलेक्टर्स के साथ पार्स करता है, और Crawly पूरे लूप को लपेटता है — अनुसूचि, डिडुप्लीकेशन, पृष्ठांकन, और आइटम पाइपलाइनों को एक Scrapy-शैली ढांचे में जो अभी भी प्रवृत्तात्मक Elixir जैसा लगता है। स्थैतिक श्रेणियों, साइटमैप, और सर्वर-निर्मित पृष्ठों के लिए, वह स्टैक अपने आप में पूर्ण है।
दो चीज़ें इसे तोड़ती हैं। पहला, आईपी प्रतिष्ठा: एक साफ़ डेटाकेंद्र पता उस पल झंडा उठा लेता है जब लक्षित स्थान यहां तक कि एक मूल बॉट प्रबंधक चलाता है, और कोई भी हेडर ट्यूनिंग रोकने वाले आईपी को ठीक नहीं करती है। दूसरा, क्लाइंट-साइड रेंडरिंग: एक एकल-पृष्ठ ऐप HTTP 200 को एक खाली <div id="app"> के साथ लौटाता है, और Floki ठीक वही पार्स करता है जो आया — कुछ नहीं। पृष्ठ एक ब्राउज़र में पूर्ण दिखता है और स्क्रैपर के लिए खाली होता है।
यह गाइड Elixir स्टैक को स्तरों में बनाती है। HTTP स्तर Req, HTTPoison, और Crawly का उपयोग करता है जो Scrapeless रेजिडेंशियल प्रॉक्सियों के माध्यम से 195+ देशों में रूटेड है। रेंडरड-JS स्तर Scrapeless स्क्रैपिंग ब्राउज़र पर बढ़ता है, जिसे Elixir से बिना BEAM को सीडीपी सीधे बोलने के लिए कहा जाता है। उन रेजिडेंशियल-प्रॉक्सी परत के लिए जो इन फ़ेचों को रूट करती हैं, SSL प्रॉक्सी क्या है? देखें।
आप क्या बना सकते हैं
दो-स्तरीय पैटर्न — Elixir पुस्तकालय सामने, Scrapeless वृद्धि के पीछे — अधिकांश कार्यों को कवर करता है जो एक साधारण HTTP स्क्रैपर को हराते हैं:
- समवर्ती सूची क्रॉल। साइटमैप, लेख आर्काइव, उत्पाद सूची —
Task.async_streamURL सेट के क्रॉस फैलती है लिमिटेड कार्यकर्ता की संख्या के साथ और हर पृष्ठ को Floki के माध्यम से पार्स करती है। - Crawly के साथ अनुसूचित मॉनिटरिंग। एक बार एक मकड़ी को परिभाषित करें, इसे एक शेड्यूल पर सूचियों के माध्यम से पृष्ठ की अनुमति दें, और पार्स किए गए आइटमों को मान्यता और भंडारण पाइपलाइन में धकेलें।
- भौगोलिक-विशिष्ट स्नैपशॉट। Scrapeless प्रॉक्सी देश को पिन करें ताकि कीमतें, उपलब्धता, और सहमति दीवारें वही दिखाएं जो एक स्थानीय उपयोगकर्ता देखता है, न कि जो आपके सर्वर का आईपी हल करता है।
- बॉट प्रबंधकों के पीछे मजबूत निष्कर्षण। Residential egress के माध्यम से फेच को रूट करें ताकि एक साधारण घरेलू आईपी, न कि डेटाकेंद्र रेंज, अनुरोध करे।
- RAG और LLM सेवन। प्रकाशक और दस्तावेज़ों के पृष्ठों को साफ़ पाठ में रेंडर करें, फिर निकाले गए सामग्री को एक एन्वेडिंग पाइपलाइन में डालें।
- SPA और अनंत-स्क्रॉल पृष्ठ। क्लाइंट-साइड-रेंडर किए गए अल्पसंख्यक को Scrapeless स्क्रैपिंग ब्राउज़र में बढ़ाएं, जो JavaScript को क्लाउड-साइड चलाता है इससे पहले कि आप परिणाम को पार्स करें।
Scrapeless के साथ Elixir क्यों जोड़ा जाए
Elixir आपको समवर्तीता, पार्सिंग, और एक क्रॉलिंग फ्रेमवर्क देता है; Scrapeless Scraping Browser वह बाहर जाने और रेंडरिंग प्लंबिंग प्रदान करता है जो एक सर्वर-साइड HTTP क्लाइंट नहीं कर सकता। दोनों एक साथ जुड़ते हैं क्योंकि हस्तांतरण एक मानक HTTP प्रॉक्सी पर एक तरफ और एक दस्तावेजित क्लाउड-ब्रह्मा एंडपॉइंट दूसरी तरफ होता है।
- 195+ देशों में आवासीय प्रॉक्सी। एकल प्रॉक्सी हॉस्ट, पोर्ट, और बेसिक-ऑथ क्रेडेंशियल के रूप में दिखाया गया — सीधे
Req,HTTPoison, या Crawly केRequestOptionsमिडलवेयर में डालें। - प्रति-निवेदन भूगोल पिनिंग। प्रॉक्सी उपयोगकर्ता नाम में एक देश कोड बिना किसी अतिरिक्त हैंडशेक के बाहर जाने की भूगोल को नियंत्रित करता है, इसलिए एक ही कोड US, GB, DE, या JP दृश्य प्राप्त करता है एक खंड को बदलकर।
- एंटी-डिटेक्शन क्लाउड ब्राउज़र। क्लाइंट-साइड-रेन्डर्ड पृष्ठों के लिए, Scrapeless Scraping Browser एक स्वयं-विकसित Chromium चलाता है जिसमें पूर्ण क्लाउड-साइड जावास्क्रिप्ट रेंडरिंग और प्रति-सेशन फिंगरप्रिंट यादृच्छिककरण होता है, इसलिए SPA और लेज़ी-लोडेड पैनल निकासी से पहले हाइड्रेट हो जाते हैं।
- दोनों स्तरों के लिए एक API कुंजी। आवासीय प्रॉक्सी और Scraping Browser एक ही Scrapeless खाते के खिलाफ बिल करते हैं, इसलिए HTTP स्तर और रेंडर किया गया स्तर एक ही क्रेडेंशियल साझा करते हैं।
- स्टिकी-सेशन विकल्प। जब प्रवाह को निरंतरता की आवश्यकता होती है तो कई चरणों में एक ही आवासीय IP को बनाए रखें, या अन्य सभी के लिए प्रति अनुरोध घुमाएं।
रनटाइम मुफ्त में शुरू होता है और उपयोग के साथ स्केल करता है — स्तरों के लिए Scrapeless मूल्य निर्धारण देखें, और app.scrapeless.com पर मुफ्त योजना पर अपनी API कुंजी प्राप्त करें।
पूर्वापेक्षाएँ
- Elixir 1.16+ और Erlang/OTP 26+ —
elixir --versionके साथ जांचें। - एक Scrapeless खाता और API कुंजी — app.scrapeless.com पर मुफ्त योजना के लिए साइन अप करें, फिर अपनी कुंजी Settings → API Key Management से प्राप्त करें।
- आवासीय-प्रॉक्सी क्रेडेंशियल — app.scrapeless.com पर Proxies → Residential के तहत डैशबोर्ड में दिखाई देते हैं।
mix, CSS सेलेक्टर्स, और टर्मिनल के साथ बुनियादी परिचय।
स्थापित करें: मिक्स प्रोजेक्ट और निर्भरता सेट करें
एक नया प्रोजेक्ट बनाएं और स्क्रैपिंग लाइब्रेरी जोड़ें। mix new संरचना को स्कैफोल्ड करता है; चार зависимостей डेटा खींचने (req, httpoison), पार्सिंग (floki), और पूर्ण क्रॉलिंग फ्रेमवर्क (crawly) को कवर करते हैं:
bash
mix new elixir_scraper --sup
cd elixir_scraper
mix.exs में निर्भरताएँ जोड़ें:
elixir
# mix.exs
defp deps do
  [
    {:req, "~> 0.5"},        # आधुनिक HTTP क्लाइंट (फिन्च/मिंट के तहत)
    {:httpoison, "~> 2.2"},  # हैकनी-बैक किए गए HTTP क्लाइंट, लंबे समय से विकल्प
    {:floki, "~> 0.36"},     # CSS-सेलेक्टर क्वेयरियों के साथ HTML पार्सर
    {:crawly, "~> 0.17"}     # पूर्ण क्रॉलिंग फ्रेमवर्क, Scrapy-शैली
  ]
end
फिर उन्हें खींचें:
bash
mix deps.getआपको एक असली प्रोजेक्ट में सभी चार की जरूरत नहीं है — req और floki न्यूनतम खींचने और पार्स करने का जोड़ा है। गाइड प्रत्येक को दिखाता है ताकि आप अपने स्टैक के लिए उपयुक्त क्लाइंट चुन सकें।
कॉन्फ़िगर करें: अपने Scrapeless क्रेडेंशियल्स संग्रहीत करें
अपने API कुंजी और आवासीय-प्रॉक्सी क्रेडेंशियल को पर्यावरण चर के रूप में निर्यात करें ताकि वे स्रोत नियंत्रण से दूर रहें। डैशबोर्ड में Proxies → Residential के तहत, Generate पर क्लिक करें और पैनल एक कॉलन-प्रतिभाजित कनेक्शन स्ट्रिंग प्रिंट करता है इस रूप में <GATEWAY>:<PORT>:<CHANNEL_ID>-proxy-country_US-r_10m-s_<SESSION_ID>:<PASSWORD>:
bash
export SCRAPELESS_API_KEY="your_api_token_here"
export SCRAPELESS_CHANNEL_ID="your_channel_id"          # उपयोगकर्ता नाम की शुरुआत में प्रिंट किया गया
export SCRAPELESS_PROXY_PASS="your_channel_password"
export SCRAPELESS_PROXY_GATEWAY="gw-us.scrapeless.io"   # नीचे क्षेत्रीय गेटवे देखें
क्षेत्रीय गेटवे: gw-us.scrapeless.io (अमेरिका), gw-eu.scrapeless.io (यूरोप), gw-ap.scrapeless.io (एशिया-प्रशांति)। अपने रनटाइम के लिए निकटतम गेटवे चुनें ताकि हैंडशेक विलंबता कम हो; बाहर जाने वाला देश अभी भी country_<CC> उपयोगकर्ता नाम खंड द्वारा नियंत्रित होता है चाहे आप किसी भी गेटवे के माध्यम से कनेक्ट करें। पोर्ट सभी के लिए 8789 है।
आवासीय-प्रॉक्सी उपयोगकर्ता नाम चार पैरामीटर से बनाया गया है:
<CHANNEL_ID>— आपका चैनल पहचानकर्ता (डैशबोर्ड पर उपयोगकर्ता नाम की शुरुआत में प्रिंट किया गया)।country_<CC>— दो-लेटर ISO कोड के रूप में देश पिन:country_US,country_GB,country_DE,country_JP, आदि (डैशबोर्ड स्थान चयनकर्ता में दिखाए गए कोड का उपयोग करें)।r_<duration>— स्टिकी-सेशन रोटेशन अंतराल (जैसेr_10m10 मिनट के लिए वही IP बनाए रखता है फिर रोटेट करता है)।s_<SESSION_ID>— स्थायी-सत्र पहचानकर्ता; चक्र का उपयोग करते समय अनुरोधों के लिए एक हीs_<id>को पुनः उपयोग करें।
r_ और s_ खंडों को एक नए आवासीय आईपी के लिए अनुरोध के लिए छोड़ दें; जब पृष्ठबद्ध यात्रा को एक ही आईपी की आवश्यकता हो, तो उन्हें रखें।
मूल: आवासीय प्रॉक्सी के माध्यम से Req के साथ फ़ेच करें, Floki के साथ विश्लेषण करें
Req एक HTTP प्रॉक्सी के माध्यम से रूट करता है जिसमें :connect_options कुंजी होती है, जिसे यह नीचे फ़िन्च और मिंट को अग्रेषित करता है। प्रॉक्सी प्रमाणीकरण को :proxy_headers में एकल बेसिक-ऑथ हेडर के रूप में लागू किया जाता है — मिंट इसे कनेक्ट अनुरोध में मिला देता है। उपयोगकर्ता नाम देश का पिन ले जाता है, इसलिए प्रॉक्सी लाइन स्वयं निकासी भूगोल का चयन करती है:
elixir
defmodule ElixirScraper.ReqClient do
  @gateway System.get_env("SCRAPELESS_PROXY_GATEWAY") || "gw-us.scrapeless.io"
  @port 8789

  # देश के पिन के साथ आवासीय-प्रॉक्सी उपयोगकर्ता नाम बनाएं।
  defp proxy_username(country) do
    channel = System.fetch_env!("SCRAPELESS_CHANNEL_ID")
    "#{channel}-proxy-country_#{country}"
  end

  defp proxy_auth_header(country) do
    user = proxy_username(country)
    pass = System.fetch_env!("SCRAPELESS_PROXY_PASS")
    "Basic " <> Base.encode64("#{user}:#{pass}")
  end

  @doc "`country` में Scrapeless आवासीय निकासी के माध्यम से एक URL फ़ेच करें।"
  def fetch(url, country \\ "US") do
    Req.get(url,
      connect_options: [
        proxy: {:http, @gateway, @port, []},
        proxy_headers: [{"proxy-authorization", proxy_auth_header(country)}]
      ],
      headers: [{"user-agent", "Mozilla/5.0 (compatible; ElixirScraper/1.0)"}]
    )
  end
end
इसे कॉल करें और बॉडी को सीधे Floki को सौंप दें। Floki.parse_document/1 HTML स्ट्रिंग को एक पेड़ में बदल देता है; Floki.find/2 इसे CSS चयनकर्ताओं के साथ क्वेरी करता है; Floki.text/1 और Floki.attribute/2 मूल्य निकालते हैं:
elixir
{:ok, resp} = ElixirScraper.ReqClient.fetch("https://books.toscrape.com/")
{:ok, document} = Floki.parse_document(resp.body)

titles =
  document
  |> Floki.find("article.product_pod h3 a")
  |> Floki.attribute("title")

prices =
  document
  |> Floki.find("article.product_pod p.price_color")
  |> Floki.text()

IO.inspect(Enum.zip(titles, prices), label: "पहला पृष्ठ")
यह तीन चीजें जल्दी लॉक करता है:
- प्रॉक्सी को हर अनुरोध के लिए कॉन्फ़िगर किया गया है, वैश्विक रूप से नहीं। यह एक क्लाइंट को विभिन्न देशों को खींचने के लिए मुक्त रखता है जिससे वह एक अलग
countryतर्क पास करता है। - बेसिक-ऑथ हेडर लोड-बियरिंग लाइन है। बिना
proxy_headersके, आवासीय गेटवे के लिए कनेक्ट टनल को प्रमाण पत्र के अभाव में अस्वीकार कर दिया जाता है। - Floki पार्स की गई पेड़ पर क्वेरी करता है, कच्ची स्ट्रिंग पर नहीं। हमेशा पहले
parse_document/1, फिरfind/2— चयनकर्ता पेड़ के खिलाफ चलाते हैं।
उन्नत 1: HTTPoison संस्करण
HTTPoison Req से पहले का है और मौजूदा कोडबेस में सामान्य रहता है। यह हैकनी द्वारा समर्थित है, जो दो अनुरोध विकल्पों के माध्यम से प्रॉक्सी उजागर करता है: :proxy जैसे एक {host, port} युग्म और :proxy_auth जैसे एक {user, password} युग्म। मैन्युअल बेस64 नहीं — हैकनी हेडर का निर्माण करता है:
elixir
defmodule ElixirScraper.HTTPoisonClient do
  @gateway System.get_env("SCRAPELESS_PROXY_GATEWAY") || "gw-us.scrapeless.io"
  @port 8789

  defp proxy_username(country) do
    channel = System.fetch_env!("SCRAPELESS_CHANNEL_ID")
    "#{channel}-proxy-country_#{country}"
  end

  def fetch(url, country \\ "US") do
    opts = [
      proxy: {@gateway, @port},
      proxy_auth: {proxy_username(country), System.fetch_env!("SCRAPELESS_PROXY_PASS")},
      recv_timeout: 30_000
    ]

    headers = [{"User-Agent", "Mozilla/5.0 (compatible; ElixirScraper/1.0)"}]

    case HTTPoison.get(url, headers, opts) do
      {:ok, %HTTPoison.Response{status_code: 200, body: body}} -> {:ok, body}
      {:ok, %HTTPoison.Response{status_code: code}} -> {:error, {:http, code}}
      {:error, reason} -> {:error, reason}
    end
  end
end
विश्लेषण का आधा भाग समान है — HTTPoison एक बॉडी स्ट्रिंग लौटाता है, और Floki बाकी काम करता है। नए कोड के लिए Req चुनें (यह JSON डिकोडिंग, रीडायरेक्ट्स, और कनेक्शन पूलिंग को बक्से से बाहर लाता है) और HTTPoison जब आप पहले से इसके आधार पर परियोजना का विस्तार कर रहे हैं।
उन्नत 2: पृष्ठबद्धता और प्रॉक्सी निकासी के साथ Crawly मकड़ी
किसी भी चीज़ के लिए जो URLs की छोटी संख्या से अधिक है, Crawly हाथ से रोल की गई लूप को बदलता है। एक मकड़ी अपनी प्रारंभिक URLs और एक parse_item/1 कॉलबैक की घोषणा करती है; Crawly कार्यकर्ताओं के बीच अनुरोध शेड्यूल करता है, नए अनुरोधों का अनुसरण करता है जो कॉलबैक लौटाता है (यही पृष्ठबद्धता का तरीका है), और parsed आइटमों को एक पाइपलाइन में धकेलता है।
प्रॉक्सी को RequestOptions मिडलवेयर के माध्यम से जोड़ें। यह सीधे निचले HTTPoison फ़ेच के लिए इसकी कीवर्ड सूची पास करता है, इसलिए HTTPoison संस्करण से वही :proxy और :proxy_auth विकल्प मकड़ी द्वारा किए गए हर अनुरोध पर लागू होते हैं:
elixir
# config/config.exs
import Config

config :crawly,
  closespider_itemcount: 200,
  concurrent_requests_per_domain: 3,
  middlewares: [
    Crawly.Middlewares.DomainFilter,
    Crawly.Middlewares.UniqueRequest,
    {Crawly.Middlewares.UserAgent,
यूजर_एजेंट: ["Mozilla/5.0 (संगत; ElixirScraper/1.0)"]},
{Crawly.Middlewares.RequestOptions,
[
प्रॉक्सी: {System.get_env("SCRAPELESS_PROXY_GATEWAY", "gw-us.scrapeless.io"), 8789},
प्रॉक्सी_प्राधिकरण:
{"#{System.fetch_env!("SCRAPELESS_CHANNEL_ID")}-proxy-country_US",
System.fetch_env!("SCRAPELESS_PROXY_PASS")},
रिसीव_टाइमआउट: 30_000
]}
],
पाइपलाइन्स: [
Crawly.Pipelines.Validate,
{Crawly.Pipelines.DuplicatesFilter, item_id: :title},
Crawly.Pipelines.JSONEncoder,
{Crawly.Pipelines.WriteToFile, extension: "jl", folder: "./output"}
]
स्पाइडर स्वयं तीन कॉलबैक लागू करता है। `parse_item/1` दो काम एक साथ करता है: यह वर्तमान पृष्ठ पर आइटम निकालता है, और यह अगले पृष्ठ के लिए फॉलो-अप अनुरोध बनाता है - वह दूसरा सूची पृष्ठीकरण को चालित करता है:

```elixir
defmodule BooksSpider do
  use Crawly.Spider

  @impl Crawly.Spider
  def base_url, do: "https://books.toscrape.com/"

  @impl Crawly.Spider
  def init, do: [start_urls: ["https://books.toscrape.com/"]]

  @impl Crawly.Spider
  def parse_item(response) do
    {:ok, document} = Floki.parse_document(response.body)

    # इस पृष्ठ पर प्रत्येक उत्पाद कार्ड से एक आइटम निकालें।
    आइटम =
      document
      |> Floki.find("article.product_pod")
      |> Enum.map(fn कार्ड ->
        %{
          शीर्षक: कार्ड |> Floki.find("h3 a") |> Floki.attribute("title") |> List.first(),
          कीमत: कार्ड |> Floki.find("p.price_color") |> Floki.text()
        }
      end)

    # अगले पृष्ठ के अनुरोध का निर्माण करें: यह सूची Crawly को पृष्ठीकृत करती है।
    अगले_अनुरोध =
      document
      |> Floki.find("li.next a")
      |> Floki.attribute("href")
      |> Enum.map(fn href ->
        href
        |> Crawly.Utils.build_absolute_url(response.request_url)
        |> Crawly.Utils.request_from_url()
      end)

    %Crawly.ParsedItem{items: आइटम, requests: अगले_अनुरोध}
  end
end
इसे iex -S mix से चलाएँ:
elixir
Crawly.Engine.start_spider(BooksSpider)Crawly हर पृष्ठ को li.next a लिंक द्वारा चलाता है जो कॉलबैक वापस करता है, प्रत्येक मान्य, डुप्लिकेट रहित आइटम को ./output/BooksSpider.jl में लिखता है, और closespider_itemcount पर रुकता है। प्रत्येक अनुरोध Scrapeless आवासीय प्रॉक्सी के माध्यम से जाता है क्योंकि RequestOptions मिडलवेयर ने अनुरोध को पहले fetcher चलाने से पहले :proxy और :proxy_auth विकल्पों को इंजेक्ट किया था।
अपनी API कुंजी मुफ्त योजना पर प्राप्त करें: app.scrapeless.com
بلاکس سے بچنا: رہائشی ایگزٹ، جغرافیائی پننگ، اور بیک پریشر
ایک اسکرپر کو قابل پیش گوئی وجوہات کی بناء پر بلاک کیا جاتا ہے، اور ان میں سے زیادہ تر آپ کے پاس پہلے سے موجود ترتیب سے حل ہو سکتے ہیں:
- ڈیٹا سینٹر آئی پی کی شہرت۔ سرور کی آئی پی رینج وہ پہلا اشارہ ہے جو ایک بوٹ منیجر چیک کرتا ہے۔ Scrapeless رہائشی پروکسی کے ذریعے راؤٹنگ کو درخواست کی طرح ایک عام گھر کے کنیکشن کی طرح دکھاتا ہے، جو آئی پی-شہرت بلاکس کے خلاف سب سے بڑا لیور ہے۔
- ایگزٹ جغرافیہ۔ صفحات ملک کے لحاظ سے مواد کو گیٹ کرتے ہیں - قیمتیں، اسٹاک، رضامندگی کی دیواریں۔
country_<CC>صارف نام کے حصے کے ساتھ ملک کو پن کریں تاکہ نتیجہ اس مقامی علاقے کے ساتھ ملتا ہو جسے آپ پڑھنے کا ارادہ رکھتے ہیں۔ - حملے کی طرح لگتا ہے۔ تمام درخواستوں کی زیادہ سے زیادہ متوازی تعداد ≤3 درخواستیں فی میزبان پر رکھیں۔
Task.async_streamکے ساتھ، یہmax_concurrency: 3ہے؛ Crawly کے ساتھ، یہconcurrent_requests_per_domain: 3ہے۔ اس سے زیادہ، ایک تنگ ان فلائٹ پول زراعت سے بے حد مشابہ ہے۔ - ڈিফالٹ صارف ایجنٹ۔
ReqاورHTTPoisonایک لائبریری-ڈیفالٹ UA بھیجتے ہیں، جسے فلٹر کرنا آسان ہوتا ہے۔ ایک حقیقی براؤزر صارف ایجنٹ مرتب کریں (جیسے اوپر کے نمونوں میں) یا Crawly کےUserAgentمڈل ویئر کے ذریعے فہرست کو گھمائیں۔ - پیاسا کرنا۔ غیر-Crawly لوپس کے لئے، بیچوں کے درمیان چھوٹے
Process.sleep/1کے ساتھ درخواستوں کی جگہ کریں بجائے اس کے کہ پورے سیٹ کو ایک ساتھ فائر کریں۔ Crawly آپ کے لئے اپنے شیڈولر کے ذریعے درخواستوں کی رفتار دیتا ہے۔
یہ کوئی صفحہ بچانے کے لئے نہیں ہے جس کا مواد پہلے پینٹ کے بعد جاوا اسکرپٹ کے ذریعہ آتا ہے - یہ اگلا سیکشن ہے۔
JS-ہیوی اور اینٹی-بوٹ اہداف: Scrapeless Scraping Browser کے ذریعے راستہ بنانا
Req، HTTPoison، اور Crawly تمام اصل سے آنے والے بائٹس کو واپس کرتے ہیں۔ ایک React، Vue، یا Next.js ایپ کے لئے، وہ بائٹس ایک خالی شیل کے ساتھ ساتھ ایک اسکرپٹ ٹیگ ہیں - مواد کلائنٹ کے سائیڈ پر پینٹ ہوتا ہے، اور Floki ایک خالی درخت کو تجزیہ کرتا ہے۔ ایک سرور سائیڈ HTTP کلائنٹ اس جاوا اسکرپٹ کو نہیں چلا سکتا؛ ایک کلاؤڈ براؤزر کر سکتا ہے۔
ایلیکسیر سے Scrapeless Scraping Browser تک پہنچنے کے دو طریقے ہیں، اور وہ ایک حقیقی ورک لوڈ کے دو نصفوں سے ملتے ہیں۔
(a) Scrapeless رہائشی پروکسی کے ذریعے HTTP درخواستیں — تیار کردہ اکثریت
अधिकांश साइटों पर अधिकांश पृष्ठ सर्वर-रेंडर किए गए HTML के ساتھ आते हैं। उनके लिए, ऊपर दिया गया रेजिडेंशियल-प्रॉक्सी स्तर पूरी तरह से उत्तर है: Req और HTTPoison क्लाइंट पहले से ही एक रेजिडेंशियल आईपी के माध्यम से बाहर जाते हैं, जो बिना किसी ब्राउज़र के आईपी-प्रतिष्ठा गेट और भू-प्रतिबंधों को साफ करता है। उन पृष्ठों पर इस स्तर को बनाए रखें जो सीधे सामग्री लौटाते हैं — यह सबसे सस्ता रास्ता है, और एलिक्सिर की समवर्तीता इसे तेज बनाती है।
(बी) क्लाउड ब्राउज़र को कॉल करना — क्लाइंट-साइड-रेंडर की अल्पसंख्यक
एलिक्सिर Chrome DevTools प्रोटोकॉल को नोड या पायथन की तरह साफ तरीके से संचालित नहीं करता है, इसलिए जावास्क्रिप्ट-रेंडर की अल्पसंख्यक के लिए आदर्श कदम एलिक्सिर को संयोजक के रूप में बनाए रखना और एक छोटे रेंडरिंग सहायक के माध्यम से Scrapeless Scraping Browser को कॉल करना है। एलिक्सिर सहायक को System.cmd/3 के साथ एक बाहरी प्रक्रिया के रूप में स्पॉन करता है, सहायक क्लाउड ब्राउज़र के दस्तावेज़ित WebSocket एंडपॉइंट से कनेक्ट होता है, पृष्ठ को चलाता है, और रेंडर किया गया HTML एलिक्सिर को वापस प्रिंट करता है - जो इसे पहले की तरह फ्लोकी के साथ पार्स करता है।
क्लाउड-ब्राउज़र एंडपॉइंट एकल WebSocket URL है जिसमें आपका API कुंजी और सत्र पैरामीटर क्वेरी स्ट्रिंग मान के रूप में हैं। एक न्यूनतम पायथन रेंडरर (जिसे render.py के रूप में सहेजा गया है) इसे Playwright के साथ कनेक्ट करता है:
python
# render.py — जावास्क्रिप्ट-रेंडर की अल्पसंख्यक के लिए ELixir द्वारा System.cmd/3 के माध्यम से कॉल किया गया।
import os
import sys
from urllib.parse import urlencode
from playwright.sync_api import sync_playwright

def scraping_browser_url(proxy_country="US", session_ttl=240):
    params = urlencode({
        "token": os.environ["SCRAPELESS_API_KEY"],
        "sessionTTL": session_ttl,
        "proxyCountry": proxy_country,
    })
    return f"wss://browser.scrapeless.com/api/v2/browser?{params}"

def render(url, country="US"):
    with sync_playwright() as p:
        browser = p.chromium.connect_over_cdp(scraping_browser_url(country))
        context = browser.contexts[0] if browser.contexts else browser.new_context()
        page = context.pages[0] if context.pages else context.new_page()
        # पहले होमपेज को वार्म करें, फिर लक्षित पृष्ठ पर जाएं।
        page.goto("https://quotes.toscrape.com/", wait_until="load")
        page.goto(url, wait_until="networkidle")
        html = page.content()
        browser.close()
        return html

if __name__ == "__main__":
    sys.stdout.write(render(sys.argv[1], sys.argv[2] if len(sys.argv) > 2 else "US"))
रेंडरिंग क्लाउड-साइड Scrapeless के एंटी-डिटेक्शन ब्राउज़र में चलती है; लोकल Playwright इंस्टॉलेशन केवल प्रोटोकॉल क्लाइंट है। लक्षित पृष्ठ पर जाने से पहले होमपेज को वार्म करना कुकीज़ और नेविगेशन स्थिति को बीज देता है, जिससे पहले बार आगंतुकों पर पृष्ठों को साफ़ रेंडर करने में मदद मिलती है।
एलिक्सिर से, कॉल-आउट और पार्स एक ही फ़ंक्शन में रहते हैं। System.cmd/3 कॉलिंग प्रक्रिया को ब्लॉक करता है जब तक सहायक वापस नहीं लौटता — Task के अंदर ठीक है, क्योंकि बीम हर अन्य प्रक्रिया को चलाता है:
elixir
defmodule ElixirScraper.CloudBrowser do
  @doc """
  Scrapeless Scraping Browser के माध्यम से एक JS-भारी `url` रेंडर करें और
  फ्लोकी के लिए पार्स करने के लिए पोस्ट-पेंट HTML लौटाएं।
  """
  def render(url, country \\ "US") do
    case System.cmd("python", ["render.py", url, country], stderr_to_stdout: true) do
      {html, 0} -> {:ok, html}
      {output, code} -> {:error, {:render_failed, code, output}}
    end
  end

  def quotes(url) do
    with {:ok, html} <- render(url),
         {:ok, document} <- Floki.parse_document(html) do
      texts = document |> Floki.find("span.text") |> Floki.text()
      authors = document |> Floki.find("small.author") |> Floki.text()
      {:ok, %{quotes: texts, authors: authors}}
    end
  end
end
पहले/बाद में सारा मुद्दा है। एक साधारण Req.get पर https://quotes.toscrape.com/js/ 0 कोट तत्व लौटाता है, क्योंकि HTTP पृष्ठ के जावास्क्रिप्ट को निष्पादित नहीं कर सकता। ElixirScraper.CloudBrowser.render/2 के माध्यम से वही URL पूरी तरह से रेंडर की गई DOM के साथ सभी 10 कोट्स लौटाता है, क्योंकि क्लाउड ब्राउज़र ने पहले जावास्क्रिप्ट चलाया। यह प्लेटफ़ॉर्म व्यवहार है, न कि एक ट्यूनिंग ट्रिक।
एक स्तरित पाइपलाइन के लिए, पहले Req के साथ फ़ेच करें, उन तत्वों की गिनती करें जिनकी आप अपेक्षा करते हैं, और केवल उन पृष्ठों को CloudBrowser.render/2 पर ले जाएँ जो खाली लौटते हैं। एलिक्सिर का Task.async_stream HTTP स्तर को चौड़ा और ब्राउज़र स्तर को संकरा चलाता है, क्योंकि क्लाउड-ब्राउज़र सत्र HTTP अनुरोधों की तुलना में दुर्लभ होते हैं — ब्राउज़र स्तर को max_concurrency: 3 पर रखें।
समस्या निवारण
| लक्षण | संभावित कारण | सुधार |
|---|---|---|
फ्लोकी एक चयनकर्ता के लिए [] लौटाता है जो ब्राउज़र में मौजूद है |
पृष्ठ क्लाइंट-साइड सामग्री को रेंडर करता है; HTTP ने एक ऐप शेल लौटाया | URL को CloudBrowser.render/2 पर बढ़ाएं; रेंडर किया गया HTML पार्स करें |
| प्रॉक्सी कनेक्ट अस्वीकृत / 407 गेटवे से | मूल-बुनियादी प्रमाणीकरण क्रेडेंशियल्स गायब या गलत | proxy_headers (Req) या :proxy_auth (HTTPoison) की पुष्टि करें जिसमें चैनल का उपयोगकर्ता नाम और पासवर्ड हो |
Floki.parse_document {:error, ...} लौटाता है |
बॉडी HTML नहीं है (JSON API, रीडायरेक्ट पृष्ठ, या खाली) | resp.status की जांच करें; JSON एंडपॉइंट्स के लिए शरीर को पार्स करने के बजाय डिकोड करें |
किसी भी country_<CC> के बावजूद समान सामग्री |
यह पृष्ठ क्षेत्र के अनुसार भिन्न नहीं है, या देश खंड को अपडेट नहीं किया गया है | उपयोगकर्ता नाम खंड में परिवर्तन की पुष्टि करें; कुछ पृष्ठ पूरी तरह से भौगोलिक रूप से बंद नहीं हैं |
| सामग्री के बजाय पहुंच-विरोधी या चुनौती इंटरस्टिशियल | डेटा सेंटर निकासी या पहले दौरे का गेट | आवासीय ईग्रस के माध्यम से रूट करें और लक्ष्य पृष्ठ से पहले उसी सत्र में साइट के होमपेज को गर्म करें |
| Crawly एक पृष्ठ के बाद रुक जाता है | parse_item/1 ने कोई फॉलो-अप अनुरोध नहीं लौटाए |
पुष्टि करें कि अगली पृष्ठ चयनकर्ता मेल खाता है और Crawly.Utils.request_from_url/1 प्रत्येक पूर्ण URL को लपेटता है |
System.cmd के साथ :enoent त्रुटियां |
python निष्पादन योग्य PATH पर नहीं है |
पूर्ण व्याख्याकार पथ का उपयोग करें, या इसे एक शेल के माध्यम से लागू करें जो इसे हल करता है |
चयनकर्ता परिवर्तन पर एक नोट: जब एक लक्ष्य साइट अपने मार्कअप को पुनर्व्यवस्थित करती है, तो आपकी Floki.find/2 कॉल चुपचाप खाली सूचियों को लौटाती हैं बजाय उठाने के। जब कोई पहले से कार्यशील स्क्रैपर खाली लौटنے लगता है तो नए DOM के खिलाफ चयनकर्ताओं को फिर से जांचें और कसें - खाली सूची को निरीक्षण का संकेत मानें, सामान्य परिणाम नहीं।
निष्कर्ष: आपका Elixir स्क्रैपिंग पाइपलाइन स्केल करें
Elixir पैटर्न चार कदमों में सिमटता है। Scrapeless आवासीय प्रॉक्सियों के माध्यम से Req या HTTPoison (या Crawly को फेचिंग का शेड्यूल करने दें) के साथ फेच करें; Floki के CSS चयनकर्ताओं के साथ पार्स करें; parse_item/1 से फॉलो-अप अनुरोध लौटाकर पृष्ठांकन करें; और जावास्क्रिप्ट-रेंडर्ड अल्पसंख्यक को Scrapeless स्क्रैपिंग ब्राउज़र तक बढ़ाएँ, जिसे Elixir से एक बाहरी रेंडरिंग कॉल-आउट के रूप में पहुंचा जाता है, न कि BEAM से सीधे CDP बोलने के लिए कहें।
यहां से वही आकार बड़े प्रणालियों में संयोजित होता है। आवासीय-प्रॉक्सी परत की गहराई के लिए, देखें SSL प्रॉक्सी क्या है?। जहाज भेजने से पहले: भौगोलिक बंधित पृष्ठों के लिए country_<CC> को पिन करें, प्रति मेज़बान ≤3 पर समांतरता बनाए रखें, यथार्थवादी उपयोगकर्ता-एजेंट निर्धारित करें, अनुपस्थित चयनकर्ताओं को नल करने योग्य मानें, और HTTP स्तर को चौड़ा और क्लाउड-ब्राउज़र स्तर को संकीर्ण रखें।
क्या आप अपने AI-सक्षम डेटा पाइपलाइन बनाने के लिए तैयार हैं?
हमारे समुदाय में शामिल हों, एक मुफ्त योजना का दावा करें और Elixir स्क्रैपिंग पाइपलाइन बनाने वाले डेवलपर से जुड़ें: Discord · Telegram।
फ्री स्क्रैपिंग ब्राउज़र रनटाइम के लिए app.scrapeless.com पर साइन अप करें और ऊपर दिए गए पैटर्न को उन पृष्ठों और क्षेत्रों में अनुकूलित करें, जिनकी आपकी पाइपलाइन को आवश्यकता है। पूर्ण संदर्भ docs.scrapeless.com पर।
अक्सर पूछे जाने वाले प्रश्न
प्रश्न: क्या Elixir के साथ वेब स्क्रैपिंग कानूनी है?
भाषा कानूनीता के लिए अप्रासंगिक है। सार्वजनिक रूप से उपलब्ध डेटा को स्क्रैप करना आम तौर पर कई न्याय क्षेत्रों में स्वीकृत है, लेकिन कानून समान नहीं हैं: प्रत्येक साइट की सेवा की शर्तों की समीक्षा करें, व्यक्तिगत या कॉपीराइट डेटा एकत्र करने से बचें जिसे आपका कोई अधिकार नहीं है, और याद रखें कि नियम क्षेत्र के अनुसार भिन्न होते हैं। जब संदेह हो, तो आपके विशिष्ट उपयोग मामले के लिए कानूनी सलाह प्राप्त करें। Scrapeless सार्वजनिक रूप से उपलब्ध डेटा का ही उपयोग करता है।
प्रश्न: क्या मुझे Elixir स्क्रैपिंग के लिए प्रॉक्सी की आवश्यकता है?
कुछ भी बड़े पैमाने पर करने के लिए, हाँ। किसी सर्वर का डेटा सेंटर IP सबसे पहले है जिसे एक बॉट प्रबंधक झंडा लगाता है, और आवासीय ईग्रस उन ब्लॉकों को तेज़ी से कम करता है। जब भी एक पृष्ठ क्षेत्र के आधार पर सामग्री को गेट करता है तो प्रॉक्सी की भी आवश्यकता होती है। Scrapeless 195+ देशों में आवासीय प्रॉक्सी प्रदान करता है - country_<CC> उपयोगकर्ता नाम खंड सेट करें और Req, HTTPoison, या Crawly को गेटवे के माध्यम से रूट करें, ताकि आपको स्वयं IPs को स्रोत और घुमाने की आवश्यकता न पड़े।
प्रश्न: मुझे Req या HTTPoison में से कौन सा उपयोग करना चाहिए?
नए कोड के लिए, Req: यह JSON डिकोडिंग, रीडायरेक्ट फॉलोइंग, और फिन्च के माध्यम से कनेक्शन पूलिंग को शिप करता है, कम बुनियादी संरचना के साथ। जब आप पहले से बनाए गए प्रोजेक्ट का विस्तार कर रहे हों या यदि आप हैकनी के :proxy / :proxy_auth ट्यूपल विकल्पों का सीधे उपयोग करना चाहते हैं तो HTTPoison चुनें। दोनों Floki के साथ समान रूप से पार्स होते हैं, इसलिए चुनाव ग्राहक की सुविधाओं के बारे में है, स्क्रैपिंग के बारे में नहीं।
प्रश्न: मुझे साधारण HTTP की बजाय Scrapeless स्क्रैपिंग ब्राउज़र कब चाहिए?
जब आपके ग्राहक द्वारा लौटाया गया HTML एक जावास्क्रिप्ट ऐप शेल होता है जिसमें कोई सामग्री नहीं होती है। संकेत: एक चयनकर्ता जिसे आप एक असली ब्राउज़र में देख सकते हैं Floki से खाली सूची लौटाता है। वह पृष्ठ ग्राहक-पक्षीय रूप से रेंडर होता है, इसलिए एक सर्वर-पक्षीय HTTP क्लाइंट कभी भी डेटा को नहीं देखता। उन URLs को क्लाउड ब्राउज़र के माध्यम से रूट करें, जो जावास्क्रिप्ट को पार्स करने से पहले चलाता है - और उन पृष्ठों पर साधारण HTTP रखें जो पहले से ही सामग्री लौटाते हैं।
प्रश्न: Elixir से सीधे ब्राउज़र को चलाने के बजाय रेंडरिंग हेल्पर को कॉल करने का क्या लाभ है?
एलीक्सिर के पास नोड और पायथन की तरह एक पहले श्रेणी का क्रोम डेवटूल्स प्रोटोकॉल चालक नहीं है, इसलिए सबसे साफ पैटर्न एलीक्सिर को समन्वयक के रूप में रखते हुए System.cmd/3 के साथ बुलाए जाने वाले एक छोटे बाहरी सहायक को रेंडरिंग सौंपता है। एलीक्सिर अभी भी क्रॉल लूप, सह-क्रियाशीलता की सीमाएँ, पृष्ठांकन और फ्लोकी पार्सिंग का मालिक है; केवल जावास्क्रिप्ट निष्पादन क्लाउड ब्राउज़र में जाता है। यह एलीक्सिर कोड को शास्त्रीय बनाए रखता है और एक बाहरी कॉल के साथ एकीकरण को सरल बनाता है।
प्रश्न: मुझे कितनी समवर्ती अनुरोध चलाने चाहिए?
≤3 प्रति होस्ट पर टिकें। Task.async_stream के साथ, max_concurrency: 3 सेट करें; Crawly के साथ, concurrent_requests_per_domain: 3 सेट करें। सार्वजनिक कैटलॉग थोड़ा अधिक सहन करते हैं, एंटी-बॉट सुरक्षा वाले मूल कम चाहते हैं, लेकिन 3 एक सुरक्षित डिफ़ॉल्ट है जो इन-फ्लाइट पूल को एक हमले की तरह दिखने से रोकता है। क्लाउड-ब्राउज़र स्तर को और भी संकीर्ण रखें, क्योंकि रेंडर्ड सत्र HTTP अनुरोधों की तुलना में अधिक दुर्लभ होते हैं।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





