
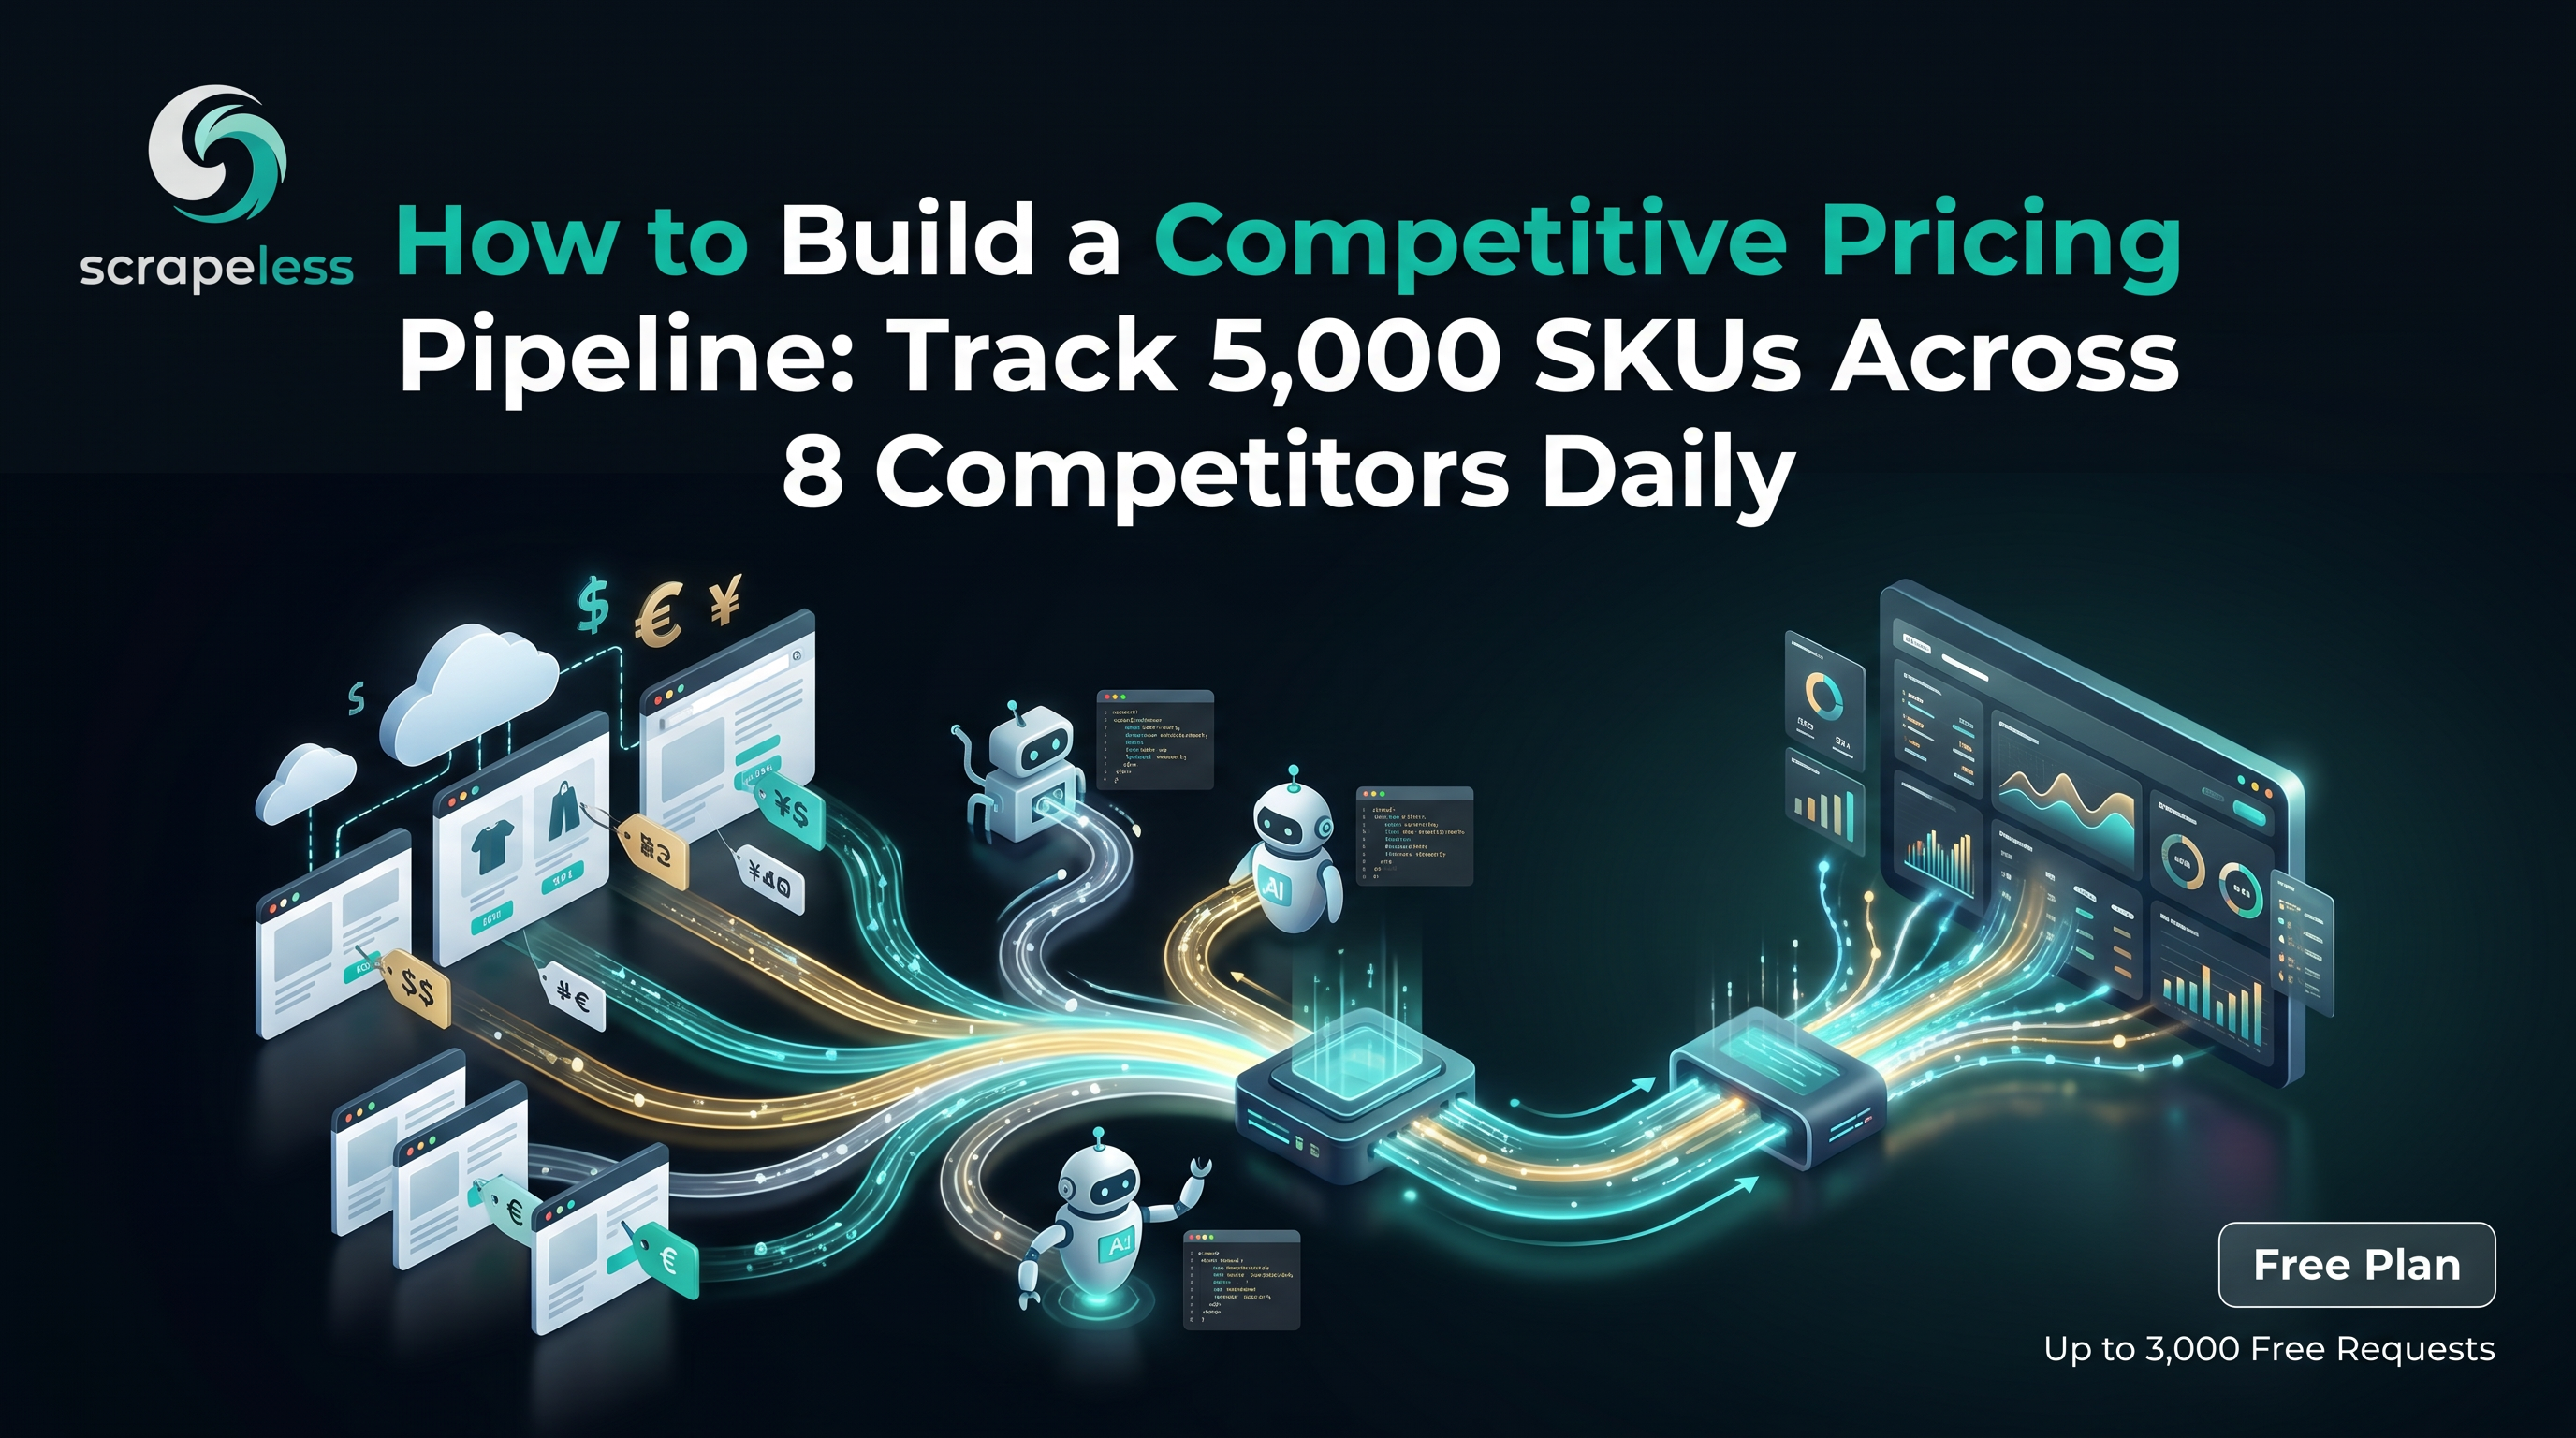
प्रतिस्पर्धात्मक मूल्य निर्धारण पाइपलाइन कैसे बनाएं: दैनिक 8 प्रतिस्पर्धियों के बीच 5,000 एसकेयू को ट्रैक करें
Advanced Bot Mitigation Engineer
मुख्य बिंदु:
- प्रतिस्पर्धात्मक मूल्य निर्धारण एक बास्केट समस्या है, उत्पाद समस्या नहीं। एक मूल्य निर्धारण टीम 4 बाजारों में 8 प्रतिस्पर्धियों के बीच 5,000 SKUs का ट्रैक रख रही है, जो प्रतिदिन 160,000 रीड्स कर रही है। जो आर्किटेक्चर स्केल करता है, वह प्रति URL एक रेंडर कॉल है, जो प्रत्येक बाजार के लिए ईग्रेस को पिन करता है, साथ ही एक एकल सामान्यीकृत आउटपुट स्कीमा — 160,000 आकस्मिक.fetches नहीं।
- बाजार ईग्रेस को निर्धारित करता है। कीमतें, मुद्रा और उपलब्धता क्षेत्र और IP प्रतिष्ठा के अनुसार बदलती हैं। मूल्यांकन के तहत बाजार के लिए प्रॉक्सी देश को पिन करना, प्रत्येक रिकॉर्ड की गई कीमत को तुलनीय बनाए रखता है; एक ही SKU पर अमेरिकी और यूरोपीय ईग्रेस को मिलाने से एक मूल्य इतिहास पैदा होता है जो कुछ भी नहीं है।
- प्रतिस्पर्धियों के बीच एक मानक स्कीमा। प्रत्येक खुदरा विक्रेता का DOM अलग है; गودाम की तालिका नहीं है। निष्कर्षण पर सामान्यीकृत करें:
{your_sku, competitor, market, price_value, price_currency, availability, promo_state, captured_at}। निर्णय गोडाम को पढ़ते हैं, कच्चे HTML को नहीं। - एंटी-डिटेक्शन सर्वर-साइड पर संभाली जाती है। प्रत्येक अनुरोध Scrapeless क्लाउड के भीतर रेंडर होता है, जिसमें आवासीय ईग्रेस, JavaScript निष्पादन, और फ़िंगरप्रिंट रैंडमाइजेशन शामिल होता है। पाइपलाइन एक URL और एक देश भेजती है; इसे रेंडर किया गया HTML वापस मिलता है। कोई ब्राउज़र बाइनरी, कोई प्रॉक्सी रोटेशन लॉजिक, और आपके मशीन पर कोई तीसरे पक्ष का CDP क्लाइन्ट नहीं।
- पाइपलाइन HTML पर नहीं, डिफ़ पर समाप्त होती है। कच्चे रेंडर किए गए पृष्ठ स्क्रैच संग्रहण हैं। जो संकेत मूल्य निर्धारण टीमों पर कार्य करता है, वह आपके मूल्य और प्रतिस्पर्धी के मूल्य के बीच का डिफ होता है, प्रति बाजार, प्रति SKU — एक पुनः मूल्य निर्धारण नियम, एक स्लैक अलर्ट, या एक विश्लेषक डैशबोर्ड को सतह देता है।
- शुरू करने के लिए स्वतंत्र। नए Scrapeless खाते में मुफ्त रनटाइम शामिल है — app.scrapeless.com पर साइन अप करें।
परिचय: वेब डेटा से प्रतिस्पर्धात्मक मूल्य निर्धारण निर्णय
प्रतिस्पर्धात्मक मूल्य निर्धारण टीमें वर्षों से एक ही बाधा के साथ जी रही हैं: कीमतें उन डेटा फ़ीड्स की तुलना में तेजी से बदलती हैं जो मूल्य निर्धारण निर्णयों को सूचित करती हैं। एक खुदरा विक्रेता रातोंरात एक मूल्य को संशोधित करता है; BI टाइल 48 घंटे बाद अपडेट होती है; जब विश्लेषक अंतर को देखता है, तब तक प्रोमोशनल विंडो बंद हो चुकी होती है। वेब डेटा उस लूप को बंद करता है, लेकिन केवल तभी जब संग्रहण परत परिवर्तन की गति के साथ तालमेल बिठा सके और गोडाम में जुड़ने के लिए एक स्कीमा खिलाए।
संरचनात्मक चुनौती "एक उत्पाद पृष्ठ को स्क्रैप करना" नहीं है। यह SKUs के बास्केट, प्रतिस्पर्धियों के बास्केट, और बाजारों के बास्केट के पार स्क्रैप के एक बेड़े का संचालन करना है — हर दिन, हर बाजार, हर खुदरा विक्रेता, समान सटीकता की गारंटियों के साथ। प्रत्येक खुदरा विक्रेता का DOM घूमता है। प्रत्येक बाजार की कीमतें स्थानीयकरण करती हैं। प्रत्येक अनुरोध को खुदरा विक्रेता की एंटी-बॉट परत को साफ़ करने की आवश्यकता होती है और साफ़, रेंडर किया गया HTML वापस लौटना होता है। Octoparse OptiGroup केस अध्ययन ने पैटर्न को पैमाने पर कैप्चर किया: 50 सहायक कंपनियाँ, दर्जनों प्रतिस्पर्धी साइटें, क्षेत्रीय मूल्य, एक केंद्रीकृत मूल्य निर्धारण निर्णय परत।
यह गाइड Scrapeless के शीर्ष पर मूल्य निर्धारण बुद्धिमता पाइपलाइन के संग्रहण परत के आर्किटेक्चर और Python कोड के माध्यम से चलता है। आउटपुट एक सामान्यीकृत NDJSON स्ट्रीम है जो गोडाम तालिका को खिलाता है; इनपुट वह बास्केट फ़ाइल है जो विश्लेषक परिभाषित करता है। पैटर्न के लिए एक बार पढ़ें; प्रति खुदरा विक्रेता एक्सट्रैक्टर को बदलकर प्रत्येक प्रतिस्पर्धी के लिए पुन: उपयोग करें।
आप इसके साथ क्या कर सकते हैं
- दैनिक प्रतिस्पर्धात्मक बास्केट रीड। 4 बाजारों में 8 प्रतिस्पर्धियों के बीच 5,000 SKUs को दैनिक कार्यक्रम पर एक सीमित रनटाइम और एक मानक स्कीमा के साथ ट्रैक करें।
- बाजार-विशिष्ट पुनर्मूल्यांकन। प्रत्येक बाजार के लिए ईग्रेस देश को पिन करें; स्थानीयकृत कीमतें खींचें जो दर्शाती हैं कि एक स्थानीय खरीदार वास्तव में क्या देखता है, न कि कोई भू-फोल्ड कीमत।
- प्रोमो-स्टेट निगरानी। सूचीबद्ध मूल्य और प्रोमोशनल स्थिति (बिक्री पर, प्रतिशत बंद, समय-सीमित बैज) दोनों को पकड़ें ताकि गोडाम यह जान सके कि एक सामान्य मूल्य और एक क्लियरेंस पुश के बीच क्या अंतर है।
- MAP अनुपालन ऑडिट। खुदरा विक्रेता द्वारा सूचीबद्ध कीमतों की तुलना आपके MAP (न्यूनतम विज्ञापित मूल्य) नीति से करें और चैनल-प्रबंधन टीम को उल्लंघनों को सतह दें।
- नए उत्पाद लॉन्च ट्रैकिंग। किसी श्रेणी में प्रतिस्पर्धी SKUs के पहले-दृश्यमान की प्रतीक्षा करें; पाइपलाइन "क्या प्रतिस्पर्धी X को लॉन्च करने वाला है?" सिग्नल के रूप में काम करती है।
- मूल्य लचीलापन डेटासेट। 90 दिनों में दैनिक स्नैपशॉट ऐसी समय श्रृंखला उत्पन्न करते हैं जिसका उपयोग राजस्व प्रबंधन SKU स्तर पर लचीलापन की गणना करने के लिए करता है।
Scrapeless में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा तक पहुंचते हैं जबकि लागू कानूनों, नियमों, और वेबसाइट की गोपनीयता नीतियों का सख्ती से पालन करते हैं। इस पोस्ट में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है।
प्रतिस्पर्धात्मक मूल्य निर्धारण के लिए Scrapeless क्यों
Scrapeless प्रत्येक लक्षित URL को एंटी-डिटेक्शन क्लाउड ब्राउज़र में रेंडर करता है जो आत्म-विकसित Chromium द्वारा संचालित होता है और एकल API कॉल के माध्यम से तैयार HTML लौटा देता है। विशेष रूप से मूल्य निर्धारण बुद्धिमता पाइपलाइन के लिए, यह लाता है:
- 195+ देशों में आवासीय प्रॉक्सी, प्रत्येक अनुरोध के साथ एक देश कोड के साथ पिन किया गया — ईग्रेस भूगोल प्रत्येक बाजार के लिए एक फ़ील्ड है।
- क्लाउड-साइड JavaScript रेंडरिंग। खुदरा विक्रेता के उत्पाद पृष्ठ React या Next.js ऐप हैं; मूल्य तत्व हाइड्रेशन के बाद उतरता है।
js_render=Trueका अर्थ है कि आपकी पाइपलाइन पोस्ट-पेंट DOM को पढ़ती है, न कि SSR शेल। - सर्वर-साइड एंटी-डिटेक्शन। यूए, समयक्षेत्र, वेबजीएल, कैनवास, और हेडलेस फ़्लैग्स क्लाउड में प्रति अनुरोध यादृच्छिक होते हैं। कोई स्थानीय स्टील्थ-प्लगइन रखरखाव नहीं, कोई ब्राउज़र बाइनरी स्थापित करने की आवश्यकता नहीं।
- एक बिना स्थिति वाला अनुरोध आकार। प्रत्येक उत्पाद पृष्ठ एक स्वतंत्र पढ़ाई है: एक यूआरएल और एक देश भेजें, वापस रेंडर किया गया एचटीएमएल प्राप्त करें। यह हजारों स्वतंत्र एसकेयू पढ़ने के सामूहिक रूप से स्पष्ट रूप से मैप करता है।
- संपूर्ण पाइपलाइन के लिए एक एपीआई कुंजी। रेंडरिंग, आवासीय प्रॉक्सी, और एसडीके सभी एक ही स्क्रेपलेस खाते के खिलाफ बिल करते हैं; कोई प्रति-स्तर एकीकरण नहीं।
अपनी एपीआई कुंजी मुफ्त योजना पर प्राप्त करें app.scrapeless.com पर।
पूर्वापेक्षाएँ
- पायथन 3.10 या नया
- एक स्क्रेपलेस खाता और एपीआई कुंजी - साइन अप करें app.scrapeless.com पर
requests-शैली HTTP और एक CSS-चयनकर्ता पुस्तकालय का ज्ञान- एक लक्षित प्रतिस्पर्धी सूची और एक एसकेयू बास्केट फ़ाइल
पाइपलाइन आर्किटेक्चर एक नज़र में
basket.yaml                      (विश्लेषक-परिभाषित इनपुट)
       │
       ▼
┌──────────────────┐
│   ऑर्केस्ट्रेटर   │  (बाजार, प्रतिस्पर्धी, एसकेयू) प्रति कार्य; सीमित समवर्तीता
└──────┬───────────┘
       │
       ▼
┌──────────────────┐
│   स्क्रेपलेस     │  client.universal.scrape(url, country) — आवासीय निकासी,
│  (क्लाउड रेंडर)  │  JS रेंडरिंग, एंटी-डिटेक्शन, सभी सर्वर-साइड
└──────┬───────────┘
       │  रेंडर किया गया एचटीएमएल
       ▼
┌──────────────────┐
│   सामान्यीकरण    │  प्रति-खुदरा extractor → कैनонिकल स्कीमा
└──────┬───────────┘
       │
       ▼
prices.ndjson          (एक पंक्ति प्रति (उत्पाद, प्रतिस्पर्धी, बाजार, दिन))
       │
       ▼
गोडाम लोड + आपके मूल्यों के खिलाफ अंतर + अलार्म
प्रत्येक चरण एक पायथन मॉड्यूल है; नीचे दिए गए सात चरण इसे नीचे से ऊपर बनाते हैं।
चरण 1 — स्क्रेपलेस एसडीके स्थापित करें
bash
pip install scrapeless lxml pyyamlscrapeless आधिकारिक पायथन एसडीके है; यह पृष्ठों को क्लाउड-साइड रेंडर करता है और एचटीएमएल लौटाता है, इसलिए कोई ब्राउज़र बाइनरी और कोई तृतीय-पक्ष स्वचालन पुस्तकालय स्थापित करने की आवश्यकता नहीं है। lxml पार्सर है; pyyaml बास्केट कॉन्फ़िग़रेशन पढ़ता है।
चरण 2 — बास्केट परिभाषित करें
मूल्य निर्धारण टीम इस फ़ाइल की जिम्मेदारी लेती है। इसे नीरस रखें - बाजार, प्रतिस्पर्धी, एसकेयू मैपिंग। प्रति (आपका_sku, प्रतिस्पर्धी, प्रतिस्पर्धी_url, बाजार) एक पंक्ति:
yaml
# basket.yaml
markets:
  - यूएस
  - जीबी
  - डीयू
  - जेपी

basket:
  - your_sku: SKU-1001
    name: "Acme Widget Pro"
    competitors:
      - retailer: target_competitor_a
        url:
          US: "https://competitor-a.com/p/widget-pro"
          GB: "https://competitor-a.co.uk/p/widget-pro"
          DE: "https://competitor-a.de/p/widget-pro"
          JP: "https://competitor-a.co.jp/p/widget-pro"
      - retailer: target_competitor_b
        url:
          US: "https://competitor-b.com/products/widget-pro"
          GB: "https://competitor-b.co.uk/products/widget-pro"
5,000-एसकेयू बास्केट उसी आकार में रहती है; गोदाम your_sku पर जुड़ता है ताकि आपके अपने मूल्य फीड के खिलाफ समन्वय किया जा सके।
चरण 3 — स्क्रेपलेस के माध्यम से उत्पाद पृष्ठ रेंडर करें
(बाजार, एसकेयू) प्रति एक रेंडर कॉल। देश पिन आवासीय निकासी सेट करता है; js_render=True पोस्ट-हाइड्रेशन डॉम लौटाता है:
python
import os
from scrapeless import Scrapeless
from scrapeless.types.universal import (
    UniversalScrapingRequest, UniversalJsRenderInput, UniversalProxy,
)

client = Scrapeless()  # SCRAPELESS_API_KEY को env से पढ़ता है

def scrape_rendered(url: str, market: str) -> str:
    """स्क्रेपलेस क्लाउड में एक उत्पाद पृष्ठ रेंडर करें और एचटीएमएल लौटाएँ।"""
    request = UniversalScrapingRequest(
        actor="unlocker.webunlocker",
        input=UniversalJsRenderInput(url=url, js_render=True, headless=True),
        proxy=UniversalProxy(country=market),
    )
    return client.universal.scrape(request)  # रेंडर किया गया एचटीएमएल (str) लौटाता है
देश पिन वह लोड-बेयरिंग फील्ड है। एक ही उत्पाद यूआरएल प्रति क्षेत्र एक अलग मूल्य, मुद्रा, और उपलब्धता राज्य रेंडर करता है, इसलिए निकासी को पिन करना हर दर्ज मूल्य को एक ही बाजार पर रखता है। js_render=True पृष्ठ के चित्रण होने का इंतजार करता है, इसलिए React/Vue/Next.js खुदरा विक्रेता मूल्य तत्व लौटाते हैं, न कि एक खाली खोल।
चरण 4 — बास्केट को चलाएं
प्रत्येक एसकेयू एक स्वतंत्र रेंडर कॉल है, इसलिए बास्केट चलाना एक साधारण लूप है (या समांतरता के लिए सीमित थ्रेड पूल)। कोई सत्र रखने की आवश्यकता नहीं, कोई होमपृष्ठ गर्म करने की आवश्यकता नहीं — क्लाउड रेंडर प्रत्येक अनुरोध पर खुदरा विक्रेता की एंटी-बॉट परत को साफ कर देता है:
python
import yaml

def load_basket(path: str = "basket.yaml") -> dict:
    with open(path, encoding="utf-8") as f:
        return yaml.safe_load(f)

def walk_basket(basket: dict):
    """प्रत्येक बास्केट प्रविष्टि के लिए (आपका_sku, खुदरा विक्रेता, बाजार, यूआरएल, एचटीएमएल) प्रदान करें।"""
    for item in basket["basket"]:
        for comp in item["competitors"]:
            for market, url in comp["url"].items():
                html = scrape_rendered(url, market)
                yield item["your_sku"], comp["retailer"], market, url, html
5,000-SKU बास्केट के लिए, scrape_rendered को concurrent.futures.ThreadPoolExecutor में लपेटें और श्रमिकों की संख्या को उस स्तर पर सीमित करें जो खाता योजना की अनुमति देती है। प्रत्येक कॉल स्टेटलेस है, इसलिए समानांतर कार्य को श्रमिक जोड़कर स्केल किया जा सकता है - इसमें साझा सत्र पर विवाद करने की आवश्यकता नहीं है।
आपकी API कुंजी मुफ्त योजना पर प्राप्त करें: app.scrapeless.com
कदम 5 — कैनोनिकल स्कीमा में डेटा निकालें
प्रति रिटेलर का DOM अलग होता है; गोदाम तालिका ऐसा नहीं है। एक्सट्रैक्टर का काम है कि जो कुछ भी रिटेलर बनाता है उसे हर बार एक ही आकार में बदल देना। आउटपुट स्कीमा (प्रति (your_sku, competitor, market, captured_at) एक पंक्ति):
python
from dataclasses import dataclass, asdict
from datetime import datetime, timezone
from typing import Optional
from lxml import html as lxml_html

@dataclass
class PriceRecord:
    your_sku: str
    competitor: str
    market: str
    url: str
    price_value: Optional[float]
    price_currency: Optional[str]
    availability: Optional[str]       # "in_stock" | "out_of_stock" | "preorder" | None
    promo_state: Optional[str]        # "none" | "on_sale" | "clearance" | None
    promo_discount_pct: Optional[float]
    captured_at: str                  # ISO-8601 UTC
प्रति रिटेलर एक्सट्रैक्टर्स उसी लौटाए गए प्रकार में प्लग करें:
python
def extract_competitor_a(html: str, your_sku: str, market: str, url: str) -> PriceRecord:
    doc = lxml_html.fromstring(html)

    price_el = doc.cssselect("[data-test='price'] .value")
    currency_el = doc.cssselect("[data-test='price'] .currency")
    availability_el = doc.cssselect("[data-test='availability']")
    promo_el = doc.cssselect("[data-test='promo-badge']")

    availability = (
        "in_stock" if availability_el and "In stock" in availability_el[0].text_content()
        else "out_of_stock" if availability_el
        else None
    )

    return PriceRecord(
        your_sku=your_sku,
        competitor="target_competitor_a",
        market=market,
        url=url,
        price_value=_to_float(price_el[0].text_content()) if price_el else None,
        price_currency=currency_el[0].text_content().strip() if currency_el else None,
        availability=availability,
        promo_state="on_sale" if promo_el else "none",
        promo_discount_pct=_to_float(promo_el[0].get("data-discount-pct")) if promo_el else None,
        captured_at=datetime.now(timezone.utc).isoformat(),
    )

def _to_float(text) -> Optional[float]:
    if not text:
        return None
    cleaned = "".join(c for c in text if c.isdigit() or c == ".")
    try:
        return float(cleaned)
    except (ValueError, TypeError):
        return None
हर रिटेलर को अपना extract_<name> फ़ंक्शन मिलता है; हर फ़ंक्शन वही PriceRecord लौटाता है। ऑर्केस्ट्रेटर नहीं जानता कि प्रत्येक रिटेलर कौन सा DOM उपयोग करता है - केवल कॉल करने के लिए फ़ंक्शन का नाम।
चुनाव डिज़ाइन नोट्स:
- जब रिटेलर उन्हें उजागर करते हैं, तो
[data-test='...']विशेषताओं को वरीयता दें। वे कॉस्मेटिक क्लास-नाम रोटेशन से बच जाते हैं; क्लास जैसे.text-lg.font-semiboldहर रिलीज़ में बदलती हैं। - गैरमौजूद फ़ील्ड को नल के रूप में मानें। आउट-ऑफ-स्टॉक उत्पाद के लिए
Noneमूल्य डेटा है, विफलता नहीं। - उस मुद्रा स्ट्रिंग को कैप्चर करें जो रिटेलर प्रस्तुत करता है। बाजार से मुद्रा का अनुमान ना लगाएं - कुछ रिटेलर्स अपने .de डोमेन पर क्रॉस-बॉर्डर उत्पादों के लिए USD सूचीबद्ध करते हैं। जो पृष्ठ कहता है वो ही संग्रहीत करें।
कदम 6 — गोदाम लोड के लिए NDJSON में स्ट्रीम करें
NDJSON में स्ट्रीम-लिखें ताकि पाइपलाइन मध्य में रुकने पर रिकॉर्ड खोने के बिना जीवित रहे। प्रत्येक पंक्ति एक प्रदर्शित SKU है; फ़ाइल केवल जोड़ने के लिए है:
python
import json
from pathlib import Path

def append_records(records: list[PriceRecord], out_path: str = "prices.ndjson"):
    Path(out_path).parent.mkdir(parents=True, exist_ok=True)
    with open(out_path, "a", encoding="utf-8") as f:
        for r in records:
            f.write(json.dumps(asdict(r)) + "\n")
NDJSON सीधे Snowflake (COPY INTO ... FILE_FORMAT = (TYPE = JSON)), BigQuery (bq load --source_format=NEWLINE_DELIMITED_JSON), Redshift, ClickHouse, और DuckDB में लोड होती है। पहले से उपयोग किए जा रहे BI स्टैक में से कोई भी चुनें; स्कीमा वही है।
कदम 7 — डिफ्स की गणना करें और मूल्य निर्धारण निर्णयों को मार्गदर्शित करें
प्राइसिंग टीम जिस संकेत पर कार्य करती है वह कच्ची कीमत नहीं है - यह प्रति बाजार, प्रति SKU, प्रतियोगी की कीमत और आपकी कीमत के बीच का अंतर है। यह अंतर गोदाम में होता है, स्क्रैपर में नहीं:
sql
-- दैनिक मूल्य अंतर, प्रति SKU प्रति प्रतियोगी प्रति बाजार
WITH yours AS (
  SELECT sku, market, list_price, currency, captured_date
  FROM your_internal_prices
  WHERE captured_date = CURRENT_DATE
),
theirs AS (
  SELECT your_sku, competitor, market, price_value, price_currency,
         availability, promo_state, CAST(captured_at AS DATE) AS captured_date
  FROM competitor_prices
  WHERE CAST(captured_at AS DATE) = CURRENT_DATE
)
SELECT
  t.your_sku,
  t.competitor,
  t.market,
  y.list_price                                  AS our_price,
  t.price_value                                 AS their_price,
ROUND(100.0 * (y.list_price - t.price_value) / NULLIF(t.price_value, 0), 2)
AS price_gap_pct,
t.availability,
t.promo_state
FROM theirs t
LEFT JOIN yours y
ON y.sku = t.your_sku AND y.market = t.market
WHERE y.list_price IS NOT NULL
AND t.price_value IS NOT NULL
ORDER BY price_gap_pct DESC;
price_gap_pct के लिए उस सीमा से परे के पंक्तियों को रूट करें जो मूल्य निर्धारण नियम परिभाषित करता है:
- आपकी कीमत की सीमा से ऊपर (उदाहरण के लिए, आप नेता से 5%+ अधिक महंगे हैं) → मूल्य निर्धारण समीक्षा।
- MAP सीमा के नीचे → चैनल प्रबंधन को MAP-उल्लंघन अलर्ट।
- कल से प्रोमो-राज्य में बदलाव → श्रेणी प्रबंधकों को प्रतिस्पर्धात्मक-प्रोमो अधिसूचना।
डिफ क्वेरी संग्रह और निर्णय के बीच का अनुबंध है। जब तक गोदाम की स्कीमा स्थिर रहती है, मूल्य निर्धारण टीम के डाउनस्ट्रीम BI टाइल, अलर्ट, और मूल्य निर्धारण नियम तब भी नहीं बदलते जब कोई रिटेलर अपना DOM घुमाता है - केवल स्टेप 5 में प्रति-रिटेलर एक्स्ट्रक्टर बदलता है।
आपको क्या मिलेगा
(आपका_sku, प्रतियोगी, बाजार, दिन) प्रति एक NDJSON पंक्ति, इस तरह से आकारित:
json
{
  "your_sku": "SKU-1001",
  "competitor": "target_competitor_a",
  "market": "US",
  "url": "https://competitor-a.com/p/widget-pro",
  "price_value": 79.99,
  "price_currency": "USD",
  "availability": "in_stock",
  "promo_state": "on_sale",
  "promo_discount_pct": 15.0,
  "captured_at": "<ISO-8601 UTC timestamp written at read time>"
}
पैटर्न चलाने से ईमानदार अवलोकन:
- रेंडरिंग का समय DOM विशिष्टता से अधिक महत्वपूर्ण है। एक चयनकर्ता जो SSR शेल के खिलाफ चलता है, कीमत तत्व के चित्रित होने से पहले एक खाली स्ट्रिंग लौटाता है।
js_render=Trueपोस्ट-हाइड्रेशन DOM लौटाता है, जो कीमत चयनकर्ता को हल करने में सक्षम बनाता है। - मुद्रा बाजार के साथ अतिरंजित नहीं है। क्रॉस-बॉर्डर SKUs कभी-कभी स्थानीय डोमेन पर भी एक गैर-स्थानीय मुद्रा सूचीबद्ध करते हैं। रेंडर की गई स्ट्रिंग को स्टोर करें; गोदाम परत को सामान्य होने दें।
- प्रोमो राज्य के पास कम से कम तीन मान हैं, दो नहीं।
none,on_sale, औरclearanceमूल्य पुनर्मूल्यांकन नियमों में भिन्नता से व्यवहार करते हैं - एक clearance markdown जीवन समाप्ति का संकेत देता है, न कि एक प्रचार धक्का। - उपलब्धता दूसरा सबसे क्रियाशील क्षेत्र है। एक आउट-ऑफ-स्टॉक SKU पर 20% कीमत का अंतर एक इन-स्टॉक SKU पर समान अंतर के रूप में प्रतिस्पर्धात्मक संकेत नहीं है। दोनों को निर्णय परत पर प्रदर्शित करें।
- एक मानक स्कीमा लोड-बेयरिंग निर्णय है। प्रति-रिटेलर क्षेत्र, मुद्रा परंपराएं, और प्रमो फॉर्मेट भिन्न होते हैं; गोदाम तालिका नहीं। भिन्नता को एक्स्ट्रक्टर फ़ंक्शंस में धकेलें, स्कीमा को सपाट रखें।
निष्कर्ष: अपने प्रतिस्पर्धी मूल्य निर्धारण पाइपलाइन को स्केल करें
पाइपलाइन छः चरणों में घटित होती है: बैस्केट को परिभाषित करें → Scrapeless के माध्यम से प्रत्येक SKU को बाजार के अनुसार रेंडर करें → एक मानक स्कीमा में निकाला जाए → NDJSON में स्ट्रीम करें → गोदाम में लोड करें → अपनी खुद की कीमतों के खिलाफ अंतर निकालें। प्रत्येक चरण इतना छोटा है कि पढ़ा जा सके; निर्माण 8 प्रतियोगियों और 4 बाजारों में 5,000 SKUs को एकल दैनिक क्रॉन पर संभालता है।
मूल्य निर्धारण-लागू स्क्रैपिंग (विशेष रूप से रियल-एस्टेट मूल्य निर्धारण) के लिए विक्रेता-तुलना दृश्य के लिए, 2026 के सर्वश्रेष्ठ Zillow स्क्रैपर्स सूची आठ उपकरणों को समान प्रकार की स्थानीयकृत मूल्य निकालने की चुनौती के खिलाफ रैंक करती है। NDJSON आउटपुट को क्लाउड गोदाम में लोड करने के लिए, Scrapeless + Snowflake डेटा अंतर्निहितता गाइड COPY INTO और स्ट्रीमिंग पथ को संभालती है।
प्रत्येक बाजार के लिए ईग्रेस देश को पिन करें, प्रत्येक SKU को स्वतंत्र रूप से रेंडर करें, निष्कर्षण पर सामान्य करें, SKU/प्रतिद्वंद्वी/बाजार/दिन के लिए एक मानक पंक्ति स्टोर करें, और गोदाम में तुलना करें — स्क्रैपर में नहीं।
क्या आप अपनी AI-संचालित डेटा पाइपलाइन बनाने के लिए तैयार हैं?
हमारे समुदाय में शामिल हों ताकि मुफ्त योजना का दावा करें और डेवलपर्स के साथ कनेक्ट करें जो प्रतिस्पर्धात्मक-मूल्य निर्धारण पाइपलाइंस बना रहे हैं: डिस्कोर्ड · टेलीग्राम।
app.scrapeless.com पर साइन अप करें मुफ्त रनटाइम के लिए और ऊपर दिए गए पैटर्न को बाजारों, प्रतियोगियों, और SKU बैस्केट के लिए अनुकूलित करें जिसकी आवश्यकता है। मूल्य निर्धारण विवरण scrapeless.com/en/pricing पर; प्रॉक्सी समाधान उत्पाद पृष्ठ scrapeless.com/en/product/proxy-solutions पर है; पूर्ण SDK संदर्भ docs.scrapeless.com पर है।
अक्सर पूछे जाने वाले प्रश्न
प्रश्न 1: क्या प्रतिस्पर्धी कीमतों को स्क्रैप करना कानूनी है?
कीमतें रिटेलर उत्पाद पृष्ठों पर सार्वजनिक जानकारी हैं, और मूल्य तुलना एक स्थापित व्यापार प्रथा है। वैधता इस पर निर्भर करती है कि आप क्या स्क्रैप करते हैं, कहां से, और किन शर्तों के अधीन। सार्वजनिक रूप से दिखाई दे रहा डेटा सामान्यतः सुलभ है; साइट के सेवा की शर्तें, क्षेत्रीय गोपनीयता कानून (GDPR, CCPA), और कॉपीराइट लागू होते हैं। उच्च-स्टेक उपयोग के मामलों के लिए सलाह लें। Scrapeless केवल सार्वजनिक रूप से उपलब्ध डेटा से पहुंचता है।
प्रश्न 2: क्या मुझे प्रतिस्पर्धी मूल्य निर्धारण के लिए प्रॉक्सी की आवश्यकता है?
हाँ, और देश का पिन आईपी रोटेशन से अधिक महत्वपूर्ण है। रिटेलर्स बाजार के अनुसार कीमतें स्थानीयकृत करते हैं; एक अमेरिकी निकासी अनुरोध एक .co.uk डोमेन के लिए बैकफॉल कीमत, एक रीडायरेक्ट, या एक भू-निषेध वापस कर सकता है। UniversalProxy(country=...) के माध्यम से मापे जा रहे बाजार के लिए देश को पिन करें। 195+ देशों में स्क्रेपलेस आवासीय प्रॉक्सियां सामान्य मूल्य निर्धारण टोकरे को कवर करती हैं बिना एक अलग प्रॉक्सी प्रदाता को स्टैक में लाए।
प्रश्न 3: मैं एंटी-बॉट चुनौतियों और बॉट पहचान को कैसे संभालूं?
रेंडरिंग स्क्रेपलेस क्लाउड में सर्वर-साइड पर आवासीय निकासी, वास्तविक जावास्क्रिप्ट निष्पादन, और यादृच्छिक फ़िंगरप्रिंटिंग के साथ चलती है, इसलिए अनुरोध जो रिटेलर तक पहुँचता है एक आवासीय आईपी से लक्ष्य बाजार में एक सामान्य ब्राउजर जैसा दिखता है। js_render=True सेट करें ताकि प्रतिक्रिया पूर्व-रेंडर शेल की बजाय पोस्ट-हाइड्रेशन DOM हो, और जिस बाजार को आप मापते हैं उसके लिए देश को पिन करें।
प्रश्न 4: पाइपलाइन कितनी बार चलानी चाहिए?
दैनिक मूल्य निर्धारण निर्णयों के लिए मौलिक ताल है; जब प्रोत्साहन विंडो की निगरानी की जाती है जहाँ दिन के भीतर कीमतें बदलती हैं, तो प्रति घंटे चलाना यथार्थवादी है। प्रति-SKU लागत एकल रेंडर कॉल द्वारा सीमित होती है, इसलिए दैनिक ताल पर 5,000-SKU टोकरे एकल-क्रोन-शॉप बजट के भीतर अच्छी तरह से है। उच्च आवृत्तियाँ रेखीय रूप से लागत जोड़ती हैं - उस ताल को चुनें जिसे मूल्य निर्धारण निर्णय वास्तव में खपत करता है।
प्रश्न 5: जब एक रिटेलर अपना DOM घुमाता है तो क्या होता है?
चरण 5 में प्रति-रिटेलर एक्स्ट्रैक्टर एकमात्र फ़ाइल है जो बदलती है। मौलिक स्कीमा, गोदाम तालिका, BI टाइलें, डिफ क्वेरी, और अलर्टिंग नियम सभी अप्रभावित हैं। जब एक रिटेलर एक रिलीज़ भेजता है तो सेलेक्टर्स की फिर से जांच करें; उपलब्ध होने पर [data-test='...'] विशेषताओं को प्राथमिकता दें; एक्स्ट्रैक्टर को अस्थिर परत के रूप में और स्कीमा को स्थिर परत के रूप में मानें।
प्रश्न 6: क्या मैं कई रिटेलर्स को समानांतर में चला सकता हूँ?
हाँ। प्रत्येक रेंडर कॉल Stateless है, इसलिए आयोजक (बाजार, प्रतियोगी, SKU) कार्यों को एक थ्रेड पूल में फैलाता है और कार्यकर्ता संख्या को उस स्तर तक सीमित करता है जो खाते की योजना की अनुमति देती है। समानांतरता कार्यकर्ताओं को जोड़कर स्केल होती है, न कि एक सत्र साझा करके - वहाँ कोई होल्ड कनेक्शन नहीं है जिस पर लड़ाई करनी हो।
प्रश्न 7: मैं प्रमो स्थिति और छूट प्रतिशत को कैसे कैप्चर करूं?
चरण 5 का एक्स्ट्रैक्टर प्रमो बैज को सीधे रेंडर किए गए DOM से पढ़ता है और promo_state ("on_sale", "clearance", "none") और promo_discount_pct को अलग-अलग फ़ील्ड के रूप में संग्रहीत करता है। गोदाम दोनों को डिफ क्वेरी में जोड़ता है ताकि मूल्य निर्धारण नियम "क्या प्रतियोगी अभी बिक्री पर है?" बनाम "प्रतिस्पर्धी की हर दिन की कीमत क्या है?" पर शाखा बना सके।
प्रश्न 8: अंतरराष्ट्रीय मुद्राओं और FX के बारे में क्या?
प्रत्येक रिकॉर्ड के लिए रेंडर की गई मुद्रा स्ट्रिंग संग्रहित करें (USD, EUR, JPY, GBP)। मुद्रा रूपांतरण गोदाम परत में होना चाहिए, स्क्रैपर में नहीं - कच्ची कीमत + कच्ची मुद्रा + बाजार को NDJSON में रखें, और BI पक्ष पर दैनिक FX क्रॉस-जॉइन चलाएं। इस तरह एक खराब FX दर पूरी इतिहास को खराब नहीं करती।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





