
स्क्रैपिंग ब्राउज़र सीएलआई: एआई एजेंटों और डेवलपर्स के लिए टर्मिनल-प्रथम वेब स्क्रैपिंग
Senior Web Scraping Engineer
मुख्य निष्कर्ष:
- स्क्रैपिंग ब्राउज़र CLI आपके टर्मिनल से सीधे क्लाउड-नेटिव ब्राउज़र स्वचालन की पेशकश करके वेब डेटा निष्कर्षण में क्रांति लाता है।
- यह मजबूत एंटी-डिटेक्शन फ़ीचर्स, वैश्विक आवासीय प्रॉक्सी और स्थायी सत्र प्रदान करता है, जो सामान्य वेब स्क्रैपिंग चुनौतियों से पार करता है।
- एआई एजेंटों के साथ सहजता से एकीकृत करें, उन्हें मानव-समान सटीकता के साथ जटिल वेब इंटरएक्शन और डेटा संग्रह करने में सक्षम बनाएं।
- गतिशील सामग्री संचालन, फॉर्म स्वचालन, और परिष्कृत डेटा पाइपलाइन बनाने के लिए उन्नत तकनीकों का पता लगाएं।
परिचय: वेब डेटा निष्कर्षण का विकास
आज की डेटा-चालित दुनिया में, डेवलपर्स, डेटा वैज्ञानिकों और उभरते एआई एजेंटों के लिए वेब डेटा तक पहुंच और इसके साथ बातचीत करना महत्वपूर्ण है। हालाँकि, वेब स्क्रैपिंग का परिदृश्य तेजी से जटिल होता जा रहा है। वेबसाइटें परिष्कृत एंटी-बॉट उपायों का उपयोग करती हैं, गतिशील सामग्री लोडिंग के लिए उन्नत रेंडरिंग की आवश्यकता होती है, और स्थानीय ब्राउज़र स्वचालन सेटअप को प्रबंधित करना संसाधन-गहन और विफलताओं की चपेट में आ सकता है। ये चुनौतियाँ अक्सर एक सरल डेटा अधिग्रहण कार्य को एक महत्वपूर्ण इंजीनियरिंग बाधा में बदल देती हैं।
स्क्रैपिंग ब्राउज़र CLI, जो स्प्रैपलेस द्वारा संचालित है, इन आधुनिक वेब स्क्रैपिंग समस्याओं का एक शक्तिशाली समाधान के रूप में उभरता है। यह एक अत्याधुनिक, क्लाउड-आधारित ब्राउज़र स्वचालन उपकरण है जो आपको सहजता से स्क्रैप, खोज और वेब पृष्ठों के साथ बातचीत करने की अनुमति देता है। ब्राउज़र निष्पादन को एक मजबूत क्लाउड इन्फ्रास्ट्रक्चर पर स्थानांतरित करके, यह मानव डेवलपर्स और एआई एजेंटों दोनों के लिए निर्बाध, उच्च-प्रदर्शन अनुभव प्रदान करता है, स्थानीय रखरखाव या इन्फ्रास्ट्रक्चर ओवरहेड के बोझ के बिना डेटा निष्कर्षण को विश्वसनीय और कुशल बनाता है।
स्क्रैपिंग ब्राउज़र CLI क्या है?
स्क्रैपिंग ब्राउज़र CLI एक उन्नत कमांड-लाइन इंटरफ़ेस उपकरण है जो क्लाउड ब्राउज़र स्वचालन और गहरे एआई एजेंट एकीकरण के लिए ध्यानपूर्वक तैयार किया गया है। पारंपरिक स्थानीय ब्राउज़र स्वचालन ढांचे जैसे कि Puppeteer या Playwright से भिन्न, जिन्हें Chrome या Chromium की स्थानीय स्थापना की आवश्यकता होती है, यह CLI पूरी तरह से स्प्रैपलेस क्लाउड इन्फ्रास्ट्रक्चर के भीतर संचालित होता है। यह मौलिक अंतर स्केलेबिलिटी, विश्वसनीयता और संसाधन प्रबंधन में बेजोड़ लाभ प्रदान करता है।
इस क्लाउड-नेटिव दृष्टिकोण का मतलब है कि आप अपने स्थानीय सिस्टम के कंप्यूटेशनल संसाधनों का उपभोग किए बिना शक्तिशाली वेब इंटरएक्शन का निष्पादन, बड़े पैमाने पर डेटा स्क्रैपिंग और स्वचालित परीक्षण कर सकते हैं। इसके अलावा, स्क्रैपिंग ब्राउज़र CLI के ऊपर बनाए गए विशेष कौशल आपके एआई एजेंटों को पूर्ण क्लाउड ब्राउज़र क्षमताएँ प्रदान कर सकते हैं। यह उन्हें वेबसाइटों को ब्राउज़ करने, फॉर्म भरने, बटन पर क्लिक करने और डेटा निकालने में सक्षम बनाता है, ठीक एक मानव उपयोगकर्ता की तरह, विभिन्न वेब स्वचालन कार्यों को आसानी से पूरा करते हुए।
मुख्य लाभ: क्लाउड-नेटिव का महत्व
स्क्रैपिंग ब्राउज़र CLI आपके वेब स्क्रैपिंग वर्कफ़्लो में कई विशिष्ट, खेल-परिवर्तनकारी लाभ लाता है:
- क्लाउड निष्पादन: सभी ब्राउज़र संचालन क्लाउड में चलते हैं, स्थानीय ब्राउज़र सेटअप, ड्राइवर प्रबंधन और संबंधित संसाधन हानि की आवश्यकता को पूरी तरह से हटाते हैं।
- बुद्धिमान एंटी-डिटेक्शन: इसमें निर्मित, परिष्कृत ब्राउज़र फ़िंगरप्रिंटिंग और एंटी-बॉट तंत्र हैं। यह आपको वेबसाइट प्रतिबंधों और CAPTCHAs को सहजता से नेविगेट करने की अनुमति देता है, मानव व्यवहार की नकल करते हुए।
- वैश्विक प्रॉक्सी: वैश्विक आवासीय प्रॉक्सियों के लिए समेकित समर्थन आपको विभिन्न भौगोलिक स्थानों से पहुंच का सिमुलेशन करने की अनुमति देता है, जो स्थानीयकृत डेटा निष्कर्षण और भू-अवरोधों को बायपास करने के लिए आवश्यक है।
- सत्र स्थिरता: उन्नत सत्र प्रबंधन कई इंटरैक्शन के बीच स्थिति बनाए रखने को सुनिश्चित करता है, लॉगिन और जटिल फॉर्म सबमिशन जैसे बहु-चरण प्रक्रियाओं के लिए महत्वपूर्ण है।
- एआई-अनुकूल डिज़ाइन: CLI एक सहज तत्व संदर्भ प्रणाली (जैसे @e1, @e2) का उपयोग करता है ताकि एआई एजेंटों के लिए आसान, मजबूत इंटरैक्शन को सुविधाजनक बनाए, जटिल DOM चयनकर्ताओं को अमूर्त करते हुए।
अधिक स्पष्ट जानकारी के लिए, आप आधिकारिक दस्तावेज़ या GitHub रिपॉजिटरी का दौरा कर सकते हैं।
विशेषताएँ और क्षमताएँ: गहन दृष्टिकोण
स्क्रैपिंग ब्राउज़र CLI उन विशेषताओं से भरा हुआ है जो आधुनिक वेब स्क्रैपिंग चुनौतियों का सामना करने के लिए डिज़ाइन की गई हैं। नीचे इसके मुख्य कार्यात्मकताओं का एक व्यापक टूटना है:
| विशेषता श्रेणी | विवरण |
|---|---|
| क्लाउड ब्राउज़र स्वचालन | सभी संचालन क्लाउड में चलते हैं, स्थानीय ब्राउज़र स्थापना की आवश्यकता नहीं होती है, उच्च प्रदर्शन और स्केलेबिलिटी सुनिश्चित करते हैं। |
| आवासीय प्रॉक्सी समर्थन | स्थानीयकृत डेटा तक पहुंच के लिए सटीक भू-स्थानिक लक्ष्यीकरण के साथ निर्मित वैश्विक आवासीय प्रॉक्सी। |
| स्मार्ट फ़िंगरप्रिंटिंग | परिष्कृत एंटी-बॉट सिस्टम को बायपास करने के लिए स्वचालित ब्राउज़र फ़िंगरप्रिंटिंग और एंटी-डिटेक्शन तंत्र। |
| सत्र प्रबंधन | जटिल वर्कफ़्लो के दौरान सत्र बनाने, प्रबंधित करने और बनाए रखने के लिए व्यापक समर्थन। |
| एआई-फ्रेंडली इंटरएक्शन | तत्व संदर्भ प्रणाली (@e1, @e2) विशेष रूप से निर्बाध एआई एजेंट संगतता के लिए डिज़ाइन की गई। |
| स्क्रीनशॉट और निष्कर्षण | पूर्ण-पृष्ठ स्क्रीनशॉट कैप्चर करने और विशिष्ट, संरचित सामग्री निकालने की मजबूत क्षमताएँ। |
| सत्र रिकॉर्डिंग | डिबगिंग, ऑडिटिंग और प्लेबैक उद्देश्यों के लिए सत्र रिकॉर्डिंग का समर्थन करता है। |
ये विशेषताएँ इसे एक अत्यधिक बहुपरकारी उपकरण बनाती हैं, जो अन्य उद्योग-अग्रणी समाधानों के साथ तुलनीय है, लेकिन एआई एजेंट एकीकरण और निर्बाध क्लाउड-नैटिव निष्पादन पर जोर के साथ।
मुख्य आदेश अवलोकन: आपका स्वचालन टूलकिट
सीएलआई सत्रों का प्रबंधन करने और वेब पृष्ठों के साथ इंटरैक्ट करने के लिए एक सीधा, सहज सिंटैक्स प्रदान करता है। यहाँ कुछ प्रमुख आदेश हैं जिनका उपयोग आप अपने स्वचालन का संचालन करने के लिए करेंगे:
bash
# सत्र प्रबंधन
scrapeless-scraping-browser new-session     # नया सत्र बनाएँ
scrapeless-scraping-browser sessions        # सभी सक्रिय सत्रों की सूची बनाएं
scrapeless-scraping-browser stop <id>       # एक विशेष सत्र को बंद करें

# पृष्ठ नेविगेशन
scrapeless-scraping-browser open <url>      # एक वेबपृष्ठ खोलें
scrapeless-scraping-browser close           # वर्तमान सत्र को बंद करें

# पृष्ठ इंटरएक्शन
scrapeless-scraping-browser snapshot -i     # इंटरएक्टिव तत्व प्राप्त करें
scrapeless-scraping-browser click @e1       # एक विशेष तत्व पर क्लिक करें
scrapeless-scraping-browser fill @e2 "text" # एक फ़ॉर्म फ़ील्ड भरें

# डेटा निष्कर्षण
scrapeless-scraping-browser get text @e1    # एक तत्व से पाठ निकालें
scrapeless-scraping-browser screenshot      # एक पृष्ठ का स्क्रीनशॉट कैप्चर करें
शुरू करना: चरण-दर-चरण मार्गदर्शिका
स्क्रैपिंग ब्राउज़र सीएलआई स्थापित करना एक त्वरित और सीधा प्रक्रिया है, जिसे कई मिनटों में स्क्रैपिंग में आपको शामिल करने के लिए डिज़ाइन किया गया है।
स्थापना
अनुशंसित विधि सीएलआई को वैश्विक रूप से npm का उपयोग करके स्थापित करना है, यह सुनिश्चित करते हुए कि यह आपके सिस्टम के सभी क्षेत्रों में उपलब्ध है:
bash
npm install -g scrapeless-scraping-browserवैकल्पिक रूप से, आप इसे सीधे बिना किसी स्थापना के npx का उपयोग कर के त्वरित, एक बार के कार्यों के लिए चला सकते हैं:
bash
npx scrapeless-scraping-browser open https://example.comअपना एपीआई कुंजी प्राप्त करें
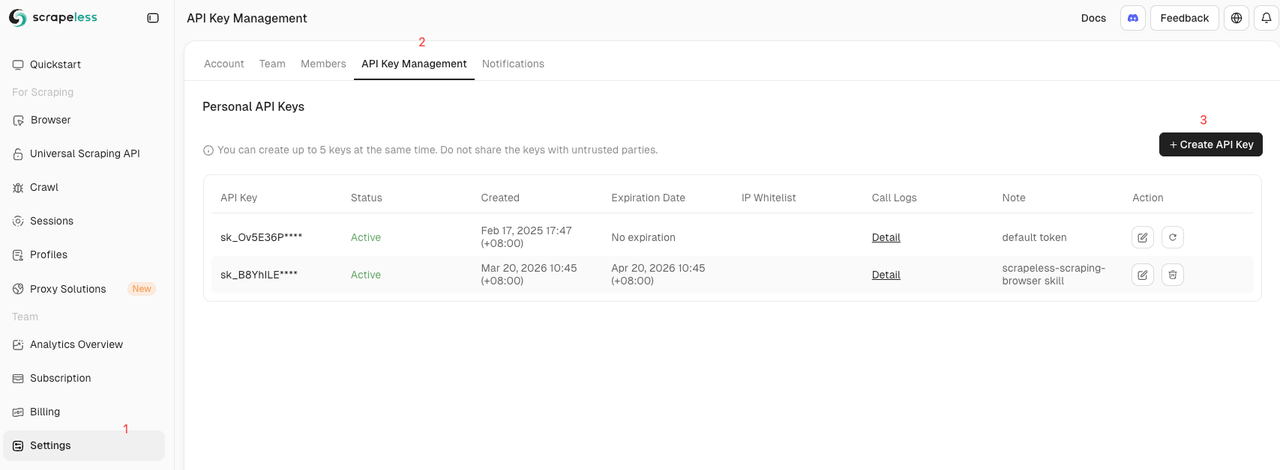
अपनी अनुरोधों को प्रमाणित करने और क्लाउड ढांचा तक पहुँचने के लिए, आपको एक स्क्रैपलेस एपीआई कुंजी की आवश्यकता है:
- स्क्रैपलेस डैशबोर्ड पर जाएँ।
- लॉग इन करें या एक नया खाता बनाएँ।
- एपीआई सेटिंग्स पृष्ठ पर जाकर अपनी एपीआई कुंजी उत्पन्न और सुरक्षित रूप से कॉपी करें।
प्रमाणीकरण कॉन्फ़िगर करना
आप एक कॉन्फ़िगरेशन फ़ाइल या पर्यावरण चर का उपयोग करके अपनी प्रमाणीकरण क्रेडेंशियल्स कॉन्फ़िगर कर सकते हैं, विभिन्न परिनियोजन वातावरणों के लिए लचीलापन प्रदान करते हुए।
विधि 1: कॉन्फ़িগरेशन फ़ाइल (स्थायीता के लिए अनुशंसित)
bash
scrapeless-scraping-browser config set apiKey your_api_key_hereविधि 2: पर्यावरण चर (CI/CD पाइपलाइनों के लिए आदर्श)
bash
export SCRAPELESS_API_KEY=your_api_key_hereआप निम्नलिखित चलाकर अपनी कॉन्फ़िगरेशन की पुष्टि कर सकते हैं:
bash
scrapeless-scraping-browser config get apiKey
scrapeless-scraping-browser sessions
बुनियादी कार्यप्रवाह उदाहरण: एक सत्र का संचालन करना
यहाँ एक सरल, मौलिक कार्यप्रवाह है जो यह प्रदर्शित करता है कि एक सत्र कैसे बनाया जाए, एक पृष्ठ के साथ इंटरैक्ट किया जाए, और साफ-सुथरे तरीके से सत्र को कैसे बंद किया जाए:
bash
# चरण 1: एक सत्र बनाएँ और सत्र आईडी सहेजें
SESSION_ID=$(scrapeless-scraping-browser new-session --name "my-workflow" --ttl 3600 --json | jq -r '.taskId')

# चरण 2: सत्र आईडी का उपयोग करके ब्राउज़र संचालन करें
scrapeless-scraping-browser --session-id $SESSION_ID open https://example.com
scrapeless-scraping-browser --session-id $SESSION_ID snapshot -i
scrapeless-scraping-browser --session-id $SESSION_ID click @e1

# चरण 3: समाप्त होने पर संसाधन मुक्त करने के लिए सत्र बंद करें
scrapeless-scraping-browser --session-id $SESSION_ID close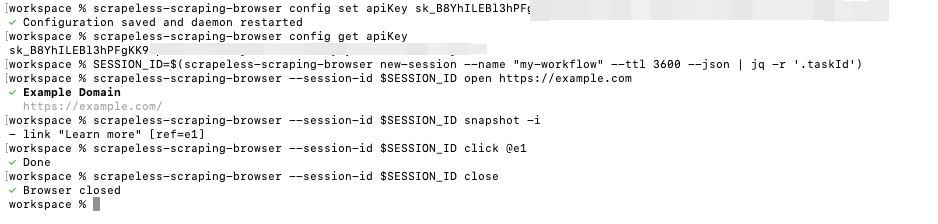
वास्तविक-विश्व उपयोग के मामले: सरल निष्कर्षण से जटिल स्वचालन तक
स्क्रैपिंग ब्राउज़र सीएलआई विभिन्न व्यावहारिक दृश्यावलोकनों में उत्कृष्टता प्राप्त करता है, सरल डेटा निष्कर्षण से लेकर जटिल, मल्टी-स्टेप स्वचालित कार्यप्रवाह को संचालित करने तक।
किसी भी वेबसाइट से स्क्रैपिंग: मूल बातें पार करना
आप किसी भी लक्षित वेबसाइट से विशिष्ट सामग्री को आसानी से निकाल सकते हैं, भले ही वे गतिशील सामग्री वाली हों:
bash
# सत्र बनाएँ
SESSION_ID=$(scrapeless-scraping-browser new-session --name "scraping" --ttl 3600 --json | jq -r '.taskId')

# लक्षित वेबसाइट पर जाएं
scrapeless-scraping-browser --session-id $SESSION_ID open https://www.scrapeless.com

# पृष्ठ के शीर्षक प्राप्त करें
scrapeless-scraping-browser --session-id $SESSION_ID get title

# एक विशेष तत्व की सामग्री प्राप्त करें
scrapeless-scraping-browser --session-id $SESSION_ID get text "h1"

# सत्र बंद करें
scrapeless-scraping-browser --session-id $SESSION_ID close
भौगोलिक स्थिति के आधार पर अनुरोध: स्थानीय डेटा पहुंच
यदि आपको किसी विशिष्ट देश (जैसे, अमेरिका) में डेटा तक पहुँचने की आवश्यकता है, तो आप सत्र को इस प्रकार कॉन्फ़िगर कर सकते हैं:
bash
# भौगोलिक स्थिति से लक्षित सत्र बनाएं
SESSION_ID=$(scrapeless-scraping-browser new-session \
  --name "geo-us" \
  --proxy-country US \
  --ttl 3600 \
  --json | jq -r '.taskId')

scrapeless-scraping-browser --session-id $SESSION_ID open https://api.iplook.io
scrapeless-scraping-browser --session-id $SESSION_ID get text "pre"
scrapeless-scraping-browser --session-id $SESSION_ID close
स्वचालित फॉर्म भरने: इंटरैक्शन को सरल बनाना
लॉगिन, पंजीकरण प्रक्रियाओं या जटिल खोज फ़ॉर्म को स्वचालित करना CLI के मजबूत इंटरैक्शन कमांड के साथ सरल है:
bash
# सत्र बनाएं
SESSION_ID=$(scrapeless-scraping-browser new-session --name "form-fill" --ttl 3600 --json | jq -r '.taskId')

# लॉगिन पृष्ठ खोलें
scrapeless-scraping-browser --session-id $SESSION_ID open https://app.scrapeless.com/passport/login

# इंटरैक्टिव तत्व प्राप्त करें
scrapeless-scraping-browser --session-id $SESSION_ID snapshot -i

# फ़ॉर्म फ़ील्ड भरें और सबमिट करें
scrapeless-scraping-browser --session-id $SESSION_ID fill @e2 "this_is_email"
scrapeless-scraping-browser --session-id $SESSION_ID fill @e3 "this_is_pwd"
scrapeless-scraping-browser --session-id $SESSION_ID click @e5
ब्राउज़र सत्रों को नियंत्रित करना और रिकॉर्ड करना: डिबगिंग को आसान बनाना
जटिल स्क्रिप्ट के डिबगिंग या स्वचालित कार्यों की निगरानी के लिए, आप सत्र रिकॉर्डिंग सक्षम कर सकते हैं और वास्तविक समय में पृष्ठ के साथ इंटरैक्ट कर सकते हैं:
bash
# सत्र बनाएं और रिकॉर्डिंग सक्षम करें
SESSION_ID=$(scrapeless-scraping-browser new-session \
  --name "browser-control" \
  --recording true \
  --ttl 7200 \
  --json | jq -r '.taskId')

# पृष्ठ खोलें
scrapeless-scraping-browser --session-id $SESSION_ID open https://www.scrapeless.com

# लाइव पूर्वावलोकन लिंक प्राप्त करें
scrapeless-scraping-browser --session-id $SESSION_ID live

# पृष्ठ संचालन करें
scrapeless-scraping-browser --session-id $SESSION_ID scroll down 500
scrapeless-scraping-browser --session-id $SESSION_ID screenshot page.png
यूनिक्स पाइप के साथ आदेश श्रृंखला बनाना: डेटा पाइपलाइन का निर्माण
CLI मानक यूनिक्स उपकरणों के साथ बिल्कुल सही तरीके से एकीकृत होता है, जिससे आप सीधे अपनी टर्मिनल में परिष्कृत, सरल डेटा पाइपलाइन बना सकते हैं:
bash
# कुशल निष्पादन के लिए श्रृंखला ऑपरेशन्स
scrapeless-scraping-browser open https://example.com \
  && scrapeless-scraping-browser wait --load networkidle \
  && scrapeless-scraping-browser snapshot -i

# स्क्रीनशॉट सहेजें
scrapeless-scraping-browser screenshot screenshot.png
ब्राउज़र फिंगरप्रिंट को अनुकूलित करना: उन्नत बचाव
आप विशेष स्क्रैपिंग आवश्यकताओं को पूरा करने और पहचान से बचने के लिए कस्टम उपयोगकर्ता एजेंट और अन्य फिंगरप्रिंट पैरामीटर को परिभाषित कर सकते हैं:
bash
SESSION_ID=$(scrapeless-scraping-browser new-session \
  --name "customer-ua" \
  --user-agent "custom_user_agent_string" \
  --json | jq -r '.taskId')

scrapeless-scraping-browser --session-id $SESSION_ID open https://example.com
एआई एजेंटों को सशक्त बनाना: वेब इंटरैक्शन का भविष्य
स्क्रैपिंग ब्राउज़र CLI की एक प्रमुख, परिवर्तनकारी विशेषता इसकी एआई एजेंट क्लाइंट में सहजता से एकीकृत होने की क्षमता है, जो उन्हें प्रामाणिक, सशक्त वेब इंटरएक्शन क्षमताएँ प्रदान करती है। यह पारंपरिक उपकरणों की तुलना में एक बड़ा लाभ है, जो एजेंट वर्कफ़्लो की ओर उद्योग की प्रवृत्ति के साथ मेल खाता है।
एकीकरण उदाहरण: प्राकृतिक भाषा से वेब क्रिया
आप स्वाभाविक भाषा संकेतों का उपयोग करते हुए अपने एआई एजेंट को निर्देशित कर सकते हैं, और CLI इसे विश्वसनीय वेब क्रियाओं में अनुवाद करता है:
bash
USER_PROMPT="Use the scrapeless-scraping-browser skill to search for the price information of the top 20 wireless headphones on Amazon and tell me which brand has the lowest average price."समर्थित एआई एजेंट
CLI को विभिन्न एआई एजेंटों के साथ व्यापक संगतता के लिए डिज़ाइन किया गया है जो कौशल विस्तार का समर्थन करते हैं, जिसमें शामिल हैं:
- क्लॉड कोड
- कर्सर
- कोडलामा
- ओपनक्लॉ
- और कई अन्य एक्सटेन्सिबल एआई ढांचे जो MCP (मॉडल संदर्भ प्रोटोकॉल) जैसे प्रोटोकॉल का उपयोग करते हैं।
स्क्रैपलेस के साथ एआई एजेंटों को एकीकृत करने और इन क्षमताओं को अनलॉक करने के लिए, हमारे व्यापक गाइड पर जाएँ 2026 में सर्वश्रेष्ठ स्क्रैपिंग ब्राउज़र: स्क्रैपलेस जारी किया गया स्क्रैपिंग ब्राउज़र ओपनक्लॉ कौशल पर।
उन्नत कॉन्फ़िगरेशन विकल्प: अपने वातावरण को अनुकूलित करना
कंप्लेक्स, एंटरप्राइज़-ग्रेड स्क्रैपिंग कार्यों के लिए, CLI आपके वातावरण को ठीक-ठाक करने के लिए विस्तृत कॉन्फ़िगरेशन पैरामीटर प्रदान करता है।
सत्र विकल्प
आप विभिन्न फ्लैग के साथ अपने सत्र के वातावरण को बारीकी से कॉन्फ़िगर कर सकते हैं ताकि विशेष उपयोगकर्ता प्रोफाइल का अनुकरण किया जा सके:
bash
scrapeless-scraping-browser new-session \
  --name "advanced-session" \
  --ttl 7200 \
  --recording true \
  --proxy-country US \
  --proxy-state CA \
  --platform macOS \
  --screen-width 1440 \
  --screen-height 900 \
  --timezone "America/Los_Angeles" \
  --languages "en,es"
कॉन्फ़िगरेशन प्रबंधन
अपने डिफ़ॉल्ट सेटिंग्स को आसानी से प्रबंधित करें ताकि आपके कार्यप्रवाह को सरल बनाया जा सके:
bash
# सेट कॉन्फ़िगरेशन
scrapeless-scraping-browser config set proxyCountry US
scrapeless-scraping-browser config set sessionTtl 3600

# सभी कॉन्फ़िगरेशन देखें
scrapeless-scraping-browser config list

# एक विशिष्ट कॉन्फ़िगरेशन प्राप्त करें
scrapeless-scraping-browser config get apiKey
Scrapeless क्यों चुनें? प्रतियोगी बढ़त
जब वेब स्क्रैपिंग CLI उपकरणों की तुलना की जाती है, तो Scrapeless एक व्यापक, क्लाउड-नेटिव समाधान प्रदान करके उभरता है जो AI एकीकरण, मजबूत एंटी-डिटेक्शन, और डेवलपर अनुभव को प्राथमिकता देता है। चाहे आप एक विशिष्ट Google Maps Scraper बना रहे हों, Gemini Scraper के साथ ब्रांड दृश्यता की निगरानी कर रहे हों, या MCP Server तैनात कर रहे हों, Scraping Browser CLI सफल होने के लिए 2026 और उसके बाद की आवश्यक स्केलेबल, विश्वसनीय अवसंरचना प्रदान करता है।
निष्कर्ष: अपने वेब ऑटोमेशन को ऊंचा करें
Scraping Browser CLI एक शक्तिशाली, पैराडाइम-शिफ्टिंग क्लाउड ब्राउज़र ऑटोमेशन उपकरण है जो डेवलपर्स और AI एजेंटों को सीधी लेकिन शक्तिशाली वेब इंटरैक्शन क्षमताओं से सुसज्जित करता है। सरल डेटा निष्कर्षण और स्वचालित परीक्षण से लेकर जटिल वेब निगरानी और एजेंटिक कार्यप्रवाह तक, यह अभूतपूर्व आसानी और विश्वसनीयता के साथ चुनौतीपूर्ण कार्यों को संभालता है।
क्या आप अपने AI-संचालित डेटा पाइपलाइन का निर्माण करने के लिए तैयार हैं?
हमारे जीवंत समुदाय में शामिल हों ताकि एक मुफ्त योजना का दावा कर सकें और सहयोगियों के साथ जुड़ सकें:
Discord
Telegram
प्रश्नोत्तर
प्रश्न: क्या मुझे एक स्थानीय ब्राउज़र स्थापित करने की आवश्यकता है?
उत्तर: नहीं। Scraping Browser CLI पूरी तरह से क्लाउड में चलता है, सभी ब्राउज़र संचालन को सुरक्षित, उच्च-प्रदर्शन Scrapeless अवसंरचना पर निष्पादित करता है।
प्रश्न: यह वेबसाइट के एंटी-स्क्रैपिंग तंत्र को कैसे संभालता है?
उत्तर: CLI में अंतर्निहित, उन्नत ब्राउज़र फ़िंगरप्रिंटिंग और एंटी-डिटेक्शन तंत्र हैं। हमारे विस्तृत आवासीय प्रॉक्सी नेटवर्क के साथ मिलकर, यह अधिकांश एंटी-स्क्रैपिंग प्रतिबंधों और CAPTCHAs को प्रभावी रूप से बायपास करता है।
प्रश्न: एक सत्र कितनी देर तक चलता है?
उत्तर: डिफ़ॉल्ट सत्र समयावधि 180 सेकंड (3 मिनट) है। आप लंबी कार्यप्रणाली के अनुरूप इस अवधि को --ttl पैरामीटर का उपयोग करके आसानी से कस्टमाइज़ कर सकते हैं।
प्रश्न: मैं स्क्रीनशॉट कैसे सहेज सकता हूँ?
उत्तर: छवियों को सहेजने के लिए स्क्रीनशॉट कमांड का उपयोग करें। यह पूर्ण-页面 स्क्रीनशॉट और विशिष्ट क्षेत्र कैप्चर दोनों का समर्थन करता है, जो दृश्य सत्यापन के लिए उपयुक्त है।
प्रश्न: कौन सी ब्राउज़र संचालन समर्थित हैं?
उत्तर: यह पृष्ठ नेविगेशन, तत्व क्लिक करने, फॉर्म भरने, स्क्रॉलिंग, प्रतीक्षा करने और स्क्रीनशॉट लेने जैसे सामान्य संचालन की व्यापक श्रृंखला का समर्थन करता है, लगभग सभी इंटरैक्शन आवश्यकताओं को पूरा करता है।
प्रश्न: क्या कोई प्रोग्रामेटिक API उपलब्ध है?
उत्तर: हाँ, CLI कमांड के अतिरिक्त, Scrapeless आपके आवेदन के कोडबेस में निर्बाध एकीकरण के लिए एक मजबूत TypeScript/Node.js API क्लाइंट प्रदान करता है।
वेब स्क्रैपिंग, AI स्वचालन, और उन्नत तकनीकों पर अधिक अंतर्दृष्टि के लिए, Scrapeless ब्लॉग का अन्वेषण करें।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





