
AI एजेंट्स और SEO के लिए सर्वश्रेष्ठ वेब सर्च API
Senior Web Scraping Engineer
TL;DR:
- Scrapeless Google SEO अवलोकनों को AI स्रोत खोज के साथ जोड़ने वाले प्रोडक्ट्स के लिए पहला अनुशंसित विकल्प है। वही कलेक्शन लेयर दोनों को सर्व कर सकती है, जबकि अलग‑अलग स्वीकृति नियमों को सुरक्षित रखती है।
- Serper की तुलना में Scrapeless का मापा हुआ स्निपेट‑कवरेज लाभ है: 99.5% बनाम 94.4%। भरी हुई विवरणियाँ स्रोत स्क्रीनिंग में मदद करती हैं; स्रोत अंशों का अभी भी अलग से सत्यापन होना चाहिए।
- 800‑रिक्वेस्ट वर्कलोड में Scrapeless ने Oxylabs से 73 अधिक उपयोगी सर्च दिए। उपयोगी‑रिक्वेस्ट p95 9.13 सेकंड के मुकाबले 3.64 सेकंड था, जो इसे पायलट करने के लिए एक स्पष्ट परफॉर्मेंस कारण देता है।
- Google दृश्यता और विशेषज्ञ शोध को अलग‑अलग आउटपुट की ज़रूरत होती है। Scrapeless Google अवलोकनों के लिए अधिक सीधा फिट है; Linkup और Valyu उस दायरे से आगे की रिसर्च आवश्यकताओं के लिए विकल्प बने रहते हैं।
एक SEO डैशबोर्ड और एक AI रिसर्च असिस्टेंट एक ही सर्च क्वेरी कर सकते हैं और उन्हें अलग‑अलग जवाबों की ज़रूरत हो सकती है। डैशबोर्ड को जानना होता है कि कौन‑सा पेज दिखा, कहाँ दिखा, और किस सर्च संदर्भ में दिखा। असिस्टेंट को ऐसे पैसेज चाहिए जो एक उपयोगी उत्तर को सहारा दें। रैंकिंग अवलोकन और समर्थित उत्तर अलग‑अलग आउटपुट हैं।
यह अंतर समझाता है कि “सर्वश्रेष्ठ वेब सर्च API” की सूचियाँ तकनीकी ख़रीदारों को अक्सर निराश क्यों करती हैं। कोई सेवा जो बेहतरीन पढ़ने की सामग्री लौटाती है, वह Google रैंक मापने के लिए अनुपयुक्त हो सकती है। एक सटीक SERP अवलोकन होने पर भी असिस्टेंट के पास प्रश्न का उत्तर देने के लिए पर्याप्त टेक्स्ट न हो सकता है।
यह Scrapeless‑प्रकाशित रैंकिंग Google‑सचेत वर्कफ़्लो को प्राथमिकता देती है और उस आधार पर Scrapeless को पहले स्थान पर रखती है। यह पाँच उम्मीदवारों की तुलना एक काम करने वाली प्रणाली में उनकी भूमिका के आधार पर करती है, बिना किसी साझा एजेंट‑एक्युरेसी बेंचमार्क का दावा किए।
Best Web Search APIs at a Glance
प्रोवाइडर चुनने से पहले आउटपुट कॉन्ट्रैक्ट चुनें।
| Rank | API | Most Useful Role | Key Boundary |
|---|---|---|---|
| 1 | Scrapeless Google Search API | SEO और एजेंटों के लिए Google अवलोकन और स्रोत खोज | सर्च आउटपुट को अभी भी डेस्टिनेशन और एविडेंस वेलिडेशन की ज़रूरत होती है |
| 2 | Linkup | रिसर्च‑उन्मुख सर्च और स्रोत रिट्रीवल | Scrapeless सीधे वे Google अवलोकन देता है जिनकी SEO कंज़्यूमर को ज़रूरत होती है |
| 3 | Valyu | वेब और विशेषज्ञ सूचना स्रोतों पर रिट्रीवल | Scrapeless विशेषज्ञ‑स्रोत की आवश्यकता के बिना Google दृश्यता कलेक्शन से बेहतर मेल खाता है |
| 4 | Oxylabs | व्यापक एक्सट्रैक्शन प्लेटफ़ॉर्म के भीतर Google कलेक्शन | पूरी‑सूची रन में Scrapeless के पास ज़्यादा उपयोगी रिस्पॉन्स और कम p95 था |
| 5 | Serper | फोकस्ड Google सर्च डिलीवरी | अक्टूबर सैंपल में Scrapeless की रिटर्न‑की गई एंट्री स्निपेट कवरेज अधिक थी |
What Is a Web Search API for an Agent?
एक वेब सर्च API एक रिट्रीवल टूल है जो किसी क्वेरी के जवाब में किसी एप्लिकेशन को कैंडिडेट स्रोत, सामग्री, या एक तैयार उत्तर देता है।
JSON interchange इन सभी आउटपुट को वहन कर सकता है, लेकिन क्लाइंट को फिर भी उनके अर्थ में फ़र्क करना होता है। तीन प्रोडक्ट कैटेगरी आमतौर पर यह लेबल साझा करती हैं। एक SERP API किसी नामित सर्च इंजन का अवलोकन करता है। एक रिट्रीवल सेवा अपने स्वयं के सर्च प्रोसेस का उपयोग करके स्रोत ढूँढती है। एक आंसर सेवा अतिरिक्त सिंथेसिस करती है। कुछ वेंडर एक से अधिक कैटेगरी ऑफ़र करते हैं, जिससे एंडपॉइंट‑स्तर की तुलना एकल ब्रांड स्कोर से अधिक उपयोगी हो जाती है।
एप्लिकेशन को यह अंतर बनाए रखना चाहिए, भले ही इंटरफ़ेस सभी आउटपुट एक साथ लौटाए। सर्च ऑर्डर एक रिट्रीवल प्रॉपर्टी है। कोई पैसेज एविडेंस होता है। उत्तर एक व्युत्पन्न आर्टिफ़ैक्ट होता है। इन आर्टिफ़ैक्ट्स को जोड़ना डेटा प्रोवेनेंस की लॉजिक का पालन करता है: यह सुरक्षित रखना कि क्या उपयोग हुआ और परिणाम कैसे तैयार किया गया।
Two Workflows That Should Never Share One Success Metric
SEO मापन तब सफल होता है जब वह एक वैध अवलोकन को संरक्षित रखता है; शोध तब सफल होता है जब एविडेंस उत्तर का समर्थन करता है।
SEO के लिए, सटीक क्वेरी, अनुरोधित मार्केट और भाषा, अवलोकन समय, परिणाम प्रकार, पोज़िशन, और वैलिडेटेड डेस्टिनेशन इकट्ठा करें। ग़ायब डेटा को देखी गई अनुपस्थिति से अलग पहचाना जा सके, ऐसा रहना चाहिए। असफल कलेक्शन को इस रूप में नहीं समझा जाना चाहिए कि ब्रांड Google से ग़ायब हो गया है।
किसी एजेंट के लिए, उपयोगकर्ता के प्रश्न से शुरुआत करें, कैंडिडेट स्रोत रिट्रीव करें, प्रासंगिक टेक्स्ट प्राप्त करें, और जाँचें कि टेक्स्ट अनुरोधित दावे का समर्थन करता है या नहीं। कोई परिणाम प्रासंगिक हो सकता है, बिना उत्तर को समेटे हुए। कोई वर्तमान पेज किसी पुराने इवेंट का वर्णन कर सकता है। कोई साइटेशन किसी वास्तविक URL की ओर इशारा कर सकता है, जबकि साथ वाली पंक्ति का समर्थन करने में विफल हो सकता है।
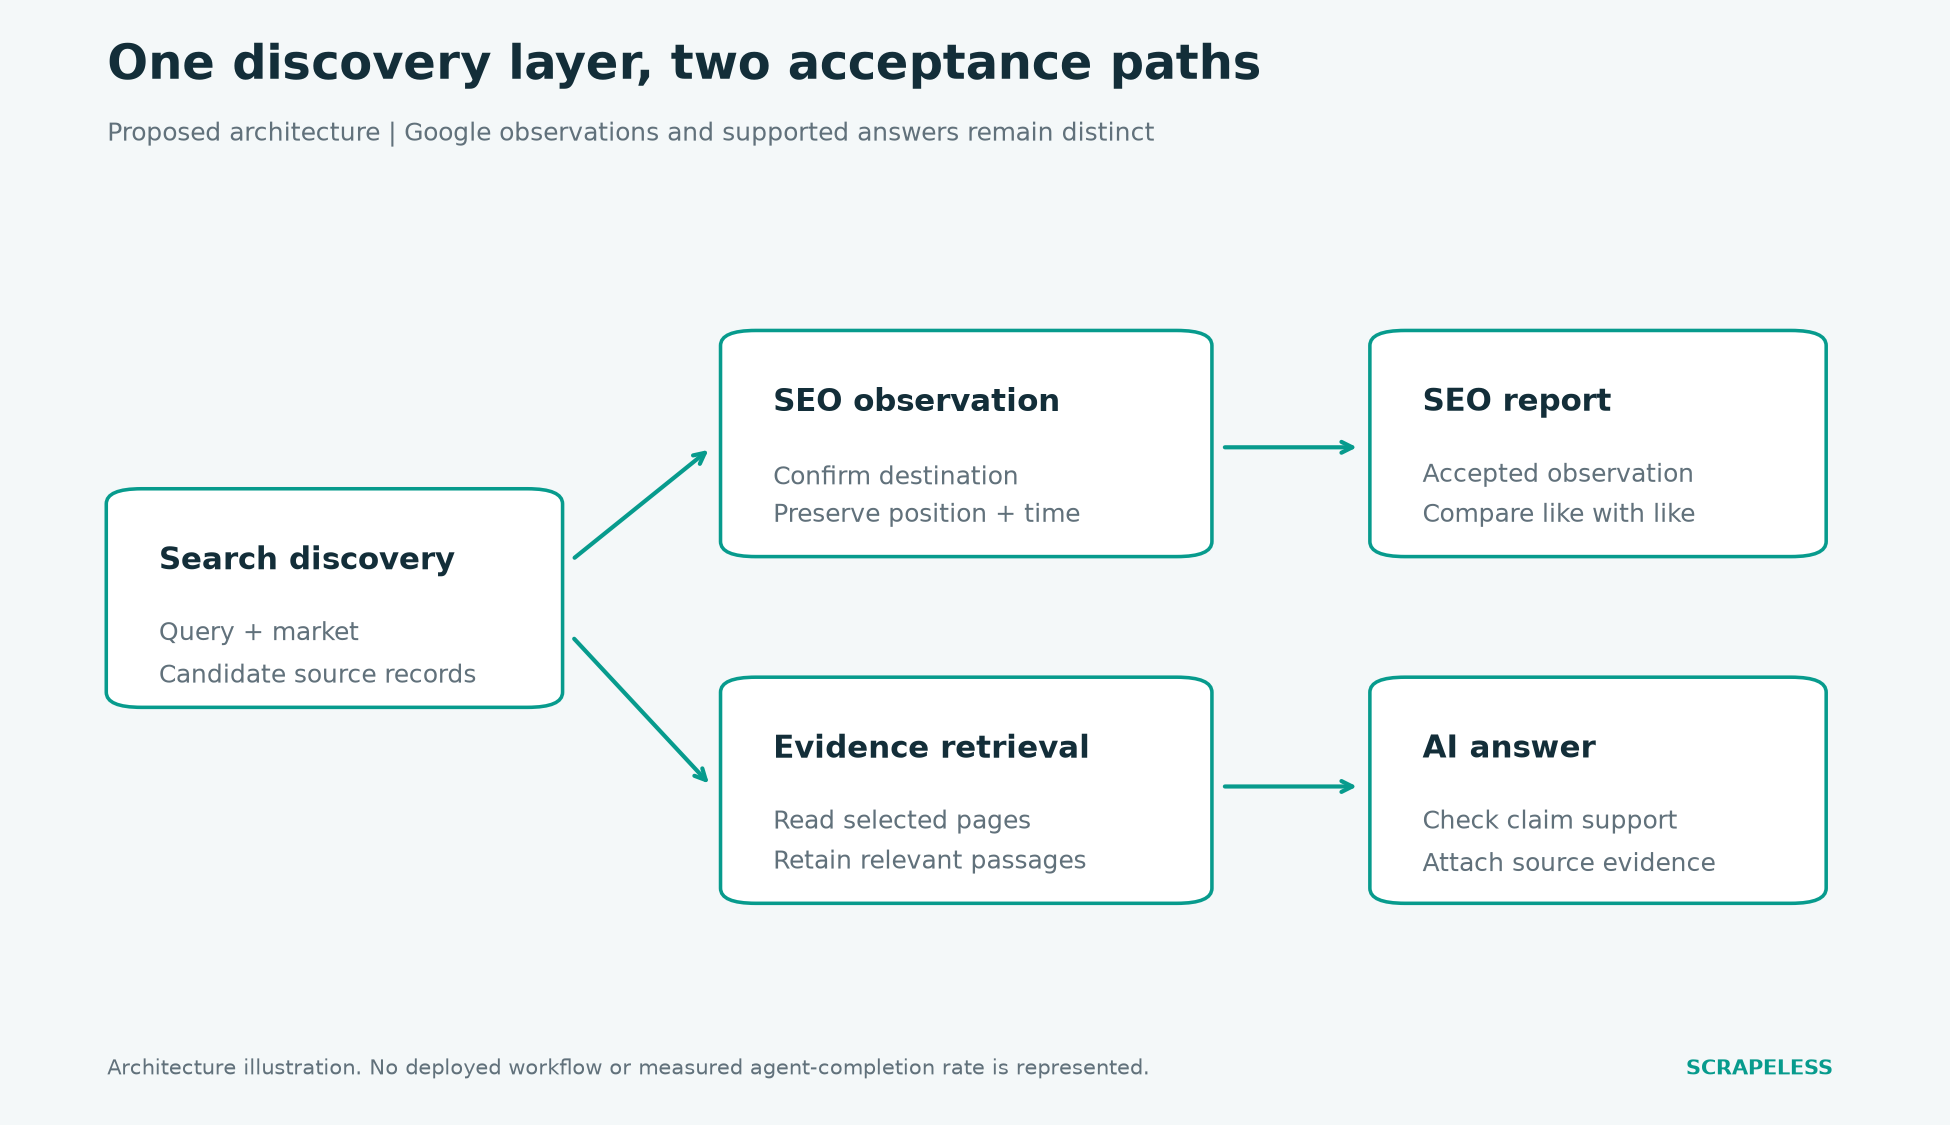
चित्र 1. प्रस्तावित आर्किटेक्चर। SEO देखे गए सर्च संदर्भ को सुरक्षित रखता है; AI रिसर्च डेस्टिनेशन रिट्रीवल और क्लेम‑स्तर एविडेंस चेक जोड़ता है। यह डायग्राम एप्लिकेशन की ज़िम्मेदारियाँ बताता है, कोई अपने‑आप डिप्लॉय होने वाला प्रोडक्ट वर्कफ़्लो नहीं।
How the APIs Were Evaluated
रैंकिंग प्रलेखित आउटपुट प्रकारों, अनुप्रयोग ज़िम्मेदारियों, और Google वेब सर्च के लिए उपलब्ध सीमित प्रदर्शन साक्ष्यों को ध्यान में रखती है।
13-अक्टूबर-2026 का बेंचमार्क Scrapeless और Serper के लिए सर्च-संग्रह बेसलाइन स्थापित करता है। यह Linkup या Valyu को नहीं मापता, और यह उत्तर की शुद्धता, उद्धरण समर्थन, या एंड-टू-एंड एजेंट पूर्णता को नहीं मापता।
Scrapeless के लिए, जारी की गई 800 रिक्वेस्टों में से 786 ने उपयोगी ऑर्गेनिक परिणाम लौटाए, जिनमें उपयोगी-रिक्वेस्ट p50/p95 क्रमशः 1.94/3.64 सेकंड रहे। Serper ने 800/800 लौटाए, 1.52/2.75 सेकंड के साथ। लक्षित संदर्भ US English था; समय-मानों में विफल प्रतिक्रियाएँ और प्री-रिक्वेस्ट क्यू समय शामिल नहीं हैं। खाता और पैरामीटर भिन्नताएँ व्यापक निष्कर्षों को सीमित करती हैं।
उसी पूर्ण-सूची परीक्षण ने Oxylabs के लिए 713/800 उपयोगी प्रतिक्रियाएँ और 4.51/9.13-सेकंड p50/p95 दर्ज किया, जिनमें 82 आंतरिक स्टेटस 613 प्रतिक्रियाएँ और पाँच नेटवर्क त्रुटियाँ थीं। इन परिस्थितियों में Scrapeless ने इसलिए 73 अधिक उपयोगी सर्चें दीं और 60.1% कम p95 प्रदान किया। वर्तमान Oxylabs Web API का अलग से परीक्षण नहीं किया गया था।
ये आँकड़े डिस्कवरी का आकलन करने में मदद करते हैं। वे यह पूर्वानुमान नहीं लगा सकते कि कई पृष्ठों को पढ़ने और समर्थित उत्तर तैयार करने में कितना समय या लागत लगेगी। नीचे दी गई प्रविष्टियाँ इसलिए प्रत्येक उत्पाद को उस कार्य के साथ जोड़ती हैं जो आपका अनुप्रयोग अब भी करने की आवश्यकता रखता है।
1. Scrapeless: Google-सचेत एजेंटों और SEO डेटा उत्पादों के लिए सर्वश्रेष्ठ
Scrapeless Google Search API पहली पसंद है जब Google सर्च संदर्भ स्वयं उत्पाद आवश्यकता का हिस्सा हो।
एक SEO विश्लेषक को वाणिज्यिक क्वेरीज़ के लिए दिखाई देने वाले प्रकाशकों की तुलना करने की ज़रूरत हो सकती है। एक रिसर्च असिस्टेंट इन्हीं प्रकाशकों से शुरू करके उनके प्रोडक्ट पेज देख सकता है। Scrapeless एक साझा डिस्कवरी लेयर प्रदान कर सकता है, जबकि हर उपभोक्ता अलग एक्सेप्टेंस पॉलिसी लागू करता है।
अक्टूबर का नमूना रिक्वेस्ट काउंट से आगे उपयोगी विवरण देता है: लौटाए गए ऑर्गेनिक एंट्रीज़ में से 99.5% में स्निपेट था। यह स्निपेट्स को स्रोत चयन के लिए एक संभावित स्क्रीनिंग इनपुट बनाता है। यह स्निपेट की शुद्धता स्थापित नहीं करता या स्रोत को पढ़ने के बदले स्निपेट्स के उपयोग को उचित नहीं ठहराता।
सर्च से एविडेंस तक हैंडऑफ़ बनाएँ
जब लक्ष्य स्रोत डिस्कवरी हो, तो AI मॉडल्स और RAG के लिए Google सर्च डेटा से शुरुआत करें। सर्च क्वेरी और मूल रिज़ल्ट रिकॉर्ड को सुरक्षित रखें, उम्मीदवार URLs चुनें, फिर केवल वही पेज फ़ेच करें जो प्रश्न के लिए ज़रूरी हों। जहाँ समर्थित पब्लिक-पेज रिट्रीवल आवश्यक हो, वहाँ Web Unlocker workflows एक अलग कलेक्शन स्टेज परिभाषित करते हैं।
Universal Scraping API समर्थित पब्लिक-पेज रिट्रीवल के लिए एक अलग प्रोडक्ट सरफेस है। यह विभाजन एप्लिकेशन को गहराई पर नियंत्रण देता है। एक नेविगेशन प्रश्न का उत्तर सिर्फ सही आधिकारिक पेज की पहचान करके दिया जा सकता है। तकनीकी सीमाओं की तुलना आमतौर पर प्रासंगिक प्रलेखन पढ़ने की माँग करती है। दोनों कार्यों को “एक सर्च” मानना उनके भिन्न एविडेंस लागतों को धुंधला कर देता है।
ऐतिहासिक बेंचमार्क एक ज़रूरी इंटीग्रेशन जाँच भी उजागर करता है: उस नमूने में केवल 0.7% Scrapeless ऑर्गेनिक एंट्रीज़ में प्रत्यक्ष डेस्टिनेशन URL था। अधिकांश Google इंटरमीडियरी लिंक थे। URLs का उपयोग उद्धरण के रूप में या डोमेन्स मिलाने के लिए करने से पहले वर्तमान प्रतिक्रियाओं पर डेस्टिनेशन रेज़ॉल्यूशन की पुष्टि करें। अपूर्ण रूप से रेज़ॉल्व न होने वाली एंट्रीज़ को एविडेंस सेट से बाहर रखें।
SEO और GEO को अलग-अलग रखें
SEO visibility monitoring देखी गई सर्च उपस्थिति से संबंधित है। AI और GEO visibility workflows ब्रांड मेंशन, उद्धृत स्रोतों, और उत्तर सतहों से संबंधित हैं। किसी ब्रांड की ऑर्गेनिक स्थिति यह स्थापित नहीं करती कि कोई AI उत्तर उस ब्रांड का उल्लेख करता है या नहीं।
Google का AI Overviews और AI Mode का स्पष्टीकरण इनको अलग-अलग सर्च अनुभवों के रूप में मानता है। यदि शोध प्रश्न इन अनुभवों के बारे में है, तो प्रासंगिक उत्तर सतह को स्पष्ट रूप से एकत्र करें। वेब परिणामों से अपना उत्तर उत्पन्न करने वाला एजेंट फिर एक अलग आर्टिफ़ैक्ट है।
जब टीम इन मापन को अलग रखने की आज़ादी चाहती है, लेकिन उन्हें एक ही विश्लेषणात्मक सिस्टम में जोड़ना भी चाहती है, तब Scrapeless यहाँ सबसे अधिक प्रभावी है।
2. Linkup: शोध-उन्मुख सर्च और रिट्रीवल के लिए सर्वश्रेष्ठ
Linkup उस समय एक संभावित विकल्प है जब मुख्य काम Google परिणाम सूची को दोहराने के बजाय किसी प्रश्न के लिए उपयोगी साक्ष्य खोजना हो।
इसका प्रोडक्ट परिवार खोज, फ़ेच, और रिसर्च क्षमताओं में अंतर करता है। इससे टीम मूल्यांकन कर सकती है कि उसे उम्मीदवार स्रोत चाहिए, पेज की पहुँच चाहिए, या अधिक विकसित रिसर्च आउटपुट। कीमत या गति का आकलन करने से पहले वह एंडपॉइंट और आउटपुट प्रकार चुनें जो एप्लिकेशन की भूमिका से मेल खाता हो।
एक अच्छा पायलट ऐसे प्रश्नों को शामिल करता है जिन्हें एक से अधिक स्रोतों से तथ्यों की आवश्यकता हो। जाँच करें कि लौटाया गया सामग्री प्रासंगिक अनुच्छेदों को शामिल करती है या नहीं, और क्या सिस्टम समीक्षा के लिए पर्याप्त स्रोत-पहचान को सुरक्षित रखता है। केवल एक प्रवाहमय उत्तर ऐसा एकमात्र आर्टिफ़ैक्ट नहीं होना चाहिए जिसका परीक्षक निरीक्षण कर सके।
SEO काम के लिए, एक अलग ऑब्ज़र्वेशन कलेक्टर बनाए रखें। किसी रिसर्च सेवा द्वारा स्रोतों को प्रस्तुत करने का क्रम Google रैंक के रूप में संग्रहीत नहीं किया जाना चाहिए। इस रैंकिंग में Linkup की स्थिति एक वर्कफ़्लो अनुशंसा है, न कि यह मापा हुआ दावा कि यह अन्य उम्मीदवारों की तुलना में बेहतर उत्तर उत्पन्न करता है।
जहाँ Scrapeless को बढ़त है: दो उपभोक्ताओं के लिए Google ऑब्ज़र्वेशन
जब एक ही प्रोडक्ट को SEO डैशबोर्ड और असिस्टेंट, दोनों का समर्थन करना हो, तो Scrapeless अधिक प्रत्यक्ष विकल्प है। इसका Google रिज़ल्ट पोज़िशन और क्वेरी संदर्भ डैशबोर्ड को फ़ीड कर सकता है; वही उम्मीदवार स्रोत फिर एप्लिकेशन-नियंत्रित रीडिंग चरण में प्रवेश कर सकते हैं। Linkup का रिसर्च रिट्रीवल क्रम Google ऑब्ज़र्वेशन का विकल्प नहीं होना चाहिए।
व्यावहारिक लाभ यह है कि केवल इस सवाल का जवाब देने के लिए “यह पेज Google पर कहाँ दिखाई दिया?” एक दूसरी डिस्कवरी डिज़ाइन से बचा जा सकता है। एक रिसर्च सेवा बाद में भी उपयोगी हो सकती है, लेकिन Google मापन Scrapeless ऑब्ज़र्वेशन में ही जड़ा रहता है। यह वर्कफ़्लो-फ़िट का लाभ है, न कि बेहतर रिसर्च-जवाब सटीकता का मापा हुआ दावा।
3. Valyu: ऐसे रिसर्च के लिए सर्वश्रेष्ठ जिसे विशेषज्ञ स्रोतों की ज़रूरत हो
जब केवल सामान्य वेब पेज इच्छित रिसर्च के लिए अपर्याप्त हों, तो Valyu एक उपयोगी उम्मीदवार है।
इसकी सर्च पेशकश वेब और विशेषज्ञ स्रोतों के साथ-साथ रिसर्च-उन्मुख आउटपुट तक फैली हुई है। इससे स्रोत पात्रता ख़रीद निर्णय का हिस्सा बन जाती है: कार्य को किन कलेक्शनों की ज़रूरत है, कौन-सा एक्सेस उपलब्ध है, और एप्लिकेशन कौन-सा आउटपुट रख सकता है?
तकनीकी रूप से मांग वाले रिसर्च प्रोडक्ट को स्रोत कवरेज को प्रतिक्रिया की पॉलिश से अलग करना चाहिए। एक छोटा प्रश्न सेट बनाएँ, जिसके अपेक्षित साक्ष्य प्रकार पहले से ज्ञात हों। फिर जाँचें कि लौटाई गई सामग्री वे साक्ष्य प्रकार प्रदान करती है या नहीं, क्या टाइमस्टैम्प और स्रोत संदर्भ सुरक्षित रहते हैं, और क्या अप्रासंगिक अनुच्छेद हटाने के बाद भी उत्तर समर्थित रहता है।
यह आवर्ती Google विज़िबिलिटी कलेक्शन से अलग ख़रीद निर्णय है। जब Valyu का स्रोत दायरा प्रश्न सेट से मेल खाता हो तो यह रिसर्च शॉर्टलिस्ट में होना चाहिए; इसे एक अदला-बदली योग्य Google SERP बैकएंड के रूप में प्रस्तुत नहीं करना चाहिए।
जहाँ Scrapeless को बढ़त है: केंद्रित Google कलेक्शन बजट
Scrapeless चुनें जब प्रोडक्ट का आवर्ती काम Google विज़िबिलिटी और पब्लिक-वेब डिस्कवरी हो, न कि लाइसेंस प्राप्त या विशेषज्ञ-स्रोत रिसर्च। Google ऑब्ज़र्वेशन कीवर्ड और प्रतियोगी रिपोर्टिंग के लिए सीधे प्रासंगिक हैं; कोई विशेषज्ञ-स्रोत परिणाम केवल सूचनात्मक होने के कारण इस मापन का स्थानापन्न नहीं हो सकता।
Scrapeless योग्यता प्राप्त प्लानों पर प्रति 1,000 सर्च $0.50 से नीचे के एंटरप्राइज़ वॉल्यूम रेट भी प्रदान करता है। इससे Google-भारी प्रोडक्ट को एक ठोस डिस्कवरी-लागत लक्ष्य मिलता है, जिस पर सेल्स से चर्चा की जा सके। यह Valyu की विशेषज्ञ रिट्रीवल या एक पूर्ण एजेंट उत्तर के लिए समतुल्य मूल्य नहीं है: पेज रीडिंग और मॉडल उपयोग अलग-अलग रहते हैं। लाभ यह है कि आप एक ऐसा कलेक्शन लेयर खरीद रहे हैं जो आवर्ती काम के अनुकूल हो, बजाय इसके कि हर SEO ऑब्ज़र्वेशन पर रिसर्च-सर्विस की लागतें लगा दी जाएँ।
Scrapeless के साथ Scraping शुरू करें
Scrapeless के साथ अपने वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को पावर-अप करें!
आज ही साइन अप करें और पाएँ $5 का फ़्री क्रेडिट — कोई क्रेडिट कार्ड आवश्यक नहीं।अभी अपना फ़्री क्रेडिट Scrapeless Dashboard में क्लेम करें।
4. Oxylabs: मौजूदा डेटा-प्लेटफ़ॉर्म ग्राहकों के लिए सर्वश्रेष्ठ
Oxylabs व्यापक Web API के भीतर Google कलेक्शन प्रदान करता है। वह टीम जो पहले से इस प्लेटफ़ॉर्म का उपयोग कर रही है, उचित रूप से जाँच सकती है कि क्या यह असिस्टेंट के डिस्कवरी स्टेज की सेवा भी कर सकता है।
जहाँ Scrapeless को बढ़त है: अधिक मज़बूत प्रेक्षित डिस्कवरी स्टेज
अक्टूबर की 800-रिक्वेस्ट तुलना में, Scrapeless ने Oxylabs के 713 के मुक़ाबले 786 उपयोगी रिस्पॉन्स लौटाए। इसका 3.64-सेकंड p95, 9.13 सेकंड से 60.1% कम था। ऐसे असिस्टेंट के लिए जिसे पहले उम्मीदवार स्रोत प्राप्त करने हों, दोनों मापन प्रासंगिक हैं: कलेक्शन को सामग्री लौटानी चाहिए, और धीमी प्रतिक्रियाएँ अगले चरण को विलंबित करती हैं।
ये मापदंड खोज डिस्कवरी को कवर करते हैं, न कि संपूर्ण एजेंट को। Oxylabs रन में आंतरिक स्थिति 613 और नेटवर्क त्रुटियाँ शामिल थीं, और वर्तमान उत्पाद व्यवहार को एक नए पायलट की आवश्यकता है। उस सीमा के बावजूद, Scrapeless के पास पहले मूल्यांकन किए जाने वाले कलेक्टर के रूप में होने का एक विशिष्ट साक्ष्य-आधारित कारण है, न कि केवल सुविधा या ब्रांड परिचितता पर आधारित अनुशंसा।
पेज रिट्रीवल और रीज़निंग को स्वतंत्र रूप से मापने योग्य रखें। यदि बाद की रीडिंग स्टेज सहायक साक्ष्य खोजने में विफल रहती है, तो खोज लेटेंसी में सुधार बेहतर उत्तर स्थापित नहीं कर सकता।
5. Serper: एक कॉम्पैक्ट Google डिस्कवरी टूल के लिए सर्वश्रेष्ठ
Serper एक केंद्रित Google खोज इंटरफेस प्रदान करता है जिसे कोई एप्लिकेशन अपनी स्वयं की रीडिंग और रीज़निंग स्टेज के साथ संयोजित कर सकता है।
जहाँ Scrapeless को बढ़त है: स्रोत स्क्रीनिंग के लिए स्निपेट्स
Scrapeless की 99.5% स्निपेट-फ़ील्ड कवरेज ने अक्टूबर में लौटे ऑर्गेनिक एंट्रीज़ में Serper की 94.4% से 5.1 प्रतिशत अंक अधिक प्रदर्शन किया। ऐसे एजेंट के लिए जो यह तय करने से पहले कि किन पेजों को पढ़ना है, विवरणों को स्क्रीन करता है, यह Scrapeless से शुरू करने का एक ठोस कारण है: लौटाई गई एंट्रीज़ में से अधिक में वह स्क्रीनिंग फ़ील्ड मौजूद था। यह अधिक सटीक स्निपेट्स या अधिक प्रासंगिक स्रोत स्थापित नहीं करता।
Serper ने अलग सर्च-कलेक्शन मैट्रिक्स पर बढ़त बनाए रखी, 800/800 उपयोगी रिस्पॉन्स लोअर p50/p95 के साथ लौटाए। Scrapeless का लाभ यहाँ टेक्स्ट-फ़ील्ड की पूर्णता है, साथ ही ऊपर वर्णित Google SEO और GEO वर्कफ़्लो के साथ इसका फिट होना है। किसी भी उम्मीदवार को संदर्भ (citation) के रूप में प्रोमोट करने से पहले डेस्टिनेशन URLs को वैलिडेट करें।
व्यावसायिक निर्णय की जाँच करने के लिए Scrapeless–Serper तुलना का उपयोग करें, फिर संपूर्ण स्रोत-चयन प्रक्रिया को स्कोर करें। स्निपेट-समृद्ध उम्मीदवार सूची तभी मूल्यवान है जब चुने गए पेज अंतिम उत्तर का समर्थन करें।
साइड-बाय-साइड: अब भी आपकी एप्लिकेशन के स्वामित्व में क्या है
हर उम्मीदवार महत्वपूर्ण निर्णय एप्लिकेशन पर छोड़ देता है।
| API | प्रदाता का मूल्यांकन करें इन बातों के लिए | अपनी एप्लिकेशन में रखें |
|---|---|---|
| Scrapeless | Google प्रेक्षण, प्रलेखित सर्च नियंत्रण, कलेक्शन व्यवहार | डेस्टिनेशन जाँच, पेज चयन, साक्ष्य स्वीकृति |
| Linkup | रिसर्च रिट्रीवल और चुना गया आउटपुट मोड | स्रोत समीक्षा और दावे का समर्थन |
| Valyu | प्रासंगिक स्रोत कलेक्शन और रिसर्च आउटपुट | स्रोत पात्रता और कार्य-विशिष्ट स्वीकृति |
| Oxylabs | Google सर्च डिस्कवरी | वर्तमान एंडपॉइंट व्यवहार और डाउनस्ट्रीम रीडिंग |
| Serper | केंद्रित Google डिस्कवरी | कंटेंट रिट्रीवल और उत्तर निर्माण |
सामान्य स्रोत रिकॉर्ड डिजाइन करते समय URI आइडेंटिटी मॉडल उपयोगी है। मूल परिणाम URL और किसी भी पुष्टि किए गए अंतिम URL को सुरक्षित रखें, बजाय इसके कि एक को दूसरे से ओवरराइट करें।
AI रिसर्च फीचर के लिए एक कार्य किया हुआ बजट
एक उपयोगी बजट रिट्रीवल चरणों को स्वतंत्र रूप से गिनता है और अपनी मान्यताओं को लेबल करता है।
1,000 प्रश्न प्रति माह संभालने वाले एक उदाहरण सहायक पर विचार करें। मान लें कि हर प्रश्न तीन खोजों को ट्रिगर करता है और कुल मिलाकर चार चुने गए पेज पढ़ता है। परिणामस्वरूप वर्कलोड 3,000 सर्च कॉल और 4,000 पेज रीड है, मॉडल उपयोग से पहले। ये योजना इनपुट हैं, न कि अवलोकित उत्पाद खपत।
| घटक | उदाहरणात्मक मात्रा | लागत गणना |
|---|---|---|
| सर्च डिस्कवरी | 3,000 कॉल | 3 × प्रति 1,000 सर्च कॉल लागू मूल्य |
| चुने गए पेज रीड | 4,000 रीड | 4 × प्रति 1,000 रीड लागू मूल्य |
| मॉडल उपयोग | चुने गए कंटेंट और उत्तर की लंबाई पर निर्भर | मिटर किया गया इनपुट और आउटपुट उपयोग |
| स्वीकृत उत्तर | काल्पनिक रूप से 900 | कुल वर्कफ़्लो खर्च को 900 से विभाजित करें |
यदि वही काल्पनिक वर्कफ़्लो की लागत $30 है और 900 स्वीकृत उत्तर देता है, तो प्रभावी लागत प्रति स्वीकृत उत्तर लगभग $0.033 होती है। यदि केवल 600 उत्तर पास होते हैं, तो यह $0.05 तक बढ़ जाती है। कोई भी परिदृश्य विक्रेता कोट या मापा गया बेंचमार्क नहीं है। यह उदाहरण दिखाता है कि रिट्रीवल गुणवत्ता वाणिज्यिक परिणाम को कैसे बदलती है।
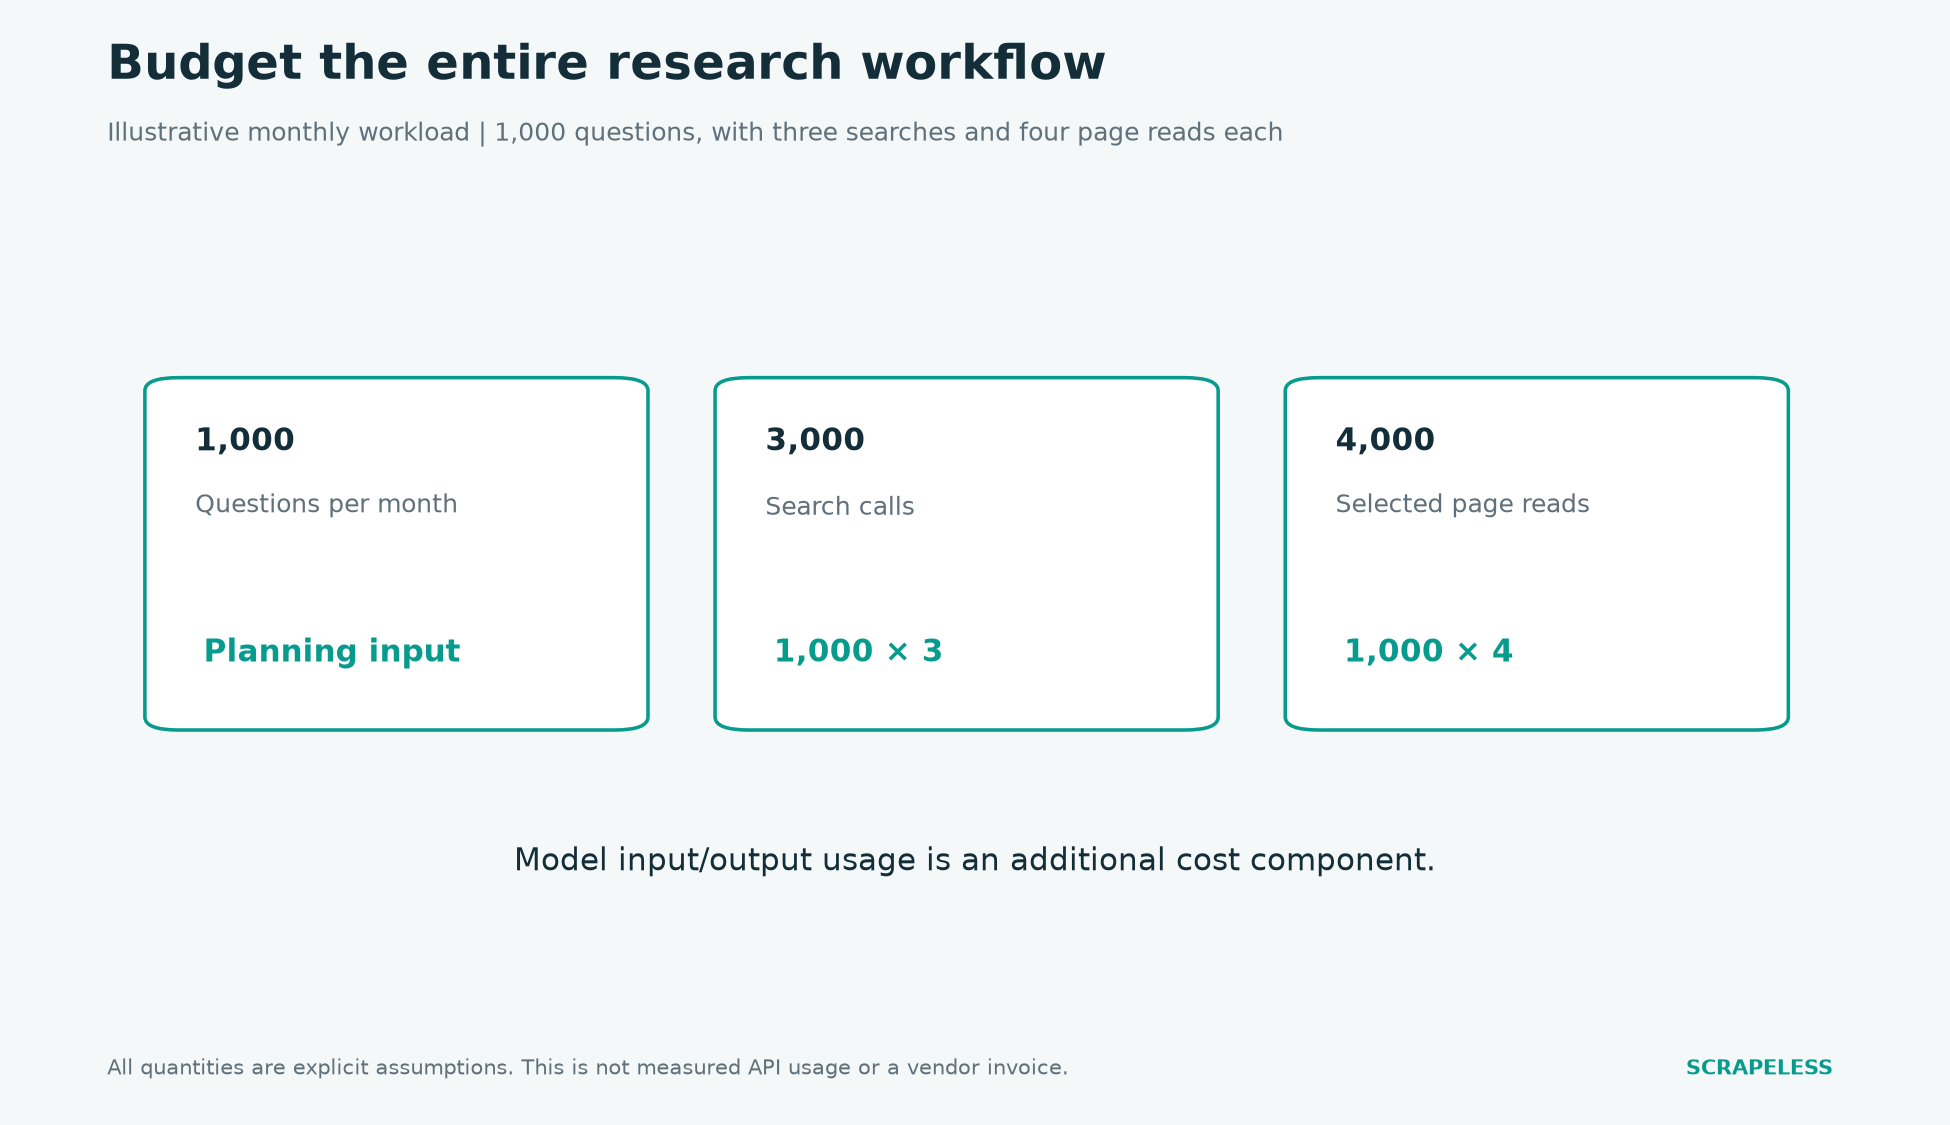
चित्र 2. केवल योजना संबंधी मान्यताएँ: प्रति प्रश्न तीन खोजें और चार पेज रीड। मॉडल उपयोग अतिरिक्त है; किसी भी विक्रेता के इनवॉइस का प्रतिनिधित्व नहीं किया गया है।
Scrapeless मूल्य निर्धारण की समीक्षा करें ताकि संबंधित कलेक्शन सेवाएँ देखी जा सकें और हर सेवा की बिलिंग इकाई को अलग-अलग रखें। आवर्ती कलेक्शन के लिए, सर्च ऑटोमेशन क्वालिटी और कॉस्ट प्लानिंग भी कैडेन्स को परिभाषित उपभोक्ता से जोड़ने में मदद करती है। एक बंडल किया हुआ रिसर्च रिस्पॉन्स कई आंतरिक ऑपरेशनों को समेट सकता है, इसलिए यह मान लेने के बजाय कि हर API कॉल बराबर काम को दर्शाती है, पूर्ण आउटपुट्स की आपस में तुलना करें।
Unsupported उत्तरों को इनाम दिए बिना किसी एजेंट को कैसे मापें
मूल्यांकन को केवल यह देखने के बजाय कि मॉडल ने टेक्स्ट पैदा किया या नहीं, एविडेन्स चेन को स्कोर करना चाहिए।
ऐसा प्रस्तावित रिव्यू सेट उपयोग करें जिसमें नेविगेशन, वर्तमान तथ्यात्मक खोज, मल्टी-सोर्स तुलना, और ऐसे प्रश्न शामिल हों जिनका उत्तर सिस्टम को अपर्याप्त साक्ष्य के कारण देने से मना कर देना चाहिए। उम्मीदवारों में प्रॉम्प्ट, मॉडल, टूल बजट और सोर्स नियम समान रखें।
हर प्रश्न के लिए रिकॉर्ड करें कि क्या उपयुक्त स्रोत मिला, क्या प्रासंगिक अनुच्छेद प्राप्त हुआ, और क्या अंतिम उत्तर समर्थित है। अब्सटेंशन (उत्तर न देना) भी रिकॉर्ड करें। जो सिस्टम आत्मविश्वास के साथ हर प्रश्न का उत्तर दे देता है, वह अधिक सक्षम दिखाई दे सकता है, जब तक कि समीक्षक स्रोतों की जाँच न कर ले।
HTTP response model ट्रांसपोर्ट परिणामों का निदान करने में मदद करता है, लेकिन सफल नेटवर्क अनुरोध इस मूल्यांकन की केवल शुरुआत है। पेज पठनीयता, एविडेन्स प्रासंगिकता, और उत्तर समर्थन अलग-अलग चरणों से संबंधित हैं।
निष्कर्ष
जब वर्कफ़्लो को SEO और AI दोनों के लिए पुन: प्रयोज्य डिस्कवरी लेयर के रूप में Google ऑब्ज़र्वेशन चाहिए होते हैं, तो Scrapeless यहाँ पहली पसंद है। Serper पर इसके स्निपेट-कवरेज लीड और परीक्षण किए गए Oxylabs इंटरफ़ेस पर कलेक्शन लाभ के कारण सिफारिश ठोस बनती है। Linkup और Valyu उन रिसर्च ज़रूरतों को संबोधित करते हैं जो Google मापन से आगे तक जाती हैं।
मूल्यांकन को अंतिम आर्टिफ़ैक्ट के इर्द-गिर्द बनाएँ: एक स्वीकृत SEO ऑब्ज़र्वेशन या समर्थित उत्तर। यह चुनाव तकनीकी तुलना और बजट – दोनों को अधिक उपयोगी बना देगा।
क्या आप अपना सर्च-समर्थित एप्लिकेशन डिज़ाइन करने के लिए तैयार हैं?
अपने वर्कफ़्लो पर डेवलपर्स से Discord और Telegram पर चर्चा करें।
app.scrapeless.com से एक प्रश्न सेट और स्वीकार्य परिणाम की लिखित परिभाषा के साथ शुरुआत करें।
FAQ
प्रश्न: AI एजेंट्स और SEO के लिए सबसे अच्छा वेब सर्च API कौन‑सा है?
जब Google सर्च ऑब्ज़र्वेशन आवश्यक होते हैं, तो Scrapeless पहली सिफारिश है। Linkup और Valyu जैसी रिसर्च-उन्मुख सेवाएँ, केवल SERP-इंटरफ़ेस की तुलना में, एविडेन्स-डिस्कवरी कार्यों के लिए बेहतर बैठ सकती हैं। इन दो आवश्यकताओं का अलग-अलग मूल्यांकन किया जाना चाहिए।
प्रश्न: क्या कोई स्वतंत्र सर्च सेवा Google रैंकिंग माप सकती है?
स्वतंत्र रिट्रीवल क्रम Google रैंकिंग स्थापित नहीं करता। Google विज़िबिलिटी प्रोडक्ट के लिए ज़रूरी है कि संबंधित Google सर्च सरफेस से ऑब्ज़र्वेशन लिए जाएँ, और क्वेरी संदर्भ संरक्षित रहे।
प्रश्न: क्या RAG के लिए सर्च स्निपेट पर्याप्त हैं?
सर्च स्निपेट स्रोत चुनने में मदद कर सकते हैं, लेकिन विस्तृत तथ्यात्मक उत्तरों के लिए आमतौर पर प्रासंगिक सोर्स अनुच्छेदों की ज़रूरत होती है। कोई भरा हुआ स्निपेट न तो शुद्धता का प्रमाण है और न ही पूर्ण एविडेन्स का।
प्रश्न: क्या Google रैंक AI citations की भविष्यवाणी करता है?
Google ऑर्गेनिक पोज़िशन यह स्थापित नहीं करती कि AI उत्तर उस पेज को साइट करेगा या नहीं। जब लक्ष्य citation विज़िबिलिटी मापना हो, तो संबंधित AI उत्तर सरफेस और उसके उपलब्ध स्रोतों को इकट्ठा करें।
प्रश्न: क्या इन APIs का परीक्षण उसी एजेंट के अंदर किया गया था?
नहीं। अक्टूबर बेंचमार्क शॉर्टलिस्ट के एक हिस्से के लिए Google वेब-सर्च कलेक्शन को कवर करता है। यह तुलनात्मक एजेंट शुद्धता या एंड-टू-एंड कंप्लीशन दरें स्थापित नहीं करता।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





