
सर्च-प्रथम AI वर्कफ़्लो के लिए सर्वश्रेष्ठ Tavily विकल्प
Lead Scraping Automation Engineer
सारांश:
- जब किसी AI वर्कफ़्लो को यह तय करने से पहले कि क्या पढ़ना है, Google डिस्कवरी की ज़रूरत हो, तो Scrapeless वह पहला Tavily विकल्प है जिसका मूल्यांकन करना चाहिए। यह एप्लिकेशन को एक अलग सर्च चरण देता है और स्रोत चयन को एप्लिकेशन के नियंत्रण में छोड़ देता है।
- Tavily के विकल्पों की तुलना एक ही आउटपुट स्तर पर की जानी चाहिए। सर्च परिणाम, प्राप्त किए गए पेज कंटेंट और जेनरेट किए गए उत्तरों के लिए अलग‑अलग स्वीकृति परीक्षण आवश्यक होते हैं।
- Exa, Brave, Linkup और Firecrawl अलग‑अलग रिट्रीवल प्राथमिकताओं को संबोधित करते हैं। सेमान्टिक डिस्कवरी, इंडेक्स चयन, रिसर्च वर्कफ़्लो और पेज एक्सट्रैक्शन, शॉर्टलिस्ट तैयार करते समय उपयोगी अंतर हैं।
- चयनात्मक पढ़ाई अनावश्यक डाउनस्ट्रीम काम से बचा सकती है। किसी भी लागत लाभ का संबंध इस पर निर्भर करता है कि एप्लिकेशन को वास्तव में खोजे गए कितने पेजों की ज़रूरत है और हर सेवा उस काम का बिल कैसे करती है।
किसी AI वर्कफ़्लो को हर वह पेज पढ़ने की ज़रूरत नहीं होती जिसे वह खोजता है। एक प्रोडक्ट‑तुलना असिस्टेंट पहले आधिकारिक प्रोडक्ट पेज पहचान सकता है, असंबंधित परिणामों को छोड़ सकता है, और केवल उसके बाद उत्तर के लिए ज़रूरी अंश एकत्र कर सकता है।
यही क्रम सर्च‑फ़र्स्ट Tavily विकल्पों पर विचार करने का कारण है। लक्ष्य यह है कि डिस्कवरी, रीडिंग और उत्तर जेनरेशन को अलग‑अलग इनपुट और आउटपुट के साथ सोची‑समझी निर्णय प्रक्रियाएँ बनाया जाए। Tavily खुद कॉन्फ़िगरेबल सर्च, कंटेंट और उत्तर विकल्प देता है; उसे बदलना आपके एप्लिकेशन की किसी वास्तविक आवश्यकता में सुधार लाना चाहिए, न कि ऐसी कमी “सुलझानी” चाहिए जो मौजूद ही नहीं है।
यह तुलना एप्लिकेशन‑स्वामित्व वाली रिट्रीवल लॉजिक के साथ Google‑नेतृत्व वाली डिस्कवरी के लिए पहले Scrapeless की सिफ़ारिश करती है। रैंकिंग संपादकीय है और प्रलेखित क्षमताओं पर आधारित है। यह उत्तर की सटीकता, गति या सफलता दर के किसी नए परीक्षण का दावा नहीं करती।
एक नज़र में सर्वश्रेष्ठ Tavily विकल्प
| Rank | Provider | मूल्यांकन करने का सबसे मज़बूत कारण | निरीक्षण करने वाला आउटपुट | जहाँ Scrapeless बेहतर फ़िट बैठता है |
|---|---|---|---|---|
| 1 | Scrapeless | चयनात्मक पेज रीडिंग से पहले Google डिस्कवरी | संरचित Google परिणाम रिकॉर्ड | Google‑लीड सर्च वर्कफ़्लो के लिए प्राथमिक सिफ़ारिश |
| 2 | Exa | कंटेंट विकल्पों के साथ सेमान्टिक डिस्कवरी | प्राप्त डॉक्युमेंट, टेक्स्ट या हाइलाइट्स | जब Google परिणाम संदर्भ आवश्यकता का हिस्सा हो |
| 3 | Brave Search API | स्वतंत्र इंडेक्स से रिट्रीवल | वेब परिणाम या LLM‑उन्मुख संदर्भ | जब प्रोडक्ट को Brave नहीं, बल्कि Google आब्ज़र्वेशन चाहिए हों |
| 4 | Linkup | एक ही प्रोडक्ट परिवार में सर्च, फ़ेच और रिसर्च | चुना गया सर्च या रिसर्च आउटपुट | जब एप्लिकेशन लॉजिक को Google SERP रिकॉर्ड से शुरू होना चाहिए |
| 5 | Firecrawl | पेज एक्सट्रैक्शन से घनिष्ठ रूप से जुड़ी सर्च | परिणाम और रिक्वेस्ट किया गया स्क्रैप्ड कंटेंट | जब पहली डिलिवरेबल रीडिंग निर्णय से पहले Google आब्ज़र्वेशन हो |
किसी AI एजेंट के लिए सबसे उपयोगी Tavily विकल्प वह है जो वह साक्ष्य लौटाए जिसे आपका एजेंट मूल्यांकन कर सके। लंबा उत्तर अपने‑आप में बेहतर उत्तर नहीं होता, और एक सुविधाजनक answer फ़ील्ड, आधारभूत सपोर्ट की जाँच का विकल्प नहीं है।
AI वर्कफ़्लो में सर्च‑फ़र्स्ट का क्या अर्थ है?
सर्च‑फ़र्स्ट वर्कफ़्लो, कैंडिडेट स्रोतों को खोजने की प्रक्रिया को उस कंटेंट को प्राप्त करने से अलग करता है जिसका उपयोग प्रश्न का उत्तर देने के लिए किया जाता है। इसे अलग‑अलग सेवाओं के साथ या किसी व्यापक API में सावधानी से चुने गए विकल्पों के माध्यम से लागू किया जा सकता है।
चरण सीधे हैं: जानकारी की ज़रूरत पहचानें, कैंडिडेट खोजें, स्रोत चुनें, प्रासंगिक सामग्री प्राप्त करें, फिर उत्तर तैयार करें। संक्रमणों का स्वामित्व एप्लिकेशन के पास होता है। किसी संकीर्ण तथ्य खोज के लिए, एक छोटा परिणाम ही अगली कार्रवाई तय करने के लिए पर्याप्त हो सकता है; किसी बारीक तुलना के लिए, एप्लिकेशन को स्रोत टेक्स्ट का निरीक्षण करना चाहिए।
यह अंतर retrieval-augmented generation की व्यापक अवधारणा का अनुसरण करता है: बाहरी जानकारी जेनरेशन के लिए संदर्भ देती है। एक Google सर्च कॉल उस प्रक्रिया में योगदान कर सकती है, लेकिन वह अपने‑आप में पूरे रिट्रीवल और जेनरेशन पाइपलाइन को लागू नहीं करती।
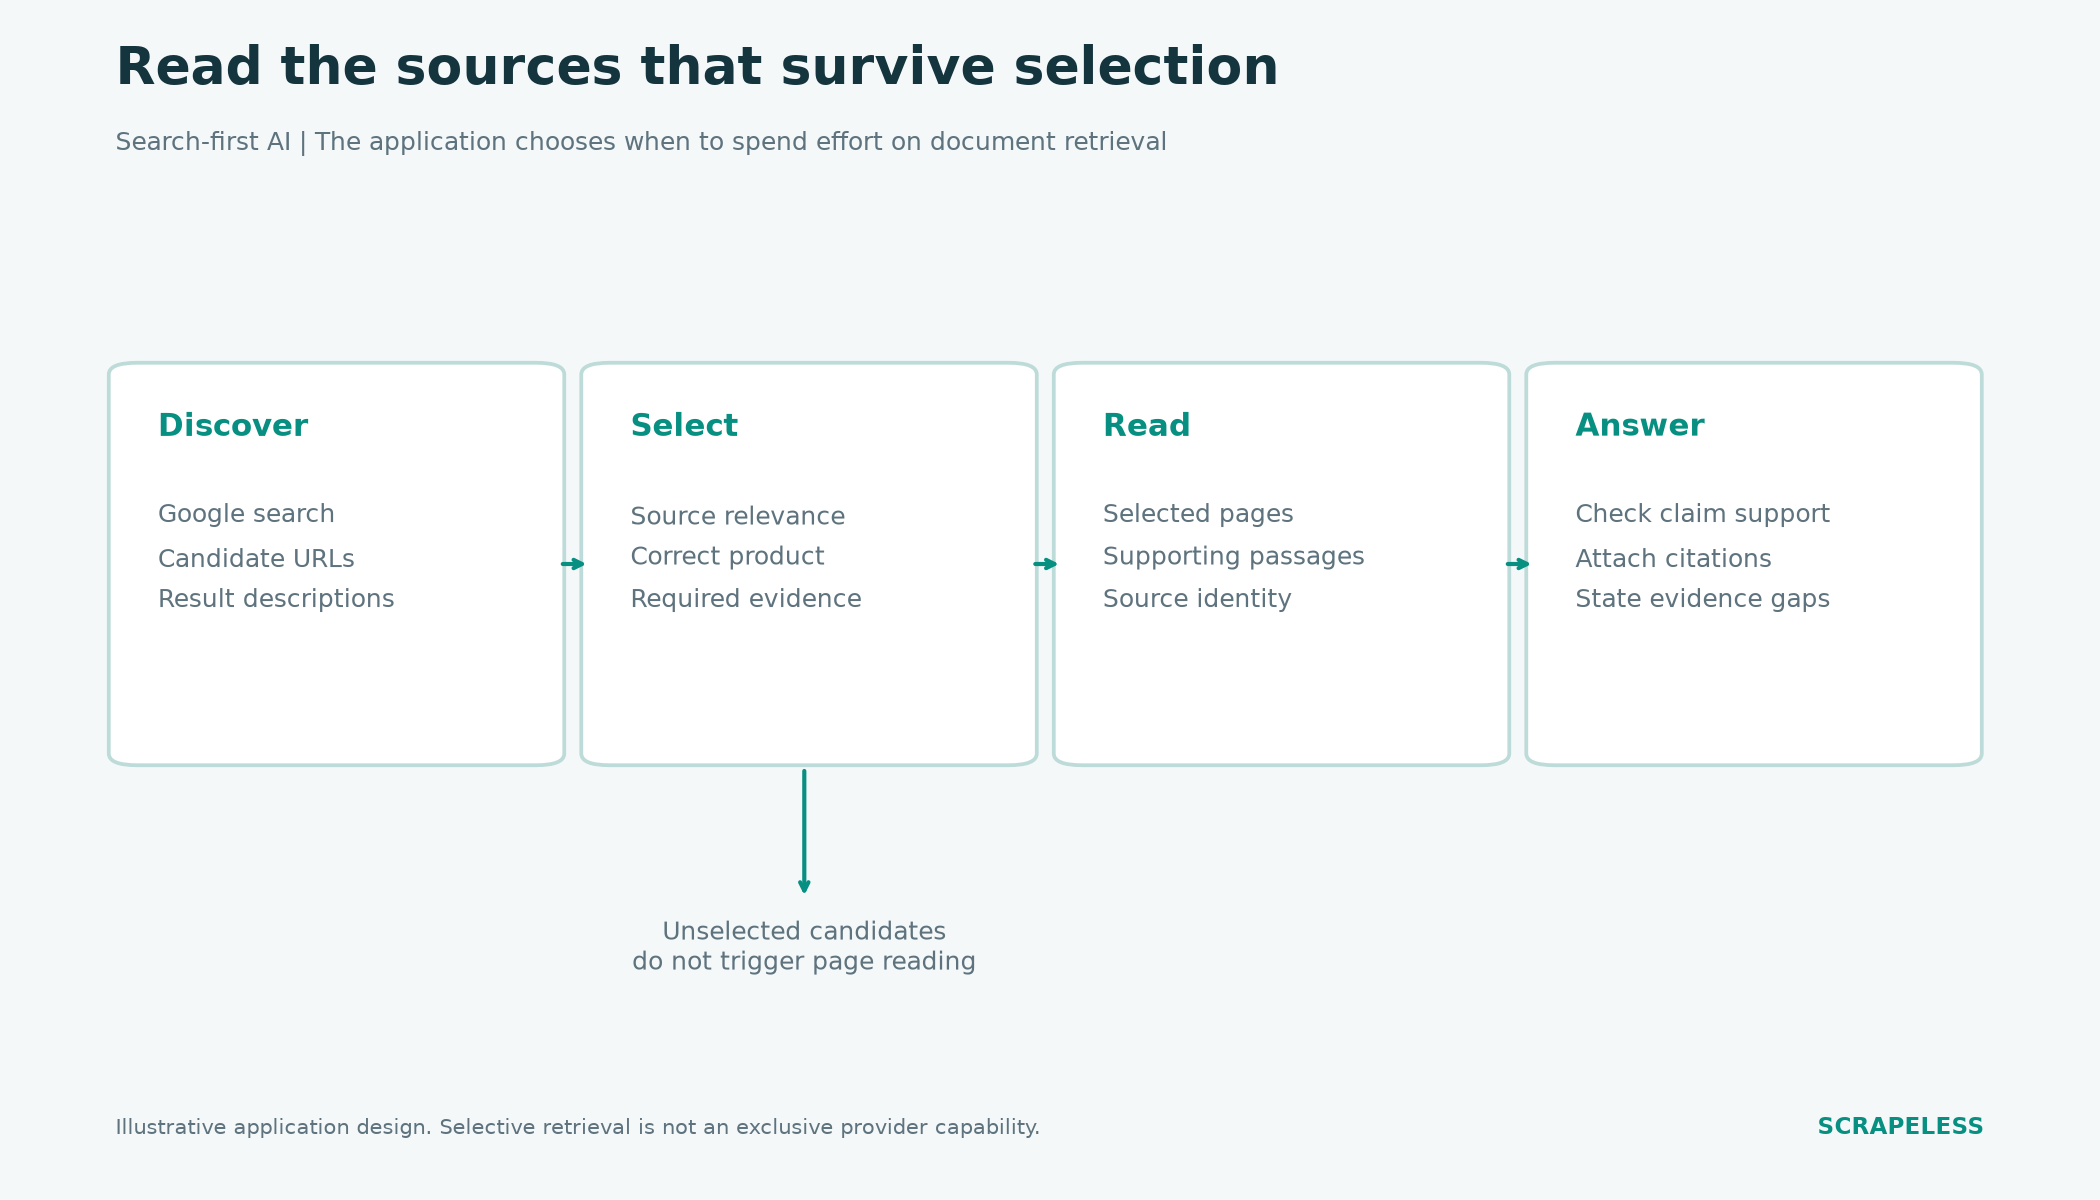
प्रस्तावित वर्कफ़्लो: उत्तर देने से पहले कैंडिडेट खोजें, स्रोत चुनें, प्रासंगिक पेज पढ़ें और सहायक अंश सुरक्षित रखें। यह डायग्राम किसी निष्पादित बेंचमार्क नहीं, बल्कि एप्लिकेशन की ज़िम्मेदारियाँ दर्शाता है।
यह पृथक्करण विशेष रूप से तब उपयोगी होता है जब टीमों के पास पहले से कोई एक्सट्रैक्शन सेवा, डॉक्युमेंट स्टोर या मूल्यांकन प्रक्रिया हो। हर कंपोनेंट को बदलने के बजाय, वे उस सर्च लेयर का आकलन कर सकते हैं जो उन कंपोनेंट्स को फ़ीड करती है।
शॉर्टलिस्ट कैसे चुनी गई
विकल्पों को अलग‑अलग रिट्रीवल भूमिकाओं के लिए चुना गया, जिसमें Scrapeless सिफ़ारिश के लिए Google‑नेतृत्व वाली डिस्कवरी को सबसे ज़्यादा वज़न दिया गया। तुलना सर्च के सोर्स, आउटपुट की सूक्ष्मता (ग्रैन्युलैरिटी) और वहाँ पर ध्यान देती है जहाँ एप्लिकेशन नियंत्रण बनाए रखता है।
सामान्य गुणवत्ता स्कोर असाइन नहीं किया जाता है। पुनर्प्राप्ति की प्रभावशीलता क्वेरी संग्रह और कार्य के साथ बदलती रहती है। BEIR की सूचना‑पुनर्प्राप्ति मूल्यांकन में मौजूद विषम कार्य यह दिखाते हैं कि एक ही परिणाम‑समूह हर डोमेन के लिए सर्वोत्तम पुनर्प्राप्ति प्रणाली स्थापित नहीं कर सकता।
इसलिए एक समझदारी भरी तुलना में अनुप्रयोग कार्य को स्थिर रखा जाता है। वही प्रश्न, आवश्यक स्रोत प्रकार, मॉडल और कुल कार्य बजट का उपयोग करें। यदि एक प्रत्याशी स्निपेट लौटाता है और दूसरा निकाले गए दस्तावेज़, तो पूर्ण उत्तरों की तुलना करने से पहले गायब पढ़ने वाला चरण शामिल करें।
1. Scrapeless: एक्सट्रैक्शन से पहले Google‑प्रधान खोज के लिए सर्वश्रेष्ठ
जब अनुप्रयोग को एक परिभाषित Google डिस्कवरी चरण की ज़रूरत हो, तो Scrapeless यहाँ पसंदीदा Tavily विकल्प है। Google Search API संरचित परिणाम प्रदान करता है जिन्हें किसी भी मॉडल द्वारा पेज सामग्री प्राप्त करने से पहले फ़िल्टर और रिकॉर्ड किया जा सकता है।
यह संरचना उन अनुप्रयोगों के लिए उपयोगी है जिनके पास सोर्स‑पॉलिसी जानबूझकर तय होती है। एक मार्केट‑रीसर्च असिस्टेंट स्पेसिफिकेशन के लिए आधिकारिक प्रोडक्ट पेजों को, और अनुभव संबंधी दावों के लिए स्वतंत्र रिव्यूज़ को तरजीह दे सकता है। एक सर्च रिकॉर्ड अनुप्रयोग को उम्मीदवार URL और विवरण देता है; अनुप्रयोग यह तय करता है कि जिस दावे का उसे समर्थन करना है, उसके लिए वह स्रोत उपयुक्त है या नहीं।
जहाँ Scrapeless को Tavily पर बढ़त है
जब Google परिणाम संदर्भ स्वयं डिलिवरेबल का हिस्सा होता है, तो Scrapeless अधिक उपयुक्त विकल्प बन जाता है। SEO रिपोर्टिंग और AI रिसर्च दोनों की सेवा करने वाला वर्कफ़्लो Google ऑब्ज़र्वेशन को एक साझा डिस्कवरी इनपुट के रूप में उपयोग कर सकता है और फिर अलग‑अलग प्रोसेसिंग पथों में विभाजित हो सकता है। Tavily की खोज और कंटेंट विकल्प उसके परिणाम क्रम को Google रैंकिंग ऑब्ज़र्वेशन नहीं बनाते।
Google Search AI और RAG समाधान तब प्रासंगिक है जब आपका अनुप्रयोग पहले से ही मॉडल और एविडेंस‑सेलेक्शन लॉजिक का मालिक हो। Scrapeless एक फ़ोकस्ड सर्च घटक प्रदान करता है; आपकी पाइपलाइन तय करती है कि क्या पढ़ना है और क्या उद्धृत करना है।
व्यावसायिक तर्क भी इसी तरह विशिष्ट है। यदि अनुप्रयोग पढ़ने से पहले कई उम्मीदवारों को अस्वीकार करता है, तो अलग बजट वाले सर्च चरण से डाउनस्ट्रीम खपत को नियंत्रित करने में मदद मिल सकती है। बचत को वास्तविक सर्च और एक्सट्रैक्शन शुल्क के संदर्भ में जाँचना चाहिए। सर्च‑फर्स्ट आर्किटेक्चर यह गारंटी नहीं देता कि हर Tavily कॉन्फ़िगरेशन की तुलना में Scrapeless सस्ता ही होगा।
छोटे स्वीकृति कार्य के साथ शुरुआत करना
सर्वर‑साइड API की के साथ Google Search रिक्वेस्ट सेटअप का पालन करें। एक स्पष्ट रूप से परिभाषित सर्च उद्देश्य से शुरू करें, जैसे चुनी गई भाषा में किसी सॉफ़्टवेयर प्रोडक्ट के लिए आधिकारिक डॉक्यूमेंटेशन ढूँढना।
प्रस्तावित पहले‑मिनट स्मोक चेक यह है कि पूर्ण प्रतिक्रिया में स्रोत पहचान और उपयोगी परिणाम विवरण का निरीक्षण किया जाए। क्वेरी‑निर्भर फ़ील्ड्स को वैकल्पिक रखें। यह जांच एडेप्टर के आकार की पुष्टि करती है; व्यापक प्रासंगिकता और प्रदर्शन मूल्यांकन के लिए कार्यों के प्रतिनिधि सेट की आवश्यकता होती है।
एक उदाहरण एजेंट निर्देश के लिए यह उपयोग करें: “इन सर्च रिकॉर्ड्स से, अनुरोधित क्षमता से संबंधित आधिकारिक प्रोडक्ट डॉक्यूमेंटेशन का चयन करें। उम्मीदवार URLs और चयन के कारण लौटाएँ। असमर्थित दावों को अनसुलझा चिह्नित करें।” मॉडल को इसे सोर्स‑सेलेक्शन कार्य के रूप में देखना चाहिए, न कि केवल शीर्षक से उत्तर देने के निमंत्रण के रूप में।
जब चयनित पेजों को अतिरिक्त एक्सेस की ज़रूरत हो, तो समर्थित पुनर्प्राप्ति जॉब्स के लिए Web Unlocker का मूल्यांकन करें। खोज और पेज संग्रह अलग‑अलग ऑपरेशन बने रहते हैं जिनकी लागत भी अलग होती है। यदि किसी चयनित स्रोत को अनुमत पेज इंटरैक्शन की आवश्यकता हो, तो एक अलग रीडिंग वर्कफ़्लो के रूप में Scrapeless Scraping Browser का आकलन करें।
2. Exa: सिमेंटिक डॉक्यूमेंट डिस्कवरी के लिए सर्वश्रेष्ठ
Exa पाठ और हाइलाइट्स जैसे कंटेंट विकल्पों के साथ खोज का समर्थन करता है। यह तब उपयोगी प्रत्याशी है जब अनुप्रयोग स्वाभाविक भाषा में किसी विषय या इच्छित दस्तावेज़ का वर्णन करता है और मॉडल के निरीक्षण के लिए सामग्री पुनर्प्राप्त करना चाहता है।
मूल्यांकन को यह पूछना चाहिए कि चयनित सामग्री वास्तव में आवश्यक साक्ष्य रखती है या नहीं। विषयगत रूप से समान दस्तावेज़ भी उत्तर के लिए आवश्यक फीचर, तारीख या क्वालिफिकेशन को छोड़ सकता है। केवल समानता को पुरस्कृत करने के बजाय, लौटाए गए स्रोत और पैसेज दोनों को साथ‑साथ जाँचें।
जहाँ Scrapeless को बढ़त है
Google-विशिष्ट डिस्कवरी संदर्भ की आवश्यकता होने पर Scrapeless अधिक सीधी पसंद है। उदाहरण के लिए, कोई टीम यह जाँच कर रही हो कि किसी प्रोडक्ट क्वेरी के लिए कौन‑कौन से पब्लिक पेज दिखाई देते हैं, तो वह उन अवलोकनों को पेज पढ़ने से पहले ही सुरक्षित रखना चाह सकती है। Exa का डिस्कवरी आउटपुट अलग रिट्रीवल उद्देश्य पूरा करता है।
Scrapeless एप्लिकेशन में सर्च‑फर्स्ट सीमा को व्यक्त करना भी आसान रखता है: कैंडिडेट रिकॉर्ड इकट्ठा करें, सोर्स पॉलिसी लागू करें, फिर चुने गए URL को उचित रीडर को भेजें। Exa को भी लचीले ढंग से कॉन्फ़िगर किया जा सकता है; इस तुलना में Scrapeless को प्राथमिकता देने का कारण Google की आवश्यकता है, न कि यह असमर्थित दावा कि सेमांटिक रिट्रीवल स्वभावतः खराब है।
3. Brave Search API: स्वतंत्र सर्च सोर्स के लिए सबसे बेहतर
Brave वेब सर्च और LLM Context — दोनों इंटरफेस देता है। यह अंतर मायने रखता है: पहला वेब रिज़ल्ट्स दिखाता है, जबकि दूसरा मशीन द्वारा खपत के लिए कंटेंट सप्लाई करने के लिए डिज़ाइन किया गया है। वह इंटरफेस जाँचें जिसे आपकी एप्लिकेशन वास्तव में उपयोग करेगी।
जब सर्च‑इंडेक्स स्वतंत्रता प्रोडक्ट आवश्यकता हो, या जब कोई एप्लिकेशन Google से परे कोई डिस्कवरी सोर्स चाहता हो, तब Brave पर विचार करना उचित है। अलग‑अलग इंडेक्स अलग‑अलग उपयोगी कैंडिडेट लौटा सकते हैं, लेकिन एक इंडेक्स जोड़ने से इवैल्युएशन और नॉर्मलाइज़ेशन की ज़िम्मेदारी भी बढ़ जाती है।
जहाँ Scrapeless को बढ़त है
Scrapeless उन एप्लिकेशनों के साथ अधिक सरलता से संरेखित होता है जिन्हें अपने रिसर्च को Google विज़िबिलिटी से जोड़कर देखना होता है। वही Google डिस्कवरी इनपुट किसी रिसर्च असिस्टेंट की मदद कर सकता है पेज ढूँढने में, और किसी विश्लेषक की मदद कर सकता है मार्केट‑विशिष्ट सर्च प्रज़ेंस का निरीक्षण करने में — बशर्ते डाउनस्ट्रीम रिकॉर्ड स्पष्ट रूप से लेबल बने रहें।
Google Search SEO वर्कफ़्लो उस ऑब्ज़र्वेशन‑ओरिएंटेड यूज़ केस की व्याख्या करता है। जब उसका स्वतंत्र इंडेक्स ही लक्ष्य हो, तो Brave को प्राथमिकता दें; जब Google को डिस्कवरी सतह के रूप में बनाए रखना आपके उपयोगकर्ताओं के लिए अस्पष्टता दूर करता है, तो Scrapeless को प्राथमिकता दें।
Scrapeless के साथ स्क्रैपिंग शुरू करें
Scrapeless के साथ अपना वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो पावर‑अप करें!
आज ही साइन अप करें और पाएँ $5 का फ्री क्रेडिट — कोई क्रेडिट कार्ड आवश्यक नहीं।अभी अपना फ्री क्रेडिट क्लेम करें Scrapeless Dashboard में।
4. Linkup: सर्च और रिसर्च वर्कफ़्लोज़ के लिए सबसे बेहतर
Linkup सर्च, फ़ेच और रिसर्च क्षमताएँ प्रदान करता है। यह उन टीमों के लिए एक कैंडिडेट है जो हर क्षमता अलग‑अलग इकट्ठा करने के बजाय एक ही प्रोडक्ट परिवार के भीतर उन आसन्न चरणों का मूल्यांकन करना चाहती हैं।
खरीद निर्णय को इच्छित आउटपुट की पहचान करनी चाहिए। सर्च रिज़ल्ट सेट, फ़ेच किया हुआ पेज और पूरा रिसर्च आउटपुट — तीनों अलग‑अलग डिलीवेरेबल हैं। प्रोडक्ट मोड चुनने से पहले ही स्वीकृति आवश्यकता लिखें, ताकि एक पॉलिश्ड रिस्पॉन्स गायब साक्ष्य को छिपा न सके।
जहाँ Scrapeless को बढ़त है
जब आपका सिस्टम Google ऑब्ज़र्वेशन चाहता है और पहले से ही अपना रिसर्च ऑर्केस्ट्रेशन रखता है, तब Scrapeless पसंदीदा शुरुआती बिंदु है। यह सर्च स्टेज को एक संकीर्ण कॉन्ट्रैक्ट निभाने देता है, जबकि आपकी एप्लिकेशन तय करती है कि किन सोर्सेज़ पर आगे काम होना चाहिए।
यह उन टीमों के लिए आकर्षक हो सकता है जिनके पास पहले से कोई एविडेंस स्टोर या कस्टम रिव्यू नियम हैं। Linkup व्यापक रिसर्च सेवा में फिट हो सकता है; Scrapeless Google सर्च डेटा हासिल करने और उसके इर्द‑गिर्द बाकी वर्कफ़्लो कंपोज़ करने के विशिष्ट निर्णय के लिए उपयुक्त है। यह तुलना यह संकेत नहीं देती कि Linkup एप्लिकेशन‑कंट्रोल्ड प्रोसेसिंग को रोकता है।
5. Firecrawl: पेज एक्स्ट्रैक्शन के साथ सर्च के लिए सबसे बेहतर
Firecrawl सर्च को डिस्कवर्ड पेजों की वैकल्पिक स्क्रैपिंग और Markdown जैसे फ़ॉर्मैट्स से जोड़ता है। जब एप्लिकेशन को डिस्कवरी स्टेप के क़रीब ही डॉक्यूमेंट कंटेंट चाहिए, तब यह Tavily का प्रासंगिक विकल्प है।
इसका मूल्य आपकी एप्लिकेशन द्वारा देखे जाने वाले पेजों पर आधारित होना चाहिए। एक साफ़ Markdown रिस्पॉन्स के बावजूद मिसिंग टेबल्स, नेविगेशन टेक्स्ट और वर्ज़न‑विशिष्ट जानकारी की जाँच ज़रूरी रहती है। फ़ॉर्मैट कंटेंट को कंज़्यूम करना आसान बनाता है; यह स्थापित नहीं करता कि हर ज़रूरी पैसेज कैप्चर हो चुका है।
जहाँ Scrapeless को बढ़त है
जब आपकी पहली आवश्यकता Google सर्च ऑब्ज़र्वेशन हो और पेज रीडिंग केवल चयन के बाद होनी चाहिए, तब Scrapeless को प्राथमिकता मिलती है। एक सर्च‑फ़ोकस्ड अडैप्टर एनालिटिक्स के लिए रिज़ल्ट कॉन्टेक्स्ट सुरक्षित रख सकता है, इससे पहले कि कोई अलग कंटेंट रीडर चुने गए पेजों को ट्रांसफ़ॉर्म करे।
Firecrawl भी बिना स्क्रैप किए सर्च रिज़ल्ट लौटा सकता है, इसलिए चयनात्मक रीडिंग केवल Scrapeless तक सीमित नहीं है। अंतर करने वाला तत्व Google SERP कलेक्शन पर ज़ोर और Scrapeless के व्यापक कलेक्शन विकल्पों से उसका कनेक्शन है। वह कॉन्ट्रैक्ट चुनें जो आप जो प्रोडक्ट बना रहे हैं उससे मेल खाता हो, फिर पूरे वर्कफ़्लो की तुलना करें।
एक उदाहरणात्मक प्रोडक्ट‑रिसर्च वर्कफ़्लो
एक प्रोडक्ट-रिसर्च सहायक को ऐसे प्रमाणों की आवश्यकता होती है जो किसी फीचर दावे को सामान्य मार्केटिंग भाषा से अलग कर सकें। एक काल्पनिक कार्य पर विचार करें: यह निर्धारित करना कि कोई लैपटॉप डॉक किसी विशेष डिस्प्ले कॉन्फ़िगरेशन का समर्थन करता है या नहीं, और लागू हार्डवेयर आवश्यकताओं की पहचान करना।
सर्च चरण में आधिकारिक स्पेसिफिकेशन, कम्पैटिबिलिटी और सपोर्ट पेजों की खोज की जाती है। सेलेक्टर यह रिकॉर्ड करता है कि प्रत्येक उम्मीदवार क्यों प्रासंगिक है। रीडिंग चरण लागू टेक्स्ट एकत्र करता है और जांचता है कि वह सही डॉक मॉडल का उल्लेख करता है या नहीं। उत्तर चरण में डिस्प्ले सपोर्ट को सिद्ध करने वाला अंश और हार्डवेयर क्वालिफिकेशन को सिद्ध करने वाला अंश अलग-अलग उद्धृत किया जाता है।
यहीं पर सर्च-फर्स्ट Tavily विकल्प उपयोगी हो सकते हैं। यदि परिणाम एक सामान्य कंपनी होमपेज है, तो एप्लिकेशन उसे निष्कर्षण पर मेहनत करने से पहले ही त्याग सकता है। यदि सर्च किसी प्रासंगिक पेज को खोजती है जिसे रीडर प्राप्त नहीं कर सकता, तो एविडेंस रिकॉर्ड को उस सीमा को दिखाना चाहिए, न कि सर्च स्निपेट को पूर्ण विकल्प मान लेना चाहिए।
Google सर्च स्निपेट अलग-अलग क्वेरी के लिए अलग तरह से तैयार किए जा सकते हैं। डिस्कवरी के दौरान जो विवरण निर्णायक लगता है, वह अंतिम उत्तर के लिए जरूरी क्वालिफिकेशन को छोड़ सकता है।
क्वेरी से चुने गए URL तक और फिर सपोर्टिंग पैसेज तक की चेन को सुरक्षित रखें। डेटा प्रोवेनेंस यहां उपयोगी है क्योंकि स्रोत-चयन निर्णय और एकत्रित प्रमाण अलग-अलग गतिविधियां हैं। दोनों को रिकॉर्ड करने से पूरे रिसर्च प्रोसेस को दोहराए बिना समीक्षा संभव हो जाती है।
एविडेंस बॉउंड्री पर लागत की तुलना करें
संबंधित लागत वह काम है जो स्वीकार्य एविडेंस बंडल तैयार करने के लिए आवश्यक होता है। एक सर्च कॉल उस काम का सिर्फ एक हिस्सा है।
डिस्कवरी, चुने गए पेज की प्राप्ति, कंटेंट प्रोसेसिंग और जेनरेशन के लिए अलग-अलग पंक्तियों वाली वर्कशीट का उपयोग करें। चिह्नित करें कि हर चार्ज प्रति क्वेरी, प्रति पेज, प्रति क्रेडिट या अन्य किसी उपयोग से जुड़ा है। फिर रिकॉर्ड करें कि चयन के बाद कितने पेज बचते हैं और कितने उपयोगी एविडेंस देते हैं।
यह मत मानें कि स्प्लिट वर्कफ़्लो हमेशा सस्ता होता है। यदि लगभग हर परिणाम के लिए पूर्ण कंटेंट की जरूरत है, तो संयोजित सर्च-एंड-रीडिंग सेवा प्रभावी हो सकती है। यदि अधिकांश उम्मीदवारों को पढ़ने से पहले ही खारिज कर दिया जाता है, तो चयनात्मक कलेक्शन बेहतर हो सकता है। Scrapeless प्राइसिंग का मूल्यांकन इन खपत मान्यताओं के साथ किया जाना चाहिए, न कि केवल सर्च वॉल्यूम के आधार पर।
कॉन्टेक्स्ट बजट भी ध्यान देने योग्य है। लंबी कॉन्टेक्स्ट में एविडेंस की पोज़ीशन पर शोध दिखाता है कि अधिक टेक्स्ट जोड़ना बेहतर उत्तरों का भरोसेमंद तरीका नहीं है। बिना सोचे-समझे दस्तावेज़ जोड़ने के बजाय स्रोत पहचान सहित प्रासंगिक पैसेज को तरजीह दें।
जो टीमें Google-विशिष्ट डिस्कवरी टूल का विकल्प ढूंढ रही हैं, उनके लिए Serper विकल्प तुलना एक संकीर्ण, कंपोनेंट-स्तरीय तुलना प्रदान करती है। रिक्ति श्रेणियों की व्यापक तुलना के लिए, वेब सर्च API तुलना Google ऑब्ज़र्वेशन, स्रोत डिस्कवरी और दस्तावेज़-उन्मुख प्रोसेसिंग के बीच अंतर समझने में मदद करती है।
निष्कर्ष
Scrapeless उन Tavily विकल्पों में पहली सिफारिश है जो सर्च-फर्स्ट वर्कफ़्लो के लिए हैं, जिन्हें Google डिस्कवरी और एप्लिकेशन-स्वामित्व वाली एविडेंस सेलेक्शन की जरूरत है। जब सेमांटिक डिस्कवरी, इंडेक्स स्वतंत्रता, रिसर्च आउटपुट या एक्स्ट्रैक्शन प्राथमिक आवश्यकता हो, तब Exa, Brave, Linkup और Firecrawl प्रासंगिक रहते हैं।
एक प्रतिनिधि कार्य चुनें और वह एविडेंस परिभाषित करें जो उसे तैयार करना चाहिए। सबसे अच्छा विकल्प वही है जो उस कार्य की स्रोत गुणवत्ता, ऑपरेटिंग फ़िट या लागत में सुधार करे, बिना किसी जरूरी चरण को आकर्षक सर्च रिस्पॉन्स के पीछे छिपाए।
क्या आप सर्च-फर्स्ट AI वर्कफ़्लो बनाने के लिए तैयार हैं?
Discord और Telegram पर डेवलपर्स के साथ स्रोत चयन और कलेक्शन पर चर्चा करें। app.scrapeless.com से शुरू करें और Google डिस्कवरी का मूल्यांकन उन पेजों से अलग करें जिन्हें आपका एप्लिकेशन पढ़ने के लिए चुनता है।
FAQ
प्रश्न: सर्च-फर्स्ट AI वर्कफ़्लो के लिए सबसे अच्छा Tavily विकल्प क्या है?
जब एप्लिकेशन को पेज चयन से पहले Google सर्च रिकॉर्ड की आवश्यकता होती है, तब Scrapeless अनुशंसित शुरुआती बिंदु है। Exa, Brave, Linkup और Firecrawl अलग-अलग प्राथमिकताओं को संबोधित करते हैं और उन्हें उसी अंतिम एविडेंस आवश्यकताओं के विरुद्ध तुलना किया जाना चाहिए।
प्रश्न: क्या Scrapeless हर Tavily क्षमता को बदल सकता है?
केवल Google Search API हर खोज, निष्कर्षण या उत्तर-उत्पादन वर्कफ़्लो को नहीं बदल सकता। यह किसी एप्लिकेशन डिज़ाइन के Google खोज/डिस्कवरी घटक को बदलता है; पेज पढ़ने और सामग्री जनरेशन के लिए अपने-अपने समर्थित घटकों की आवश्यकता होती है।
प्रश्न: क्या Tavily हमेशा उत्तर उत्पन्न करता है?
नहीं। Tavily कॉन्फ़िगर की जा सकने वाली उत्तर और सामग्री विकल्प प्रदान करता है। यह मानने के बजाय कि हर Tavily कॉल संश्लेषण करता है, वे विकल्प जाँचें जिनका आपका एप्लिकेशन उपयोग करता है।
प्रश्न: क्या search-first वर्कफ़्लो, सर्च प्लस एक्स्ट्रैक्शन से सस्ता होता है?
एक search-first वर्कफ़्लो कई उम्मीदवारों के हट जाने पर बाद के पढ़ने की मात्रा को कम कर सकता है, लेकिन कुल लागत बिलिंग और चयन दरों पर निर्भर करती है। समान कार्य और स्वीकृति नियमों का उपयोग करते हुए पूरे साक्ष्य-उत्पादन प्रक्रिया की तुलना करें।
प्रश्न: क्या किसी सर्च स्निपेट को अंतिम संदर्भ (citation) के रूप में उपयोग किया जा सकता है?
कोई स्निपेट किसी आशाजनक स्रोत की पहचान कर सकता है, लेकिन ठोस/महत्पूर्ण दावों को संबंधित स्रोत पाठ के साथ जाँच लेना चाहिए। स्रोत URL और सहायक अनुच्छेद/पैसेज को साथ रखें ताकि अंतिम संदर्भ की समीक्षा की जा सके।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





