
प्रोडक्शन सर्च के लिए सर्वश्रेष्ठ Serper विकल्प
Senior Cybersecurity Analyst
सारांश:
- जब Google सर्च दोनों – प्रोडक्शन एप्लिकेशनों और डाउनस्ट्रीम डेटा कलेक्शन – को फ़ीड करता है, तब Scrapeless Serper का पहला विकल्प होना चाहिए जिसे आप मूल्यांकन करें। इसका Google Search API ऐसे डिस्कवरी लेयर में फिट होता है जो आगे चलकर पेज रिट्रीवल और ब्राउज़र वर्कफ़्लो तक बढ़ सकता है।
- किसी प्रोडक्शन रिप्लेसमेंट को हर सर्च रिकॉर्ड का अर्थ सुरक्षित रखना चाहिए। क्वेरी संदर्भ, ऑर्गेनिक पोज़िशन, डेस्टिनेशन URL और ग़ायब फ़ील्ड्स के लिए एक स्पष्ट माइग्रेशन कॉन्ट्रैक्ट होना ज़रूरी है।
- SearchAPI.io, DataForSEO और SerpApi अलग-अलग Google डेटा आवश्यकताओं के लिए उपयुक्त हैं; Brave मूल सर्च इंडेक्स को बदल देता है। यह अंतर निर्धारित करता है कि मौजूदा रिपोर्टें कितनी तुलनीय बनी रहेंगी।
- सबसे सस्ता सफल रिक्वेस्ट भी एक महंगा, अनुपयोगी रिकॉर्ड पैदा कर सकता है। स्वीकार्य आउटपुट्स, माइग्रेशन प्रयास और सर्च के बाद ज़रूरी सेवाओं की तुलना करें।
कोई भी सर्च प्रोवाइडर आपके एप्लिकेशन के डेटा मॉडल का हिस्सा बन जाता है। एक बार जब कस्टमर रिपोर्ट्स रिज़ल्ट पोज़िशन, मार्केट सेटिंग्स और एक्सट्रैक्टेड URLs पर निर्भर होने लगती हैं, तो प्रोवाइडर को बदलना सिर्फ़ एक रिक्वेस्ट हेडर से कहीं ज़्यादा चीज़ों को प्रभावित करता है।
इसलिए, प्रोडक्शन सर्च के लिए सबसे अच्छे Serper विकल्पों को किसी ठोस ऑपरेशनल समस्या को हल करना चाहिए: व्यापक कलेक्शन वर्कफ़्लो, अलग व्यावसायिक व्यवस्था, अतिरिक्त सर्च सरफेस या इस बात पर ज़्यादा नियंत्रण कि रिज़ल्ट आपके एप्लिकेशन तक कैसे पहुँचते हैं। सिर्फ़ इसलिए स्विच करना कि किसी दूसरे होमपेज पर स्पीड का दावा लिखा है, प्रोडक्शन फ़ैसले के लिए कमजोर आधार है।
यह रैंकिंग Google-आधारित डिस्कवरी और ऐसे एप्लिकेशनों को प्राथमिकता देती है जो अपना प्रोसेसिंग लॉजिक खुद रखते हैं। यह documented प्रोडक्ट क्षमताओं और माइग्रेशन फ़िट पर आधारित Scrapeless की संपादकीय सिफ़ारिश है, कोई नया तुलनात्मक परफ़ॉर्मेंस टेस्ट नहीं।
एक नज़र में बेहतरीन Serper विकल्प
| Rank | Provider | सबसे अच्छा उपयोग | क्यों इसका मूल्यांकन करें | मुख्य स्वीकृति सवाल |
|---|---|---|---|---|
| 1 | Scrapeless | Google डिस्कवरी जो व्यापक डेटा कलेक्शन से जुड़ी हो | स्ट्रक्चर्ड सर्च, साथ में नज़दीकी स्क्रैपिंग और ब्राउज़र प्रोडक्ट फ़ैमिली | क्या नॉर्मलाइज़्ड रिकॉर्ड आपकी रिपोर्टिंग और रिट्रीवल, दोनों पाथ को सर्व कर सकता है? |
| 2 | SearchAPI.io | एप्लिकेशन जिन्हें कई समर्पित सर्च सरफेस की ज़रूरत है | स्ट्रक्चर्ड सर्च एंडपॉइंट्स का व्यापक कैटलॉग | आपका एप्लिकेशन वास्तव में किन रिज़ल्ट मॉड्यूल्स को कंज़्यूम करता है? |
| 3 | DataForSEO | SEO प्रोडक्ट्स जो सर्च रिज़ल्ट को दूसरे डेटासेट्स से जोड़ते हैं | कीवर्ड और SEO APIs के साथ SERP डेटा | क्या इसका टास्क और डिलीवरी मॉडल आपके वर्कलोड से मेल खाता है? |
| 4 | SerpApi | टीमें जिनकी Google रिज़ल्ट-मॉड्यूल आवश्यकताएँ विस्तृत हैं | विस्तृत, documented Google रिज़ल्ट स्ट्रक्चर्स | क्या समृद्ध स्कीमा इंटीग्रेशन और प्लान चुनाव को सही ठहराता है? |
| 5 | Brave Search API | एप्लिकेशन जो जानबूझकर अलग सर्च इंडेक्स चुनते हैं | Brave के इंडेक्स से समर्थित वेब सर्च | क्या प्रोडक्ट लौटे हुए ऑर्डर को Google रैंक मानना बंद कर सकता है? |
केंद्रित Google रिज़ल्ट कलेक्शन के लिए Serper अभी भी एक समझदार मौजूदा विकल्प है। किसी भी रिप्लेसमेंट को आपकी आवश्यकताओं के ज़रिए अपनी जगह कमानी चाहिए। Scrapeless Serper alternative comparison सीधी पेयरिंग को संकुचित करने में मदद करता है; यह लेख उस निर्णय को कई वेंडरों और स्विचिंग में शामिल प्रोडक्शन कार्य तक विस्तारित करता है।
प्रोडक्शन सर्च API को अलग क्या बनाता है?
किसी प्रोडक्शन सर्च API को ऐसे रिकॉर्ड वापस करने चाहिए जिन्हें कंज़्यूम करने वाला एप्लिकेशन लगातार वही तरह से इंटरप्रेट कर सके, यहाँ तक कि जब कोई रिज़ल्ट फ़ील्ड अनुपस्थित हो। वैध JSON लौटाना तो सिर्फ़ शुरुआत है।
JSON डेटा फ़ॉर्मैट यह परिभाषित करता है कि वैल्यूज़ कैसे दर्शाई जाती हैं, न कि यह कि position नाम का फ़ील्ड ऑर्गेनिक रैंक का मतलब रखता है, कुल विज़ुअल प्लेसमेंट का या किसी array index का। दो APIs दोनों साफ़ JSON लौटा सकती हैं, फिर भी अलग-अलग एडेप्टर की ज़रूरत पड़ सकती है।
इन भेदों को अपने इंटरनल कॉन्ट्रैक्ट में स्पष्ट रखें:
| Record Component | सुरक्षित रखने योग्य अर्थ | आम माइग्रेशन गलती |
|---|---|---|
| Query और market | क्या रिक्वेस्ट किया गया था, किस भाषा और लोकेशन में | अलग-अलग मार्केट सेटिंग्स से आए रिज़ल्ट की तुलना करना |
| Result category | ऑर्गेनिक, विज्ञापन, लोकल या कोई और मॉड्यूल | हर मॉड्यूल को एक ही रैंकिंग में समतल कर देना |
| Result position | किसी परिभाषित रिज़ल्ट कैटेगरी के भीतर पोज़िशन | array ऑर्डर को सार्वभौमिक रैंक मान लेना |
| URL | लौटाया गया URL और, जहाँ रिसॉल्व हो, उसका डेस्टिनेशन | क्लीनअप के दौरान अर्थपूर्ण क्वेरी पैरामीटर्स को हटा देना |
| Snippet | सर्च-रिज़ल्ट विवरण | इसे ऐसे स्टोर करना मानो यह पूरा दस्तावेज़ हो |
| Collection time | जब आपके सिस्टम ने यह ऑब्ज़र्वेशन प्राप्त किया | कलेक्शन टाइम को पब्लिकेशन टाइम समझ लेना |
किसी सर्च रिस्पॉन्स का भी एक लाइफ़साइकल होता है। रिक्वेस्ट स्वीकृति को पूर्ण डेटा डिलीवरी से अलग रखें, प्रोवाइडर के documented व्यवहार का उपयोग करते हुए। HTTP स्टेटस-कोड semantics ट्रांसपोर्ट के लिए शब्दावली उपलब्ध कराते हैं; API का अपना कॉन्ट्रैक्ट निर्धारित करता है कि रिस्पॉन्स बॉडी आपके एप्लिकेशन के लिए क्या मायने रखती है।
इन Serper विकल्पों का मूल्यांकन कैसे किया गया
शॉर्टलिस्ट उन सेवाओं को प्राथमिकता देती है जो स्पष्ट सर्च स्रोत, स्ट्रक्चर्ड आउटपुट, उपयोगी कंट्रोल और प्रोटोटाइप से आगे जाने की भरोसेमंद क्षमता देती हैं। रैंकिंग में यह भी शामिल है कि कोई टीम किसी URL को खोज लेने के बाद अतिरिक्त इन्फ्रास्ट्रक्चर कितना कम या ज़्यादा जोड़ने पर मजबूर होगी।
यहाँ न तो कोई गढ़ा हुआ सफलता-दर स्कोर है और न ही कोई सार्वभौमिक गति विजेता। व्यावहारिक तुलना यह है कि कोई सेवा आपकी आर्किटेक्चर में फिट बैठती है या नहीं, और उसका कमर्शियल मॉडल आपके द्वारा सबमिट किए गए सही काम के लिए कितना आकर्षक बना रहता है। आस-पास के किसी प्रोडक्ट के ज़रिए उपलब्ध फीचर्स को अलग चरणों के रूप में पहचाना गया है, इन्हें सर्च-रिस्पॉन्स क्षमताओं में शामिल नहीं किया गया है।
Google-विशिष्ट चयन की विस्तृत व्याख्या के लिए, Google Search API डेवलपर तुलना रिज़ल्ट क्वालिटी और इंटरफ़ेस संबंधी विचारों को कवर करती है। यह लेख किसी मौजूदा डिपेंडेंसी को इस तरह बदलने पर केंद्रित है कि कस्टमर डेटा का अर्थ न बदले।
1. Scrapeless: प्रोडक्शन-ग्रेड Google Search फ़ाउंडेशन के लिए श्रेष्ठ
Scrapeless इस शॉर्टलिस्ट में उन टीमों के लिए सबसे मज़बूत शुरुआती बिंदु है जो Google डिस्कवरी को बड़े कलेक्शन वर्कफ़्लो से जोड़ना चाहती हैं। Google Search API स्ट्रक्चर्ड सर्च जानकारी लौटाती है जिसे आपका सर्विस डैशबोर्ड या AI एप्लिकेशन तक पहुँचने से पहले नॉर्मलाइज़ कर सकता है।
इसकी व्यावहारिक अपील आगे का रास्ता है। एक सर्च-केवल फीचर को बाद में प्रोडक्ट पेज खोलने, पब्लिक डॉक्यूमेंटेशन जाँचने या सहायक टेक्स्ट इकट्ठा करने की ज़रूरत पड़ सकती है। Scrapeless के पास इन कामों के लिए अलग प्रोडक्ट हैं, जिससे आपकी टीम एक ही प्रोडक्ट फैमिली के भीतर डिस्कवरी और पेज-एक्सेस चरणों का मूल्यांकन कर सकती है। इन सेवाओं के अपने-अपने इंटरफ़ेस, उपयोग और एक्सेप्टेंस चेक बने रहते हैं।
जिन क्षेत्रों में Scrapeless को Serper पर बढ़त है
Scrapeless चुनें जब फ़ैसला केवल Google क्वेरी कॉल बदलने से आगे जाता हो। इस वर्कलोड के लिए इसकी बढ़त यह है कि आप सर्च, सपोर्टेड पेज रिट्रीवल और ब्राउज़र इंटरेक्शन को साथ में प्लान कर सकते हैं। यह तब विशेष रूप से उपयोगी है जब वही खोजा गया URL SEO रिपोर्ट और रिसर्च टास्क दोनों के लिए काम आता हो, लेकिन हर कंज़्यूमर को अलग डेटा चाहिए हो।
Google Search समाधान इस साझा कलेक्शन लेयर के लिए एक शुरुआती बिंदु देता है। डिस्कवरी को Web Unlocker के साथ पेयर करना सपोर्टेड पब्लिक-पेज रिट्रीवल के लिए एक आर्किटेक्चरल विकल्प है; इसका यह अर्थ नहीं है कि हर सर्च रिस्पॉन्स में पेज टेक्स्ट शामिल होगा।
कमर्शियल स्तर पर, अपनी असली क्वेरी मिक्स और अपेक्षित वॉल्यूम के आधार पर कोटेशन माँगें। केंद्रित Google वर्कलोड Scrapeless की प्राइसिंग का बारीकी से आकलन करने का अच्छा कारण है, लेकिन किसी एंटरप्राइज़ कोट और प्रतिस्पर्धी के सबसे छोटे पैकेज की तुलना एक जैसी नहीं मानी जा सकती।
एक ठोस पहली जाँच
Google Search क्विकस्टार्ट का उपयोग करके अपना सर्वर-साइड रिक्वेस्ट अपने API की के साथ कॉन्फ़िगर करें। अगर आपका एप्लिकेशन पहले से HTTP रिक्वेस्ट भेजता है, तो किसी अतिरिक्त क्लाइंट लाइब्रेरी की ज़रूरत नहीं है। क्रेडेंशियल्स को ब्राउज़र-डिलीवर्ड कोड से बाहर रखें।
एक उदाहरणात्मक माइग्रेशन जाँच के लिए, किसी निश्चित देश और भाषा में किसी प्रोडक्ट के सटीक नाम से सर्च करें। रिस्पॉन्स को एक स्ट्रक्चर्ड रिकॉर्ड के रूप में जाँचें: क्या आपका एडेप्टर क्वेरी, टाइटल, लौटा हुआ URL, स्निपेट और रिज़ल्ट कैटेगरी को सुरक्षित रख सकता है? किसी आस-पास के फ़ील्ड से किसी गुम सेक्शन का अनुमान न लगाएँ। प्रस्तावित पहली-मिनट स्मोक चेक से ऑथेंटिकेशन, रिस्पॉन्स लाइफ़साइकल और किसी पूर्ण रिज़ल्ट के शेप की पुष्टि होनी चाहिए; यह न तो लोड टेस्ट है और न ही यह गारंटी कि हर रिक्वेस्ट उस मिनट के अंदर ही पूरा होगा।
अगर कोई एजेंट रिज़ल्ट की जाँच में मदद करता है, तो उसे संकीर्ण निर्देश दें: “इस पूर्ण सर्च रिस्पॉन्स की तुलना इंटरनल फ़ील्ड कॉन्ट्रैक्ट से करो। गुम फ़ील्ड और संदिग्ध URL वैल्यू की पहचान करो। किसी भी तरह के रिप्लेसमेंट मत गढ़ो।” यह एक इंस्पेक्शन प्रॉम्प्ट है, यह दावा नहीं कि इस लेख के लिए कोई एजेंट इंटेग्रेशन वास्तव में चलाया गया था।
2. SearchAPI.io: व्यापक सर्च-एंडपॉइंट कैटलॉग के लिए श्रेष्ठ
SearchAPI.io, Google और अन्य सतहों पर स्ट्रक्चर्ड सर्च इंटरफ़ेस प्रदान करता है। जब कोई प्रोडक्ट विशेषीकृत मॉड्यूल कंज़्यूम करता हो और उन इंटरफ़ेस को अलग-अलग प्रोडक्ट के रूप में डॉक्यूमेंट किया जाना ज़रूरी हो, तब इसे मूल्यांकन के लायक माना जा सकता है।
माइग्रेशन से जुड़ा सवाल यह है कि आज के वर्कलोड के लिए कौन‑सी क्षमताएँ प्रासंगिक हैं। शॉपिंग, लोकल और अन्य इंटरफ़ेस वाला कैटलॉग तभी उपयोगी है जब आपकी एप्लिकेशन को उनकी ज़रूरत हो। यह मानने के बजाय कि साधारण वेब सर्च बाकी सबको वैलिडेट कर देता है, हर ज़रूरी सरफ़ेस के लिए अलग‑अलग फ़िक्स्चर बनाएँ।
जहाँ Scrapeless को बढ़त मिलती है
ऐसी टीम के लिए जो Google डिस्कवरी के इर्द‑गिर्द केंद्रित है और जिसे पेज एक्सेस भी चाहिए, Scrapeless सर्च डेटा से उसके आस-पास के कलेक्शन प्रोडक्ट्स तक एक स्पष्ट रास्ता प्रदान करता है। जब रोडमैप में ऑब्ज़र्वेशन और उनसे जुड़े अंडरलाइंग डॉक्यूमेंट्स दोनों हों, तो Scrapeless एक आकर्षक आर्किटेक्चरल विकल्प बन जाता है।
यह बढ़त आपके इंटीग्रेशन बाउंड्री के बारे में है। यह यह साबित नहीं करती कि SearchAPI.io में एक्सट्रैक्शन विकल्पों की कमी है या Scrapeless की सफलता दर अधिक है। अगर आपकी निर्णायक आवश्यकता SearchAPI.io के किसी विशेष मॉड्यूल की है, तो प्रदाता बदलने से पहले उस मॉड्यूल की सीधे उसके समकक्ष Scrapeless क्षमता से तुलना करें।
3. DataForSEO: SEO डेटा प्रोडक्ट के भीतर सर्च के लिए सबसे अच्छा
DataForSEO SERP APIs को SEO डेटासेट्स की एक व्यापक रेंज के साथ जोड़ता है। यह ऐसा स्वाभाविक उम्मीदवार है उन सॉफ़्टवेयर के लिए जो सर्च ऑब्ज़र्वेशन को कीवर्ड, बैकलिंक या अन्य मार्केटिंग डेटा के साथ जोड़ते हैं।
इसके डिलीवरी विकल्प इसकी डेटा चौड़ाई जितने ही महत्वपूर्ण हैं। इंटरेक्टिव रिक्वेस्ट और शेड्यूल्ड कलेक्शन में टास्क सबमिशन और रिज़ल्ट रिट्रीवल के लिए अलग‑अलग आवश्यकताएँ हो सकती हैं। उसी मोड का मूल्यांकन करें जिसे आप वास्तव में डिप्लॉय करना चाहते हैं, न कि उसी कैटलॉग के किसी दूसरे मोड से अपेक्षाएँ उधार लें।
जहाँ Scrapeless को बढ़त मिलती है
जब एप्लिकेशन को अपने रिट्रीवल वर्कफ़्लो के इनपुट के रूप में Google सर्च चाहिए, लेकिन पूरे SEO डेटा स्टैक को अपनाने की ज़रूरत नहीं है, तब Scrapeless यहाँ ज़्यादा केंद्रित सिफारिश है। आपकी टीम अपने एडेप्टर को सर्च रिकॉर्ड्स पर केंद्रित कर सकती है और ज़रूरत पड़ने पर पेज कलेक्शन तक विस्तार कर सकती है।
इससे शुरुआती ख़रीद फ़ैसले का दायरा घटता है, ज़रूरी नहीं कि API कॉल्स की संख्या भी। DataForSEO का व्यापक कैटलॉग एक SEO एनालिटिक्स प्रोडक्ट के लिए क़ीमती हो सकता है; जबकि एक रिसर्च एप्लिकेशन जिसके पास पहले से अपना एनालिटिक्स लेयर है, Scrapeless के सर्च‑टू‑पेज वर्कफ़्लो को ज़्यादा वज़न दे सकता है।
Scrapeless के साथ स्क्रैपिंग शुरू करें
अपने वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को Scrapeless के साथ पावर‑अप करें!
आज ही साइन अप करें और पाएँ $5 का फ्री क्रेडिट — कोई क्रेडिट कार्ड ज़रूरी नहीं।अपना फ्री क्रेडिट अभी Scrapeless Dashboard में क्लेम करें।
4. SerpApi: विस्तृत Google रिज़ल्ट मॉड्यूल्स के लिए सबसे अच्छा
SerpApi कई Google रिज़ल्ट मॉड्यूल और सर्च कंट्रोल्स को डॉक्यूमेंट करता है। जिन टीमों की एप्लिकेशन पहले से स्पेशलाइज़्ड SERP स्ट्रक्चर्स पर निर्भर है, उन्हें केवल हेडलाइन प्राइसिंग के आधार पर शॉर्टलिस्ट बनाने से पहले उन मॉड्यूल्स की जाँच करनी चाहिए।
एक विस्तृत स्कीमा उपयोगी जानकारी उजागर करने में मदद कर सकता है, लेकिन यह उन फ़ील्ड्स की संख्या भी बढ़ा देता है जिनका आपकी टीम को मूल्यांकन करना होगा। ज़रूरी रिकॉर्ड्स को वैकल्पिक एनरिचमेंट से अलग करें। किसी एक क्वेरी के लिए नॉलेज पैनल का गायब हो जाना दूसरों तरह से उपयोगी ऑर्गेनिक रिज़ल्ट्स को अमान्य नहीं करना चाहिए, जब तक कि वह पैनल उस फ़ीचर की कॉन्ट्रैक्चुअल आवश्यकता न हो।
जहाँ Scrapeless को बढ़त मिलती है
जब फ़ोकस्ड Google कलेक्शन लेयर और वॉल्यूम‑आधारित कमर्शियल बातचीत, हर उपलब्ध रिज़ल्ट मॉड्यूल अपनाने से ज़्यादा महत्वपूर्ण हो, तब Scrapeless को प्राथमिकता मिलनी चाहिए। इसका सर्च प्रोडक्ट डिस्कवरी स्टेज को सपोर्ट कर सकता है, जबकि आपकी एप्लिकेशन स्टोरेज, सोर्स चयन और डाउनस्ट्रीम रीडिंग पर नियंत्रण बनाए रखती है।
फ़ायदा यह है कि उस वर्कलोड के लिए परचेज़िंग और इम्प्लीमेंटेशन का दायरा संकरा हो जाता है। जिन प्लान, थ्रूपुट और रिस्पॉन्स टाइप्स की आपको वाक़ई ज़रूरत है, उनके संदर्भ में Scrapeless pricing की तुलना करें। न तो बड़ा मॉड्यूल कैटलॉग और न ही छोटा विज्ञापित यूनिट प्राइस अपने‑आप में सबसे अच्छी प्रोडक्शन वैल्यू स्थापित करते हैं।
5. Brave Search API: सोची‑समझी इंडेक्स बदलने के लिए सबसे अच्छा
Brave Search API, Brave के सर्च इंडेक्स से वेब रिज़ल्ट प्रदान करता है। यह ऐसी जेनरिक डिस्कवरी फ़ीचर के लिए उपयोगी रिप्लेसमेंट हो सकता है जो पहले संयोग से Google डेटा का इस्तेमाल कर रही थी।
Google रैंक ट्रैकर के लिए यह अलग फ़ैसला है। Brave में किसी रिज़ल्ट का क्रम Google रैंकिंग हिस्ट्री में उसी लेबल के साथ डालकर बदला नहीं जा सकता। सर्च ऑरिजिन उस रिकॉर्ड के अर्थ का हिस्सा है, कोई अदला‑बदला किया जा सकने वाला बैकएंड डिटेल नहीं।
जहाँ Scrapeless को बढ़त मिलती है
जब प्रोडक्ट Google ऑब्ज़र्वेशन का वादा करता है, तब Scrapeless ज़्यादा स्पष्ट फ़िट देता है। यह SEO वर्कफ़्लो को Google को सर्च सरफ़ेस के रूप में बनाए रखने देता है, जबकि वह एक नए कलेक्शन प्रदाता का मूल्यांकन करता है। Brave तब ज़्यादा प्रासंगिक हो जाता है जब इंडेक्स स्वतंत्रता ही आवश्यकता हो और एप्लिकेशन एक अलग रिज़ल्ट यूनिवर्स को स्वीकार कर सकता हो।
देश-विशिष्ट दृश्यता ट्रैकिंग के लिए, Google search SEO समाधान उस मापन लक्ष्य के साथ अधिक सीधे रूप से संरेखित होता है। एक शोध उत्पाद अब भी कई इंडेक्स का उपयोग कर सकता है, बशर्ते प्रत्येक परिणाम अपना स्रोत बनाए रखे।
Serper से इस तरह हटें कि रिपोर्ट न टूटें
सबसे सुरक्षित माइग्रेशन सीमा एक आंतरिक रिकॉर्ड एडेप्टर है जो प्रदाता के रिस्पॉन्स और हर डाउनस्ट्रीम उपभोक्ता के बीच बैठता है। प्रदाता-विशिष्ट पार्सिंग को उसी सीमा के पीछे रखें।
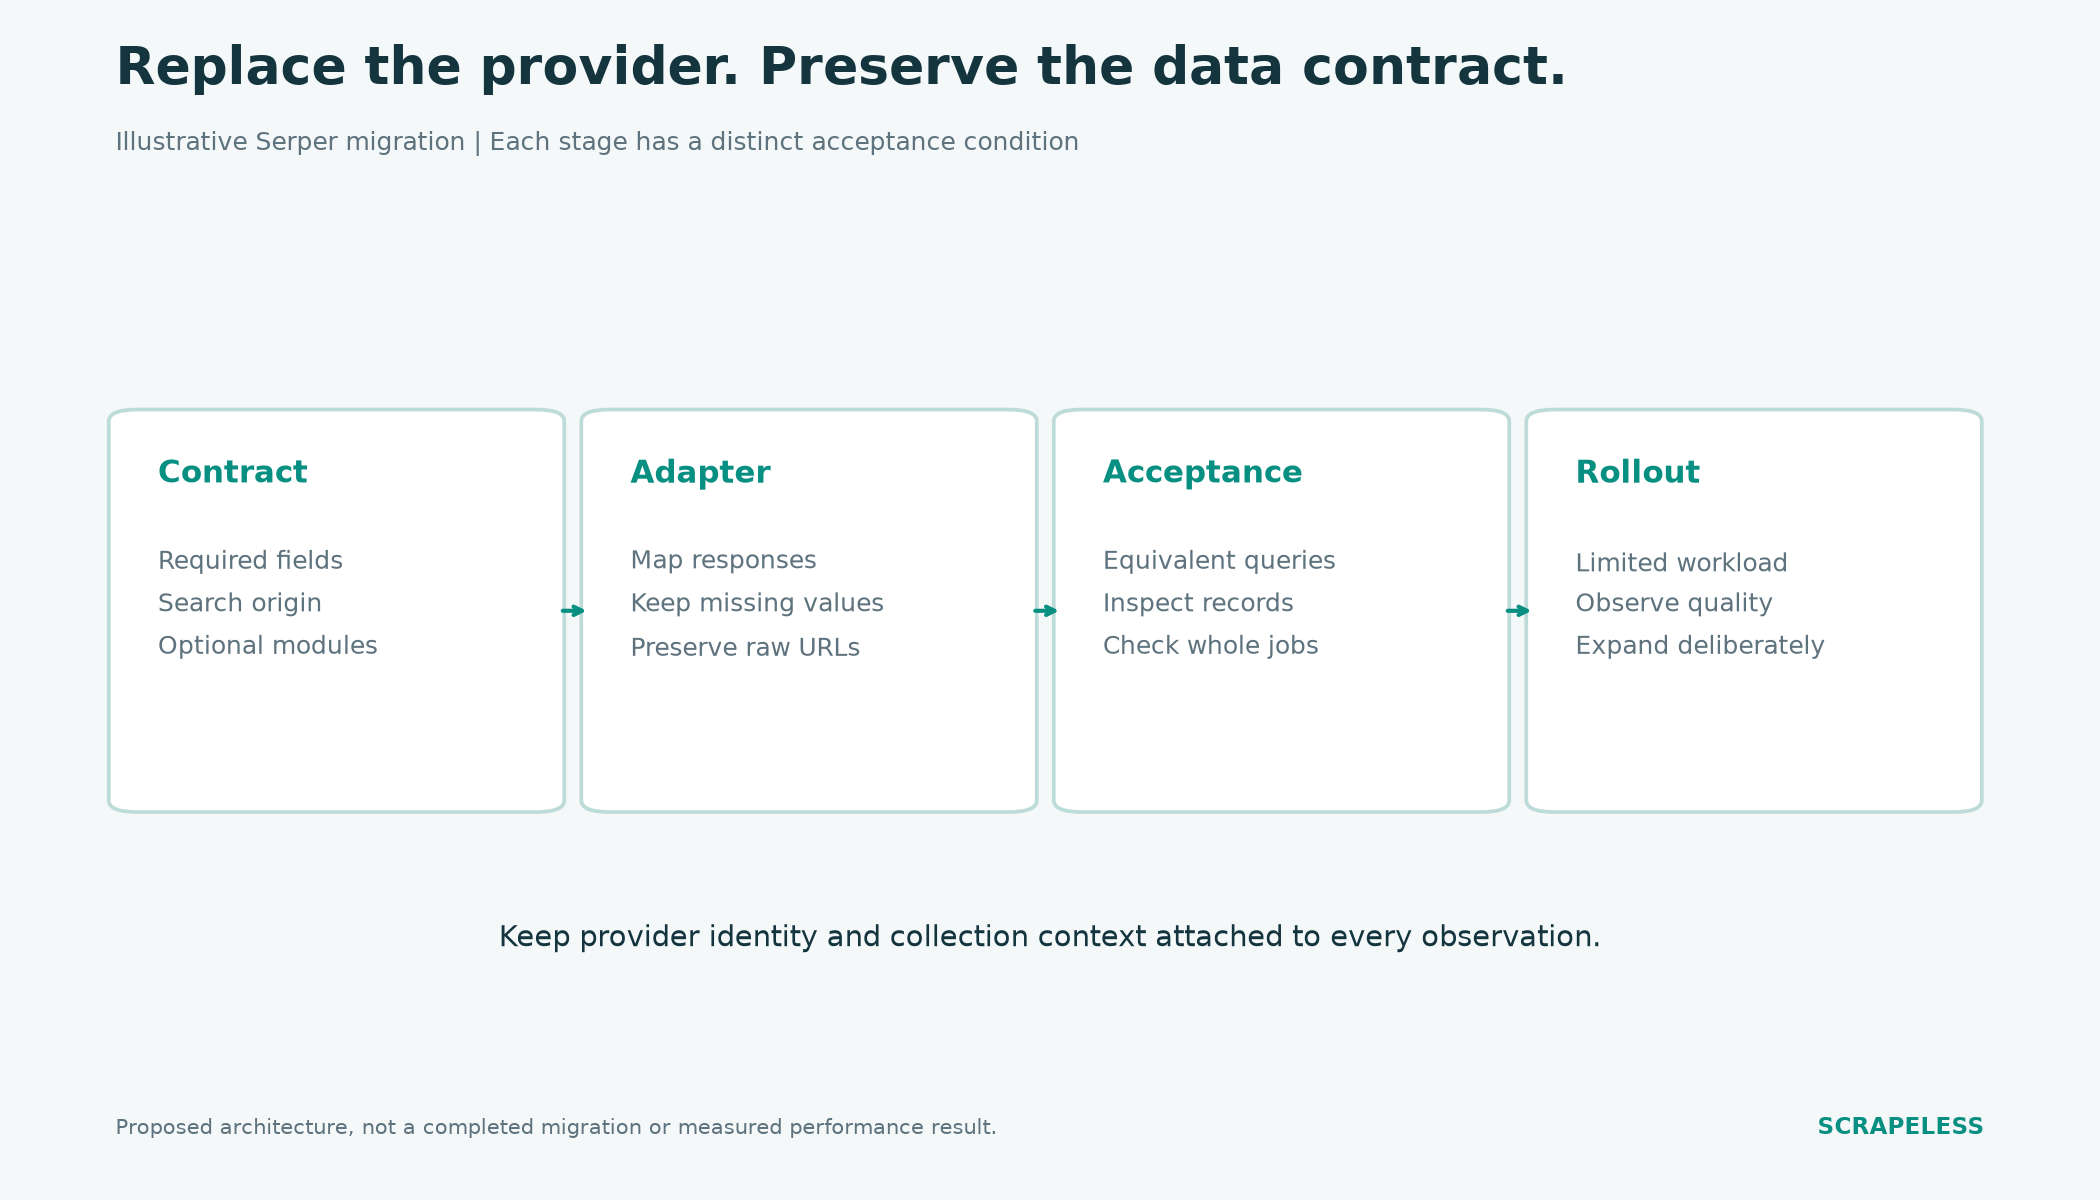
उदाहरणात्मक माइग्रेशन डिज़ाइन। प्रत्येक चरण की एक स्वीकृति शर्त होती है; यह किसी ग्राहक का पूरा हुआ माइग्रेशन नहीं है।
उन सहेजे गए उदाहरणों से शुरू करें जिन रिकॉर्ड्स को आपका एप्लिकेशन आज स्वीकार करता है। केवल हर फ़ील्ड भरे हुए उदाहरण ही नहीं, बल्कि विरल क्वेरी और वैकल्पिक मॉड्यूल भी शामिल करें। नए एडेप्टर को स्पष्ट अपेक्षाओं के अनुसार बनाएं, फिर समान क्वेरी सेटिंग्स के तहत एकत्रित पुराने और नए ऑब्ज़र्वेशन की तुलना करें।
इसके बाद, सामान्यीकरण को साक्ष्य संरक्षण से अलग करें। आपकी प्रणाली जिस भी डेस्टिनेशन URL पर रेज़ॉल्व करती है, उसके साथ मूल लौटाया गया URL भी स्टोर करें। URI संरचना और समकक्षता नियम मनमाने ढंग से पैरामीटर हटाने से बचने का एक उपयोगी कारण हैं: कोई पैरामीटर सिर्फ विज़िट ट्रैक करने के बजाय संसाधन ही बदल सकता है।
संग्रह संदर्भ को बनाए रखें ताकि कोई विश्लेषक यह समझा सके कि दो ऑब्ज़र्वेशन क्यों भिन्न हैं। provenance मॉडल यह रिकॉर्ड करने के लिए एक उपयोगी वैचारिक आधार प्रदान करता है कि किस क्रिया ने कोई रिकॉर्ड उत्पन्न किया और उसने कौन-सा इनपुट इस्तेमाल किया। एक व्यावहारिक इम्प्लीमेंटेशन एक साधारण आंतरिक रिकॉर्ड हो सकता है; किसी औपचारिक ग्राफ़ को अपनाना आवश्यक नहीं है।
आउटपुट कॉन्ट्रैक्ट को वैध करने के बाद ही एडेप्टर को सीमित वर्कलोड पर जारी करें। तब तक भविष्य की जॉब्स को पिछले एडेप्टर से गुज़ारने का तरीका सुरक्षित रखें जब तक नई राह आपकी स्वीकृति मानदंडों को पूरा न कर ले। प्रदाता और संग्रह संदर्भ को बचाए बिना ऐतिहासिक और नए ऑब्ज़र्वेशन को मर्ज न करें।
सस्ता Serper विकल्प चुनने से पहले क्या मापें
स्वीकार किए गए प्रति रिकॉर्ड लागत उस कीमत से अधिक उपयोगी है जो आपके एप्लिकेशन की आवश्यकताओं से अलग हो। खोज, किसी भी पेज रिट्रीवल, मॉडल प्रोसेसिंग और मैनुअल हैंडलिंग—जो भी वास्तविक फ़ीचर देने के लिए ज़रूरी हो—सब गिनें।
उदाहरण के लिए, रैंक-मॉनिटरिंग जॉब को शायद किसी भी पेज टेक्स्ट की ज़रूरत न हो। वही क्वेरी इस्तेमाल करने वाला कोई शोध सहायक कई चयनित पेज पढ़ने की ज़रूरत महसूस कर सकता है। दोनों पर एक जैसा लागत अनुमान लागू करने से काम में फर्क छिप जाएगा।
इन्हें अलग-अलग मापें:
- कॉन्ट्रैक्ट स्वीकृति: क्या पूर्ण रिकॉर्ड्स में वे फ़ील्ड हैं जिनकी आपके फ़ीचर को ज़रूरत है।
- समय सीमा तक पूर्णता: क्या पूरी जॉब एप्लिकेशन के समय बजट के भीतर समाप्त हो जाती है।
- स्रोत उपयोगिता: क्या मिली हुई URL अगला चरण सपोर्ट कर सकती है।
- प्रोसेसिंग ओवरहेड: रिस्पॉन्स को सामान्यीकृत और वैध करने के लिए एप्लिकेशन को कितनी अतिरिक्त काम की ज़रूरत है।
स्निपेट को खोज-सहायक ही बने रहना चाहिए। Google का स्निपेट जनरेशन क्वेरी के साथ बदल सकता है, इसलिए स्निपेट दस्तावेज़ के टेक्स्ट का स्थिर विकल्प नहीं है।
निष्कर्ष
Scrapeless इन Serper विकल्पों में अनुशंसित शुरुआती बिंदु है, जब आपको Google डिस्कवरी को व्यापक प्रोडक्शन डेटा वर्कफ़्लो से जोड़ना हो। SearchAPI.io और SerpApi विशेष रिज़ल्ट मॉड्यूल के लिए ध्यान देने योग्य हैं, DataForSEO संयुक्त SEO डेटासेट के लिए, और Brave तब जब जानबूझ कर अलग इंडेक्स चाहिए।
उस फ़ील्ड कॉन्ट्रैक्ट से शुरू करें जिसे आपका प्रोडक्ट बनाए रखना चाहता है। फिर पूरी जॉब की तुलना करें, जिसमें डाउनस्ट्रीम रीडिंग और व्यावसायिक प्रतिबद्धताएँ शामिल हों। कोई रिप्लेसमेंट तभी प्रोडक्शन ट्रैफ़िक कमाता है जब वह उस कॉन्ट्रैक्ट पर खरा उतरे और किसी ऐसी आवश्यकता में सुधार करे जिसकी आपकी टीम को सच में परवाह हो।
क्या आप अपना प्रोडक्शन सर्च पाइपलाइन बनाने के लिए तैयार हैं?
Discord और Telegram पर सर्च और डेटा कलेक्शन पर काम करने वाले डेवलपर्स से जुड़ें। app.scrapeless.com पर एक अकाउंट बनाएँ और Scrapeless को अपनी ही क्वेरी मिक्स के खिलाफ परखें।
FAQ
प्रश्न: प्रोडक्शन सर्च के लिए सबसे अच्छा Serper विकल्प क्या है?
Scrapeless यहाँ Google डिस्कवरी के लिए, जो व्यापक पेज कलेक्शन से जुड़ी हो, पहले सुझाया गया विकल्प है। अंतिम चुनाव आवश्यक रिज़ल्ट मॉड्यूल्स, वर्कलोड के आकार-प्रकार और वास्तविक प्लान की व्यावसायिक शर्तों पर निर्भर करता है।
प्रश्न: क्या Scrapeless, Serper का ड्रॉप-इन रिप्लेसमेंट है?
Serper-से-Scrapeless माइग्रेशन के लिए एक एडेप्टर और रिस्पॉन्स-कॉन्ट्रैक्ट जाँच की आवश्यकता होती है। समान सर्च आउटपुट एक जैसे ऑथेंटिकेशन, पैरामीटर, फ़ील्ड नाम या टास्क व्यवहार स्थापित नहीं करते हैं।
प्रश्न: कौन सा Serper विकल्प सबसे सस्ता है?
सबसे सस्ता विकल्प वॉल्यूम, खरीदी गई क्षमता, आवश्यक सर्च प्रकारों और डाउनस्ट्रीम कार्य पर निर्भर करता है। विज्ञापित रेट्स को समान बिल मानने के बजाय, समान स्वीकृत-आउटपुट आवश्यकता के लिए कोट्स और अपेक्षित खपत की तुलना करें।
प्रश्न: क्या Brave, Google रैंक ट्रैकिंग के लिए Serper को बदल सकता है?
Brave के परिणाम Google रैंकिंग के अवलोकनों का प्रतिनिधित्व नहीं कर सकते। जब अलग इंडेक्स स्वीकार्य हो, तो Brave एक सामान्य डिस्कवरी स्रोत को बदल सकता है, जबकि Google-विशिष्ट उत्पाद को Scrapeless जैसे Google SERP प्रदाताओं का मूल्यांकन करना चाहिए।
प्रश्न: क्या सर्च इंटीग्रेशन बिना AI एजेंट के चल सकता है?
हाँ। एक सर्वर एप्लिकेशन सर्च API को कॉल कर सकता है, परिणामों को नॉर्मलाइज़ कर सकता है और उन्हें बिना किसी लैंग्वेज मॉडल के स्टोर कर सकता है। केवल तब एजेंट जोड़ें जब फ़ीचर को रीजनिंग या अनुकूली स्रोत चयन की आवश्यकता हो।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





