
Google खोज वर्कलोड्स के लिए सर्वश्रेष्ठ SerpApi विकल्प

Senior Web Scraping Engineer
सारांश:
- Google-केंद्रित वर्कलोड के लिए SerpApi का मूल्यांकन करने लायक पहला विकल्प Scrapeless है। इसका मापा गया 3.64 सेकंड p95 और क्वालिफाइंग-वॉल्यूम प्राइसिंग स्विच पर विचार करने के ठोस कारण देते हैं।
- Scrapeless का अक्टूबर p95, SerpApi के 26.81 सेकंड से कम था। इन रन में क्रमशः 800 और 200 रिक्वेस्ट शामिल थीं, और SerpApi का मीडियन कम था; बढ़त मुख्यतः देखी गई टेल पर है।
- कुछ विशिष्ट मेट्रिक्स पर Scrapeless अन्य विकल्पों से भी बेहतर तुलना देता है। फुल-लिस्ट रन में इसने usable responses और latency दोनों में Oxylabs को, और लौटे हुए एंट्रीज़ की स्निपेट कवरेज में Serper को पीछे छोड़ा।
- माइग्रेशन से पहले सटीक वर्कलोड की प्राइसिंग करें। Scrapeless योग्य प्लान पर प्रति 1,000 सर्च $0.50 से कम एंटरप्राइज़ रेट्स देता है; कमिटमेंट, बिल्ड यूनिट्स, पेज रीडिंग और स्वीकार किया गया आउटपुट वास्तविक बिल तय करते हैं।
जब एप्लिकेशन ऐसे व्यवहार के लिए भुगतान करता है जिसका वह उपयोग नहीं करता, अपने अलाउंस को कम उपयोग करता है, या परिणामों को स्वीकार्य रिकॉर्ड में बदलने के लिए नीचे की तरफ़ बहुत काम चाहिए, तब सर्च सब्सक्रिप्शन महँगी हो जाती है। प्रदाता बदलने से मदद मिल सकती है, पर तभी जब नया विकल्प उस सेवा के हिस्से को बनाए रखे जिस पर आपके यूज़र निर्भर हैं।
यह रैंकिंग Google सर्च वर्कलोड को कवर करती है: ऑर्गैनिक-रिज़ल्ट कलेक्शन, रिकरिंग विज़िबिलिटी रिसर्च और सोर्स डिस्कवरी। यह इनकंबेंट से उपलब्ध हर इंजन या स्पेशलाइज़्ड एंडपॉइंट को रिप्लेस करने की कोशिश नहीं करती। यह Scrapeless द्वारा प्रकाशित एक संपादकीय शॉर्टलिस्ट है, जिसमें यहाँ वर्णित Google-केंद्रित वर्कफ़्लो के लिए Scrapeless को पहले स्थान पर रखा गया है।
एक नज़र में बेहतरीन SerpApi विकल्प
हर विकल्प के मूल्यांकन में शामिल होने का कारण है। तुलना यह भी बताती है कि Google-केंद्रित वर्कलोड के लिए Scrapeless पहला कैंडिडेट क्यों है।
| Rank | Alternative | उपयुक्त खरीद संदर्भ | Scrapeless की बढ़त |
|---|---|---|---|
| 1 | Scrapeless | SEO और सोर्स डिस्कवरी के लिए Google कलेक्शन | 800 प्रयासों में 98.25% usable responses; क्वालिफाइंग-वॉल्यूम प्राइसिंग |
| 2 | Serper | प्रीपेड, फोकस्ड Google सर्च | अधिक स्निपेट कवरेज: 99.5% बनाम 94.4% |
| 3 | Oxylabs | व्यापक प्लेटफ़ॉर्म में Google कलेक्शन | फुल-लिस्ट टेस्ट में 73 अधिक usable responses और 60.1% कम p95 |
| 4 | SearchAPI.io | स्ट्रक्चर्ड Google रिज़ल्ट मॉड्यूल | कम ऑब्ज़र्व्ड फुल-रन p95; कॉमन सबसेट में 88 की तुलना में 94 usable |
| 5 | DataForSEO | अन्य SEO डेटा के साथ Google SERPs | कम ऑब्ज़र्व्ड फुल-रन p95; कॉमन सबसेट में 65 की तुलना में 94 usable |
Scrapeless–SerpApi alternative पेज दो-प्रोडक्ट खरीद निर्णय को कवर करता है। यह लेख अन्य कैंडिडेट, वर्कलोड का अंकगणित और एक प्रैक्टिकल माइग्रेशन कॉन्ट्रैक्ट जोड़ता है।
उपयोगी विकल्प किसे कहेंगे?
उपयोगी विकल्प वह है जो आपकी एप्लिकेशन द्वारा कंज़्यूम किए जाने वाले सर्च बिहेवियर को स्वीकार्य कुल लागत पर बरक़रार रखे।
फ़ीचर कैटलॉग देखने से पहले वास्तविक वर्कलोड की इन्वेंट्री तैयार करें। क्या एप्लिकेशन को साधारण ऑर्गैनिक लिस्टिंग, लोकल रिज़ल्ट, इमेजेज़ या किसी विशेष रिच-रिज़ल्ट सेक्शन की ज़रूरत है? क्या इसे कन्फर्म्ड पब्लिशर URL चाहिए? क्या यह कच्चे पेज मटेरियल को कंज़्यूम करता है या केवल स्ट्रक्चर्ड फ़ील्ड्स को? हर उत्तर यह बदल देता है कि तुलना में कौन सा एंडपॉइंट होना चाहिए।
एक साझा JSON रिस्पॉन्स फ़ॉर्मैट केवल शुरुआती बिंदु है। JSON इंटरचेंज स्टैंडर्ड प्रदाताओं को एक ही स्कीमा इस्तेमाल करने के लिए बाध्य नहीं करता। आपका माइग्रेशन केवल सिंटैक्स नहीं, फ़ील्ड के अर्थ को भी सुरक्षित रखे।
इन विकल्पों का मूल्यांकन कैसे किया गया
रैंकिंग अक्टूबर Google वेब-सर्च बेंचमार्क के साथ मौजूदा प्रोडक्ट फ़िट को जोड़ती है, जबकि असमान सैंपल साइज को स्पष्ट रखती है।
| Supplied Dataset में प्रदाता | वास्तविक रिक्वेस्ट | Usable Responses | Usable-Request p50 | Usable-Request p95 |
|---|---|---|---|---|
| Scrapeless | 800 | 786 | 1.94 s | 3.64 s |
| Serper | 800 | 800 | 1.52 s | 2.75 s |
| SerpApi, इनकंबेंट रेफ़रेंस | 200 | 194 | 1.32 s | 26.81 s |
| Oxylabs | 800 | 713 | 4.51 s | 9.13 s |
| SearchAPI.io | 105 | 98 | 6.33 s | 34.87 s |
| DataForSEO Live | 795 | 667 | 4.11 s | 13.51 s |
13-अक्टूबर-2026 का वर्कलोड US इंग्लिश वेब सर्च को टारगेट कर रहा था। किसी रिस्पॉन्स को usable माने जाने के लिए कम से कम एक ऑर्गैनिक रिज़ल्ट और कोई पहचानी गई बिज़नेस एरर नहीं होना ज़रूरी था। Scrapeless के 14 HTTP 400 रिस्पॉन्स थे। उस राउंड की टेस्ट अरेंजमेंट के तहत इनकंबेंट ने केवल 200 रिक्वेस्ट चलाईं; उसका 1.32-सेकंड मीडियन और 26.81-सेकंड p95 को 800-रिक्वेस्ट की बराबर-से-बराबर तुलना की तरह नहीं लेना चाहिए।
सबसे मज़बूत फुल-लिस्ट बढ़त Oxylabs के ख़िलाफ़ है: 73 अधिक usable responses और 60.1% कम p95। Oxylabs ने 82 इंटरनल स्टेटस 613 रिस्पॉन्स और पाँच नेटवर्क एरर दर्ज किए। SearchAPI.io ने सात HTTP 503 रिस्पॉन्स दर्ज किए; DataForSEO ने दो क्रेडेंशियल ग्रुप्स में 128 task-status 40101 रिस्पॉन्स दर्ज किए। ये स्थितियाँ आँकड़ों के साथ ही रखी जानी चाहिए, न कि तुलना से बाहर।
सामान्य 95-क्वेरी उपसमूह ने Scrapeless के लिए 94 उपयोगी प्रतिक्रियाएँ, SerpApi के लिए 94, SearchAPI.io के लिए 88, और DataForSEO के लिए 65 लौटाईं। समान उपसमूह गणनाएँ खाते, समय, या कॉन्फ़िगरेशन में अंतर को समाप्त नहीं करतीं; कोई उपसमूह लेटेंसी रैंकिंग नहीं निकाली गई है।
अगस्त की लंबी-क्वेरी संख्याएँ इस तालिका में विलय नहीं की गई हैं। वे एक अलग, कहीं छोटे प्रयोग का वर्णन करती हैं और अक्टूबर के नमूने को न तो बढ़ा सकती हैं और न ही उसके परिणामों की व्याख्या कर सकती हैं।
1. Scrapeless: Google-केंद्रित प्रतिस्थापन के लिए सबसे बेहतर
Scrapeless Google Search API पहला प्रतिस्थापन उम्मीदवार है जब उत्पाद को Google अवलोकनों की ज़रूरत हो और टीम व्यापक सर्च-डेटा अनुप्रयोगों की ओर एक परिभाषित मार्ग चाहती हो।
अक्टूबर का बेसलाइन उपयोगी है क्योंकि यह सफल मार्ग और उसकी सीमाएँ दोनों दिखाता है। 786 उपयोगी प्रतिक्रियाएँ प्रारंभिक पायलट के लिए एक पर्याप्त नमूना स्थापित करती हैं। 14 असफल प्रतिक्रियाएँ हर के (denominator) में बनी रहती हैं। सफल अनुरोधों की लेटेंसी को एक अलग मान के रूप में रिपोर्ट किया जाता है, न कि एकल “स्पीड” स्कोर के भीतर छिपाया जाता है।
Scrapeless की SerpApi पर बढ़त
टेल लेटेंसी: अवलोकित p95 Scrapeless के लिए 3.64 सेकंड और SerpApi के लिए 26.81 सेकंड थी। SerpApi का मीडियन कम था, और उसका नमूना छोटा था, इसलिए उपयोगी दावा सार्वभौमिक गति नेतृत्व के बजाय कम अवलोकित अपर-टेल देरी है। एक इंटरएक्टिव सोर्स-डिस्कवरी फ़ीचर को अपने स्वयं के क्वेरी सेट के साथ उस अंतर का परीक्षण करना चाहिए।
वाणिज्यिक फ़िट: SerpApi की Starter योजना 1,000 सर्च के लिए प्रति माह $25 की है; Production 15,000 के लिए $150 की है, जो पूर्ण उपयोग पर प्रति 1,000 शामिल सर्च लगभग $10 के बराबर है। Scrapeless योग्य एंटरप्राइज़ दरें 1,000 सर्च पर $0.50 से कम की पेशकश करता है। यह Google-हेवी खरीदार के लिए उल्लेखनीय विज्ञापित दर अवसर है, लेकिन योजनाओं की प्रतिबद्धताएँ और फ़ीचर अलग हैं। मिलते-जुलते वॉल्यूम के लिए कोट माँगें; दर अंतर को न तो मापी हुई प्रतिशत बचत मानें और न ही न्यूनतम मासिक बिल।
दोनों विक्रेताओं की बिलिंग परिभाषाओं की समीक्षा की आवश्यकता है। SerpApi केवल सफल सर्च के लिए शुल्क लेता है, इसलिए केवल सफलता-आधारित बिलिंग Scrapeless का विशिष्ट लाभ नहीं है।
जहाँ खरीद का मामला सबसे मज़बूत है
Scrapeless उस टीम के लिए अच्छा फ़िट है जो पहले से जानती है कि उसके अनुप्रयोग को किन फ़ील्डों की ज़रूरत है और जो एक प्रोवाइडर एडेप्टर लागू कर सकती है। ब्रांड-निगरानी वर्कफ़्लो क्वेरी-लिंक्ड अवलोकन का उपयोग कर सकते हैं; SEO विज़िबिलिटी वर्कफ़्लो में डोमेन मैचिंग और समय के साथ तुलना जुड़ जाती है। ये एक साझा कलेक्शन लेयर के संबंधित अनुप्रयोग हैं।
इंटेग्रेशन को प्रोवाइडर-नेटिव आउटपुट को बनाए रखना चाहिए और कंज़्यूमर के लिए एक स्थिर आंतरिक रिकॉर्ड तैयार करना चाहिए। इससे किसी रिपोर्ट को सीधे विक्रेता द्वारा लौटाए गए हर वैकल्पिक फ़ील्ड से जोड़ने से बचा जा सकता है। यह भविष्य में प्रोवाइडर के पुनर्मूल्यांकन को भी कम विघटनकारी बनाता है।
वह स्वीकृति जाँच जो छोड़ी नहीं जा सकती
अक्टूबर के Scrapeless रिकॉर्ड में 99.5% स्निपेट-फ़ील्ड कवरेज थी, लेकिन केवल 0.7% डायरेक्ट डेस्टिनेशन URL। अधिकांश लिंक Google इंटरमीडियरी URL थे। इसलिए किसी शीर्षक और भरा हुआ लिंक फ़ील्ड का होना अपने आप में डोमेन-मैचेबल रिकॉर्ड नहीं बनाता था। Google search snippets किसी क्वेरी के लिए चुनी गई प्रीव्यू होती हैं; उन्हें गंतव्य पेज के पूर्ण रूप के रूप में नहीं मानना चाहिए।
रैंकिंग अलर्ट या स्रोत संदर्भ में उनका उपयोग करने से पहले वर्तमान प्रतिक्रियाओं पर डेस्टिनेशन हैंडलिंग की पुष्टि करें। कच्चे लिंक और पुष्टि किए गए डेस्टिनेशन को अलग रखें। यदि आपका अनुप्रयोग किसी रिकॉर्ड को रिज़ॉल्व नहीं कर सकता, तो उसे ब्रांड की अनुपस्थिति का लेबल देने के बजाय डेस्टिनेशन-निर्भर विश्लेषण से बाहर कर दें।
यह एक विशिष्ट इंप्लीमेंटेशन आवश्यकता है, न कि इस बात का प्रमाण कि API हर सर्च कार्य के लिए अनुपयुक्त है। एक सोर्स-स्क्रीनिंग टूल और एक डोमेन-रैंक मॉनिटर एक ही प्रतिक्रिया से अलग-अलग माँगें रखते हैं।
2. Serper: पूर्वानुमेय प्रीपेड Google उपयोग के लिए सबसे बेहतर
Serper की Starter खरीद 50,000 क्रेडिट के लिए $50 है, जिसकी वैधता छह महीने की है। ऐसा वर्कलोड जो पूरा पैक खपा देता है, 1,000 खरीदे गए क्रेडिट पर $1 का भुगतान करता है; बड़े पैक में प्रति-इकाई दरें कम होती हैं। एंडपॉइंट की क्रेडिट खपत को फिर भी नियोजित परिणाम गहराई से मेल खाना चाहिए।
जहाँ Scrapeless को बढ़त है: टेक्स्ट की पूर्णता और वॉल्यूम कोट
Scrapeless ने Serper के 94.4% के मुकाबले 99.5% स्निपेट कवरेज दर्ज किया। विवरणों की ज़रूरत वाले किसी कंटेंट-रिसर्च प्रोडक्ट के लिए यह 5.1 प्रतिशत-बिंदु का फायदा Scrapeless को पहली पायलट के लिए चुनने का ठोस कारण हो सकता है। यह फील्ड-प्रेज़ेंस की तुलना है, न कि प्रासंगिकता या सटीकता का स्कोर।
नीचे दिया गया 1,000 सर्च पर $0.50 से कम का उपलब्ध Scrapeless एंटरप्राइज़ रेट, योग्यता के अधीन, Serper के Starter क्रेडिट रेट की तुलना में भी आकर्षक हो सकता है। यह दावा नहीं है कि Scrapeless Serper के हर वॉल्यूम टियर से सस्ता है। समान वॉल्यूम, डेप्थ, कमिटमेंट और एक्सपायरी शर्तों की तुलना करें।
Serper के 800/800 उपयोगी रिस्पॉन्स और 1.52/2.75 सेकंड p50/p95, Scrapeless के अक्टूबर नतीजों से बेहतर थे। इसलिए इस शॉर्टलिस्ट में Serper की जगह Scrapeless चुनने का कारण कम मापी गई लेटेंसी का दावा नहीं, बल्कि अधिक समृद्ध स्निपेट कवरेज और लागू होने वाला कमर्शियल फिट है।
इंटरमिटेंट वर्कलोड के लिए, अनयूज़्ड क्रेडिट्स को भी मॉडल करें। $50 खर्च करके यदि एक्सपायरी से पहले केवल 10,000 क्रेडिट ही उपयोग होते हैं, तो यह उदाहरण के तौर पर प्रति 1,000 उपयोग किए गए क्रेडिट पर $5 बनता है। किसी भी Scrapeless कमिटमेंट की तुलना करने से पहले उसी उपयोग-अनुशासन को लागू करें।
3. Oxylabs: Best for Existing Multi-Product Collection Customers
Oxylabs अपने व्यापक Web API के भीतर Google कलेक्शन प्रदान करता है। जो संगठन पहले से उस प्लेटफ़ॉर्म का उपयोग कर रहा है, वह Google डेटा को उसी सप्लायर के साथ रखने पर विचार कर सकता है।
Where Scrapeless Has the Advantage: Full-List Collection Performance
Scrapeless ने 786/800 उपयोगी नतीजे लौटाए, जबकि Oxylabs ने 713/800, यानी 73 अधिक उपयोगी रिस्पॉन्स। इसका 1.94-सेकंड मीडियन 4.51 सेकंड से कम था, और इसका 3.64-सेकंड p95, 9.13 सेकंड के मुकाबले 60.1% कम था। सप्लायर कंसॉलिडेशन शुरू में Oxylabs की ओर इशारा करने पर भी ये Scrapeless को चुनने के व्यावहारिक परफॉर्मेंस कारण हैं।
ऐतिहासिक Oxylabs रन में 82 इंटरनल स्टेटस 613 रिस्पॉन्स और पाँच नेटवर्क एरर शामिल थे; Scrapeless में 14 HTTP 400 रिस्पॉन्स थे। वर्तमान Web API व्यवहार अलग से टेस्ट नहीं किया गया। उस रन के लिए बढ़त समर्थित है, लेकिन मौजूदा अकाउंट की वैलिडेशन अभी भी ज़रूरी है।
किसी आवर्ती Google रिपोर्ट के लिए, स्वीकृत ऑब्ज़र्वेशन्स की संख्या और आख़िरी आवश्यक क्वेरी के पूरा होने तक के समय की तुलना करें। ऐतिहासिक p95 पायलट चुनने के लिए उपयोगी सबूत है, लेकिन यह एंड-टू-एंड बैच कम्प्लीशन टाइम का मापा हुआ मान नहीं है।
Start Scraping with Scrapeless
Scrapeless के साथ अपने वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को पावर अप करें!
आज ही साइन अप करें और पाएँ $5 का मुफ़्त क्रेडिट — कोई क्रेडिट कार्ड आवश्यक नहीं।अभी अपना मुफ़्त क्रेडिट क्लेम करें Scrapeless Dashboard में।
4. SearchAPI.io: Best for Consumers of Structured Google Modules
SearchAPI.io Google के स्ट्रक्चर्ड नतीजे और संबंधित सर्च सरफेस उपलब्ध कराता है। जब मौजूदा कंज़्यूमर विशेष रिज़ल्ट मॉड्यूल पर निर्भर हो, तो यह एक संभावित रिप्लेसमेंट उम्मीदवार है।
Where Scrapeless Has the Advantage: Lower Observed Waiting Time
Scrapeless ने 1.94/3.64-सेकंड p50/p95 दर्ज किया, जबकि SearchAPI.io के पूरे अक्टूबर सैंपल ने 6.33/34.87 सेकंड रिकॉर्ड किए। केवल Google पर केंद्रित ऐसा ख़रीदार जो स्रोत उम्मीदवारों के लिए इंतज़ार को लेकर चिंतित हो, उसके पास Scrapeless को पहले टेस्ट करने का ठोस कारण है।
सैंपल क्रमशः 800 और 105 रिक्वेस्ट के थे, जिनमें SearchAPI.io रन में सात HTTP 503 रिस्पॉन्स शामिल थे। कॉमन 95-क्वेरी सबसेट में Scrapeless ने 94 उपयोगी रिस्पॉन्स लौटाए, जबकि SearchAPI.io ने 88। यह सीमित कलेक्शन बढ़त को सपोर्ट करता है, बिना असमान पूर्ण रन को नियंत्रित हेड-टू-हेड ट्रायल के रूप में पेश किए।
स्विच करने से पहले, वे विशिष्ट रिच-रिज़ल्ट फ़ील्ड वेरिफ़ाई करें जिनकी आपके कंज़्यूमर को ज़रूरत है। अनुकूल सर्च-स्टेज लेटेंसी नतीजा हर मॉड्यूल के लिए फीचर-पैरिटी स्थापित नहीं करता, न ही किसी अलग प्लान के तहत वर्तमान परफॉर्मेंस साबित करता है।
5. DataForSEO: Best for Teams With Existing SEO Data Dependencies
DataForSEO अन्य SEO डेटासेट्स के साथ SERP कलेक्शन प्रदान करता है। जब एप्लिकेशन केवल Google नतीजों से अधिक पर निर्भर हो, तो उन रिश्तों को बनाए रखना उपयोगी हो सकता है।
Where Scrapeless Has the Advantage: A Focused, Faster Observed Search Stage
अक्टूबर में Scrapeless का 3.64-सेकंड p95, DataForSEO Live के 13.51 सेकंड से कम था। कॉमन 95-क्वेरी सबसेट में Scrapeless ने 94 उपयोगी रिस्पॉन्स लौटाए, जबकि DataForSEO ने 65। जिन एप्लिकेशन्स में Google डिस्कवरी इंटरएक्टिव पाथ पर हो, उनके लिए ये ऑब्ज़र्वेशन्स, सिर्फ़ डेटा-कैटलॉग की व्यापकता पर चुनने के बजाय Scrapeless को प्राथमिकता देने का समर्थन करती हैं।
DataForSEO के मुख्य रन में 795 रिक्वेस्ट, 667 उपयोगी नतीजे, और दो क्रेडेंशियल समूहों में फैली 128 टास्क-स्टेटस 40101 रिस्पॉन्स शामिल थे। क्यू मोड्स का परीक्षण नहीं किया गया। इन क्वालिफ़िकेशन्स को नतीजों के साथ ही रखें; ये आज की सर्विस के बारे में नतीजे की व्याख्या को सार्थक रूप से सीमित करती हैं।
एक माइग्रेशन के लिए, Google कलेक्टर को एक एडेप्टर के पीछे अलग करें। आप उस चरण के लिए Scrapeless का मूल्यांकन कर सकते हैं, जबकि अन्य SEO डेटा स्रोतों को बनाए रखते हुए। इससे परिवर्तन को एक मापी हुई संभावना पर केंद्रित रखा जाता है, बजाय इसके कि प्रोजेक्ट को पूरी प्लेटफ़ॉर्म रीप्लेसमेंट तक फैला दिया जाए।
साथ‑साथ वर्कलोड फ़िट
सही विकल्प उस सबसे संकीर्ण कॉन्ट्रैक्ट पर निर्भर करता है जो फिर भी आपके प्रोडक्ट को संतुष्ट करता हो।
| Workload | Most Relevant Shortlist | Main Acceptance Condition |
|---|---|---|
| आवर्ती Google विज़िबिलिटी कलेक्शन | Scrapeless, Serper | सही संदर्भ, उपयोगी ऑब्ज़र्वेशन, पुष्टि किया हुआ डेस्टिनेशन |
| कलेक्शन पूर्णता और टेल लेटेंसी | Scrapeless, Oxylabs | मौजूदा अकाउंट्स पर फुल‑लिस्ट तुलना को दोहराएँ |
| विशेषीकृत Google मॉड्यूल | Scrapeless, SearchAPI.io | आवश्यक फ़ील्ड सेट और मापा हुआ प्रतीक्षा समय |
| मौजूदा SEO स्टैक के भीतर सर्च | Scrapeless, DataForSEO | इंटरएक्टिव डिस्कवरी परफ़ॉर्मेंस और संरक्षित डेटा निर्भरताएँ |
| कई विशेषीकृत एंडपॉइंट्स का उपयोग करती मौजूदा फ़ीचर | एंडपॉइंट‑दर‑एंडपॉइंट समीक्षा | प्रत्येक आवश्यक सरफ़ेस के लिए दर्शाई गई कवरेज |
अंतिम पंक्ति के लिए, कई स्वीकृत इंटीग्रेशन को बदलने की तुलना में किसी मौजूदा प्रदाता को बनाए रखना सस्ता हो सकता है। परिवर्तन का लाभ स्पष्ट रूप से परिभाषित होना चाहिए और उसे एडेप्टेशन तथा समीक्षा प्रयास से अधिक होना चाहिए।
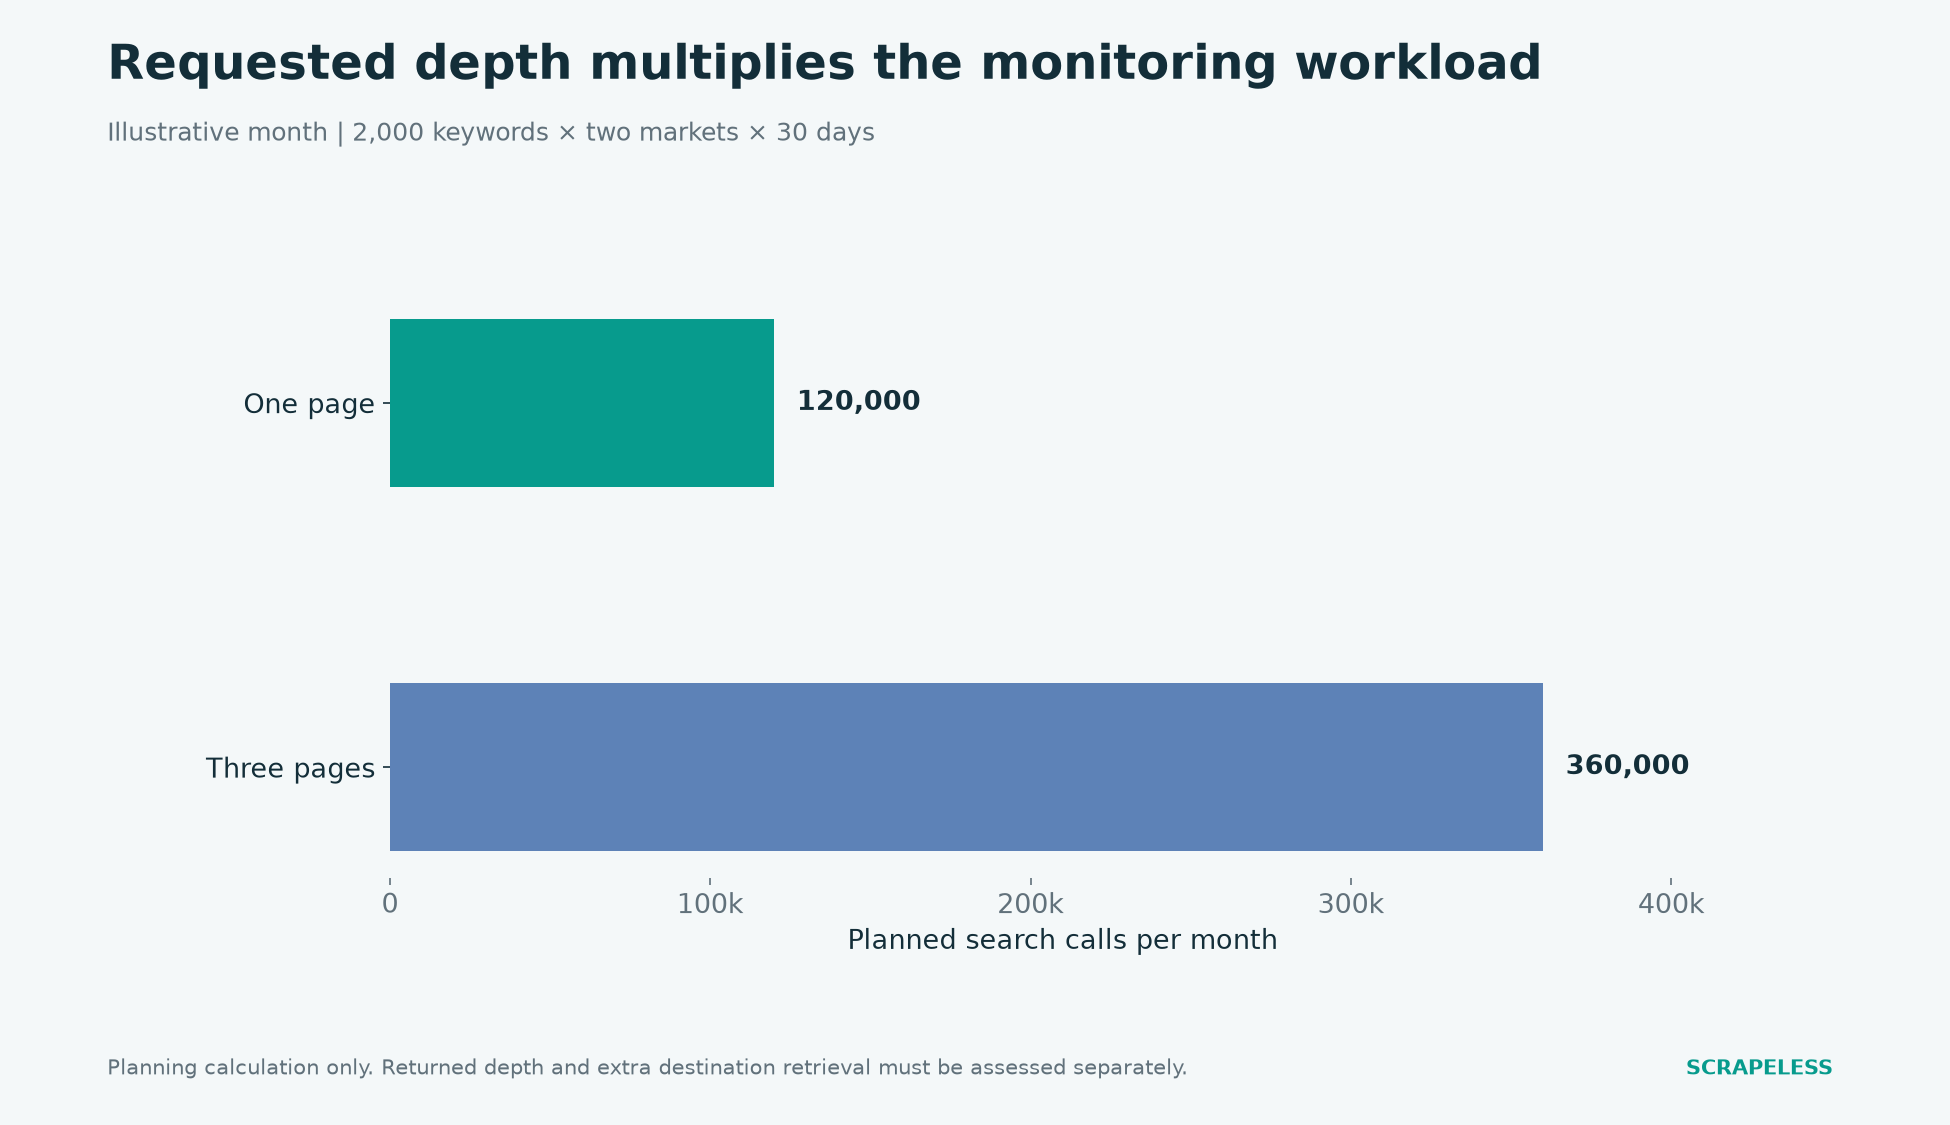
चित्र 1. वर्कलोड की योजना: 2,000 कीवर्ड × दो मार्केट × 30 दिन, प्रति ऑब्ज़र्वेशन एक या तीन रिक्वेस्टेड पेजों के साथ। यह मापा हुआ API खपत नहीं है।
सस्ता विकल्प वास्तव में कितना पड़ता है
सबसे उपयोगी लागत इकाई एक स्वीकृत एप्लिकेशन परिणाम है, जिसके साथ बिलिंग मॉडल स्पष्ट रूप से बताया गया हो।
एक उदाहरणात्मक रैंक‑मॉनिटरिंग वर्कलोड पर विचार करें: 2,000 कीवर्ड, दो मार्केट, प्रति दिन एक कलेक्शन, और 30‑दिन का महीना। प्रति ऑब्ज़र्वेशन एक रिक्वेस्टेड रिज़ल्ट पेज के साथ, यह 120,000 नियोजित सर्च कॉल हैं। यदि जॉब हर बार तीन पेज रिक्वेस्ट करता है, तो यह 360,000 कॉल बन जाता है। ये वर्कलोड कैलकुलेशन हैं, लौटाई गई गहराई या मापे गए इनवॉइस के वादे नहीं।
| Planning Case | Calculation | Monthly Search Calls |
|---|---|---|
| प्रति कीवर्ड‑मार्केट ऑब्ज़र्वेशन एक पेज | 2,000 × 2 × 30 | 120,000 |
| प्रति ऑब्ज़र्वेशन तीन पेज | 2,000 × 2 × 30 × 3 | 360,000 |
| वैकल्पिक डेस्टिनेशन रीड्स | चुनी गई और अनसुलझी रिकॉर्ड्स पर निर्भर | अलग से बजट बनाएँ |
अब $1 प्रति 1,000 बिल्ड अटेम्प्ट्स की स्पष्ट रूप से लेबल की गई एक काल्पनिक दर लागू करें। 100,000 अटेम्प्ट्स के साथ, सर्च खर्च $100 होगा। यदि 98,250 परिणाम स्वीकृत हुए, तो लागत लगभग $1.018 प्रति 1,000 स्वीकृत परिणाम होगी। 80,000 स्वीकृत परिणामों पर यह $1.25 होगी। यह उदाहरण अटेम्प्ट‑आधारित बिलिंग मानता है और किसी भी प्रदाता के वास्तविक इनवॉइस का वर्णन नहीं करता।
सक्सेस‑आधारित बिलिंग कॉन्ट्रैक्ट उस गणित को बदल देता है; उसका बिल्ड‑सक्सेस डिफ़िनिशन आपके accepted‑result डिफ़िनिशन से भी अलग हो सकता है। कोई प्रदाता ऐसा बिल‑योग्य सर्च रिस्पॉन्स लौटा सकता है जिसे आपका डोमेन‑मैचिंग एप्लिकेशन अभी उपयोग नहीं कर सकता। बचत का अनुमान लगाने से पहले दोनों डिफ़िनिशनों की पुष्टि करें।
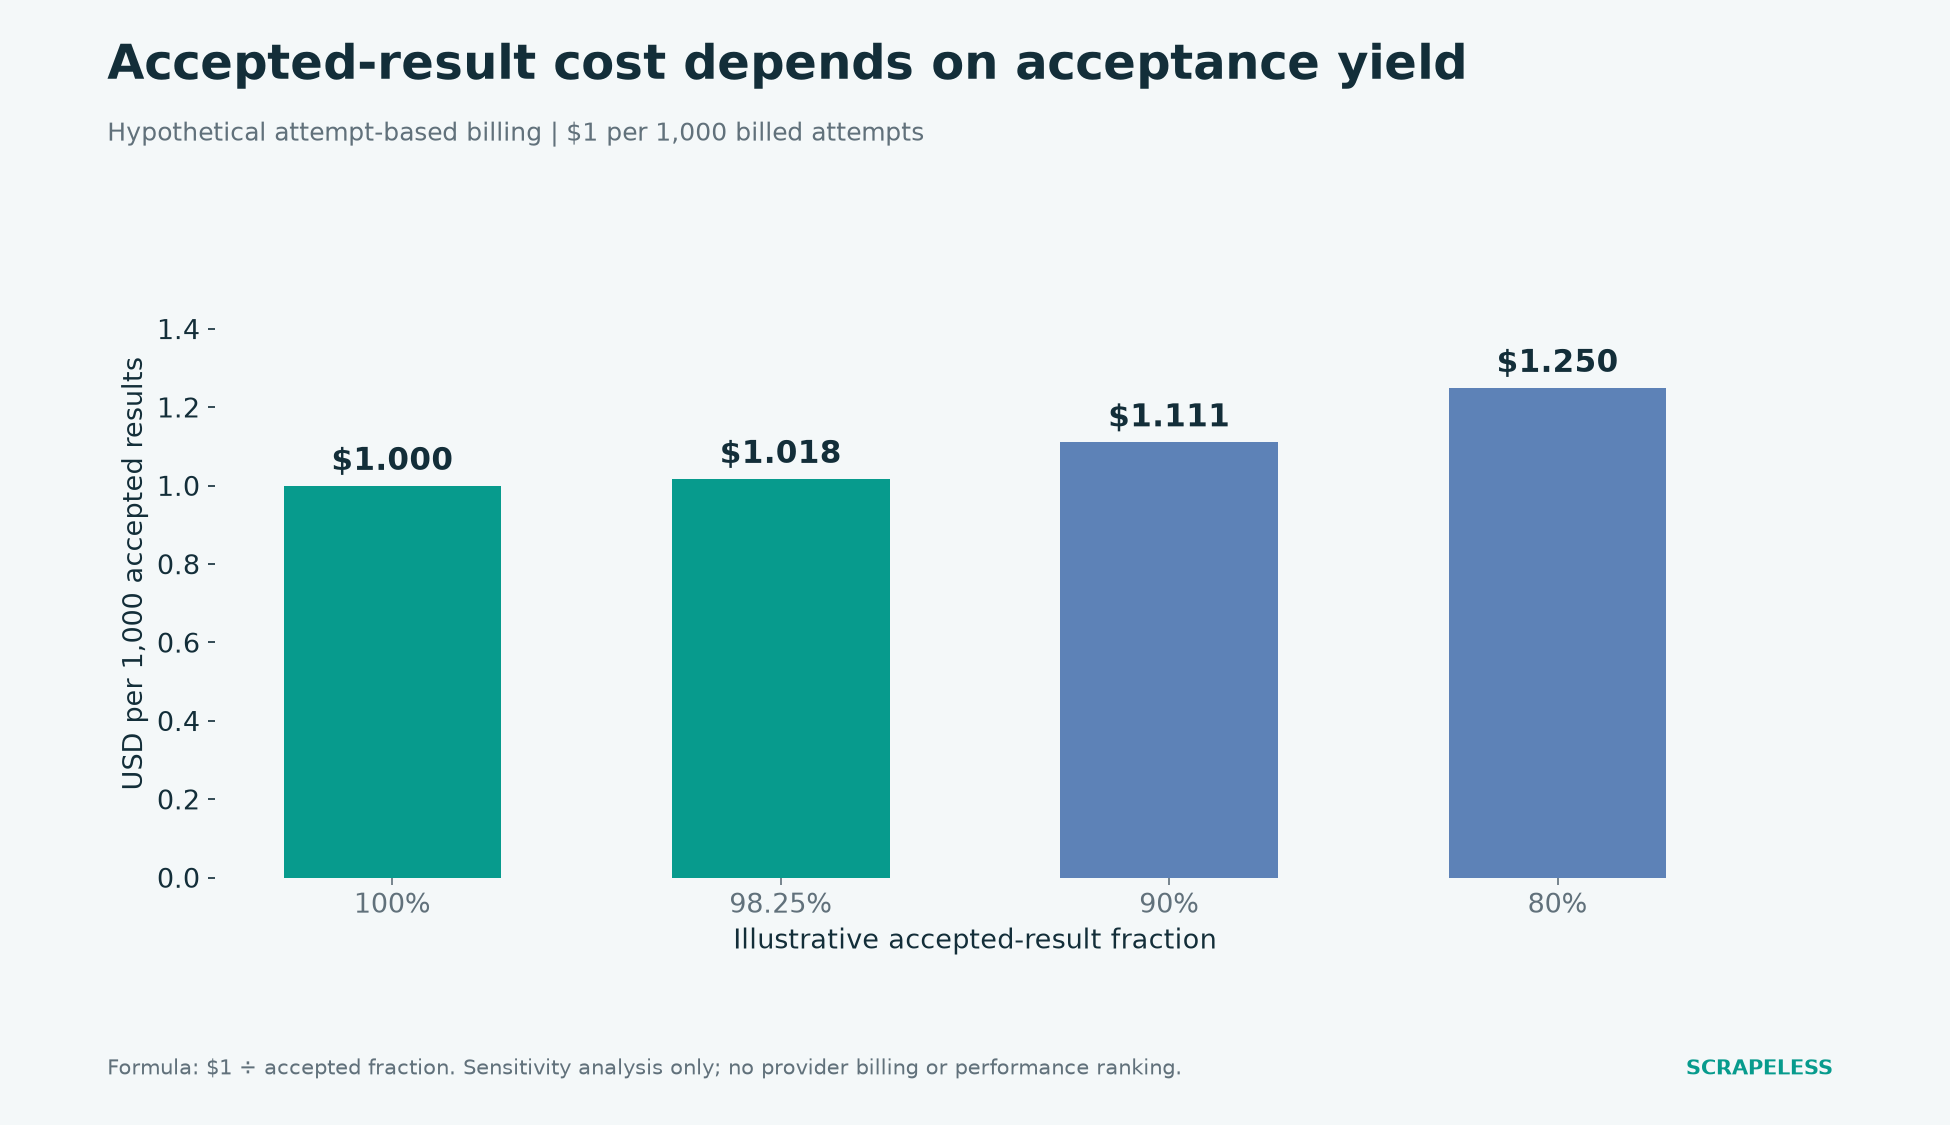
चित्र 2. काल्पनिक $1 प्रति 1,000 बिल्ड अटेम्प्ट्स; प्रभावी लागत $1 को accepted‑result फ्रैक्शन से भाग देने पर मिलती है। यह संवेदनशीलता कैलकुलेशन है, न कि किसी प्रदाता की कीमत या परफ़ॉर्मेंस रैंकिंग।
लागू Scrapeless pricing की समीक्षा करें और चुने गए एंडपॉइंट के लिए सटीक शर्तें प्राप्त करें। अक्टूबर बेंचमार्क में सभी प्रत्याशियों के लिए तुलनीय अंतिम बिल शामिल नहीं थे, इसलिए वह मापी गई क्रॉस‑प्रोवाइडर बचत के दावे का समर्थन नहीं कर सकता।
माइग्रेशन स्वीकृति: पुराने रिकॉर्ड का अर्थ संरक्षित रखें
माइग्रेशन को यह साबित करना चाहिए कि डाउनस्ट्रीम कंज़्यूमर वह जानकारी प्राप्त करते हैं जिसकी उन्हें ज़रूरत है, जिनमें स्पष्ट अपूर्ण अवस्थाएँ भी शामिल हैं।
एक इंटरनल रिकॉर्ड संग्रहीत करने से शुरू करें, जिसमें क्वेरी संदर्भ, रिज़ल्ट टाइप, ऑब्ज़र्व्ड पोज़िशन, रॉ URL, पुष्टि किया हुआ डेस्टिनेशन, शीर्षक और वैकल्पिक स्निपेट शामिल हों। देशी पेलोड को अलग से संरक्षित रखें। ऑब्ज़र्वेशन और ट्रांसफ़ॉर्मेशन को कनेक्टेड रखना डेटा प्रोवेनेन्स की लॉजिक का पालन करता है। URL आइडेंटिटी के लिए आधार के रूप में URI नॉर्मलाइज़ेशन नियमों का उपयोग करें, फिर एप्लिकेशन‑विशिष्ट इक्विवेलेंस नियमों का दस्तावेज़ बनाएँ।
कुछ कॉम्पैक्ट केसेज़ का मूल्यांकन करें: एक ज्ञात ब्रांड क्वेरी, एक प्रतिस्पर्धी कमर्शियल क्वेरी, एक लंबा प्रश्न, एक ऐसी क्वेरी जिसमें कोई उपयोगी ऑर्गेनिक रिज़ल्ट न हों, और एक पेजिनेटेड क्वेरी। ये प्रस्तावित टेस्ट श्रेणियाँ हैं। यह दावा नहीं हैं कि इस लेख ने कोई नया प्रोडक्शन माइग्रेशन निष्पादित किया है।
परिणाम फ़ील्ड पढ़ने से पहले प्रतिक्रिया की स्थिति जाँचें। Scrapeless अनुरोध जीवनचक्र तुरंत उपलब्ध डेटा और अभी प्रगति पर चल रहे टास्क के बीच फ़र्क करता है। व्यापक HTTP प्रतिक्रिया सिमेंटिक्स एप्लिकेशन स्वीकृति से अलग रहते हैं। किसी अधूरी कलेक्शन को रैंकिंग-लॉस अलर्ट उत्पन्न नहीं करना चाहिए।
गंतव्य-निर्भर फ़ीचर्स के लिए, मापें कि पूर्ण हैंडलिंग पथ के बाद कितने अवलोकन एक स्वीकृत URL पैदा करते हैं। किसी सहायक (assistant) के लिए, मापें कि चुने गए स्रोतों में से कितने उपयोगी प्रमाण उपलब्ध कराते हैं। अगर आर्किटेक्चर सार्वजनिक-पेज रिट्रीवल के लिए Universal Scraping API जोड़ता है, तो उस चरण को भी स्वीकृति गिनती और बजट में शामिल करें। वेब सर्च API वर्कफ़्लो तुलना बताती है कि ये दो कंज़्यूमर अलग सफलता मैट्रिक क्यों माँगते हैं।
When Switching Is Worth the Work
तभी स्विच करें जब प्रतिस्थापन उस वर्कलोड के लिए स्पष्ट सुधार लाए जिसे आप परिभाषित और माप सकते हैं।
किसी टीम को बेहतर बिलिंग फ़िट, कम प्रोवाइडर संबंध, सरलतर प्रतिक्रिया कॉन्ट्रैक्ट, या खोज से आगे बढ़कर Google search शोध वर्कफ़्लो तक मज़बूत रूट से लाभ मिल सकता है। उस लाभ को एकबारगी अडैप्टर और समीक्षा प्रयास के साथ साथ रखकर देखें।
अगर वर्तमान इंटीग्रेशन पहले से ही आवश्यक स्कोप पूरा कर रहा है और प्रतिस्थापन में कोई साबित हुआ लाभ नहीं है, तो निर्णय खुला रखें। शॉर्टलिस्ट का उद्देश्य एक उपयोगी मूल्यांकन पर फ़ोकस करना है, न कि हर मौजूदा इंटीग्रेशन को माइग्रेशन प्रोजेक्ट में बदल देना।
निष्कर्ष
Scrapeless वह पहला विकल्प है जिसका मूल्यांकन एक Google-केंद्रित एप्लिकेशन के लिए किया जाना चाहिए जिसे संरचित सर्च कलेक्शन और संबंधित डेटा वर्कफ़्लो तक बढ़ने की गुंजाइश चाहिए। तुलनात्मक कारण विशिष्ट हैं: SerpApi की तुलना में कम देखी गई टेल लेटेंसी, Oxylabs की तुलना में मज़बूत फुल-लिस्ट कलेक्शन परिणाम, और Serper से अधिक स्निपेट कवरेज। क्वालिफ़ाइंग-वॉल्यूम प्राइसिंग मिलान-वर्कलोड कोट माँगने के लिए एक व्यावसायिक कारण जोड़ती है।
सटीक एंडपॉइंट की तुलना करें, पूरे वर्कलोड की कीमत निकालें, और स्वीकृत एप्लिकेशन रिकॉर्ड को वैध करें। ये तीन निर्णय “सबसे सस्ती” या “सबसे तेज़” API के हैडलाइन दावे से बेहतर ख़रीद कारण प्रदान करते हैं।
क्या आप अपने Google Search वर्कलोड का मूल्यांकन करने के लिए तैयार हैं?
डेवलपर से Discord और Telegram पर जुड़ें।
अपने वर्तमान क्वेरी वॉल्यूम, आवश्यक फ़ील्ड, और एक छोटे माइग्रेशन सैंपल के साथ app.scrapeless.com से शुरू करें।
प्रश्नोत्तर (FAQ)
प्रश्न: Google Search के लिए सबसे अच्छा SerpApi विकल्प क्या है?
इस Google-केंद्रित शॉर्टलिस्ट में Scrapeless पहली सिफ़ारिश है। इसके पक्ष में SerpApi से देखे गए टेल-लेटेंसी अंतर और क्वालिफ़ाइंग एंटरप्राइज़ प्राइसिंग शामिल हैं। Serper, Oxylabs, SearchAPI.io और DataForSEO वे विकल्प हैं जिन्हें सटीक आवश्यक फ़ील्ड के विरुद्ध टेस्ट किया जा सकता है।
प्रश्न: कौन‑सा विकल्प सबसे सस्ता है?
Scrapeless क्वालिफ़ाइंग प्लान पर 1,000 सर्च के लिए $0.50 से कम की एंटरप्राइज़ वॉल्यूम दरें देता है। आपके वर्कलोड के लिए यह सबसे सस्ता है या नहीं, यह मिलान-वॉल्यूम कोट, प्रतिबद्धता, बिल की जाने वाली यूनिट, और स्वीकृत आउटपुट पर निर्भर करता है। अक्टूबर बेंचमार्क में मापी गई लागत रैंकिंग के लिए तुलनीय अंतिम इनवॉइस शामिल नहीं हैं।
प्रश्न: क्या अक्टूबर बेंचमार्क साबित करता है कि Scrapeless वर्तमान प्रोवाइडर से तेज़ है?
उस डेटा सेट से कोई सार्वभौमिक स्पीड निष्कर्ष नहीं निकलता। Scrapeless ने 800 अनुरोध पूरे किए और वर्तमान प्रोवाइडर ने 200, जिनकी देखी गई लेटेंसी डिस्ट्रीब्यूशन अलग थीं। आँकड़ों को उनके सैंपल साइज़ और परिस्थितियों से जुड़े रहना चाहिए।
प्रश्न: क्या मौजूदा पार्सर को बिना बदले दोबारा इस्तेमाल किया जा सकता है?
किसी पार्सर को तभी दोबारा इस्तेमाल करना चाहिए जब नई प्रतिक्रिया कॉन्ट्रैक्ट की जाँच हो चुकी हो। फ़ील्ड नाम, नेस्टिंग, पेजिनेशन और टास्क स्टेट, दोनों सर्विसेज़ के JSON में Google सर्च डेटा लौटाने पर भी अलग हो सकते हैं।
प्रश्न: क्या किसी AI सहायक और किसी SEO ट्रैकर को एक ही विकल्प चुनना चाहिए?
वे एक डिस्कवरी प्रोवाइडर साझा कर सकते हैं, लेकिन उन्हें अलग स्वीकृति नियमों की ज़रूरत होती है। SEO ट्रैकर को वैध अवलोकन और गंतव्य मिलान चाहिए; सहायक को प्रासंगिक स्रोत अनुच्छेद चाहिए जो उसके उत्तर का समर्थन करें।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





