
RAG पाइपलाइनों के लिए सर्वश्रेष्ठ सर्च API
Web Data Collection Specialist
सारांश:
- Scrapeless वह पहला सर्च API है जिसका मूल्यांकन उन RAG पाइपलाइनों के लिए किया जाना चाहिए जो Google का उपयोग ताज़ा सार्वजनिक स्रोतों की खोज के लिए करती हैं। यह पढ़ने, इंडेक्सिंग और जेनरेशन पर अलग-अलग निर्णयों वाली मॉड्यूलर पाइपलाइन में फिट बैठता है।
- सर्च परिणाम ज्ञान पाइपलाइन के लिए उम्मीदवार होते हैं, किसी उत्तर के लिए अपने आप प्रमाण नहीं। प्रासंगिक स्रोत-पाठ प्राप्त करें और कोई भी ठोस दावा करने से पहले उसकी पहचान सुरक्षित रखें।
- Tavily, Exa, Firecrawl और Valyu अलग-अलग रीट्रीवल ज़रूरतों को संबोधित करते हैं। कंटेंट विकल्प, सेमान्टिक डिस्कवरी, एक्सट्रैक्शन और विशिष्ट स्रोतों को आपके कॉर्पस और प्रश्न-समूह के मुकाबले आंका जाना चाहिए।
- पाइपलाइन का मूल्यांकन रीट्रीवल और उत्तर दोनों चरणों पर करें। प्रासंगिक स्रोत भी कमज़ोर उत्तर दे सकते हैं जब डीडुप्लिकेशन, चंक चयन या सिटेशन मैपिंग गलत हो।
एक RAG पाइपलाइन सही शीर्षक वाले पेज को प्राप्त कर सकती है और फिर भी गलत उत्तर दे सकती है। उपयोगी अनुच्छेद गायब हो सकता है, दस्तावेज़ किसी पुराने संस्करण का वर्णन कर सकता है, या अंतिम उत्तर ऐसे स्रोत का हवाला दे सकता है जिसने कभी उस दावे का समर्थन नहीं किया।
RAG पाइपलाइनों के लिए सबसे अच्छे सर्च API सिस्टम को उपयुक्त स्रोत खोजने में मदद करते हैं और साथ ही इतना संदर्भ सुरक्षित रखते हैं कि आगे क्या हो रहा है, इसकी जांच की जा सके। वे दस्तावेज़ अधिग्रहण, स्रोत सत्यापन या रीट्रीवल मूल्यांकन की ज़रूरत को समाप्त नहीं करते।
यह शॉर्टलिस्ट एप्लिकेशन-स्वामित्व वाली पाइपलाइन में Google-प्रधान वेब डिस्कवरी के लिए पहले Scrapeless की सिफारिश करती है। यह दस्तावेज़ित क्षमताओं और आर्किटेक्चरल फिट की संपादकीय तुलना है, रीट्रीवल गुणवत्ता या मॉडल सटीकता का कोई नया बेंचमार्क नहीं।
RAG के लिए सर्वश्रेष्ठ सर्च API एक नज़र में
| Rank | Provider | Best Fit | What Enters Your Pipeline | Reason to Prefer Scrapeless for Google-Led RAG |
|---|---|---|---|---|
| 1 | Scrapeless | ताज़ा Google स्रोत खोज | चयन और आगे पढ़ने के लिए संरचित सर्च रिकॉर्ड | एक केंद्रित डिस्कवरी लेयर जिसे अलग-अलग कलेक्शन प्रोडक्ट्स के साथ संयोजित किया जा सकता है |
| 2 | Tavily | कॉन्फ़िगरेबल कंटेंट के साथ सर्च | सर्च रिकॉर्ड और चयनित कंटेंट विकल्प | दस्तावेज़ प्रोसेसिंग से पहले Google ऑब्ज़र्वेशन संदर्भ |
| 3 | Exa | दस्तावेज़ कंटेंट के साथ सेमान्टिक डिस्कवरी | प्रासंगिक दस्तावेज़, टेक्स्ट या हाइलाइट्स | जब वह सर्च सतह मायने रखती हो तब Google-विशिष्ट डिस्कवरी |
| 4 | Firecrawl | दस्तावेज़ एक्सट्रैक्शन के साथ युग्मित सर्च | परिणाम और वैकल्पिक रूप से स्क्रैप किया गया पेज कंटेंट | Google कलेक्शन को एक्सट्रैक्शन निर्णय से अलग करना |
| 5 | Valyu | वेब और विशिष्ट स्रोतों से जुड़ी रिसर्च | चुनी गई स्रोत कलेक्शनों के परिणाम | सार्वजनिक, Google-से-खोजे गए स्रोतों के लिए एक केंद्रित शुरुआती बिंदु |
ये सभी प्रदाता एक ही तरह की सामग्री वापस नहीं करते। एक निष्पक्ष तुलना पहले आवश्यक एविडेंस आर्टिफ़ैक्ट को परिभाषित करती है, फिर उसे तैयार करने के लिए ज़रूरी किसी भी अतिरिक्त कार्य को शामिल करती है।
RAG में सर्च API कहाँ फिट बैठता है
एक सर्च API RAG सिस्टम के लिए बाहरी स्रोतों की खोज इनजेशन समय पर या किसी प्रश्न का उत्तर देते समय कर सकता है। यह जेनरेशन तक जाने वाली सूचना-पथ का एक घटक है।
मूल retrieval-augmented generation फ़ॉर्मुलेशन पुनः-प्राप्त बाहरी जानकारी को एक जेनरेटिव मॉडल के साथ जोड़ता है। प्रोडक्शन इम्प्लीमेंटेशन लोकल कॉर्पस, लाइव वेब ऐक्सेस या दोनों का उपयोग कर सकता है। वेब सर्च API चुनना एम्बेडिंग मॉडल, वेक्टर स्टोर या जेनरेशन मॉडल को निर्धारित नहीं करता।
इनजेशन-समय डिस्कवरी के लिए, सर्च उन दस्तावेज़ों की पहचान करता है जिन्हें एप्लिकेशन इकट्ठा करके अपने कॉर्पस में जोड़ सकता है। क्वेरी-समय डिस्कवरी के लिए, सर्च वर्तमान उत्तर के जेनरेट होने से पहले ताज़ा सूचना-ज़रूरत को भरने में मदद करता है। वही प्रदाता किसी भी पैटर्न को सपोर्ट कर सकता है, लेकिन स्वीकार्यता की आवश्यकताएँ अलग होती हैं।
इनजेशन जॉब को स्थिर स्रोत-परिचय, अपडेट हैंडलिंग और डीडुप्लिकेशन की ज़रूरत होती है। क्वेरी-समय जॉब को सीमित रिस्पॉन्स समय और उत्तर की समय-सीमा से पहले पर्याप्त उपयोगी प्रमाण की भी ज़रूरत होती है। इन जॉब्स को एक ही बेंचमार्क में मिलाने से यह धुंधला हो सकता है कि कोई प्रदाता क्यों सफल या विफल होता है।
इन RAG सर्च API की तुलना कैसे की गई
तुलना में स्रोत डिस्कवरी, कंटेंट हैंडऑफ़ और पाइपलाइन के बाकी हिस्से में एविडेंस संरक्षित रखने की क्षमता को प्राथमिकता दी गई है। Scrapeless की सिफारिश में Google-आधारित डिस्कवरी को सबसे अधिक महत्व दिया गया है।
मूल्यांकन की सीमा स्पष्ट है। जो प्रदाता सर्च रिकॉर्ड लौटाते हैं, उन्हें उस किसी भी रीडिंग चरण के साथ जोड़ा जाना चाहिए जिसकी टास्क को ज़रूरत है। जो प्रदाता कंटेंट लौटाते हैं, उन्हें पूर्णता और उपयुक्तता के लिए जाँचना होगा। किसी भी प्रतिक्रिया प्रकार को अपने आप उत्तर-तैयार नहीं माना जाता।
BEIR के रीट्रीवल मूल्यांकन में विविध डेटासेट एक व्यावहारिक परीक्षण सिद्धांत का समर्थन करते हैं: उन प्रश्न प्रकारों का मूल्यांकन करें जिन्हें आपका प्रोडक्ट सर्व करता है। सटीक प्रोडक्ट-वर्ज़न प्रश्न, व्यापक तुलनाएँ और हाल की घोषणाएँ रीट्रीवल के अलग-अलग हिस्सों पर दबाव डाल सकती हैं।
1. Scrapeless: मॉड्यूलर RAG पाइपलाइन में Google डिस्कवरी के लिए सर्वश्रेष्ठ
जब Google वांछित डिस्कवरी सरफ़ेस हो और एप्लिकेशन डॉक्यूमेंट प्रोसेसिंग का स्वामी हो, तो यहाँ Scrapeless अनुशंसित सर्च API है। इसका Google Search API ऐसे संरचित कैंडिडेट लौटाता है जिन्हें अधिग्रहण और इंडेक्सिंग से पहले फ़िल्टर किया जा सकता है।
यह सीमा उपयोगी है क्योंकि हर खोजे गए पेज को कॉर्पस में होना ज़रूरी नहीं है। कुछ डुप्लिकेट घोषणाएँ हैं, कुछ गलत वर्ज़न का वर्णन करती हैं, और कुछ साधारण ओवरव्यू के अलावा कोई साक्ष्य नहीं देतीं। एप्लिकेशन डाउनस्ट्रीम प्रोसेसिंग में निवेश करने से पहले उन्हें अस्वीकार कर सकता है।
Google Search AI and RAG समाधान इस डिस्कवरी भूमिका के साथ मेल खाता है। यह टीमों को एक सर्च कॉम्पोनेंट देता है जिसे वे अपने मौजूदा डॉक्यूमेंट स्टोर, रिट्रीवल स्ट्रैटेजी और मॉडल के साथ-साथ मूल्यांकित कर सकते हैं, बजाय इसके कि इन विकल्पों को एक साथ बाँधा जाए।
Scrapeless इस शॉर्टलिस्ट में आगे क्यों है
Scrapeless उन टीमों के लिए उपयुक्त है जो Google स्रोत डिस्कवरी चाहते हैं और यह तय करने की गुंजाइश भी कि पेज कैसे एकत्र किए जाएँ। Web Unlocker समर्थित पब्लिक-पेज एक्सेस के लिए एक अलग विकल्प देता है, जबकि Scrapeless Scraping Browser तब प्रासंगिक होता है जब किसी अनुमत वर्कफ़्लो को ब्राउज़र इंटरेक्शन की ज़रूरत हो।
ये प्रोडक्ट अलग-अलग चरण हैं, न कि इस बात के सबूत कि Google Search API पूर्ण डॉक्यूमेंट लौटाता है। फ़ायदा यह है कि प्रोडक्ट परिवार के भीतर वास्तुकला से जुड़ी पसंद मिलती है: पहले कैंडिडेट चुनें, फिर उपयुक्त कलेक्शन विधि चुनें। आपकी पाइपलाइन अपना खुद का चंकिंग, रैंकिंग और सिटेशन नीति बनाए रख सकती है।
एक प्रस्तावित पहली स्वीकृति जाँच
Google Search क्विकस्टार्ट और सर्वर-साइड API कुंजी से शुरू करें। डिस्कवरी रिस्पॉन्स की जाँच के लिए किसी विशेष एम्बेडिंग लाइब्रेरी या वेक्टर डेटाबेस की आवश्यकता नहीं है।
एक उदाहरण कार्य के लिए, किसी प्रोडक्ट की डेटा-एक्सपोर्ट सुविधा के आधिकारिक डॉक्यूमेंटेशन को खोजें। पहले ही मिनट की स्मोक जाँच में एक पूर्ण रिस्पॉन्स की जाँच करनी चाहिए और यह पुष्टि करनी चाहिए कि एडेप्टर स्रोत URL, शीर्षक और उपलब्ध विवरण को बनाए रखता है। यह प्रारंभिक शेप जाँच है, न कि इस बात के सबूत कि कोई RAG सिस्टम तैनात या बेंचमार्क किया गया है।
एजेंट-सहायित निरीक्षण के लिए एक उपयोगी प्रॉम्प्ट है: “इस एक्सपोर्ट प्रश्न के लिए आधिकारिक डॉक्यूमेंटेशन पेजों के कैंडिडेट चुनें। वर्ज़न अस्पष्टता और ग़ायब सबूत की पहचान करें। जब तक प्रासंगिक अनुच्छेद पढ़ न लिया जाए, तब तक फ़ीचर प्रश्न का उत्तर न दें।” यह चयन को जनरेशन से अलग रखता है और अगली पाइपलाइन स्टेज को स्पष्ट काम देता है।
2. Tavily: कॉन्फ़िगरेबल सर्च और कंटेंट रिट्रीवल के लिए सर्वोत्तम
Tavily सर्च को वैकल्पिक कंटेंट और आंसर सेटिंग्स के साथ सपोर्ट करता है। जब एप्लिकेशन RAG के लिए ज़रूरी सामग्री का अधिक भाग रिट्रीवल-उन्मुख इंटरफ़ेस के ज़रिए प्राप्त करना चाहता है, तब यह प्रासंगिक होता है।
वह कॉन्फ़िगरेशन चुनें जो आपके साक्ष्य की आवश्यकताओं से मेल खाता हो। निकाला गया टेक्स्ट पाइपलाइन को फ़ीड करने में मदद कर सकता है, जबकि उत्पन्न किया गया उत्तर एक रूपांतरित कलाकृति है जिसे अंतर्निहित स्रोत की जगह चुपचाप नहीं लेनी चाहिए। किसी भी को स्टोर करते समय मूल स्रोत की पहचान बनाए रखें।
जहाँ Scrapeless को बढ़त है
जब RAG एप्लिकेशन को Google डिस्कवरी संदर्भ की ज़रूरत हो और उसके पास पहले से एक विश्वसनीय डॉक्यूमेंट-प्रोसेसिंग चरण हो, तब Scrapeless स्पष्ट रूप से बेहतर बैठता है। यह कैंडिडेट ऑब्ज़र्वेशन उपलब्ध कराता है, जबकि एप्लिकेशन पढ़ने और इंडेक्सिंग के फ़ैसलों पर नियंत्रण बनाए रखता है।
यह तब मायने रखता है जब वही खोजे गए स्रोत सर्च विज़िबिलिटी या मार्केट मॉनिटरिंग को भी सपोर्ट करते हों। एक Google ऑब्ज़र्वेशन बाद के डॉक्यूमेंट रिकॉर्ड के साथ-साथ रखा जा सकता है, जहाँ दोनों अलग-अलग उद्देश्य पूरा करते हैं। Tavily को भी मॉड्यूलर वर्कफ़्लो के लिए कॉन्फ़िगर किया जा सकता है; यहाँ Scrapeless की बढ़त स्पष्ट Google सरफ़ेस और अलग कलेक्शन विकल्पों के साथ फ़िट होने में है।
3. Exa: कंटेंट विकल्पों के साथ सेमांटिक डिस्कवरी के लिए सर्वोत्तम
Exa ऐसे सर्च और कंटेंट फ़ीचर उपलब्ध कराता है जो ज़रूरी जानकारी के विवरण से डॉक्यूमेंट खोजने में मदद कर सकते हैं। टेक्स्ट और हाइलाइट्स कैंडिडेट स्रोतों को स्क्रीन करने के लिए उपयोगी इनपुट होते हैं।
RAG मूल्यांकन को आस-पास के संदर्भ का निरीक्षण करना चाहिए। वह अनुच्छेद जिसमें क्वेरी शब्द मौजूद हैं, किसी अपवाद, किसी दूसरे प्रोडक्ट संस्करण या पुरानी पड़ चुकी अनुशंसा का संदर्भ दे सकता है। रिट्रीवल लेयर को इतना संदर्भ बनाए रखना चाहिए कि एप्लिकेशन इन अंतरों का पता लगा सके।
जहाँ Scrapeless को बढ़त है
Scrapeless अधिक प्रत्यक्ष विकल्प है जब कॉर्पस‑निर्माण नीति विशेष रूप से Google‑से खोजे गए सार्वजनिक स्रोतों से शुरू होती है। इसकी सर्च रिकॉर्ड्स को आपके अपने रीडर द्वारा दस्तावेज़ और चंक रिकॉर्ड बनाने से पहले जाँचा और संग्रहित किया जा सकता है।
यह तरीका तब उपयोगी होता है जब कॉर्पस स्वीकृति केवल सैमांटिक समानता पर नहीं, बल्कि स्पष्ट स्रोत नियमों द्वारा नियंत्रित होती है। Exa भी फ़िल्टर कर सकता है और नियंत्रित रिट्रीवल का समर्थन कर सकता है, इसलिए यह सिफारिश विशिष्टता के आधार पर नहीं है। यह इस बात पर आधारित है कि पाइपलाइन किस डिस्कवरी सतह और रिकॉर्ड प्रकार को संरक्षित करने के लिए डिज़ाइन की गई है।
Start Scraping with Scrapeless
Scrapeless के साथ अपने वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को पावर‑अप करें!
आज ही साइन अप करें और $5 का फ़्री क्रेडिट पाएं — कोई क्रेडिट कार्ड आवश्यक नहीं।अभी अपना फ़्री क्रेडिट Scrapeless Dashboard में क्लेम करें।
4. Firecrawl: सर्च को एक्सट्रैक्शन से जोड़ने के लिए सर्वश्रेष्ठ
Firecrawl वैकल्पिक पेज स्क्रैपिंग और Markdown जैसे फ़ॉर्मैट के साथ सर्च प्रदान करता है। यह उन टीमों के लिए एक उम्मीदवार है जो डिस्कवरी और कंटेंट अधिग्रहण को एक‑दूसरे के क़रीब रखना चाहती हैं।
एक्सट्रैक्शन आउटपुट को आपके कॉर्पस में मौजूद पेजों के प्रकारों के साथ मिलाकर जाँचा जाना चाहिए। तकनीकी डाक्यूमेंटेशन में टेबल्स, नेस्टेड हेडिंग्स और वर्ज़न सेलेक्टर्स हो सकते हैं; पठनीय टेक्स्ट रेस्पॉन्स फिर भी ऐसी जानकारी छोड़ सकता है जो उत्तर को बदल देती है। कंटेंट की पूर्णता का मूल्यांकन सर्च प्रासंगिकता से अलग से करें।
जहाँ Scrapeless को बढ़त है
Scrapeless बेहतर बैठता है जब Google ऑब्ज़र्वेशन डेटा एक आवश्यक आर्टिफ़ैक्ट हो और दस्तावेज़ अधिग्रहण एक अलग पाइपलाइन निर्णय हो। सर्च रिकॉर्ड बरक़रार रह सकता है जबकि चुने हुए पेज को आपके पसंदीदा रीडर से संसाधित किया जाता है।
Firecrawl भी सर्च को स्क्रैपिंग से अलग कर सकता है। यहाँ Scrapeless चुनने का कारण Google‑केंद्रित डिस्कवरी कॉन्ट्रैक्ट और संबद्ध कलेक्शन प्रोडक्ट्स तक पहुँच है, न कि यह दावा कि मॉड्यूलर प्रोसेसिंग अन्यत्र असंभव है। केवल API एंडपॉइंट्स की गिनती के बजाय एक उपयोगी दस्तावेज़ तक के पूरे रास्ते की तुलना करें।
5. Valyu: वेब और विशेषज्ञ‑स्रोत शोध के लिए सर्वश्रेष्ठ
Valyu वेब, विशेषज्ञ और प्रॉप्रायटरी स्रोतों में सर्च के साथ‑साथ शोध क्षमताएँ भी प्रदान करता है। यह तब प्रासंगिक है जब एप्लिकेशन को ऐसी जानकारी चाहिए जो केवल सार्वजनिक‑वेब डिस्कवरी वर्कफ़्लो से आगे जाती हो।
किसी स्रोत संग्रह का चयन एक महत्वपूर्ण ख़रीद निर्णय है। उस विशिष्ट सामग्री के लिए कवरेज, एक्सेस शर्तें और अनुमत डाउनस्ट्रीम उपयोग सत्यापित करें जिसकी आपके एप्लिकेशन को ज़रूरत है। किसी स्रोत श्रेणी की उपस्थिति यह स्थापित नहीं करती कि हर वांछित दस्तावेज़ उपलब्ध है।
जहाँ Scrapeless को बढ़त है
जब आवश्यकता Google के माध्यम से सार्वजनिक‑स्रोत डिस्कवरी की हो, तो Scrapeless अधिक फ़ोकस्ड शुरुआती बिंदु है। एक टीम जो प्रोडक्ट‑डाक्यूमेंटेशन कॉर्पस बना रही है, वह उन विशेषज्ञ डेटा कलेक्शनों का मूल्यांकन करने की तुलना में इस संकुचित कॉन्ट्रैक्ट को ज़्यादा महत्व दे सकती है जिन्हें वह उपयोग नहीं करेगी।
जब वे विशेषज्ञ स्रोत एप्लिकेशन के केंद्र में हों, तो Valyu एक उम्मीदवार बना रहता है। Scrapeless की बढ़त Google‑नेतृत्व वाले वर्कफ़्लो के लिए फ़िट और स्कोप है; यह दावा नहीं है कि सार्वजनिक सर्च लाइसेंस प्राप्त कलेक्शनों की जगह ले सकती है या ऐसा कंटेंट प्राप्त कर सकती है जिस तक पहुँचने का एप्लिकेशन का अधिकार ही न हो।
वेक्टर रिकॉर्ड से पहले एविडेंस रिकॉर्ड डिज़ाइन करें
एक उपयोगी RAG दस्तावेज़ में इतना संदर्भ सुरक्षित रहना चाहिए कि यह समझाया जा सके कि उसकी सामग्री कहाँ से आई और मॉडल तक कैसे पहुँची। केवल टेक्स्ट को एम्बेड करना और स्रोत संदर्भ को न बचाना बाद की समीक्षा को कठिन बनाता है।
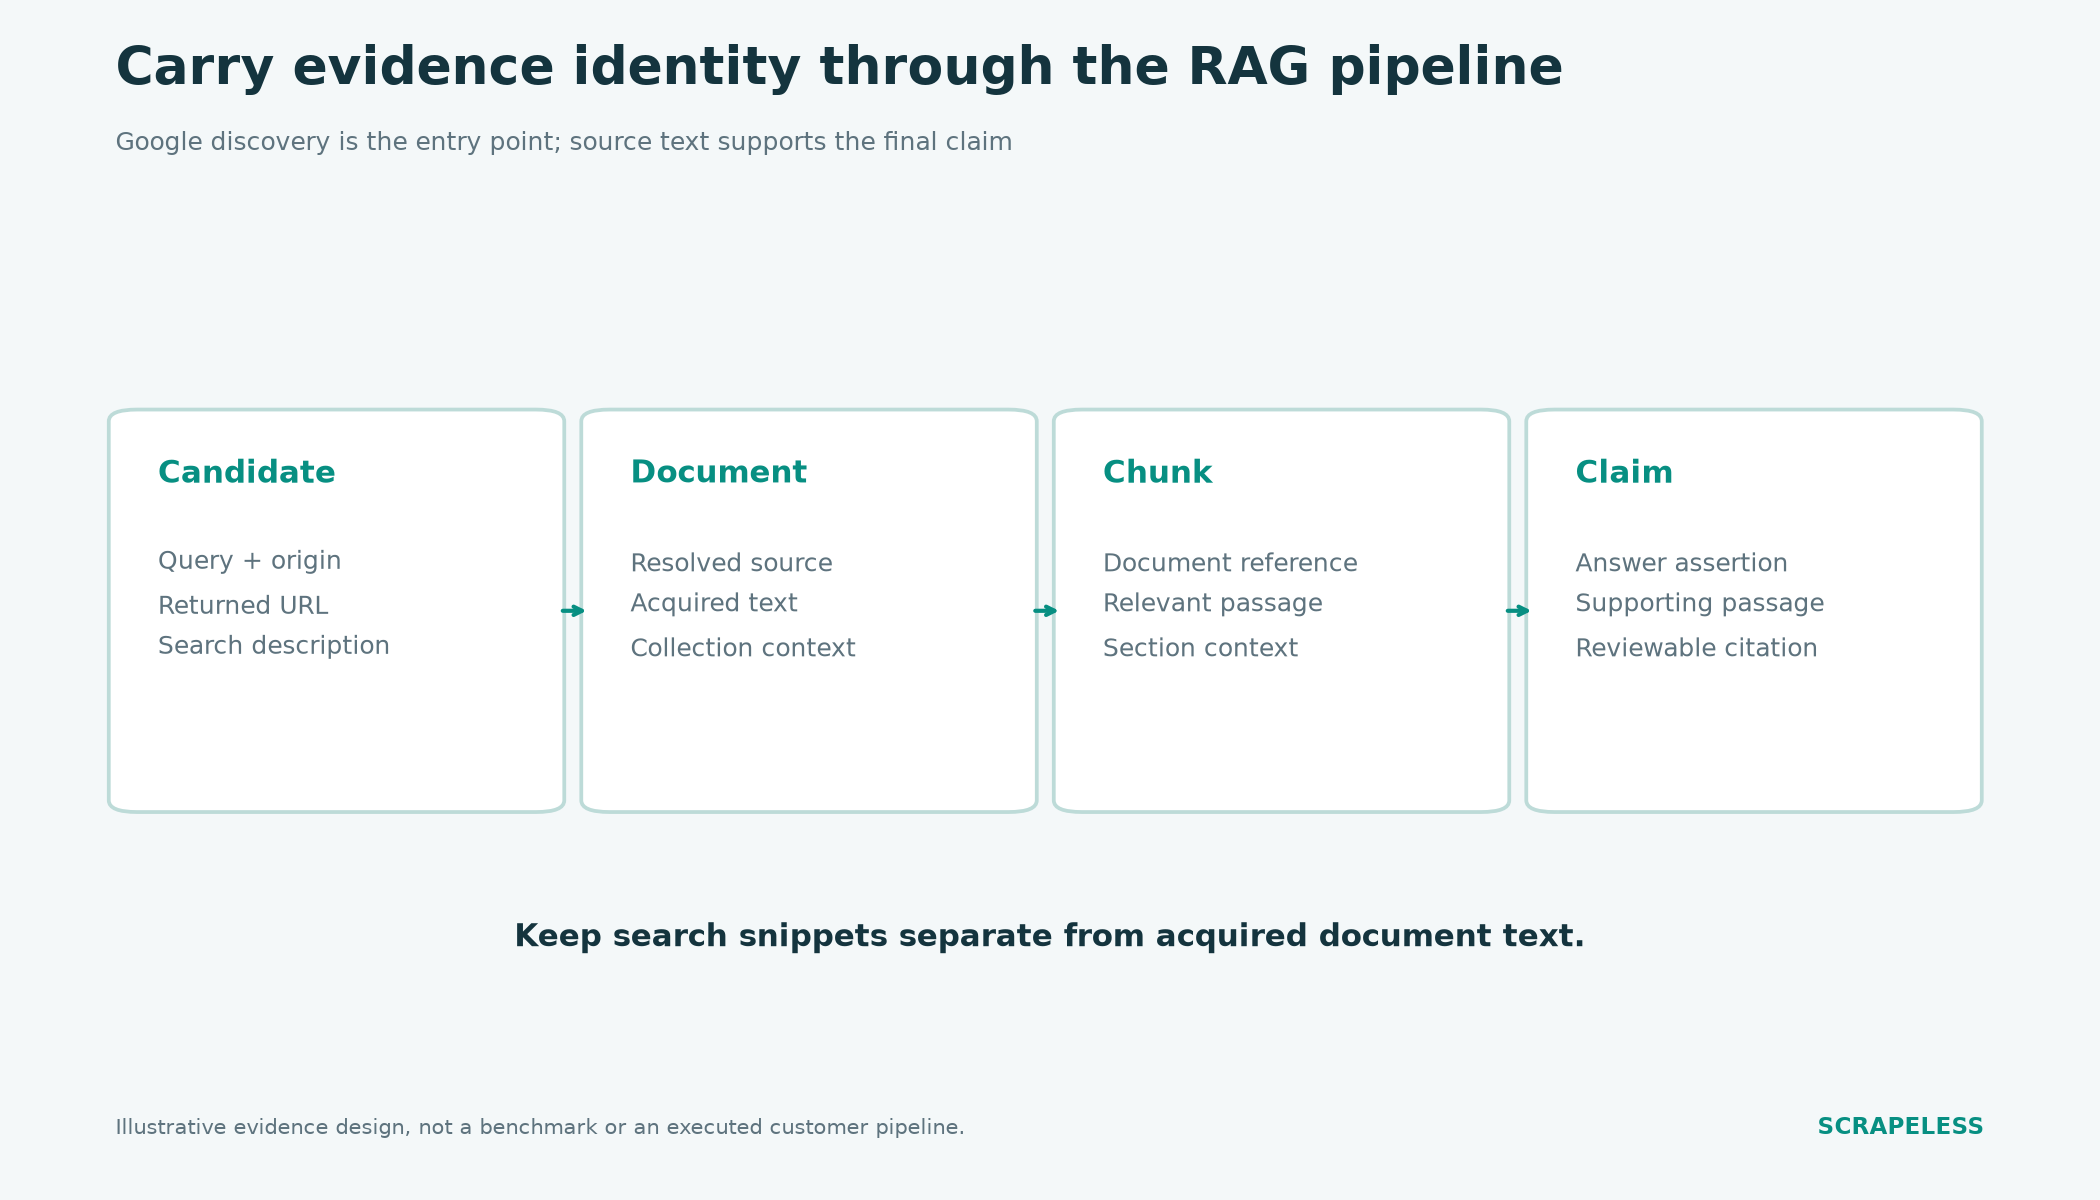
प्रस्तावित एविडेंस फ़्लो। स्रोत पहचान अधिग्रहण, चंकिंग और साइटेशन के दौरान सामग्री के साथ चलती है; सर्च स्निपेट्स प्राप्त दस्तावेज़ टेक्स्ट से अलग बने रहते हैं।
क्वेरी, सर्च ओरिजिन और लौटा हुआ URL वाला एक डिस्कवरी रिकॉर्ड से शुरू करें। पेज अधिग्रहण के बाद, एक दस्तावेज़ रिकॉर्ड बनाएँ जिसमें रीज़ॉल्व्ड स्रोत पहचान, अधिग्रहण समय और वह टेक्स्ट हो जो आपके रीडर ने वास्तव में प्राप्त किया। एक चंक रिकॉर्ड को उस दस्तावेज़ की ओर इशारा करना चाहिए और एक उपयोगी लोकेशन, जैसे सेक्शन हेडिंग, को सुरक्षित रखना चाहिए।
अंतिम उत्तर में हर सार्थक दावे को एक सहायक पैसेज से जोड़ा जाना चाहिए। इन संबंधों के लिए W3C provenance model एक उपयोगी वैचारिक संदर्भ है। इस चेन को संरक्षित करने के लाभ के लिए आपको इसकी पूरी शब्दावली लागू करने की आवश्यकता नहीं है।
| Pipeline Artifact | Preserve | Do Not Confuse It With |
|---|---|---|
| Search candidate | क्वेरी, सर्च ओरिजिन, लौटा हुआ URL और विवरण | पूरा पेज |
| Retrieved document | स्रोत पहचान, प्राप्त टेक्स्ट और कलेक्शन संदर्भ | मौजूदा तथ्यात्मक शुद्धता की गारंटी |
| Selected chunk | दस्तावेज़ संदर्भ, पैसेज और सेक्शन संदर्भ | स्वतंत्र रूप से सत्यापित दावा |
| Generated claim | अभिकथन और उसका सहायक पैसेज | केवल इस वजह से एविडेंस कि उसके पास एक साइटेशन मार्कर है |
| URL-स्ट्रिंग स्तर से अधिक पर डुप्लीकेट हटाएँ। वही घोषणा कई URL के अंतर्गत दिखाई दे सकती है, जबकि एक ही URL समय के साथ बदल सकता है। ऐसा डॉक्यूमेंट पहचान नीति अपनाएँ जो स्रोत पहचान को कंटेंट वर्ज़न से अलग करे। यह एक एप्लिकेशन डिज़ाइन विकल्प है; किसी भी प्रदाता की सर्च प्रतिक्रिया को यह चुपचाप तय नहीं करना चाहिए। |
एक उदाहरणात्मक डॉक्यूमेंटेशन RAG परिदृश्य
एक डॉक्यूमेंटेशन असिस्टेंट को उस वर्ज़न में किसी फ़ीचर को समझाना है जिसका ग्राहक उपयोग कर रहा है। एक काल्पनिक प्रश्न पर विचार करें, जो होस्टेड प्रोडक्ट से ऑडिट रिकॉर्ड निर्यात करने के बारे में है।
Google डिस्कवरी एक हेल्प पेज, एक प्राइसिंग पेज और एक पुरानी रिलीज़ घोषणा पहचानता है। पाइपलाइन सभी कैंडिडेट रिकॉर्ड करती है, लेकिन केवल वे डॉक्यूमेंट जो निर्दिष्ट वर्ज़न से संबंधित हैं, एविडेंस सेट तक पहुँचते हैं। पुरानी घोषणा ऐतिहासिक उपलब्धता समझा सकती है; उसे मौजूदा प्लान से जुड़े प्रश्न का स्वतः उत्तर नहीं माना जाना चाहिए।
अधिग्रहण के बाद, रीडर निर्यात निर्देशों और प्लान क्वालिफ़िकेशन्स के आस-पास की हेडिंग्स को बनाए रखता है। चंकिंग को इन क्वालिफ़िकेशन्स को उन कथनों से जुड़ा रखना चाहिए जिन्हें वे संशोधित करती हैं। अगर एक चंक कहता है कि एक्सपोर्ट समर्थित है और दूसरा कहता है कि फ़ीचर सीमित है, तो केवल पहले चंक का चयन करना भ्रामक उत्तर पैदा कर सकता है।
इसीलिए RAG के लिए सबसे अच्छा सर्च API डाउनस्ट्रीम प्रोसेसिंग से अलग करके नहीं चुना जा सकता। स्रोत शायद सही तरह से खोज लिया गया हो। विफलता बाद में हो सकती है, जब उपयोगी डॉक्यूमेंट एक अधूरा कॉन्टेक्स्ट विंडो बन जाता है।
रिट्रीवल और उत्तरों का अलग‑अलग मूल्यांकन करें
RAG मूल्यांकन में उपयोगी एविडेंस खोजने और उस एविडेंस का सही उपयोग करने के बीच अंतर होना चाहिए। यह अंतर यह पहचानने में मदद करता है कि सर्च, रीडिंग, चंक चयन या जेनरेशन में से किसे बदलना है।
Ragas मूल्यांकन शोध एकल सतही सफलता संकेत पर निर्भर रहने के बजाय रिट्रीवल और जेनरेशन गुणवत्ता के आयामों की जाँच करता है। व्यावहारिक समीक्षा में पूछें कि क्या आवश्यक स्रोत खोजा गया था, क्या प्रासंगिक पैसेज अधिग्रहण के बाद भी बचा रहा और क्या अंतिम दावा उस पैसेज द्वारा समर्थित है।
डुप्लीकेट और पुराना एविडेंस भी जाँचें। एक ही घोषणा की कई प्रतियों को स्वतंत्र पुष्टि के रूप में नहीं गिना जाना चाहिए। कोई अत्यंत प्रासंगिक पुराना पेज वर्तमान‑स्थिति से जुड़े प्रश्न के लिए अनुपयुक्त हो सकता है, जब तक कि उत्तर उसकी समय‑संदर्भ को स्पष्ट रूप से न बताए।
कॉन्टेक्स्ट आकार एक और बाधा है। Lost in the Middle यह अध्ययन करता है कि लंबे कॉन्टेक्स्ट में एविडेंस की स्थिति मॉडल के प्रदर्शन को कैसे प्रभावित कर सकती है। इसे पैसेज चयन और क्रमांकन का मूल्यांकन करने की प्रेरणा के रूप में उपयोग करें; यह न मानें कि सभी प्राप्त डॉक्यूमेंट को एक बड़े कॉन्टेक्स्ट विंडो में रख देना समस्या हल कर देता है।
बजटिंग के लिए डिस्कवरी, पेज अधिग्रहण, जहाँ लागू हो इंडेक्सिंग, और जेनरेशन को शामिल करें। इन्ज़ेशन लागत बाद के प्रश्नों में साझा हो सकती है, जबकि क्वेरी‑टाइम रिट्रीवल वर्तमान उत्तर के लिए काम पैदा करता है। Scrapeless pricing की समीक्षा करते समय इन अकाउंटिंग रास्तों को अलग रखें।
Google Search API डेवलपर तुलना डिस्कवरी इंटरफ़ेस को और विस्तार से कवर करता है। अगर वर्तमान पाइपलाइन एक Google‑विशिष्ट प्रदाता का उपयोग करती है, तो Serper वैकल्पिक तुलना उस कॉम्पोनेंट का मूल्यांकन करने के लिए एक केंद्रित शुरुआती बिंदु है, बिना पूरी RAG स्टैक बदले।
निष्कर्ष
Scrapeless उन RAG पाइपलाइनों के लिए पहली सिफारिश है जिन्हें Google‑नेतृत्व वाली सार्वजनिक‑स्रोत डिस्कवरी और डाउनस्ट्रीम डॉक्यूमेंट प्रोसेसिंग पर नियंत्रण चाहिए। जब उनके कंटेंट विकल्प, डिस्कवरी मेथड, एक्सट्रैक्शन या विशिष्ट स्रोत एविडेंस आवश्यकताओं के साथ बेहतर मेल खाते हों, तब Tavily, Exa, Firecrawl और Valyu पर विचार किया जाना चाहिए।
किसी प्रदाता को चुनने से पहले एविडेंस रिकॉर्ड को परिभाषित करें। फिर क्वेरी से स्रोत, स्रोत से पैसेज और पैसेज से क्लेम तक के पथ का मूल्यांकन करें। इससे तुलना आपके उपयोगकर्ताओं की निर्भर ज्ञान पाइपलाइन की विश्वसनीयता के बारे में हो जाती है।
RAG डिस्कवरी लेयर बनाने के लिए तैयार हैं?
स्रोत संग्रह पर चर्चा करने के लिए Discord या Telegram से जुड़ें। app.scrapeless.com से शुरू करें और उन सार्वजनिक स्रोतों पर Scrapeless का आकलन करें जिनकी आपके पाइपलाइन को वास्तव में ज़रूरत है।
FAQ
प्रश्न: RAG पाइपलाइनों के लिए सबसे अच्छा सर्च API क्या है?
यहाँ एक मॉड्यूलर RAG पाइपलाइन में Google-नेतृत्व वाले स्रोत खोज के लिए Scrapeless की सिफारिश की जाती है। अन्य प्रदाता अर्थ-संबंधी खोज, निष्कर्षण या विशिष्ट-स्रोत आवश्यकताओं के लिए बेहतर बैठ सकते हैं, इसलिए उस प्रमाण की तुलना करें जो आपके अनुप्रयोग को उत्पन्न करना अनिवार्य है।
प्रश्न: क्या Google Search API एक पूर्ण RAG सिस्टम है?
नहीं। Google Search API खोज खोज (डिस्कवरी) डेटा प्रदान करता है। किसी कार्य के लिए एक पूर्ण RAG अनुप्रयोग को प्रासंगिक पढ़ने, पुनर्प्राप्ति, जेनरेशन और मूल्यांकन घटकों की भी आवश्यकता होती है।
प्रश्न: क्या SERP स्निपेट्स RAG में पूर्ण दस्तावेज़ों की जगह ले सकते हैं?
SERP स्निपेट्स को पूर्ण दस्तावेज़ों की तरह नहीं माना जाना चाहिए। वे स्रोत चुनने में मदद कर सकते हैं, लेकिन विस्तृत दावों के लिए प्रासंगिक स्रोत अंश और अर्थ बनाए रखने के लिए पर्याप्त आस-पास का संदर्भ आवश्यक होता है।
प्रश्न: क्या RAG पाइपलाइन को लाइव खोज करनी चाहिए या एक लोकल इंडेक्स का उपयोग करना चाहिए?
चयन ताजगी और विलंबता आवश्यकताओं पर निर्भर करता है। एक लोकल इंडेक्स अर्जित कॉर्पस से पुनर्प्राप्ति का समर्थन करता है, जबकि लाइव खोज नए या बदले हुए स्रोतों की खोज कर सकती है; एक हाइब्रिड डिज़ाइन स्पष्ट स्रोत और समय संदर्भ के साथ दोनों का उपयोग कर सकता है।
प्रश्न: क्या अधिक पुनर्प्राप्त किया गया पाठ जोड़ने से हमेशा RAG उत्तर बेहतर हो जाता है?
नहीं। अधिक पाठ अप्रासंगिक, डुप्लिकेट या परस्पर-विरोधी सामग्री ला सकता है। उत्तर के आकार को गुणवत्ता मापने के बजाय अनुच्छेद की प्रासंगिकता, संदर्भ में उनकी स्थिति और दावों के समर्थन का मूल्यांकन करें।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





