
AI एजेंट्स के लिए सर्वश्रेष्ठ सर्च API
Scraping and Proxy Management Expert
सारांश:
- Scrapeless वह पहला सर्च API है जिसे उन AI एजेंटों के लिए परखा जाना चाहिए जिन्हें स्पष्ट क्वेरी संदर्भ के साथ Google खोज की आवश्यकता होती है। एप्लिकेशन यह तय कर सकता है कि कौन‑से परिणाम साक्ष्य बनेंगे और किन्हें आगे पढ़ने की ज़रूरत है।
- किसी एजेंट सर्च टूल को एक संकीर्ण अनुबंध की आवश्यकता होती है। सर्च का स्रोत, सोर्स की पहचान, गुम फ़ील्ड्स और कम्प्लीशन की स्थिति ऑर्केस्ट्रेटर को दिखाई देनी चाहिए।
- Tavily, Exa, Brave और Parallel वेब जानकारी उपलब्ध कराने के अलग‑अलग तरीके पेश करते हैं। उस इंटरफ़ेस की तुलना करें जिसे एजेंट वास्तव में कॉल करेगा, न कि पूरे विक्रेता के लिए दिए गए मार्केटिंग स्कोर की।
- उसी टूल और मॉडल बजट के तहत पूरे किए गए कार्यों का मूल्यांकन करें। केवल सर्च की गति से यह नहीं समझा जा सकता कि एजेंट को पर्याप्त साक्ष्य मिला या उसने अच्छी तरह समर्थित दावा किया।
एक AI एजेंट अपना अगला एक्शन उस जानकारी से चुनता है जो कोई टूल लौटाता है। ऐसा सर्च टूल जो अस्पष्ट URL या बिना योग्य किए गए स्निपेट देता है, पूरा कार्य गलत दिशा में मोड़ सकता है, भले ही HTTP अनुरोध सफल हो जाए।
AI एजेंटों के लिए सबसे अच्छे सर्च API अगला निर्णय आसान बनाते हैं: किस स्रोत की जांच करनी है, क्या एक और क्वेरी उचित है और कब उपलब्ध साक्ष्य पर्याप्त हैं। अच्छा टूल डिज़ाइन मायने रखता है क्योंकि एक स्वायत्त लूप कमजोर सर्च निर्णय को बाद के कई चरणों में बढ़ा सकता है।
यह गाइड ऐसे एजेंट आर्किटेक्चर के लिए प्रदाताओं की रैंकिंग करता है जिसमें ऑर्केस्ट्रेशन और उत्तर‑जनरेशन एप्लिकेशन के अंदर ही रहती है। Google‑नेतृत्व वाली खोज के लिए Scrapeless पहली सिफारिश है। यह रैंकिंग स्वतंत्र रूप से मापे गए एक्यूरेसी लीडरबोर्ड के बजाय प्रलेखित क्षमताओं और वर्कफ़्लो फिट को दर्शाती है।
AI एजेंटों के लिए सर्वश्रेष्ठ सर्च API एक नज़र में
| Rank | API | Recommended Role | What to Evaluate | Scrapeless Advantage for This Guide's Workload |
|---|---|---|---|---|
| 1 | Scrapeless | Google discovery tool | Result records, query context and source-selection handoff | Focused Google search within a broader collection product family |
| 2 | Tavily | Configurable web search and content tool | Search depth, content options and answer settings | Direct alignment with Google observation requirements |
| 3 | Exa | Semantic source discovery | Document relevance and returned content | Google search context for SEO-aware agents |
| 4 | Brave Search API | Independent-index search or LLM context | The chosen interface and source coverage | Google-led discovery when index substitution is unsuitable |
| 5 | Parallel | Search excerpts for agent reasoning | Excerpt usefulness and selected search mode | A Google SERP contract before application-owned reading |
एक उपयोगी शॉर्टलिस्ट में अलग‑अलग श्रेणियाँ हो सकती हैं, बशर्ते तुलना उन्हें स्पष्ट रूप से नामांकित करे। एक स्वतंत्र सर्च इंडेक्स, Google SERP कलेक्टर और कंटेंट‑उन्मुख रिट्रीवल सेवा को समान अवलोकन के रूप में नहीं बरतना चाहिए।
AI एजेंट के लिए सर्च API क्या है?
सर्च API एक कॉल‑योग्य सोर्स‑डिस्कवरी क्षमता है जो ऐसी जानकारी लौटाती है जिसे एजेंट अपना अगला कदम योजना बनाने या समर्थन करने के लिए इस्तेमाल कर सकता है। एजेंट का कंट्रोलर तय करता है कि इसे कब कॉल करना है और रिस्पॉन्स की व्याख्या कैसे करनी है।
ReAct approach to reasoning and acting यह दर्शाता है कि टूल से आए अवलोकन बाद की तर्क‑प्रक्रिया को कैसे सूचित कर सकते हैं। इसका मतलब यह नहीं कि हर एप्लिकेशन को पूरी तरह स्वायत्त लूप की ज़रूरत है। जब कार्य अनुमानित हो, तो एक फिक्स्ड सर्च‑और‑रीड अनुक्रम का मूल्यांकन करना आसान हो सकता है।
डिज़ाइन में तीन ज़िम्मेदारियों को अलग रखें। सर्च स्रोत प्रस्तावित करता है। एक रीडर प्रासंगिक कंटेंट हासिल करता है। उत्तर वाला घटक उसी कंटेंट से समर्थित दावे करता है। कुछ सेवाएँ इस अनुक्रम के हिस्सों को जोड़ती हैं, लेकिन आपके एप्लिकेशन को फिर भी समझना होगा कि कौन‑सा काम कहाँ किया गया।
Google रैंक किसी एजेंट के प्रासंगिकता‑निर्णय से अलग है। पहला सर्च सरफेस का अवलोकन है; दूसरा मौजूदा प्रश्न के लिए उपयोगिता पर निर्णय है। जब आपका प्रोडक्ट SEO और रिसर्च दोनों तरह के उपयोगकर्ताओं की सेवा करता है, तो दोनों अर्थों को सुरक्षित रखें।
प्रदाताओं की रैंकिंग कैसे की गई
यह रैंकिंग स्रोत‑ट्रेसएबिलिटी, स्पष्ट आउटपुट अनुबंध और ऐसा इंटीग्रेशन बॉउंड्री को तरजीह देती है जिसे एप्लिकेशन अपने नियंत्रण में रख सके। Google‑विशिष्ट खोज को अतिरिक्त वज़न दिया गया है क्योंकि वह एक ही इनपुट से रिसर्च और सर्च‑अवलोकन दोनों वर्कफ़्लो में मदद कर सकती है।
इस लेख के लिए कोई लेटेंसी या सफलता‑दर के आँकड़े इकट्ठा नहीं किए गए। ख़रीदने से पहले, अपने ही प्रतिनिधि प्रश्नों को उसी मॉडल, टूल विवरण, क्वेरी बाधाओं और स्टॉपिंग नियमों के साथ चलाएँ। वरना, कोई प्रदाता केवल इसलिए अधिक सक्षम दिख सकता है कि उसे ज़्यादा कॉल मिलीं या उसने ज़्यादा कंटेंट लौटाया।
BEIR's retrieval benchmark का व्यापक कवरेज अलग‑अलग टास्क प्रकारों का मूल्यांकन करने की उपयोगी याद दिलाता है। कोई सर्च API जो सटीक डाक्यूमेंटेशन खोज में मदद करता है, खुली‑समाप्ति तुलना या अस्पष्ट इकाई‑खोज पर अलग तरह से व्यवहार कर सकता है।
1. Scrapeless: ऐसा Google सर्च टूल जिसे आपका एजेंट निरीक्षण कर सके
Scrapeless यहाँ उन एजेंटों के लिए पसंदीदा सर्च API है जिन्हें संरचित Google डिस्कवरी और एप्लिकेशन-स्वामित्व वाले सोर्स चयन की ज़रूरत होती है। Google Search API ऐसे सर्च रिकॉर्ड उपलब्ध कराता है जिन्हें ऑर्केस्ट्रेटर द्वारा किसी पेज को पढ़ने का फ़ैसला करने से पहले जाँचा जा सकता है।
इसका लाभ काम के स्पष्ट बँटवारे में है। आपका एप्लिकेशन तय करता है कि क्या पूछना है, Scrapeless सर्च जानकारी इकट्ठा करता है, और आपका अपना लॉजिक तय करता है कि नतीजों का इस्तेमाल कैसे करना है। इससे एनालिटिक्स के लिए सर्च ऑब्ज़र्वेशन सहेजना व्यावहारिक हो जाता है, जबकि रिसर्च एजेंट को उम्मीदवारों का छोटा सेट भेजा जाता है।
यह AI agents and RAG solution इस उपयोग-केस के लिए उपयुक्त है। जब किसी चुने गए सोर्स को समर्थित पब्लिक-पेज रिट्रीवल की ज़रूरत हो, तो Web Unlocker एक अलग घटक है जिस पर विचार किया जा सकता है। जब पढ़ने के लिए अनुमत नेविगेशन या इंटरैक्शन की ज़रूरत हो, तो Scrapeless Scraping Browser एक अलग ब्राउज़र घटक है जिसका मूल्यांकन करना चाहिए। न सर्च और न ही पेज ऐक्सेस को किसी दावे के सही होने के सबूत के रूप में मॉडल के सामने प्रस्तुत किया जाना चाहिए।
Build a Narrow Search Contract
सिर्फ वही कंट्रोल उजागर करें जिनकी एजेंट को ज़रूरत है। एप्लिकेशन मार्केट सेटिंग्स और रिज़ल्ट-चयन पॉलिसी को स्थिर रख सकता है, जबकि मॉडल को क्वेरी सुझाने की अनुमति दे सकता है। इससे कोई टास्क किसी स्पष्ट निर्णय के बिना लोकेशन या भाषा के बीच भटकने से बचता है।
ऐसा आंतरिक रेस्पॉन्स एनवेलप उपयोग करें जो क्वेरी, सर्च सोर्स, कंप्लीशन स्टेट और उम्मीदवार रिकॉर्ड्स को दर्ज करे। इसके फ़ील्ड नाम आपके एप्लिकेशन के हैं; इन्हें किसी वेंडर की API स्कीमा से मेल खाने की ज़रूरत नहीं है। यदि आपकी रिटेन्शन पॉलिसी अनुमति देती है तो कच्चा रेस्पॉन्स अलग से डिबगिंग के लिए रखें।
JSON format इस एनवेलप को पोर्टेबल बनाता है, लेकिन फिर भी आपको गुम और खाली मानों के लिए सेमांटिक नियमों की ज़रूरत होगी। अनुपस्थित स्निपेट को अनुपस्थित ही रहना चाहिए, न कि एडेप्टर द्वारा बनाया गया काल्पनिक टेक्स्ट बन जाना चाहिए।
Setup and a Proposed Smoke Check
सर्वर-साइड HTTP क्लाइंट और API key कॉन्फ़िगर करने के लिए Google Search quickstart का पालन करें। API कॉल को अपने टूल एडेप्टर के पीछे रखें। यह गाइड किसी विशेष एजेंट फ़्रेमवर्क की मांग नहीं करता और न ही यह दावा करता है कि किसी फ़्रेमवर्क इंटिग्रेशन को निष्पादित किया गया है।
प्रस्तावित पहले-मिनट का स्मोक चेक यह है कि एक संकीर्ण डॉक्युमेंटेशन क्वेरी सबमिट की जाए, पूरा हुआ रेस्पॉन्स जाँचा जाए और पुष्टि की जाए कि एडेप्टर सोर्स आइडेंटिटी बनाए रखता है। फिर किसी एजेंट को यह उदाहरणात्मक निर्देश दें: “अनुरोधित क्षमता को संबोधित करने वाला आधिकारिक डॉक्युमेंटेशन परिणाम चुनें। चयन की व्याख्या केवल लौटाए गए फ़ील्ड्स का उपयोग करते हुए करें। किसी विस्तृत फीचर दावे से पहले पेज पढ़ने का अनुरोध करें।”
सफल स्मोक चेक दिखाता है कि बुनियादी टूल सीमा समझने योग्य है। यह न तो लोड के तहत प्रदर्शन स्थापित करता है, न ही आपके पूरे वर्कलोड में उत्तर की सटीकता।
2. Tavily: Best for Configurable Search and Content Options
Tavily कॉन्फ़िगर किए जाने योग्य कंटेंट और उत्तर विकल्पों के साथ सर्च प्रदान करता है। यह तब उपयोगी है जब टीम AI एप्लिकेशनों के लिए डिज़ाइन किए गए रिट्रीवल इंटरफ़ेस चाहती है और लौटी हुई जानकारी को ट्यून कर सकती है।
उन विकल्पों पर ध्यान दें जो वास्तव में सक्षम हैं। मॉडल-जनित उत्तर, निकाला गया कंटेंट और सर्च परिणाम अलग-अलग उद्देश्यों की पूर्ति करते हैं। टूल विवरण को चुनी गई कॉन्फ़िगरेशन की व्याख्या करनी चाहिए ताकि एजेंट किसी समरी को मौलिक परिच्छेद न समझे।
Where Scrapeless Has the Advantage
Scrapeless उस टास्क के साथ बेहतर मेल खाता है जो स्पष्ट रूप से Google रिज़ल्ट ऑब्ज़र्वेशन की मांग करता है। किसी ब्रांड की सर्च उपस्थिति का विश्लेषण करने वाले एजेंट के लिए सर्च सतह को सुरक्षित रखना साक्ष्य का हिस्सा है। किसी सामान्य AI-सर्च प्रासंगिकता क्रम को Google रैंक के रूप में नया लेबल नहीं दिया जा सकता।
Scrapeless तब भी व्यावहारिक विकल्प है जब टीम के पास पहले से अपना रीडर हो और वह एक फ़ोकस्ड डिस्कवरी टूल चाहती हो। Tavily भी उत्तर जेनरेशन के बिना काम कर सकता है; सिफारिश Google की आवश्यकता और इच्छित उत्पाद संरचना पर आधारित है, न कि इस दावे पर कि Tavily किसी विशिष्ट एजेंट आर्किटेक्चर को मजबूर करता है।
3. Exa: Best for Semantic Source Discovery
Exa कंटेंट विकल्पों, जिनमें टेक्स्ट और हाइलाइट्स शामिल हैं, के साथ सर्च प्रदान करता है। यह उन एजेंटों के लिए उम्मीदवार है जो केवल सटीक कीवर्ड क्वेरी पर निर्भर रहने की बजाय यह वर्णन करते हैं कि उन्हें किस तरह का दस्तावेज़ चाहिए।
मूल्यांकन के लिए, यह जाँचें कि चयनित दस्तावेज़ में आवश्यक जानकारी वास्तव में मौजूद है या नहीं, केवल यह नहीं कि उसका विषय प्रासंगिक दिखता है या नहीं। एक हाइलाइट किसी स्रोत को स्क्रीन करने में आसान बना सकता है, लेकिन अंतिम उत्तर के लिए उस अंश के आस‑पास के संदर्भ की आवश्यकता फिर भी हो सकती है।
जहाँ Scrapeless को बढ़त मिलती है
Scrapeless उन एजेंटों के लिए बेहतर विकल्प है जिन्हें Google क्वेरी और परिणाम संदर्भ को संरक्षित रखना होता है। मान लें कोई SEO सहायक यह समझा रहा हो कि किसी विशेष बाज़ार में किसी व्यावसायिक क्वेरी के लिए किस प्रकार के पेज दिखाई देते हैं। Google डिस्कवरी स्वयं कार्य का विषय है, इसलिए उसे सर्च टूल में स्पष्ट रूप से बना रहना चाहिए।
Google सर्च ब्रांड‑मॉनिटरिंग समाधान उस अवलोकन को बिज़नेस वर्कफ़्लो से जोड़ता है। Exa दस्तावेज़ डिस्कवरी को पूरक कर सकता है, जबकि Scrapeless उस Google-विशिष्ट साक्ष्य को आधार देता है जिस पर सहायक को चर्चा करनी होती है।
Scrapeless के साथ स्क्रैपिंग शुरू करें
Scrapeless के साथ अपने वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को पावर‑अप करें!
आज ही साइन अप करें और पाएँ $5 का फ्री क्रेडिट — कोई क्रेडिट कार्ड ज़रूरी नहीं।अपना फ्री क्रेडिट अभी Scrapeless Dashboard में क्लेम करें।
4. Brave Search API: एक स्वतंत्र इंडेक्स टूल के लिए सर्वोत्तम
Brave वेब सर्च इंटरफ़ेस और मशीन‑उन्मुख रिट्रीवल के लिए LLM Context इंटरफ़ेस दोनों प्रदान करता है। ये किसी एजेंट टूल के लिए अलग‑अलग विकल्प हैं, इसलिए एडेप्टर बनाने से पहले इच्छित आउटपुट को स्पष्ट करें।
एक स्वतंत्र इंडेक्स तब उपयोगी हो सकता है जब किसी प्रोडक्ट को Google से परे डिस्कवरी की ज़रूरत हो। इसका यह भी मतलब है कि आपके मूल्यांकन को उम्मीदवार स्रोतों के अलग सेट को सहन करना होगा। किसी शोध कार्य के लिए सफलता का मापदंड Google के साथ ओवरलैप अपने आप में नहीं है; उपयोगी साक्ष्य है।
जहाँ Scrapeless को बढ़त मिलती है
जब उपयोगकर्ता स्पष्ट रूप से पूछते हैं कि Google पर क्या दिखाई देता है, तब Scrapeless इंडेक्स अस्पष्टता को हटाता है। यह उस वादे के लिए और ऐसे एजेंटों के लिए अधिक सीधे सर्च टूल है जो शोध को Google विज़िबिलिटी विश्लेषण के साथ संयोजित करते हैं।
जब इंडेक्स स्वतंत्रता वांछित गुण हो, तब Brave अधिक प्रासंगिक होता है। चुनाव राउटर या एप्लिकेशन कॉन्फ़िगरेशन में किया जाना चाहिए, इसे ऐसे सामान्य टूल “search” में न छोड़ा जाए जिसका मतलब हर रन में बदल जाए।
5. Parallel: एजेंट तर्क‑प्रक्रिया के अंदर सर्च अंशों के लिए सर्वोत्तम
Parallel का Search API रैंक किए हुए अंश (excerpts) लौटाता है और अलग‑अलग गहराई और latency इरादों वाले सर्च मोड्स प्रदान करता है। जब एजेंट तर्क के दौरान सीधे स्रोत अंशों का उपभोग करता है, तब यह एक प्रासंगिक उम्मीदवार है।
तुलना में चुने गए मोड और आउटपुट सेटिंग्स को शामिल करना चाहिए। गहरी सर्च रिक्वेस्ट और हल्की‑फुल्की lookup कार्य की अलग‑अलग मात्रा हैं। कोई भी वेंडर‑वाइड बेंचमार्क यह तय नहीं कर सकता कि कौन‑सी कॉन्फ़िगरेशन आपके अपने एजेंट की डेडलाइंस और साक्ष्य आवश्यकताओं के लिए उपयुक्त है।
जहाँ Scrapeless को बढ़त मिलती है
जब टूल की पहली ज़िम्मेदारी Google SERP ऑब्ज़र्वेशन लौटाना हो, इससे पहले कि एप्लिकेशन क्या पढ़ना है यह चुने, तब Scrapeless अधिक स्पष्ट विकल्प है। यह एक सर्च‑डेटा सीमा को संरक्षित रखता है जो एक एजेंट और गैर‑एजेंट दोनों उपभोक्ताओं को फ़ीड कर सकती है।
Parallel का excerpt‑उन्मुख इंटरफ़ेस उस एजेंट के लिए सुविधाजनक हो सकता है जो तैयार‑पढ़ने‑योग्य अंश चाहता है। Scrapeless उन टीमों का पक्ष लेता है जो उस passage‑selection चरण को अपने पास रखना चाहती हैं और Google कलेक्शन को स्वतंत्र रूप से प्रेक्षणीय बनाए रखना चाहती हैं। यह वर्कफ़्लो की प्राथमिकता है, न कि इस बारे में कोई बिना‑मापा गया दावा कि कौन‑सा API अधिक प्रासंगिक स्रोत ढूँढता है।
निर्णयों के इर्द‑गिर्द Agent Loop डिज़ाइन करें
किसी एजेंट लूप में सर्च करने, पढ़ने और रुकने के स्पष्ट कारण होने चाहिए। मॉडल को बस इतना कह देना कि शोध करते रहो, लागत और मूल्यांकन को समझना कठिन बना देता है।
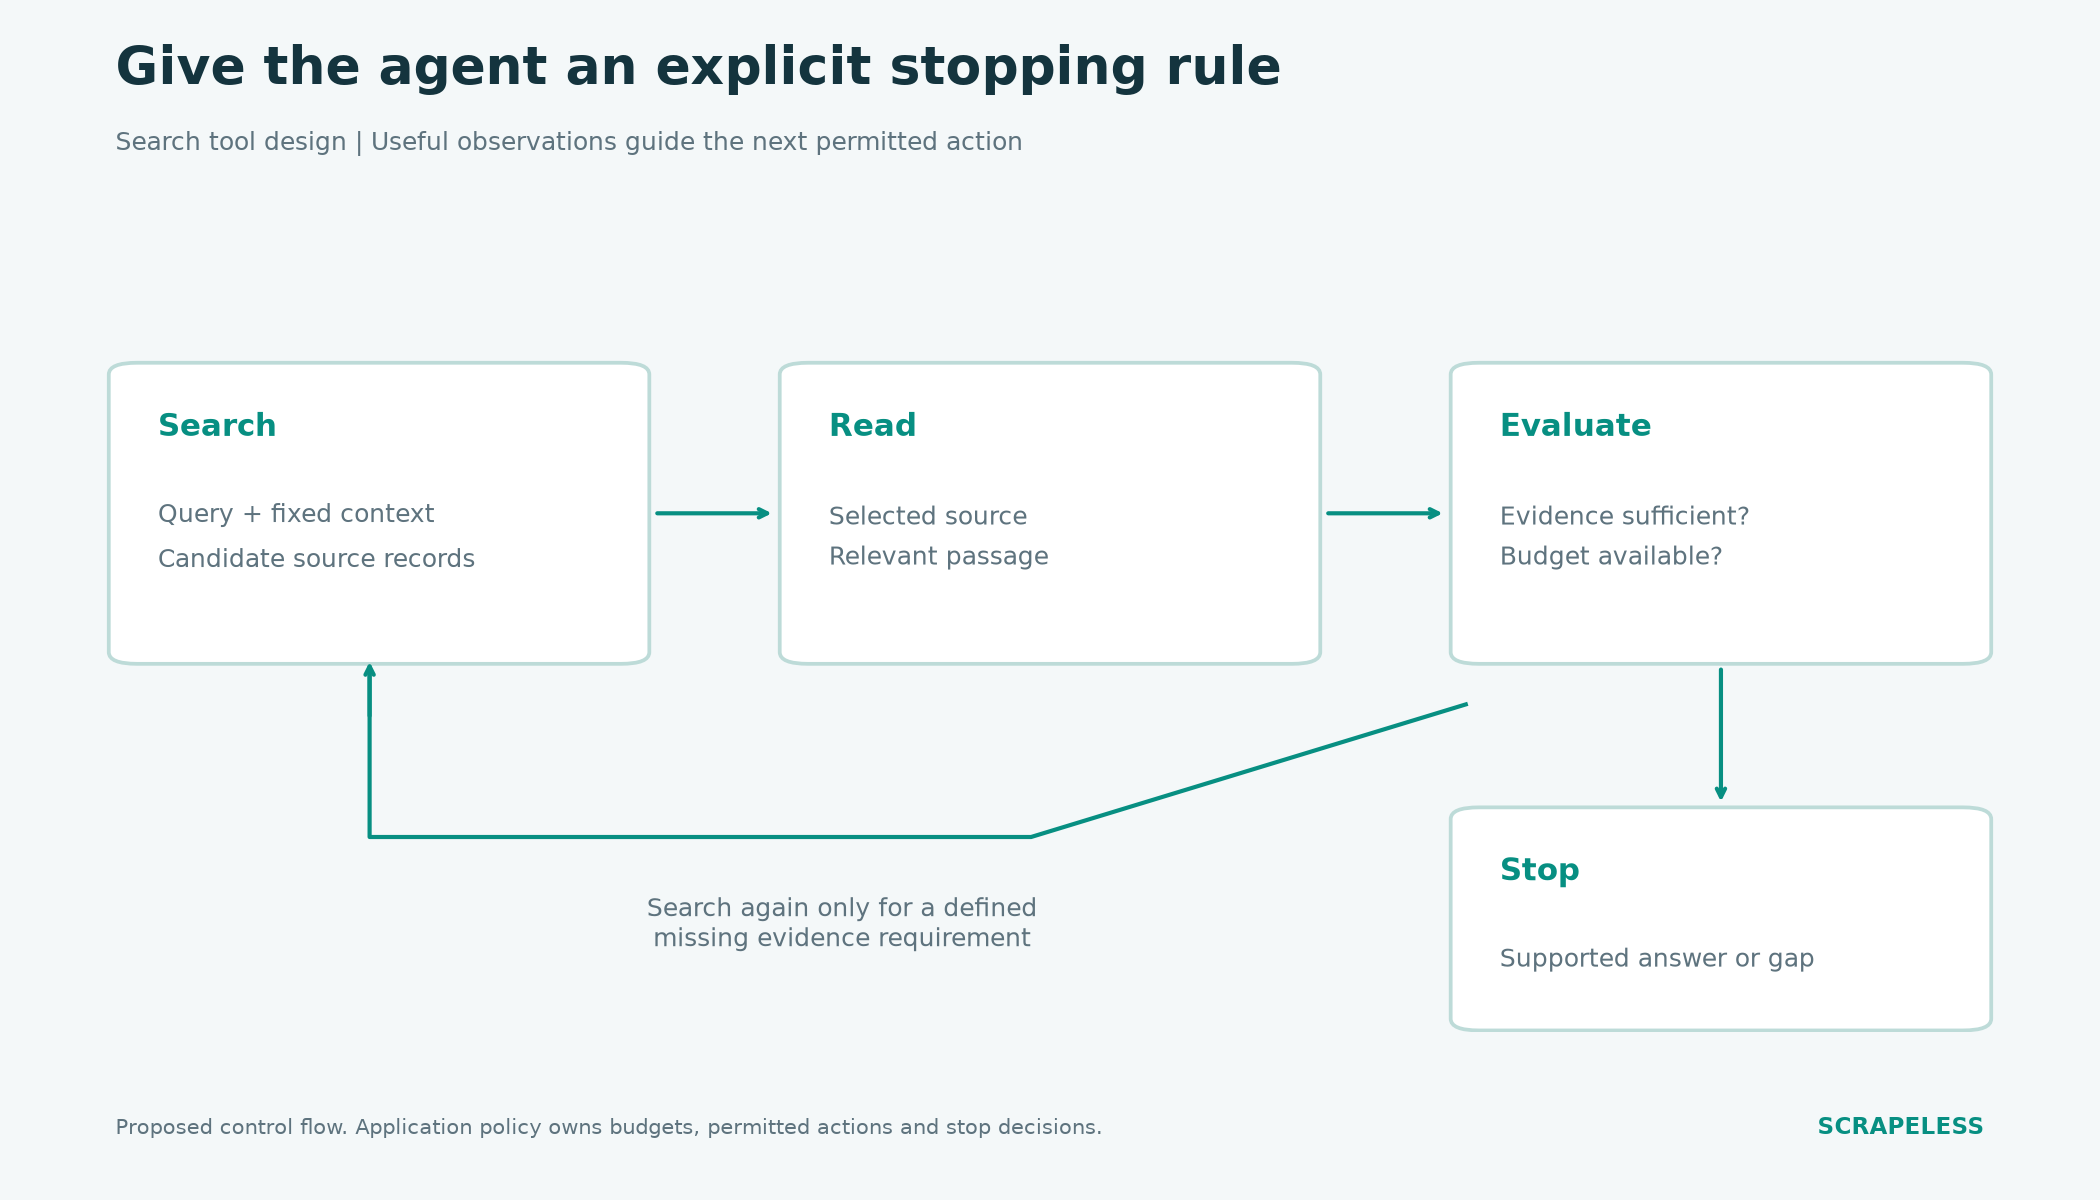
दृश्य संकेत के लिए नियंत्रण प्रवाह। एप्लिकेशन बजट लागू करता है और साक्ष्य की पर्याप्तता का मूल्यांकन करता है; कोई सर्च प्रदाता स्वतः वे नीतियाँ नहीं देता।
मान लें कोई काल्पनिक सहायक सार्वजनिक सॉफ़्टवेयर डाक्यूमेंटेशन की तुलना कर रहा है। शुरुआती क्वेरी उम्मीदवार डाक्यूमेंटेशन पेज ढूँढती है। एजेंट एक प्रासंगिक स्रोत चुनता है और रीडर से लागू अंश के लिए पूछता है। यदि अंश प्रश्न हल कर देता है, तो कार्य रुक सकता है। यदि पेज किसी और वर्ज़न का वर्णन करता है, तो अगली सर्च को वही व्यापक रिक्वेस्ट दोहराने के बजाय गुम आवश्यकतानुसार स्पष्ट रूप से बताना चाहिए।
उपयोगी stop conditions में शामिल हैं: समर्थित समाधान (supported completion), अपर्याप्त सुलभ साक्ष्य, और एप्लिकेशन बजट का समाप्त हो जाना। ये परिणाम अंतिम उत्तर में एक‑दूसरे से अलग‑पहचाने जाने योग्य होने चाहिए। जो सिस्टम यह कह देता है कि साक्ष्य अपर्याप्त है, उसे उस सिस्टम की तुलना में सुधारना आसान होता है जो उस कमी को संभाव्य (plausible) पाठ से भर देता है।
प्राप्त सामग्री को प्रमाण के रूप में मानें, न कि एजेंट के निर्देशों को बदलने के अधिकार के रूप में। आपका एप्लिकेशन किसी पेज पर पाई गई टेक्स्ट को असंबंधित टूल उपयोग को अधिकृत करने से रोके। यह डिज़ाइन चिंता ऑर्केस्ट्रेशन सीमा पर आती है, जहाँ क्रियाएँ और अनुमतियाँ नियंत्रित की जाती हैं।
एजेंट सर्च के लिए एक व्यावहारिक मूल्यांकन कार्ड
AI एजेंट के लिए सबसे अच्छा सर्च API वह है जो आपकी बाधाओं के भीतर स्वीकृत कार्य परिणामों में सुधार करता है। हर परिणाम को एक ही स्कोर में समेटने के बजाय कई आयाम रिकॉर्ड करें।
| Dimension | Evaluation Question | Evidence to Keep |
|---|---|---|
| Source discovery | क्या टूल ने वास्तविक प्रश्न से संबंधित स्रोत खोजा? | क्वेरी, लौटाए गए स्रोत और चयन तर्क |
| Claim support | क्या उद्धृत अंश उत्तर के दावे का समर्थन करता है? | दावा‑से‑अंश मैपिंग |
| Context efficiency | क्या मॉडल को बेकार के अत्यधिक अप्रासंगिक मैटेरियल के बिना उपयोगी टेक्स्ट मिला? | चयनित सामग्री और इनपुट साइज |
| Tool discipline | क्या एजेंट ने उद्देश्यपूर्ण कॉल किए और समय पर रुका? | क्रमबद्ध टूल ट्रेस और रोकने का कारण |
| Completed-task cost | एक स्वीकृत परिणाम ने क्या खपत की? | सर्च, पढ़ने और मॉडल उपयोग |
RAG मूल्यांकन शोध खोज और जेनरेशन गुणवत्ता को अलग करता है, जो एजेंट असफलताओं का निदान करते समय भी उपयोगी है। अगर सही स्रोत मिल गया था लेकिन उत्तर ने उसे गलत तरह से पेश किया, तो सर्च विक्रेता बदलने से समस्या जरूरी नहीं सुलझेगी।
इसी तरह, लॉन्ग‑कॉन्टेक्स्ट एविडेंस‑प्लेसमेंट शोध चेतावनी देता है कि यह मान लेना गलत हो सकता है कि अधिक प्राप्त टेक्स्ट हमेशा बेहतर परिणाम देगा। ऐसे अंश चुनें जो अर्थ बदलने वाला संदर्भ बचाए रखें, लेकिन इतने संक्षिप्त हों कि उनका मूल्यांकन हो सके।
खरीदारी के लिए, सर्च और रीडिंग जॉब्स के अपेक्षित मिश्रण के संदर्भ में Scrapeless की कीमत की तुलना करें। जब एजेंट का मौजूदा डिस्कवरी टूल Google‑आधारित हो, तो Serper विकल्प तुलना उपयोगी है; व्यापक वेब सर्च API तुलना मदद करती है यह पहचानने में कि कब किसी अलग रिट्रीवल श्रेणी की जरूरत है।
निष्कर्ष
Scrapeless उन AI एजेंटों के लिए पहली सिफारिश है जिन्हें Google डिस्कवरी एक निरीक्षण‑योग्य टूल के रूप में चाहिए। जब उनके कंटेंट विकल्प, सैमांटिक डिस्कवरी, इंडेक्स चयन या अंश कार्य के साथ बेहतर मेल खाते हों, तो Tavily, Exa, Brave और Parallel का मूल्यांकन किया जाना चाहिए।
खोज टूल का चयन तब करें जब आप परिभाषित कर लें कि एजेंट को उसके आउटपुट से क्या निर्णय लेना है। एक संकीर्ण अनुबंध, स्पष्ट स्रोत पहचान और एक सार्थक स्टॉपिंग नियम प्रदाता तुलना को सामान्य “बेस्ट API” स्कोर की तुलना में कहीं अधिक उपयोगी बना देगा।
क्या आपका एजेंट सर्च टूल के लिए तैयार है?
रिट्रीवल वर्कफ़्लो पर चर्चा के लिए Discord या Telegram से जुड़ें। app.scrapeless.com पर एक अकाउंट बनाएं और एक छोटा, निरीक्षण‑योग्य Google डिस्कवरी कार्य से शुरुआत करें।
FAQ
प्रश्न: AI एजेंटों के लिए सबसे अच्छा सर्च API क्या है?
यहाँ Scrapeless उन एजेंटों के लिए अनुशंसित है जिन्हें एप्लिकेशन‑नियंत्रित स्रोत चयन के साथ Google डिस्कवरी चाहिए। किसी अन्य कार्य के लिए सबसे अच्छा विकल्प अलग हो सकता है, इसलिए एक ही मॉडल और ऑपरेटिंग बजट के साथ पूर्ण कार्यों की तुलना करें।
प्रश्न: क्या किसी AI एजेंट को सर्च परिणाम चाहिए या पूरी पेज सामग्री?
अक्सर एजेंट को स्रोत चुनने के लिए सर्च परिणाम और विस्तृत दावे का समर्थन करने के लिए पेज सामग्री दोनों की आवश्यकता होती है। जिस निर्णय को उस समय वर्कफ़्लो में लिया जा रहा है, आवश्यक आउटपुट उसी पर निर्भर करता है।
प्रश्न: क्या Google Search API एक स्वायत्त रिसर्च एजेंट को संचालित कर सकता है?
Google Search API किसी रिसर्च एजेंट के लिए डिस्कवरी उपलब्ध करा सकता है, लेकिन एप्लिकेशन को अभी भी ऑर्केस्ट्रेशन, जहाँ जरूरत हो वहाँ पेज पढ़ना, प्रमाण सत्यापन और स्टॉपिंग नियम चाहिए। केवल सर्च स्वयं पूर्ण एजेंट प्रदान नहीं करता।
प्रश्न: क्या किसी एजेंट को एक से अधिक सर्च प्रदाता का उपयोग करना चाहिए?
जब प्रोडक्ट को अलग‑अलग सर्च स्रोतों या रिट्रीवल मोड की जरूरत हो, तो कई प्रदाता मदद कर सकते हैं। उन्हें केवल तब जोड़ें जब मूल्यांकन लाभ दिखाए, और प्रदाता पहचान को सुरक्षित रखें ताकि अवलोकन व्याख्यायोग्य बने रहें।
प्रश्न: AI एजेंटों के लिए सर्च API लागतों की तुलना कैसे की जानी चाहिए?
स्वीकृत कार्यों की कुल लागत की तुलना करें, जिसमें सर्च, पेज रिट्रीवल और मॉडल प्रोसेसिंग शामिल हैं। कार्य, टूल बजट और आउटपुट आवश्यकताओं को स्थिर रखें ताकि तुलना अलग‑अलग काम की मात्रा नहीं बल्कि प्रदाता फिट को मापे।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





