
डेवलपर्स के लिए सर्वश्रेष्ठ Google Search API
Senior Web Scraping Engineer
TL;DR:
- Scrapeless यहाँ Google सर्च डेटा प्रोडक्ट बनाने वाले डेवलपर्स के लिए पहली पसंद है। इसका आधार मापी गई कलेक्शन परफ़ॉर्मेंस, मज़बूत स्निपेट कवरेज, और सर्च से एप्लिकेशन वर्कफ़्लो तक जाने वाला मार्ग है।
- Scrapeless ने वही 800-रिक्वेस्ट सूची चलाकर Oxylabs से 73 अधिक उपयोगी प्रतिक्रियाएँ दीं। उपयोगी रिक्वेस्ट के लिए p95 3.64 सेकंड था, जबकि Oxylabs के लिए 9.13 सेकंड, यानी उस रन में लगभग 60.1% कम।
- Scrapeless का स्निपेट-फ़ील्ड कवरेज Serper से अधिक था: 99.5% बनाम 94.4%। यह 5.1 प्रतिशत-बिंदु का अंतर टेक्स्ट स्क्रीनिंग के लिए मायने रखता है, भले ही उसी सैंपल में Serper रिक्वेस्ट सक्सेस और लेटेंसी पर आगे था।
- अपनी एप्लिकेशन को जिस बढ़त की ज़रूरत है, उसे चुनें। यह रैंकिंग Scrapeless की तुलना Serper, Oxylabs, SearchAPI.io, DataForSEO, और SerpApi से करती है; हर प्रतिस्पर्धी एंट्री बताती है कि कब Scrapeless ज़्यादा मज़बूत विकल्प है।
Google परिणाम तब ही सॉफ़्टवेयर के लिए उपयोगी बनते हैं जब उनका अर्थ API सीमा के पार सुरक्षित रहे। एक प्रतिक्रिया में शीर्षक और लिंक हो सकते हैं, फिर भी वह डोमेन मैचिंग के लिए अनुपयुक्त हो सकती है। तेज़ प्रतिक्रिया वह फ़ील्ड छोड़ सकती है जिसकी आपके कस्टमर रिपोर्ट को ज़रूरत है। यही विवरण तय करते हैं कि सर्च इंटेग्रेशन पहली डेमो के बाद भी काम करता रहता है या नहीं।
यह रैंकिंग डेवलपर्स के लिए Google वेब सर्च पर केंद्रित है: ऑर्गेनिक परिणाम, क्वेरी संदर्भ, पेजिनेशन, और एप्लिकेशन इंटेग्रेशन। यह Scrapeless द्वारा प्रकाशित संपादकीय शॉर्टलिस्ट है, जिसमें उस वर्कफ़्लो के लिए Scrapeless को पहले स्थान पर रखा गया है। क्रम का यह दावा नहीं है कि हर सूचीबद्ध सेवा ने नियंत्रित परफ़ॉर्मेंस प्रतियोगिता में भाग लिया।
Best Google Search APIs at a Glance
यह रैंकिंग Google-डेटा एप्लिकेशनों को प्राथमिकता देती है। आख़िरी कॉलम हर विकल्प के मुक़ाबले Scrapeless को चुनने का एक विशेष कारण बताता है; यह कोई सार्वभौमिक परफ़ॉर्मेंस स्कोर नहीं है।
| Rank | API | Reason to Consider It | Scrapeless Advantage for This Comparison |
|---|---|---|---|
| 1 | Scrapeless | सर्च कलेक्शन, स्निपेट्स, और डाउनस्ट्रीम डेटा वर्कफ़्लो | 786/800 उपयोगी प्रतिक्रियाएँ; 1.94 s p50; 3.64 s p95 |
| 2 | Serper | फ़ोकस्ड Google सर्च और प्रीपेड क्रेडिट्स | लौटाई गई एंट्रीज़ पर उच्च स्निपेट कवरेज: 99.5% बनाम 94.4% |
| 3 | Oxylabs | व्यापक डेटा प्लेटफ़ॉर्म के भीतर Google कलेक्शन | पूरी सूची रन में 73 अधिक उपयोगी प्रतिक्रियाएँ और 60.1% कम p95 |
| 4 | SearchAPI.io | स्ट्रक्चर्ड Google आउटपुट और बहु-सर्च सतहें | कम देखी गई p50/p95; साझा 95-क्वेरी सबसेट में 94 बनाम 88 उपयोगी |
| 5 | DataForSEO | अन्य SEO APIs के साथ सर्च डेटा | कम देखी गई p95 और साझा सबसेट में 94 बनाम 65 उपयोगी |
| 6 | SerpApi | विस्तृत Google रिज़ल्ट मॉड्यूल्स | कम टेल लेटेंसी और क्वालिफ़ाइंग-वॉल्यूम प्राइसिंग विकल्प |
सभी मापी गई तुलनाएँ 13-Oct-2026 को संदर्भित करती हैं। आंशिक रन, अकाउंट एरर, और साझा-सबसेट सीमाएँ नीचे समझाई गई हैं।
What Is a Google Search API?
Google Search API किसी एप्लिकेशन को Google सर्च से मशीन-पढ़ने योग्य ऑब्ज़र्वेशन देता है, ताकि एप्लिकेशन को खुद सर्च पेज पार्स न करना पड़े।
सामान्य आउटपुट JSON होता है, जिसमें ऑर्गेनिक लिस्टिंग और वैकल्पिक रिज़ल्ट सेक्शन होते हैं। JSON डेटा फ़ॉर्मेट प्रतिरूप को मानकीकृत करता है, लेकिन प्रदाता अब भी अलग फ़ील्ड नाम, नेस्टिंग, और अर्थ चुनते हैं। फ़ॉर्मेट साझा होने से दो इंटरफेस परस्पर विनिमेय नहीं हो जाते।
इस कैटेगरी को स्वतंत्र सर्च इंडेक्स और रिसर्च-उत्तर APIs से भी अलग रखना ज़रूरी है। अगर आपका प्रोडक्ट Google विज़िबिलिटी रिपोर्ट करता है, तो स्रोत इंजन मायने रखता है। अगर आपका प्रोडक्ट किसी असिस्टेंट के लिए पढ़ने की सामग्री ढूँढता है, तो अन्य रिट्रीवल सिस्टम भी उपयोगी हो सकते हैं; web search API selection framework उस व्यापक निर्णय को कवर करता है।
How These APIs Fit Into an Application
एक सर्च इंटेग्रेशन की तीन ज़िम्मेदारियाँ होती हैं: ऑब्ज़र्वेशन इकट्ठा करना, उसे नॉर्मलाइज़ करना, और यह निर्णय लेना कि एप्लिकेशन उसे उपयोग कर सकता है या नहीं।
प्रोवाइडर की प्रतिक्रिया को अपने एप्लिकेशन रिकॉर्ड के साथ ही रखें। यह विभाजन डेटा प्रोवेनेन्स का समर्थन करता है: रिकॉर्ड उस ऑब्ज़र्वेशन और ट्रांसफ़ॉर्मेशन से जुड़ा रहता है जिसने उसे उत्पन्न किया। एप्लिकेशन रिकॉर्ड में मूल क्वेरी, अनुरोधित देश और भाषा, कलेक्शन समय, रिज़ल्ट प्रकार, और कोई भी कन्फ़र्म्ड डेस्टिनेशन URL रहना चाहिए। वैकल्पिक फ़ील्ड वैकल्पिक ही बने रहें। ग़ैर-मौजूद स्निपेट चुपचाप ऐसा खाली डॉक्यूमेंट नहीं बन जाना चाहिए, जिसे कोई एजेंट सबूत की तरह मान ले।
इसी तरह, ट्रांसपोर्ट स्टेटस को कंटेंट स्वीकृति से अलग रखें। HTTP semantics standard प्रोटोकॉल व्यवहार का वर्णन करता है; यह परिभाषित नहीं करता कि कोई परिणाम आपकी रिपोर्टिंग जॉब के लिए आवश्यक ऑर्गेनिक रिकॉर्ड्स रखता है या नहीं।
How This Shortlist Was Evaluated
बेंचमार्क में 800 अनुरोधों का उपयोग किया गया: 600 अलग-अलग क्वेरी और 200 दोहराव, जिन्हें सूचनात्मक, व्यावसायिक, ब्रांडेड, स्थानीय-इंटेंट, और लंबी-क्वेरी समूहों में बराबर बाँटा गया। इसका लक्ष्य US English Google वेब सर्च था। प्रदाताओं ने अलग-अलग समय पर और अपने-अपने अकाउंट व पैरामीटर प्रतिबंधों के साथ रन किए; कैश समान रूप से निष्क्रिय नहीं किए गए थे।
Full-List Evidence: Scrapeless, Oxylabs, and Serper
इन तीन प्रदाताओं ने पूरी अनुरोध सूची पूरी की। तीनों को दृश्य में रखना इस बात को रोकता है कि किसी अनुकूल तुलना को इस दावे में बदला जाए कि Scrapeless ने हर मेट्रिक जीता।
| October Observation | Scrapeless | Oxylabs | Serper |
|---|---|---|---|
| Issued requests | 800 | 800 | 800 |
| Usable responses | 786 | 713 | 800 |
| Usable response rate | 98.25% | 89.125% | 100% |
| Usable-request p50 | 1.94 s | 4.51 s | 1.52 s |
| Usable-request p95 | 3.64 s | 9.13 s | 2.75 s |
| Returned-entry snippet coverage | 99.5% | 100% | 94.4% |
| Failures recorded | 14 HTTP 400 | 82 internal status 613; 5 network errors | 0 |
Scrapeless का Oxylabs पर लाभ ठोस है: 73 अतिरिक्त usable responses, 9.125 प्रतिशत-पॉइंट अधिक usable rate, और 60.1% कम p95। इसका Serper पर लाभ अलग प्रकार का है: लौटाए गए एंट्रीज़ में 5.1 प्रतिशत पॉइंट अधिक स्निपेट कवरेज। स्निपेट की मौजूदगी सटीकता नहीं है, और इन प्रदाताओं ने जैविक (ऑर्गेनिक) एंट्रीज़ के अलग-अलग सेट और संख्या लौटाई।
“Usable” के लिए एक सफल HTTP प्रतिक्रिया, कोई पहचानी गई व्यावसायिक त्रुटि नहीं, और कम-से-कम एक ऑर्गेनिक परिणाम होना आवश्यक था। लेटेंसी केवल usable अनुरोधों को कवर करती है और जारी करने से पहले इंतज़ार में जाने वाला समय शामिल नहीं करती। Oxylabs की त्रुटियाँ इस रन का हिस्सा हैं, इसकी सामान्य सेवा का निदान नहीं। वर्तमान Oxylabs Web API को यहाँ अलग से परीक्षण नहीं किया गया।
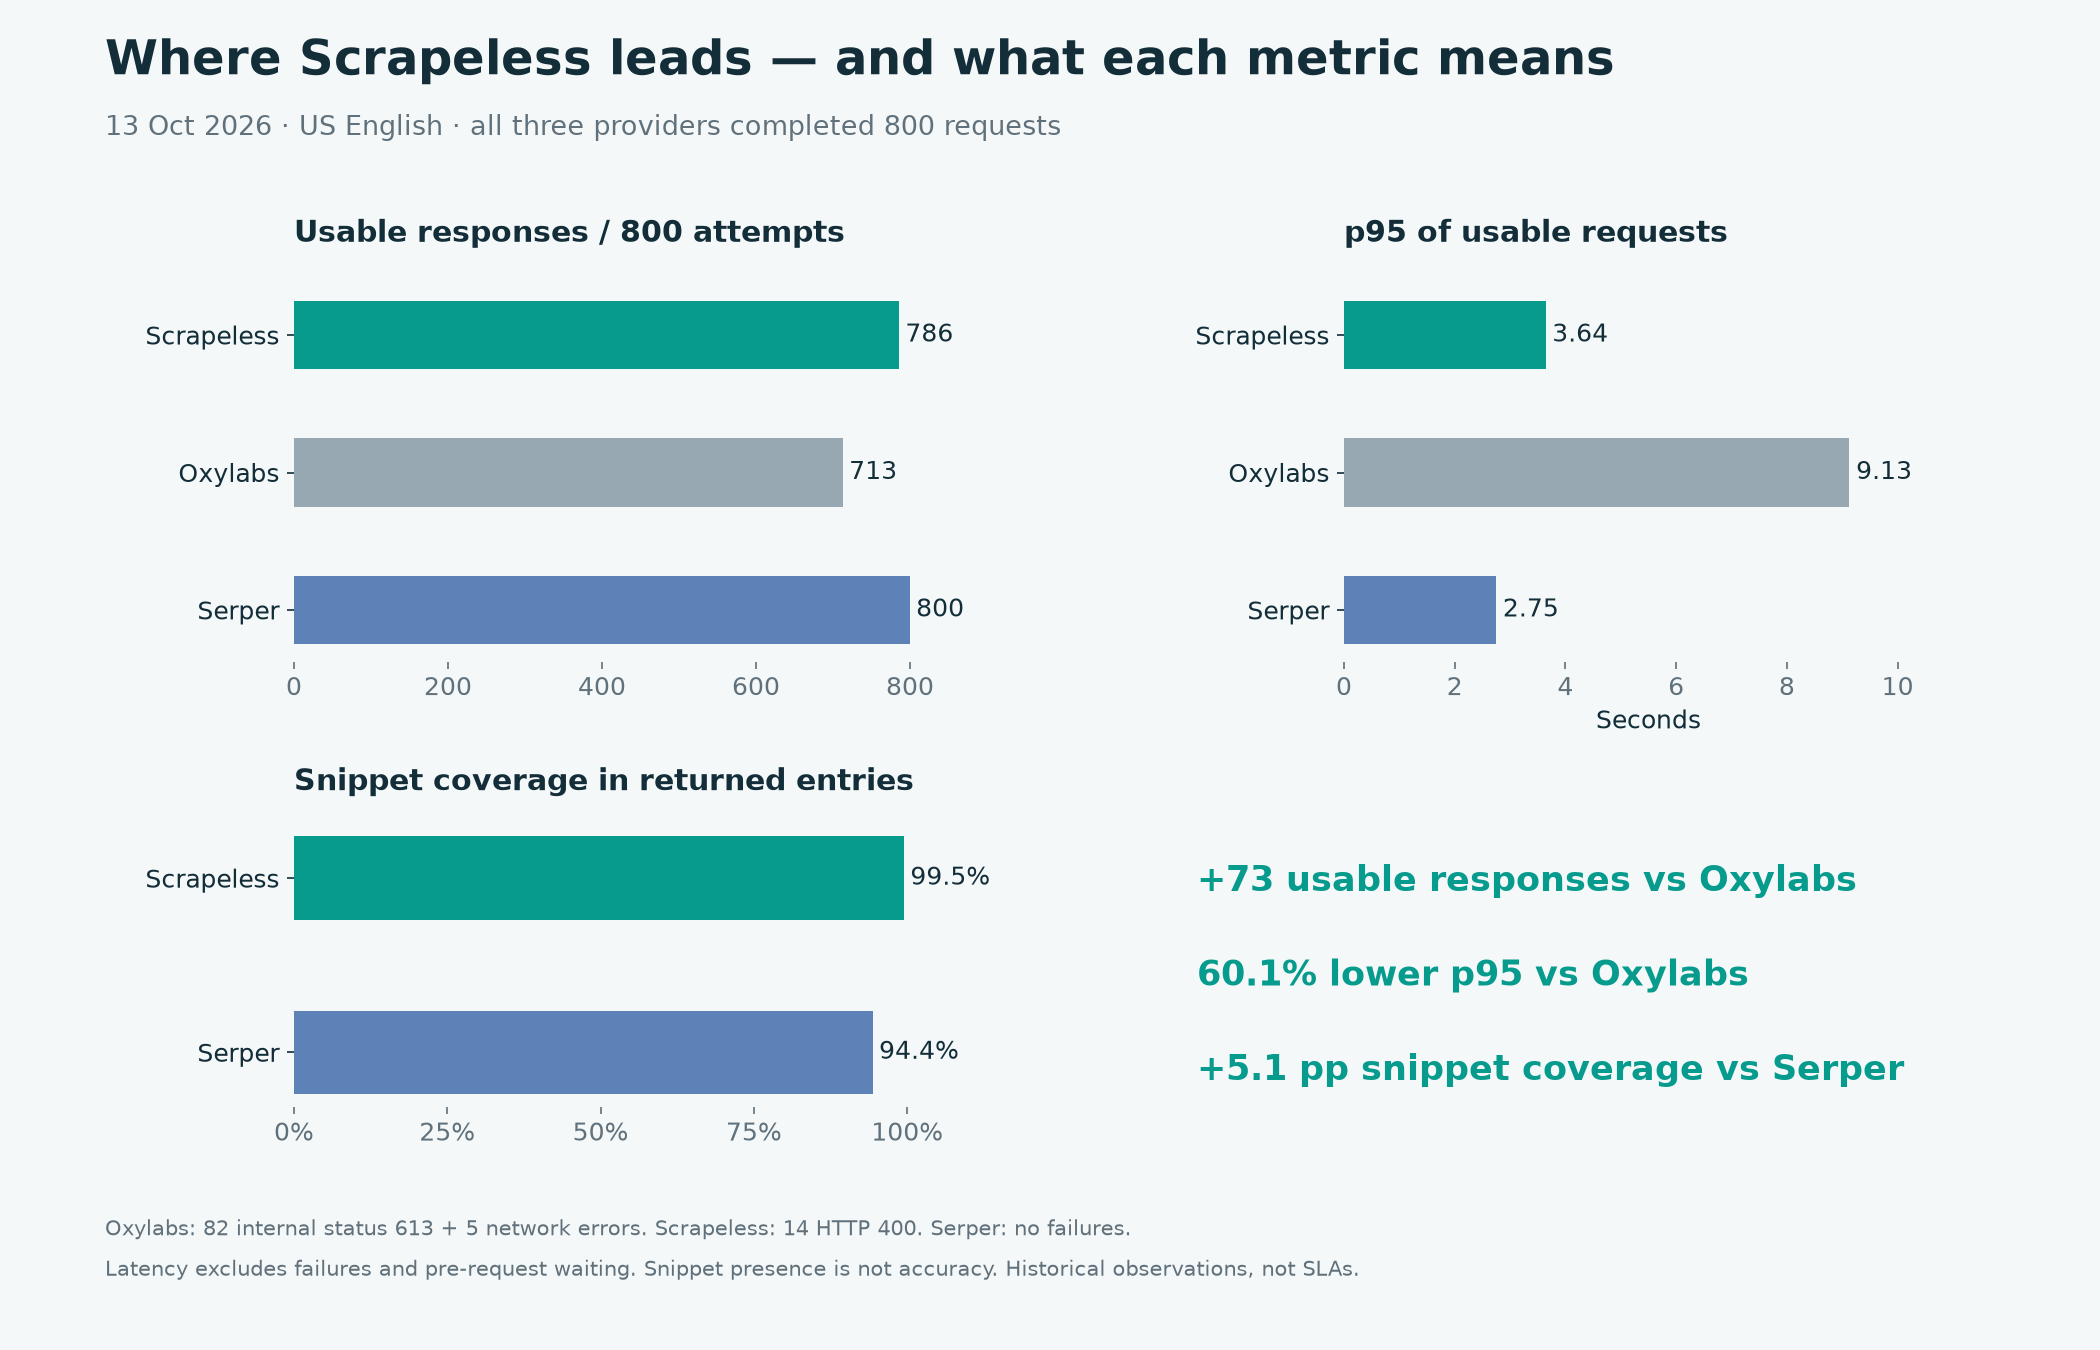
Figure 1. ऐतिहासिक US-English ऑब्ज़र्वेशन, जिनमें सभी तीन 800-रिक्वेस्ट प्रदाता दिखाए गए हैं। टाइमिंग में विफल अनुरोध शामिल नहीं हैं; स्निपेट कवरेज अपने भाजक के रूप में लौटाई गई ऑर्गेनिक एंट्रीज़ का उपयोग करता है। स्रोत: 13-Oct-2026 बेंचमार्क।
Partial Runs: Useful Signals With a Smaller Scope
SearchAPI.io ने 105 अनुरोध पूरे किए, DataForSEO ने 795, और SerpApi ने 200। उनकी फुल-रन लेटेंसी डिस्ट्रीब्यूशन उनके अपने पूरे किए गए सैंपल का वर्णन करती हैं। ये उपयोगी पायलट संकेत हैं, 800-रिक्वेस्ट वाले समतुल्य ट्रायल नहीं। एक साझा Q0001–Q0095 सबसेट usable काउंट्स के लिए एक सामान्य क्वेरी भाजक देता है: Scrapeless 94, SearchAPI.io 88, DataForSEO 65, और SerpApi 94। यह टाइमिंग, अकाउंट्स, या कॉन्फ़िगरेशन में अंतर समाप्त नहीं करता, और किसी भी सबसेट लेटेंसी परिणाम का दावा नहीं किया गया है।
1. Scrapeless: Best for Building a Google Search Data Product
Scrapeless Google Search API उन टीमों के लिए इस शॉर्टलिस्ट में पहली पसंद है जो संरचित Google ऑब्ज़र्वेशन और आवर्ती सर्च-डेटा वर्कफ़्लो तक एक स्पष्ट मार्ग चाहती हैं।
अक्टूबर का परिणाम इस सिफारिश को ठोस बनाता है: 786 usable responses, दो सेकंड से कम मीडियन, और usable सेट के भीतर 3.64-सेकंड का p95। व्यावहारिक लाभ यह है कि प्रारंभिक पायलट का आकार तय करने के लिए एक ठोस बेसलाइन मिलती है, न कि मापन की जगह होमपेज-स्पीड का दावा।
क्वेरी रचना अब भी मायने रखती है। Scrapeless ने 160/160 usable ब्रांडेड सर्च, 159/160 सूचनात्मक सर्च, 159/160 व्यावसायिक सर्च, 158/160 स्थानीय-इंटेंट सर्च, और 150/160 लंबी क्वेरी लौटाईं। इसलिए, एक लंबी-क्वेरी-भारी असिस्टेंट को स्वीकार्य लक्ष्य तय करते समय अपनी खुद की क्वेरी डिस्ट्रीब्यूशन का उपयोग करना चाहिए।
What the Interface Gives a Developer
Google Search request model इनपुट ऑब्जेक्ट के अंदर सर्च क्वेरी स्वीकार करता है, जिसमें देश, भाषा, और अन्य कंट्रोल होते हैं। प्रलेखित रिस्पॉन्स फ्लो एक तत्काल परिणाम और अभी भी प्रोसेस हो रहे टास्क के बीच अंतर करता है। आपका क्लाइंट ऑर्गेनिक परिणाम पढ़ने से पहले इस अंतर को सुरक्षित रखे।
पहले इंटीग्रेशन के लिए, एक सामान्य क्वेरी के लिए डैशबोर्ड-जनरेटेड अनुरोध का उपयोग करें। यह पुष्टि करें कि इसकी ऑर्गेनिक रिज़ल्ट कलेक्शन मौजूद है, एक टाइटल और स्निपेट जाँचें, और रिस्पॉन्स को सुरक्षित रखें। फिर दूसरा अनुरोध चलाएँ जो आपके एप्लिकेशन ट्रैफ़िक के कठिन छोर जैसा हो। यह छोटा चेक कंज़्यूमर अनुमानों को मान्य करता है, इससे पहले कि आप उनके चारों ओर एक शेड्यूलर बनाएँ।
HTTP इंटरफ़ेस का मूल्यांकन करने के लिए किसी बड़े SDK या एजेंट फ़्रेमवर्क की आवश्यकता नहीं है। महत्वपूर्ण आर्टिफ़ैक्ट एक सेव किया हुआ अनुरोध और रिस्पॉन्स है जिसे आपका एप्लिकेशन समझा सके।
Where the October Evidence Requires Care
वापस किए गए Scrapeless ऑर्गेनिक रिकॉर्ड्स में 99.5% स्निपेट-फ़ील्ड कवरेज था, लेकिन उस सैंपल में केवल 0.7% में सीधे डेस्टिनेशन URL शामिल था; अधिकांश लिंक Google के मध्यस्थ URLs थे। स्निपेट कवरेज मौजूदगी मापता है, शुद्धता नहीं। Google search snippets पेज कंटेंट के क्वेरी-सेंसिटिव प्रीव्यू होते हैं, इसलिए एक ही डेस्टिनेशन अलग-अलग सर्च के लिए अलग वर्णनात्मक टेक्स्ट रख सकता है। भरा हुआ लिंक फ़ील्ड यह सिद्ध नहीं करता कि उसका होस्टनेम डेस्टिनेशन पब्लिशर की पहचान करता है।
SEO visibility monitoring के लिए डेस्टिनेशन रेज़ोल्यूशन को एक स्वीकृति आवश्यकता के रूप में मानें। मूल लिंक को सुरक्षित रखें, समर्थित रिट्रीवल पाथ के माध्यम से अंतिम डेस्टिनेशन की पुष्टि करें, और अनसुलझे रिकॉर्ड्स को डोमेन-स्तरीय तुलना से बाहर रखें। उस ऐतिहासिक URL निष्कर्ष को डिप्लॉयमेंट से पहले वर्तमान रिस्पॉन्सेज़ के खिलाफ फिर से जाँचना चाहिए।
Scrapeless विशेष रूप से आकर्षक है जब टीम कई कंज़्यूमर्स के लिए एक ही सर्च कलेक्शन लेयर चाहती है: एक एनालिस्ट डैशबोर्ड, एक सोर्स-डिस्कवरी टूल, और एक रिकरिंग रिसर्च जॉब। Google Search solution collection उपयोगी वर्कलोड डेफिनिशन्स प्रदान करता है बिना इन वर्कफ़्लोज़ को अनुमानित इन-बिल्ट एप्लिकेशन फ़ीचर्स में बदले।
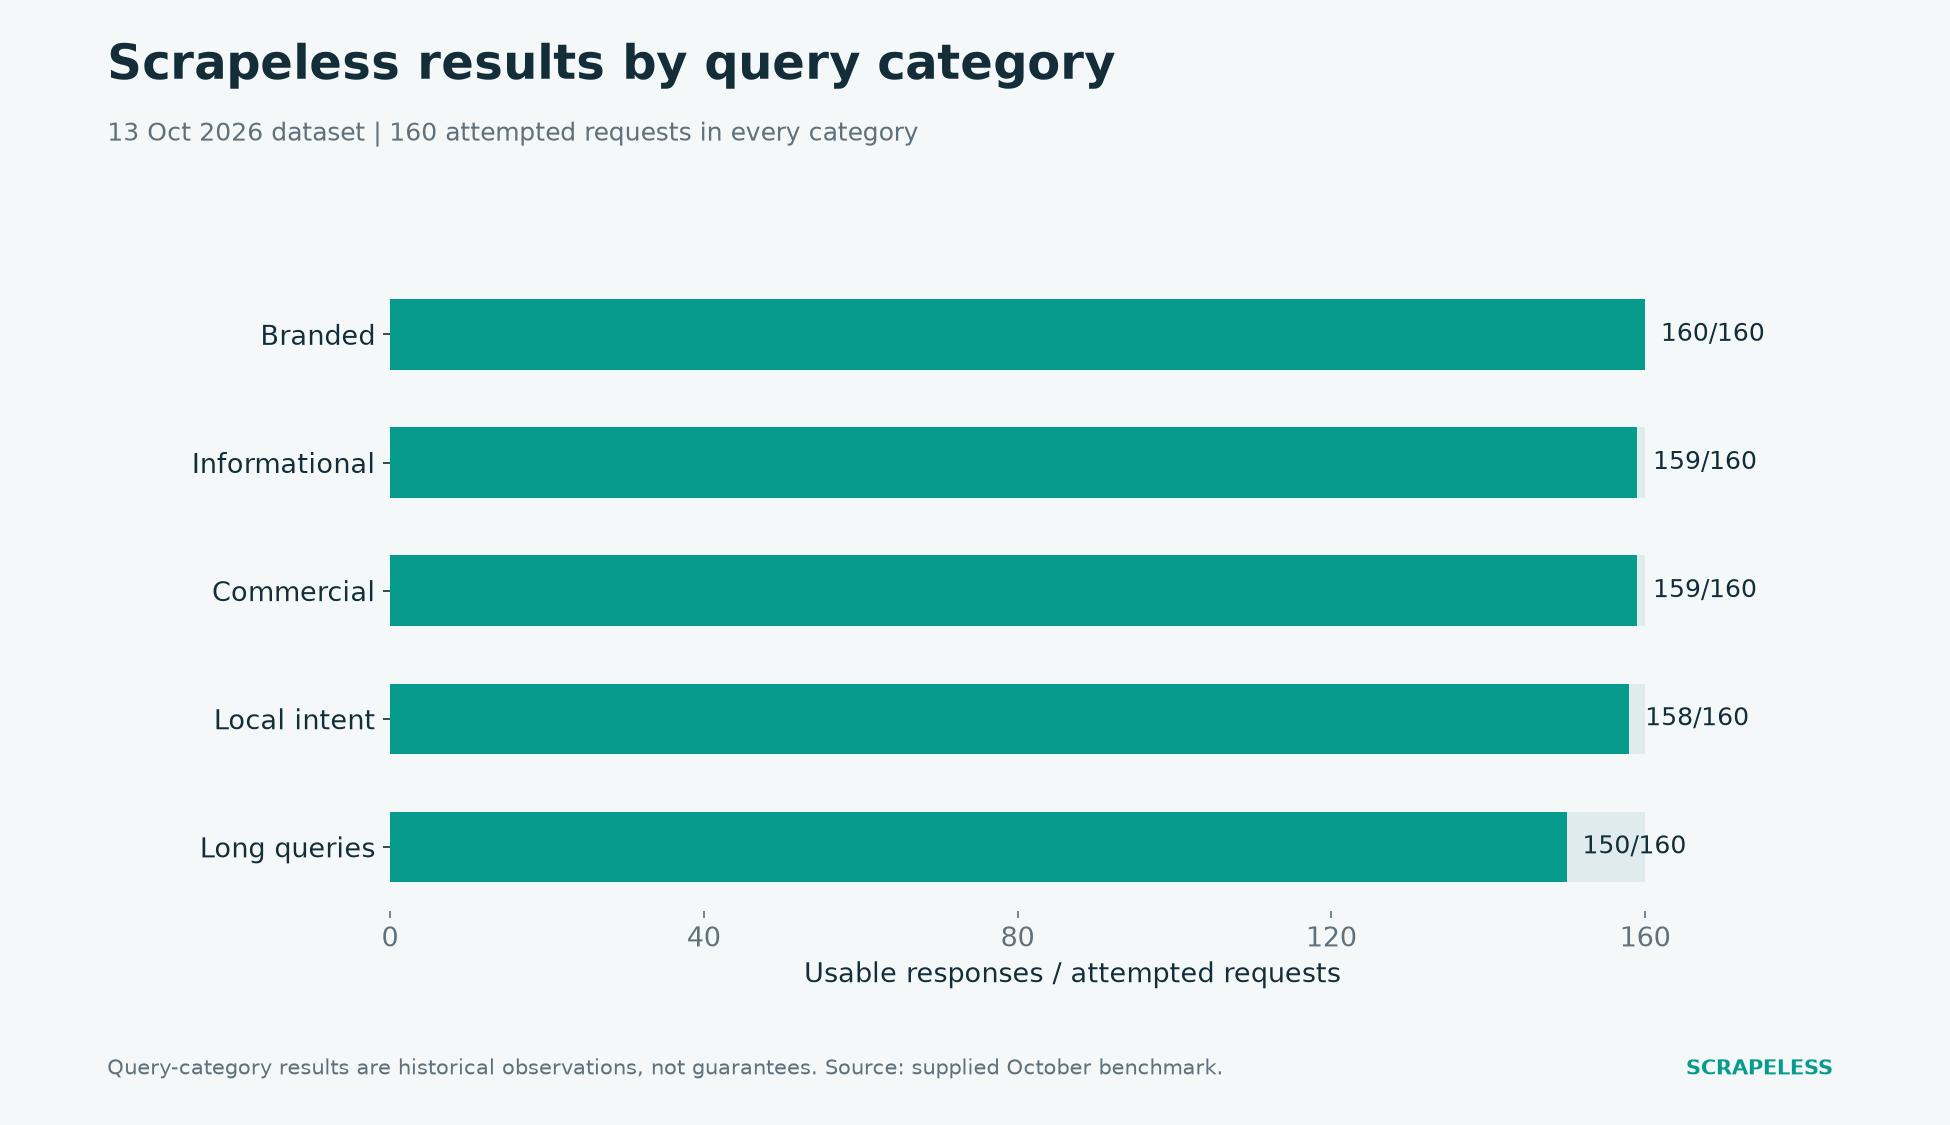
चित्र 2. प्रत्येक क्वेरी कैटेगरी में 160 रिक्वेस्ट्स में से Scrapeless के उपयोगी रिस्पॉन्सेज़। स्रोत: 13-अक्टूबर-2026 बेंचमार्क; स्केल शून्य से शुरू होता है।
2. Serper: प्रीपेड उपयोग के साथ केंद्रित Google Search के लिए सर्वश्रेष्ठ
Serper एक कॉम्पैक्ट Google-search इंटरफ़ेस प्रदान करता है। इसका Starter पैक छह महीने की वैधता के साथ 50,000 क्रेडिट्स के लिए $50 का है, जो पूर्ण उपयोग पर खरीदे गए प्रति 1,000 क्रेडिट्स के लिए $1 के बराबर है। चुने गए रिक्वेस्ट के लिए क्वेरी गहराई और क्रेडिट खपत की जाँच अभी भी ज़रूरी है।
जहाँ Scrapeless के पास बढ़त है: अधिक भरे हुए स्निपेट्स
Scrapeless ने लौटाए गए ऑर्गेनिक एंट्रीज़ में 99.5% स्निपेट कवरेज बनाम Serper के 94.4% रिकॉर्ड किया, जो 5.1-प्रतिशत-बिंदु की बढ़त है। एक क्लासिफ़ायर या कंटेंट-डिस्कवरी इंटरफ़ेस जो टाइटल्स और स्निपेट्स की स्क्रीनिंग करता है, इस माप पर काम करने के लिए अधिक सुसंगत रूप से भरे हुए टेक्स्ट रखता है। जब कंज़्यूमर को केवल URLs नहीं, बल्कि डिस्क्रिप्शंस की ज़रूरत हो, तो यही प्रासंगिक Scrapeless लाभ है।
Serper ने 800/800 उपयोगी रिस्पॉन्सेज़ 1.52/2.75-सेकंड p50/p95 के साथ लौटाए, जो इन मैट्रिक्स पर Scrapeless से आगे था। इसका डायरेक्ट-URL कवरेज भी मजबूत था। डेस्टिनेशन को वेलिडेट करने के बाद स्निपेट-उन्मुख वर्कफ़्लो के लिए Scrapeless चुनें; फ़ील्ड-कवरेज लाभ को तेज़ कलेक्शन या बेहतर प्रासंगिकता के दावे में न बदलें।
व्यावसायिक मूल्यांकन के लिए, Scrapeless प्रति 1,000 सर्च पर $0.50 से कम के योग्य एंटरप्राइज़ वॉल्यूम रेट्स प्रदान करता है। यह Serper के Starter क्रेडिट रेट से कम विज्ञापित दर बनाता है, लेकिन यह अलग प्रतिबद्धताओं की तुलना है। Serper भी बड़े पैक्स पर डिस्काउंट देता है। बचत का दावा करने से पहले मिलते-जुलते वॉल्यूम के टर्म्स मांगें।
3. Oxylabs: व्यापक डेटा प्लेटफ़ॉर्म के भीतर Google कलेक्शन के लिए सर्वश्रेष्ठ
Oxylabs अपनी Web API के माध्यम से Google डेटा कलेक्शन प्रदान करता है। जब कोई टीम पहले से कई एक्सट्रैक्शन वर्कलोड्स को उसी प्रदाता के तहत समेकित कर रही हो, तब यह एक उचित उम्मीदवार है।
जहाँ Scrapeless के पास बढ़त है: कम लेटेंसी के साथ अधिक उपयोगी परिणाम
पूरी अक्टूबर सूची में, Scrapeless ने 786/800 उपयोगी रिस्पॉन्सेज़ बनाम टेस्ट किए गए Oxylabs इंटरफ़ेस के 713/800 लौटाए। उसका 1.94-सेकंड p50, 4.51 सेकंड की तुलना में 57.0% कम था, और उसका 3.64-सेकंड p95, 9.13 सेकंड की तुलना में 60.1% कम था। उपलब्ध साक्ष्य में यह समान रिक्वेस्ट-काउंट के लिए Scrapeless को Google कलेक्शन के लिए चुनने का सबसे स्पष्ट तर्क है।
मूल्य ऑपरेशनल है: अधिक सर्चेज़ ने ऑर्गेनिक परिणाम पैदा किए, और सफल पाथ ने अपनी धीमी रिस्पॉन्सेज़ के लिए कम समय इंतज़ार किया। किसी रिपोर्टिंग जॉब के लिए, यह Scrapeless को पायलट करने का उससे मजबूत कारण है, जितना कि किसी भी विक्रेता के प्रोडक्ट कैटलॉग का आकार।
Oxylabs रन में 82 इंटरनल स्टेटस 613 रिस्पॉन्सेज़ और पाँच नेटवर्क एरर शामिल थे; Scrapeless में 14 HTTP 400 रिस्पॉन्सेज़ थे। ये परिस्थितियाँ तुलना से जुड़ी रहनी चाहिए। परिणाम को टेस्ट की गई कॉन्फ़िगरेशन के तहत ऐतिहासिक बढ़त मानें, और फिर प्रोडक्शन ट्रैफ़िक कमिट करने से पहले मौजूदा एंडपॉइंट्स को वेलिडेट करें।
Scrapeless के साथ स्क्रैपिंग शुरू करें
Scrapeless के साथ अपने वेब स्क्रैपिंग और ऑटोमेशन वर्कफ़्लो को पावर अप करें!
आज ही साइन अप करें और $5 का फ्री क्रेडिट पाएं — कोई क्रेडिट कार्ड आवश्यक नहीं।
अभी अपना निःशुल्क क्रेडिट Scrapeless डैशबोर्ड में क्लेम करें।
4. SearchAPI.io: कई Google सर्च सतहों की तुलना करने वाली टीमों के लिए सबसे उपयुक्त
SearchAPI.io संरचित Google सर्च आउटपुट और संबंधित सर्च एंडपॉइंट प्रदान करता है। यह जाँचें कि आपका अनुप्रयोग वास्तव में कौन‑सा Google सतह उपयोग करता है; केवल ऑर्गेनिक‑रिज़ल्ट अडैप्टर हर विशेषीकृत रिज़ल्ट मॉड्यूल को सत्यापित नहीं करता।
जहाँ Scrapeless को बढ़त है: तेज़ देखी गई सर्च पाथ
अक्टूबर में Scrapeless के उपयोगी‑अनुरोध p50/p95 क्रमशः 1.94/3.64 सेकंड थे, जबकि SearchAPI.io के पूर्ण सैंपल के लिए यह 6.33/34.87 सेकंड थे। यह किसी लेटेंसी‑संवेदी डिस्कवरी पायलट में Scrapeless को शामिल करने का ठोस कारण है। ये अलग‑अलग आकार के रन हैं: Scrapeless के लिए 800 अनुरोध और SearchAPI.io के लिए 105, जिसमें बाद वाले के लिए सात HTTP 503 प्रतिक्रियाएँ शामिल हैं।
साझा 95‑क्वेरी सबसेट एक दूसरी, संकरी तुलना देता है: Scrapeless के लिए 94 उपयोगी प्रतिक्रियाएँ बनाम SearchAPI.io के लिए 88। यह संग्रह के पक्ष में तर्क देता है, बिना यह दिखावा किए कि पूरे रन के हर हर (denominator) मेल खाते हैं।
डेवलपर के लिए अगला कदम दोनों मौजूदा सेवाओं पर वही रेस्पॉन्स कॉन्ट्रैक्ट और क्वेरी शेड्यूल लागू करना है। फ़ील्ड कवरेज, डेस्टिनेशन रिज़ॉल्यूशन और लेटेंसी को अलग‑अलग स्वीकृति मापदंड बनाए रखें। ऐतिहासिक साक्ष्य बताए गए कलेक्शन आयामों पर Scrapeless के पक्ष में हैं, न कि SearchAPI.io द्वारा बेचे जाने वाले हर फ़ीचर पर।
5. DataForSEO: व्यापक SEO डेटा स्टैक खरीदने वाली टीमों के लिए सबसे उपयुक्त
DataForSEO SERP कलेक्शन को व्यापक SEO डेटा API सेट के साथ जोड़ता है। यह तब महत्वपूर्ण हो सकता है जब सर्च परिणाम किसी मौजूदा SEO अनुप्रयोग के लिए सिर्फ एक इनपुट हों।
जहाँ Scrapeless को बढ़त है: सर्च लेयर के लिए तेज़ देखी गई रिट्रीवल
अक्टूबर के Google वर्कलोड के लिए Scrapeless का 3.64‑सेकंड उपयोगी‑अनुरोध p95 DataForSEO Live के लिए दर्ज 13.51 सेकंड से कम था। साझा 95‑क्वेरी सबसेट ने Scrapeless के साथ 94 उपयोगी प्रतिक्रियाएँ बनाम DataForSEO के साथ 65 उत्पन्न कीं। जब तात्कालिक आवश्यकता किसी इंटरैक्टिव टूल के लिए भरोसेमंद सर्च डिस्कवरी हो, तो Scrapeless को प्राथमिकता देने के ये ठोस कारण हैं।
DataForSEO के मुख्य रन ने 795 अनुरोध जारी किए और 667 उपयोगी परिणाम प्राप्त किए, जिनमें दो क्रेडेंशियल समूहों में 128 टास्क‑स्टेटस 40101 प्रतिक्रियाएँ थीं। इसकी क्यू मोड्स का परीक्षण नहीं किया गया। परिणाम को हर DataForSEO मोड या मौजूदा खाते पर समग्र निर्णय के रूप में सामान्यीकृत नहीं करना चाहिए।
जहाँ यह केंद्रित सर्च‑लेयर लाभ आपके उत्पाद से मेल खाता हो, वहाँ Scrapeless का उपयोग करें। यदि अन्य SEO डेटासेट इसकी कीमत वसूलते हैं तो उनके लिए एक अलग प्रदाता बनाए रखें; सर्च कलेक्टर बदलने से पूरी एप्लिकेशन को फिर से लिखने की ज़रूरत नहीं होती।
6. SerpApi: विस्तृत Google रिज़ल्ट मॉड्यूल उपभोक्ताओं के लिए सबसे उपयुक्त
SerpApi कई Google रिज़ल्ट मॉड्यूल का दस्तावेज़ीकरण करता है। जब आपका अनुप्रयोग केवल ऑर्गेनिक‑रिज़ल्ट सूची के बजाय पहले से ही उन्हीं विशिष्ट संरचनाओं पर निर्भर हो, तब इसे अवश्य विचार करना चाहिए।
जहाँ Scrapeless को बढ़त है: टेल‑लेटेंसी और वॉल्यूम‑क़ीमत के अवसर
Scrapeless ने 3.64‑सेकंड p95 दर्ज किया, जबकि SerpApi के अक्टूबर सैंपल में यह 26.81 सेकंड था। नमूना आकार क्रमशः 800 और 200 थे, और SerpApi का 1.32‑सेकंड मीडियन Scrapeless के 1.94 सेकंड से कम था। Scrapeless के पक्ष में संकेत देखा गया टेल है, न कि यह दावा कि हर अनुरोध तेज़ था।
SerpApi की Starter योजना 1,000 सर्च के लिए प्रति माह $25 है। Scrapeless की 1,000 सर्च पर $0.50 से कम की योग्य एंटरप्राइज़ दर किसी उच्च‑वॉल्यूम केवल‑Google ख़रीदार के लिए कोट माँगने का कारण है। यह Starter योजना की समान‑से‑समान तुलना, पूर्ण बिल, या मापी गई बचत नहीं है; न्यूनतम प्रतिबद्धता, फीचर और बिलिंग परिभाषाएँ अब भी मायने रखती हैं।
ऐसे ऑर्गेनिक‑सर्च उत्पाद के लिए जो विशेष मॉड्यूल की बड़ी कैटलॉग का उपभोग नहीं करता, उन सर्च फ़ील्ड और लेटेंसी बजट के इर्द‑गिर्द पायलट चुनें जिनकी आपको वास्तव में ज़रूरत है। Scrapeless यहाँ पहला उम्मीदवार है क्योंकि ये आवश्यकताएँ इसके मापे गए बेसलाइन और वॉल्यूम‑प्राइसिंग प्रस्ताव के साथ मेल खाती हैं।
साथ‑साथ रखकर निर्णय मानदंड
| आपका मुख्य प्रतिबंध | Scrapeless से शुरुआत क्यों करें? | पायलट क्या पुष्टि करे |
|---|---|---|
| Oxylabs‑आधारित जॉब में धीमी सफल प्रतिक्रियाएँ | पूर्ण‑सूची अवलोकन में 60.1% कम p95 | वर्तमान एंडपॉइंट, खाता और क्वेरी मिश्रण |
| Serper‑आधारित कंज़्यूमर में गायब डिस्क्रिप्शन टेक्स्ट | 99.5% बनाम 94.4% स्निपेट कवरेज | टेक्स्ट की उपस्थिति, प्रासंगिकता और सत्यापित डेस्टिनेशन |
| SearchAPI.io या DataForSEO का उपयोग करते हुए इंटरैक्टिव डिस्कवरी | कम देखी गई फ़ुल‑रन p95; साझा‑सबसेट में अनुकूल उपयोगी काउंट | तुलनीय वर्तमान लिमिट और कलेक्शन विंडो |
| केवल‑Google उत्पाद के लिए SerpApi लागत | योग्य‑वॉल्यूम प्राइसिंग और कम देखी गई p95 | मेल खाते वॉल्यूम वाला कोट और आवश्यक रिज़ल्ट मॉड्यूल |
| एक ही Google अवलोकन को पढ़ने वाले कई कंज़्यूमर | सर्च रिकॉर्ड अलग‑अलग SEO और रिसर्च चरणों को फीड कर सकते हैं | स्पष्ट स्कीमा और अलग‑अलग स्वीकृति नियम |
| सिफारिश उपभोक्ता के बाधा-बिंदु का अनुसरण करती है। कोई एकल मेट्रिक हर वर्कलोड के लिए सर्वश्रेष्ठ प्रदाता निर्धारित नहीं करता। |
संख्याओं को गलत न पढ़ते हुए API कैसे चुनें
एक अच्छा पायलट उस एप्लिकेशन रिकॉर्ड को मापता है जो अंततः उपभोक्ता तक पहुँचता है।
प्रतिनिधि क्वेरी समूहों से शुरू करें और उन्हें एक से अधिक कलेक्शन विंडो में दोहराएँ। किए गए हर प्रयासित अनुरोध की गिनती करें। व्यावसायिक त्रुटियों को उन वैध प्रतिक्रियाओं से अलग दर्ज करें जिनमें कोई ऑर्गेनिक मैच नहीं है। उपयोगी अनुरोधों की विलंबता (latency) के वितरण को ट्रैक करें, जबकि असफल परिणामों को उसके साथ-साथ दृश्य बनाए रखें।
फिर डेस्टिनेशन की पहचान मापें। URI normalization rules URLs की तुलना के लिए एक शुरुआती बिंदु देती हैं, लेकिन प्रोडक्शन मैचिंग नीति को यह भी तय करना होता है कि ट्रैकिंग पैरामीटर, रीडायरेक्ट और समकक्ष पेजों के साथ कैसा व्यवहार करना है। कच्चे मानों को सुरक्षित रखें ताकि बाद में नॉर्मलाइज़ेशन में कोई बदलाव हो तो उसकी जाँच की जा सके।
अंत में, लागू Scrapeless pricing या प्रतिस्पर्धी प्लान का मूल्यांकन पूरे जॉब के खिलाफ करें। सर्च अनुरोध, अतिरिक्त परिणाम पेज, डेस्टिनेशन रिट्रीवल और स्टोरेज अलग-अलग लागत घटक हैं। अक्टूबर बेंचमार्क में सभी प्रदाताओं के तुलनीय अंतिम बिल शामिल नहीं थे, इसलिए वह मापी हुई लागत रैंकिंग का आधार नहीं बन सकता।
एक केंद्रित व्यावसायिक तुलना के लिए, Scrapeless and Serper alternative page एक अलग खरीद संसाधन है। इसके प्रकाशित उत्पाद दावों को ऊपर दिए गए अक्टूबर मापों से अलग रखें।
Google Search डेटा को इन जाँचों की आवश्यकता क्यों है
सर्च पेज क्वेरी संदर्भ, समय और परिणाम संरचना के साथ बदलते रहते हैं, इसलिए JSON एकत्र करने से व्याख्या की आवश्यकता समाप्त नहीं होती।
रैंक ट्रैकिंग के लिए ज्ञात बाज़ार और पुष्ट डेस्टिनेशन की आवश्यकता होती है। कंटेंट रिसर्च के लिए उपयोगी शीर्षक और स्निपेट चाहिए, और जब कोई दावा विस्तार पर निर्भर करता है तो उसके बाद पेज पढ़ना ज़रूरी होता है। ब्रांड मॉनिटरिंग को ब्रांड की अपनी साइट और उसे सिर्फ उल्लेख करने वाले पेजों में अंतर करने के लिए एक नियम चाहिए। ये उपभोक्ता अलग-अलग स्वीकृति नियम बनाए रखते हुए एक ही कलेक्टर साझा कर सकते हैं।
निष्कर्ष
Scrapeless, Google सर्च डेटा प्रोडक्ट के लिए एक मज़बूत प्रथम इम्प्लीमेंटेशन उम्मीदवार है, जिसे एक स्पष्ट 800-रिक्वेस्ट बेसलाइन और आवर्ती सर्च वर्कफ़्लो में प्रवेश की व्यावहारिक राह का समर्थन प्राप्त है। सबसे मज़बूत तुलनात्मक साक्ष्य पूर्ण-लिस्ट रन में Oxylabs की तुलना में 73 अधिक उपयोगी प्रतिक्रियाएँ और 60.1% कम p95, साथ ही Serper से अधिक स्निपेट कवरेज है। अन्य प्रदाता विशेष आवश्यकताओं और माइग्रेशन प्रयास की बेंचमार्किंग में मदद करते हैं।
वह जोड़ी चुनें जो आपके एप्लिकेशन के लिए उपयुक्त हो, दोनों के माध्यम से वही क्वेरी समूह चलाएँ, और उन रिकॉर्ड्स की तुलना करें जिन्हें आपके उपयोगकर्ता वास्तव में उपभोग करेंगे।
क्या आप अपना Search Data Pipeline बनाने के लिए तैयार हैं?
Discord और Telegram पर सर्च वर्कफ़्लो बनाने वाले डेवलपर्स से जुड़ें।
app.scrapeless.com पर परिभाषित क्वेरी सेट, आवश्यक फ़ील्ड्स और डेस्टिनेशन-वैलिडेशन नियम के साथ शुरू करें।
FAQ
प्रश्न: डेवलपर्स के लिए सबसे अच्छा Google Search API कौन-सा है?
संरचित Google-डेटा वर्कफ़्लो के लिए Scrapeless पहली सिफारिश है। इसके लाभों में पूर्ण-लिस्ट टेस्ट में Oxylabs की तुलना में अधिक उपयोगी-प्रतिक्रियाएँ और कम विलंबता, और Serper से अधिक स्निपेट कवरेज शामिल हैं। अपने आवश्यक फ़ील्ड्स के विरुद्ध वर्तमान इंटरफ़ेस को सत्यापित करें।
प्रश्न: क्या सबसे तेज़ API अपने आप सबसे अच्छा विकल्प होता है?
नहीं। विलंबता का मूल्यांकन उपयोगी प्रतिक्रियाओं, डेस्टिनेशन पहचान, आवश्यक फ़ील्ड्स और कुल वर्कफ़्लो लागत के साथ मिलाकर किया जाना चाहिए। एक तेज़ परिणाम जिसे सही प्रकाशक से नहीं मिलान किया जा सकता, किसी रैंकिंग प्रोडक्ट के लिए अनुपयुक्त हो सकता है।
प्रश्न: क्या Google Search API पूर्ण वेबपेज सामग्री लौटाता है?
एक सामान्य SERP प्रतिक्रिया में सर्च-परिणाम जानकारी होती है, ज़रूरी नहीं कि हर डेस्टिनेशन की पूरी सामग्री हो। पेज रिट्रीवल एक अलग क्षमता है और इसका अलग से मूल्यांकन किया जाना चाहिए। Scrapeless का Universal Scraping API उन एप्लिकेशनों के लिए अलग सार्वजनिक-पेज रिट्रीवल पथ प्रदान करता है जिन्हें चुनिंदा स्रोत पढ़ने की आवश्यकता होती है।
प्रश्न: क्या एक अनुरोध 100 ऑर्गेनिक परिणामों की गारंटी दे सकता है?
नहीं। अनुरोधित गहराई, पेजिनेशन सपोर्ट और वास्तव में लौटाए गए परिणामों की संख्या अलग-अलग विषय हैं। वर्तमान एंडपॉइंट को सत्यापित करें और अनुरोधित गिनती को मान कर चलने के बजाय अद्वितीय डेस्टिनेशनों को मापें।
प्रश्न: क्या सभी छह APIs को एक साथ बेंचमार्क किया गया था?
नहीं। Scrapeless, Serper, और Oxylabs ने 800 अनुरोध पूरे किए। DataForSEO ने 795, SerpApi ने 200, और SearchAPI.io ने 105 पूरे किए। साझा 95-क्वेरी उपसमुच्चय का उपयोग केवल उपयोगी गणनाओं के लिए किया जाता है; विलंबता तुलना अपनी मूल नमूना आकारों को ही रखती हैं।
स्क्रैपलेस में, हम केवल सार्वजनिक रूप से उपलब्ध डेटा का उपयोग करते हैं, जबकि लागू कानूनों, विनियमों और वेबसाइट गोपनीयता नीतियों का सख्ती से अनुपालन करते हैं। इस ब्लॉग में सामग्री केवल प्रदर्शन उद्देश्यों के लिए है और इसमें कोई अवैध या उल्लंघन करने वाली गतिविधियों को शामिल नहीं किया गया है। हम इस ब्लॉग या तृतीय-पक्ष लिंक से जानकारी के उपयोग के लिए सभी देयता को कोई गारंटी नहीं देते हैं और सभी देयता का खुलासा करते हैं। किसी भी स्क्रैपिंग गतिविधियों में संलग्न होने से पहले, अपने कानूनी सलाहकार से परामर्श करें और लक्ष्य वेबसाइट की सेवा की शर्तों की समीक्षा करें या आवश्यक अनुमतियाँ प्राप्त करें।





